
Grundlæggende AI
Hvad er AI-guardrails? Sådan kontrollerer produktionssystemer modeladfærd
AI guardrails er lagdelte tekniske og proceduremæssige kontroller, der begrænser input, handlinger, output og eskalation omkring en model eller agent. Denne vejledning forklarer mekanismen, afvejninger, evaluering og kontroller, der er relevante i praksis.

 Føj Unite.AI til dine foretrukne kilder på Google
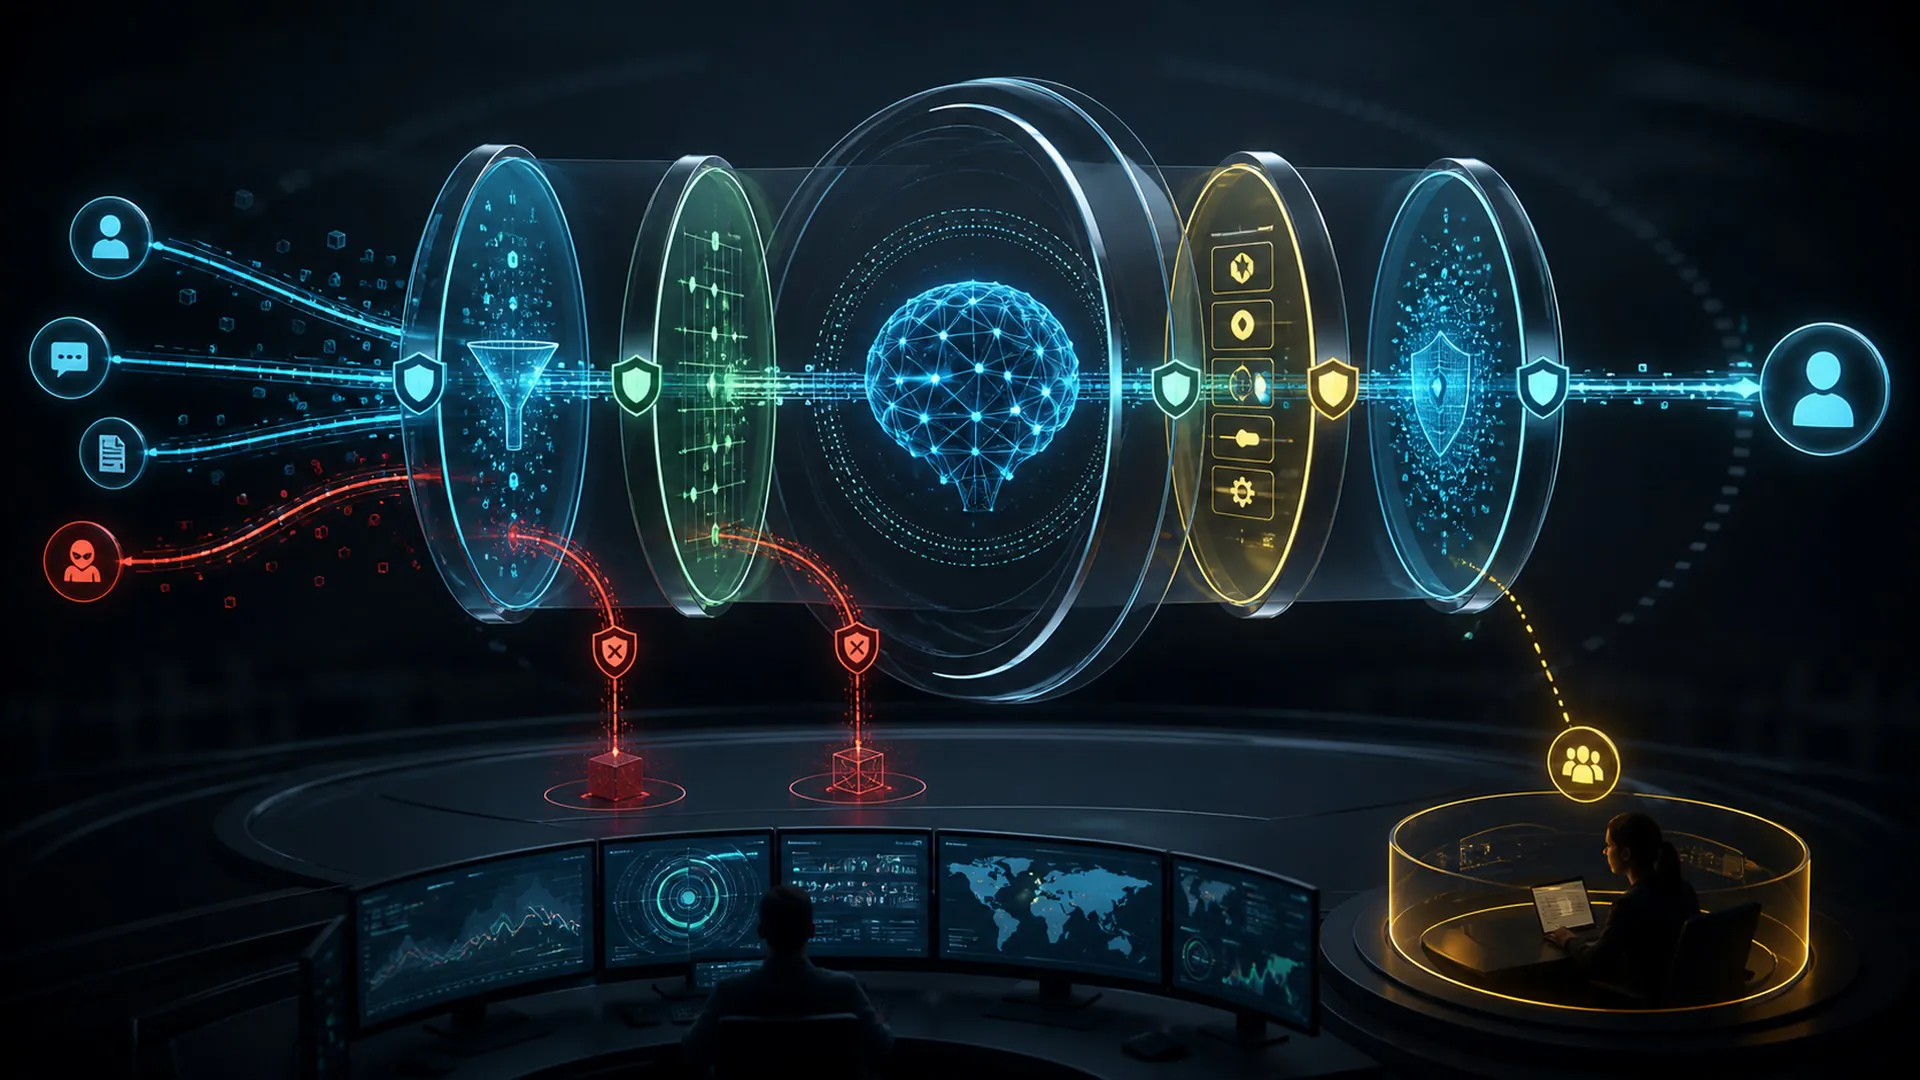
AI guardrails er lagdelte tekniske og proceduremæssige kontroller, der begrænser input, handlinger, output og eskalering omkring en model eller agent.
AI guardrails fortjener en præcis forklaring, fordi navnet identificerer en specifik informationsstrøm, træningsvalg, køretidsmekanisme eller styringsgrænse. At betragte det som et synonym for “avanceret AI” gør påstande umulige at teste. Denne guide følger konceptet fra dets input og antagelser gennem dets observerbare resultat og tester derefter den genvej, der mest sandsynligt kan forveksles med det.
AI Guardrails: Definition, grænse og formål
AI guardrails er lagdelte tekniske og proceduremæssige kontroller, der begrænser input, handlinger, output og eskalering omkring en model eller agent. Definitionen indeholder tre praktiske forpligtelser: der er et identificerbart input, en transformation eller beslutning, der er karakteristisk for AI guardrails, og et resultat, der kan evalueres i forhold til et angivet mål. Hvis et af disse elementer mangler, kan betegnelsen beskrive en aspiration snarere end en implementeret mekanisme.
Pålidelig AI kræver evidens gennem hele livscyklussen. En kontrol er meningsfuld kun når dens ejer, omfang, udløser, forventede adfærd og verifikationsmetode er eksplicitte. For AI guardrails er dette systemperspektiv vigtigt, fordi ydeevnen kan bestemmes af de omgivende data, grænseflader, hardware, tilladelser og mennesker, selv når den underliggende model forbliver uændret. En nyttig forklaring adskiller derfor modellens indlærte adfærd fra det produkt, der beslutter hvornår, hvor og med hvilken autoritet den adfærd anvendes.
Den mest misvisende genvej er en enkelt systemprompt, der forventes at håndhæve hver grænse. Den kan dele en synlig funktion med AI guardrails, men den ændrer den kausale fortælling: anderledes evidens ville fastslå succes, andre ressourcer ville dominere omkostningerne, og andre kontroller ville forhindre skade. Grænsen er derfor operationel snarere end terminologisk.
Et femtrins driftskort for AI Guardrails
Diagrammet er et kompakt kausalt kort for AI guardrails, ikke en påstand om at hver implementering bruger fem softwarekomponenter. Nogle systemer kombinerer faser, og andre gentager dem i en løkke. Kortet forbliver nyttigt, fordi det tvinger hver ændring i information eller autoritet til at have en ejer, et input, et output og en test.
1. Klassificer anmodningen og gældende politik: Input og antagelser i AI Guardrails
På dette trin af AI guardrails skal systemet klassificere anmodningen og den gældende politik. Det væsentlige spørgsmål er ikke blot, om denne operation forekommer, men hvilken information den forbruger, hvilken tilstand den ændrer, og hvilke beviser der viser, at ændringen var gyldig. En reviewer skal kunne skelne operationen fra en enkelt systemprompt, der forventes at håndhæve hver grænse, og reproducere dens resultat under de samme angivne betingelser.
Overdragelsen til dette AI guardrails-trin begynder med det angivne mål og bør ende med et resultat, der kan understøtte begrænsning af kontekst, værktøjer og dataadgang. Registrer usikkerhed, afviste alternativer, ressourceforbrug og enhver menneskelig eller softwarekontrol, der anvendes ved grænsen. Denne spor er, hvor teams kan opdage, om guardrails kan blokere legitimt arbejde, omgås, eller skabe en falsk følelse af sikkerhed, før den samme svaghed når et væsentligt output.
2. Begræns kontekst, værktøjer og dataadgang: Repræsentation eller beslutning i AI Guardrails
På dette trin af AI guardrails skal systemet begrænse kontekst, værktøjer og dataadgang. Det væsentlige spørgsmål er ikke blot, om denne operation forekommer, men hvilken information den forbruger, hvilken tilstand den ændrer, og hvilke beviser der viser, at ændringen var gyldig. En reviewer skal kunne skelne operationen fra en enkelt systemprompt, der forventes at håndhæve hver grænse, og reproducere dens resultat under de samme angivne betingelser.
Overdragelsen til dette AI guardrails-trin begynder med at klassificere anmodningen og den gældende politik og bør ende med et resultat, der kan understøtte validering af foreslåede handlinger før udførelse. Registrer usikkerhed, afviste alternativer, ressourceforbrug og enhver menneskelig eller softwarekontrol, der anvendes ved grænsen. Denne spor er, hvor teams kan opdage, om guardrails kan blokere legitimt arbejde, omgås, eller skabe en falsk følelse af sikkerhed, før den samme svaghed når et væsentligt output.
3. Valider foreslåede handlinger før udførelse: Distinkt transformation i AI‑guardrails
På dette stadium af AI‑guardrails skal systemet validere foreslåede handlinger før udførelse. Det relevante spørgsmål er ikke blot, om handlingen finder sted, men hvilken information den forbruger, hvilken tilstand den ændrer, og hvilket bevis der viser, at ændringen er gyldig. En reviewer skal kunne skelne handlingen fra en enkelt systemprompt, der forventes at håndhæve hver grænse og reproducere resultatet under de samme angivne betingelser.
Overgangen til dette AI‑guardrails‑stadium begynder med at begrænse kontekst, værktøjer og dataadgang og bør ende med et resultat, der kan understøtte inspektion af output og ændret tilstand. Registrer usikkerhed, afviste alternativer, ressourceforbrug og enhver menneskelig eller softwarekontrol, der anvendes ved grænsen. Det spor er, hvor teams kan opdage, om guardrails kan blokere legitimt arbejde, omgås eller skabe en falsk tryghedsfølelse, før den samme svaghed fører til et væsentligt output.
4. Inspicer output og ændret tilstand: Begrænsnings‑ og verifikationsgrænse i AI‑guardrails
På dette stadium af AI‑guardrails skal systemet inspicere output og ændret tilstand. Det relevante spørgsmål er ikke blot, om handlingen finder sted, men hvilken information den forbruger, hvilken tilstand den ændrer, og hvilket bevis der viser, at ændringen er gyldig. En reviewer skal kunne skelne handlingen fra en enkelt systemprompt, der forventes at håndhæve hver grænse og reproducere resultatet under de samme angivne betingelser.
Overgangen til dette AI‑guardrails‑stadium begynder med at validere foreslåede handlinger før udførelse og bør ende med et resultat, der kan understøtte eskalering, logning og forbedring fra hændelser. Registrer usikkerhed, afviste alternativer, ressourceforbrug og enhver menneskelig eller softwarekontrol, der anvendes ved grænsen. Det spor er, hvor teams kan opdage, om guardrails kan blokere legitimt arbejde, omgås eller skabe en falsk tryghedsfølelse, før den samme svaghed fører til et væsentligt output.
5. Eskaler, log og forbedr fra hændelser: Output, feedback og stop‑regel i AI‑guardrails
På dette stadium af AI‑guardrails skal systemet eskalere, logge og forbedre fra hændelser. Det relevante spørgsmål er ikke blot, om handlingen finder sted, men hvilken information den forbruger, hvilken tilstand den ændrer, og hvilket bevis der viser, at ændringen er gyldig. En reviewer skal kunne skelne handlingen fra en enkelt systemprompt, der forventes at håndhæve hver grænse og reproducere resultatet under de samme angivne betingelser.
Overgangen til dette AI‑guardrails‑stadium begynder med at inspicere output og ændret tilstand og bør ende med et resultat, der kan understøtte overvågning eller en endelig beslutning. Registrer usikkerhed, afviste alternativer, ressourceforbrug og enhver menneskelig eller softwarekontrol, der anvendes ved grænsen. Det spor er, hvor teams kan opdage, om guardrails kan blokere legitimt arbejde, omgås eller skabe en falsk tryghedsfølelse, før den samme svaghed fører til et væsentligt output.
Læs AI‑guardrails‑kortet fremad for at forstå produktionen og bagud for at diagnosticere fejl. Fremadrettet analyse spørger, hvordan ét stadium leverer til det næste. Bagudrettet analyse starter fra et forkert, langsomt, dyrt eller usikkert resultat og sporer, hvilken tidligere antagelse der tillod det. Den omvendte vej er ofte, hvor et team opdager, at den afgørende fejl opstod, før modellen producerede noget.
Et gennemarbejdet AI‑guardrails‑eksempel
En finansassistent kan udforme en overførselsinstruktion, men en deterministisk regel og en autoriseret reviewer skal godkende udførelsen.
Dette eksempel er oplysende, fordi AI‑guardrails kan knyttes til observerbare input, mellemliggende tilstande og et udfald i stedet for at blive bedømt ud fra en poleret demonstration. En stringent test ville konstruere almindelige, vanskelige og bevidst vildledende tilfælde omkring scenariet, bevare en baseline uden teknikken og registrere både gennemsnitlig ydeevne og alvoren af individuelle fejl.
Ændr én antagelse i AI‑guardrails‑eksemplet og gentag analysen. Fjern et påkrævet input, introducér et modstridende signal, begræns beregning, ændr brugerpopulationen eller tving systemet til at afstå. En mekanisme, der kun lykkes under én omhyggeligt arrangeret demonstration, har ikke påvist, at den generaliserer til driftsmiljøet.
AI‑guardrails vs. den mest almindelige genvej
AI‑guardrails reduceres ofte til en enkelt systemprompt, der forventes at håndhæve hver grænse. Denne reduktion fjerner den grænse, der definerer begrebet. Det kan føre til, at købere sammenligner uens produkter, forskere overdriver, hvad et eksperiment demonstrerer, og operatører overvåger det forkerte signal efter implementering.
| Linse | Praktisk svar |
|---|---|
| Definition | AI guardrails er lagdelte tekniske og proceduremæssige kontroller, der begrænser input, handlinger, output og eskalering omkring en model eller agent. |
| Forvirring | en enkelt systemprompt forventet at håndhæve hver grænse. |
| Risiko | guardrails kan blokere legitimt arbejde, omgås eller skabe en falsk følelse af sikkerhed. |
Sammenligningen bør også identificere analyseenheden. Et papir om AI guardrails kan isolere en model eller algoritme, mens en implementeret tjeneste tilføjer hentning, routing, caching, politik, identitet, brugergrænseflader og overvågning. To produkter kan bruge samme overskriftsterm, mens de implementerer forskellige dele af den stack. Spørg hvilken komponent der udfører den afgørende transformation, og hvilke andre komponenter der er nødvendige for det rapporterede resultat.
Hvorfor AI Guardrails er vigtige i nuværende AI-systemer
AI guardrails er vigtige nu, fordi AI-systemer får større kontekster, flere modaliteter, mere runtime-beregning, bredere værktøjstilgang og dybere forbindelser til organisatoriske beslutninger. Under disse forhold kan det, der engang så ud som en forskningsdetalje, bestemme latenstid, sikkerhed, tilgængelighed, miljøomkostninger, produktkvalitet eller juridisk ansvar.
Den relevante måling er ikke, om AI guardrails kan levere ét imponerende resultat. Det er, om teknikken forbedrer et resultat, der betyder noget på tværs af repræsentative betingelser, og gør det mere effektivt end en enklere baseline. Rapportér fordelinger, fejlkategorier, hale-latenstid, ressourceforbrug og berørte undergrupper i stedet for at komprimere hvert resultat til et enkelt gennemsnit.
Overvåg både tekniske målinger og påvirkninger på mennesker. Dokumentér usikkerhed, bevar oprindelse, gør eskalering mulig, og design genopretning, før systemet udsættes for skiftende virkelige forhold. Anvendt specifikt på AI guardrails gør den disciplin beviserne bærbare: et andet team kan vurdere, om den påståede gevinst sandsynligvis vil holde i en anden model, sprog, hardwareplatform, datasæt, brugerpopulation eller risikotolerance.
Fordele AI Guardrails kan levere
Den stærkeste grund til at bruge AI guardrails er, at de kan adressere deres tilsigtede flaskehals direkte. Afhængigt af implementeringen kan fordelen vise sig som bedre forankring, en mere trofast repræsentation, forbedret generalisering, lavere latenstid, reduceret hukommelsesbevægelse, klarere ansvarlighed eller en sikrere grænse mellem et modelforslag og en reel handling.
Fordele bør udtrykkes som beslutninger og målinger. “Mere intelligent” er ikke et acceptkriterium for AI guardrails. Et nyttigt mål kan specificere fejlrate på svære tilfælde, genopretning efter modstridende beviser, omkostning ved et percentil af trafikken, tid til menneskelig gennemgang, kalibrering eller procentdelen af handlinger, der holdes inden for en defineret myndighedsgrænse.
Fejltilstanden der definerer AI Guardrails
Den centrale begrænsning er, at guardrails kan blokere legitimt arbejde, omgås eller skabe en falsk følelse af sikkerhed. Denne fejl er ikke en eftertanke, der skal listes, når udviklingen er afsluttet. Den bør forme dataindsamling, arkitektur, tilladelser, evaluering, frigivelsesgateways og overvågning af AI guardrails fra starten.
En kontrol for AI guardrails er kun nyttig, hvis den virker før en dyr eller irreversibel konsekvens. Identificér den tidligste observerbare forløber til fejlen, fastsæt en tærskel eller regel, tildel en ansvarlig ejer, og test genopretning. Afhængigt af anvendelsestilfældet kan genopretning betyde at afholde sig, falde tilbage på et enklere system, anmode om mere bevis, eskalere til en person, rulle en model tilbage eller stoppe en handling fuldstændigt.
En evalueringsplan for AI Guardrails
Start evalueringen af AI guardrails ved at formulere den beslutning, som beviserne skal understøtte. Definér den opererende population, konsekvensen af et forkert resultat, den information, der faktisk er tilgængelig på beslutningstidspunktet, og det enkleste troværdige alternativ. Dette forhindrer, at et benchmark bliver målet blot fordi det er nemt at køre.
Brug et urørt testdatasæt til kontrollerede sammenligninger, og valider derefter AI guardrails i et trinvis driftsmiljø. Offline-evaluering gør varianter sammenlignelige; shadow mode, canaries, rate limits eller approval gates afslører, hvordan real traffic, feedback loops og mennesker ændrer adfærd. Implementeringsfasen bør have en eksplicit stop‑betingelse i stedet for at antage, at hver forbedring fortjener fuld rollout.
Versionér de input, der er nødvendige for at reproducere AI guardrails: source data, preprocessing, tokenizer eller encoder, model weights, configuration, prompt eller policy, retrieval index, evaluation set, hardware assumptions og serving code efter behov. Uden lineage kan et team ikke afgøre, om et ændret resultat skyldes teknikken, miljøet eller en uopdaget pipeline edit.
Spørg til sidst, hvilken observation der ville falsificere påstanden om, at AI guardrails hjælper. Hvis ingen resultat kan omvende vedtagelsesbeslutningen, er evalueringen blot marketing. Forudcommitted acceptance thresholds og et bevaret confirmation set gør øvelsen til evidens.
Spørgsmål at stille inden adoption af AI guardrails
- Objective: Hvilket målbare flaskehals er AI guardrails beregnet til at løse?
- Mechanism: Hvilken af de fem faser indeholder den karakteristiske transformation?
- Baseline: Hvordan sammenlignes den med en enkelt system prompt, der forventes at håndhæve hver grænse, eller et andet enklere alternativ?
- Evidence: Hvilke almindelige, vanskelige, adversarielle og undergruppe‑sager blev testet?
- Operations: Hvilke latency, memory, compute, energy, maintenance og review omkostninger opstår i skala?
- Risk: Hvordan vil teamet opdage, at guardrails kan blokere legitimt arbejde, omgås eller skabe en falsk følelse af sikkerhed?
- Recovery: Kan systemet afholde sig, falde tilbage, rulle tilbage eller eskalere før skade?
Primære kilder til studier af AI guardrails
Autoritative udgangspunkt for den del af AI‑stakken, der omfatter AI guardrails, inkluderer NIST AI Risk Management Framework, C2PA specifications, NIST Privacy Framework. Læs dem sammen med dokumentationen for den præcise model, datasæt, hardware og jurisdiktion, der er involveret. En generel kilde kan definere mekanismen, men kun deployment‑specific evidence kan fastslå, at en bestemt implementering er egnet.
Hvad man skal huske om AI guardrails
AI guardrails er en defineret mekanisme inden for et større socioteknisk system. Dens værdi kommer fra at forbedre et specifikt resultat under eksplicitte betingelser, ikke fra selve betegnelsen. Det fem‑trins kort gør informationsflowet synligt, sammenligningen identificerer, hvad den ikke er, og kontrolstien viser, hvor en ansvarlig operatør kan gribe ind.
Den praktiske regel for AI guardrails er at definere målet, sammenligne med en troværdig baseline, teste den fejl, der betyder mest, og bevare de beviser, der er nødvendige for at overvåge ændringer. Med disse elementer på plads bliver konceptet et ingeniør‑ og governance‑valg, der kan evalueres. Uden dem forbliver det et lovende navn knyttet til en ukendt driftsrisiko.


