
Tankeledere
Det næste AI-energi-flaskehals vil være i byerne

 Føj Unite.AI til dine foretrukne kilder på Google
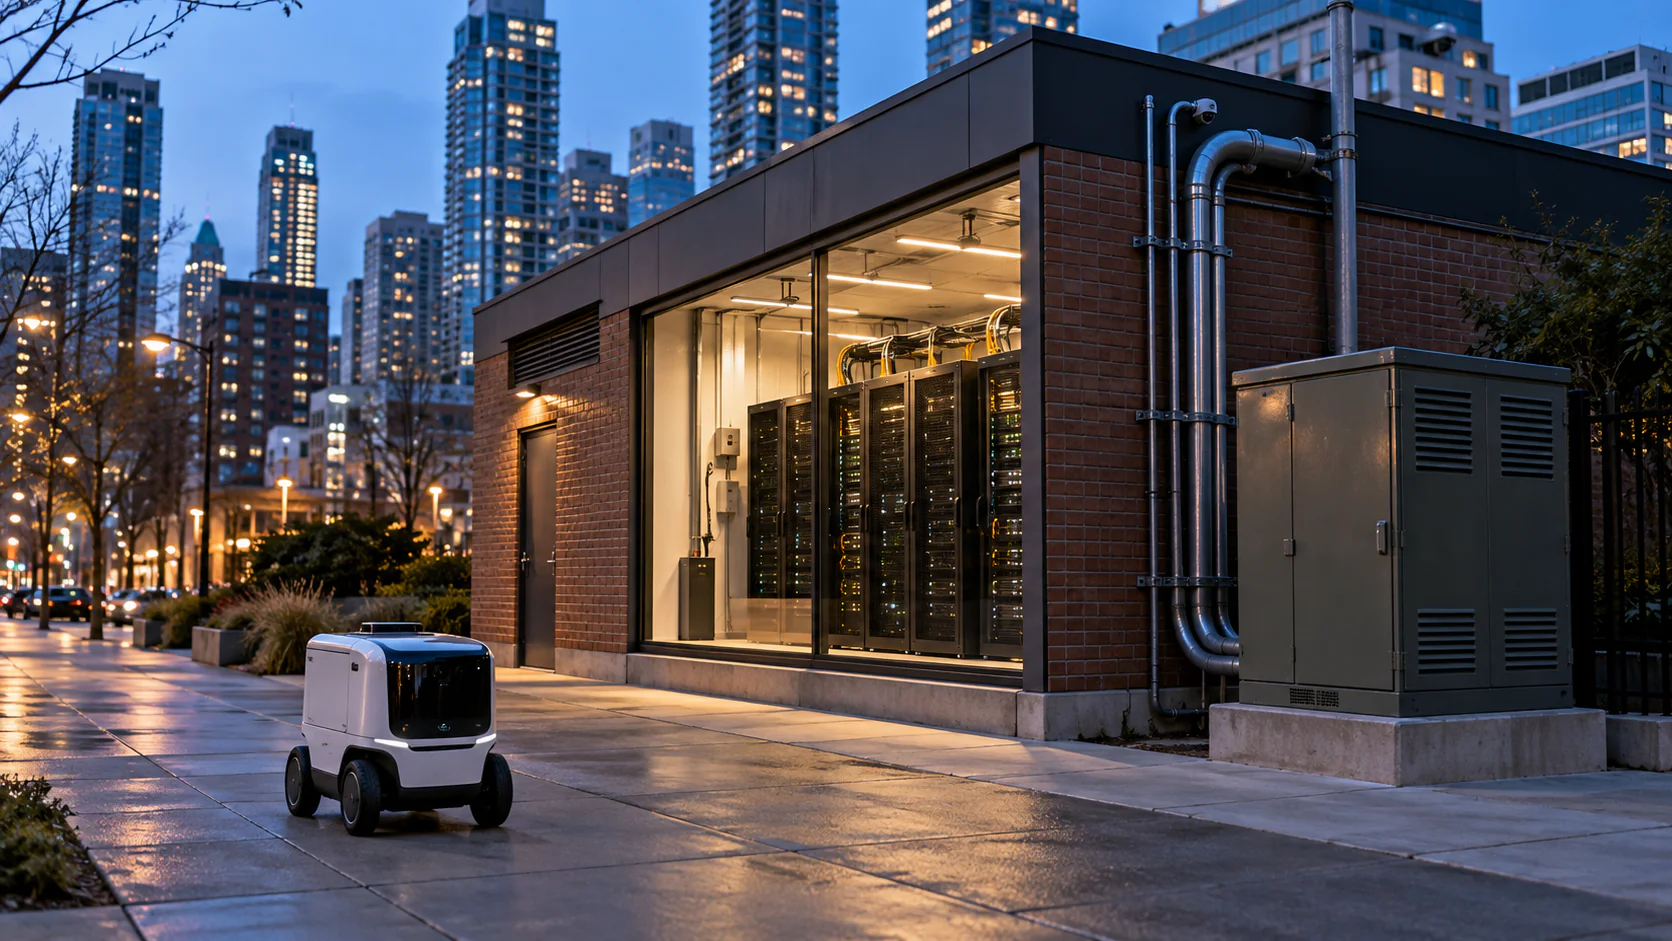
De seneste år, og tallet vokser, har AI‑infrastrukturmarkedet brugt en enorm mængde tid og penge (tæt på $7 trillion af datacenterinvesteringer inden 2030, ifølge McKinsey) på at lære, hvordan man bygger store datacentre, hvor der er strøm tilgængelig. “Hvor som helst” er nøgleordet, fordi placeringen ikke var særlig vigtig. Et træningsklynge har blot brug for adgang til tilstrækkelig strøm. Men placeringen begynder nu at blive stadig mere relevant, efterhånden som AI’s anvendelse vokser ud over chat‑grænseflader til maskiner, stemmesystemer, video og applikationer, der interagerer med den fysiske verden. Sådanne operationer kræver, at beregningskraft er tættere på de urbane centre, hvor disse interaktioner finder sted for at holde latensen nede. Mens værktøjer som chatbots kan tolerere en halvt sekunders forsinkelse, kan automatiserede serviceapplikationer som fjernstyrede leveringsrobotter, live stemmeassistenter eller automatiserede opfyldelsessystemer have brug for at reagere inden for millisekunder.
Dette er den nye udfordring for AI‑virksomheder. Hvordan kan man finde mindre blokke af pålidelig strøm i og omkring store storbyområder? Og selv efter at placeringerne er blevet opspurgt, hvordan håndteres den modstand, som selv fjern‑datacentre står over for?
Efterspørgslen efter AI i urbane centre stiger
Der er en stigende efterspørgsel inden for den urbane sfære efter AI, der går ud over personlig brug af chatbots eller enhver hyperfokusering på robotter. Et IMF‑arbejdspapir anslår, at elforbruget fra datacentre og AI allerede havde nået 400–500 TWh globalt i 2023, og AI‑drevet forbrug potentielt kunne nå 1.500 TWh inden 2030. Den automatisering, der kræves for at gøre simple operationer mere effektive — hvad enten det er behandling af papirarbejde eller arkivering af video — kræver meget strøm i stor skala.
Byerne er i frontlinjen, som det ses i en OECD‑gennemgang af 250 byer på tværs af 78 lande. Den fandt, at 56 % allerede aktivt brugte AI, mens yderligere 35 % pilotere eller planlagde implementeringer. For at illustrere et enkelt brugstilfælde, lad os overveje overvågningskameraer i byen. IHS Markit anslog for flere år siden, at antallet af overvågningskameraer på verdensplan ville overstige en milliard. Selvom de primært bruges til optagelsesformål, anvendes de nu også til andre, mere beregningsintensive opgaver, f.eks. sporing af objekter på tværs af et netværk eller søgning i store videoarkiver ved hjælp af naturligt sprog. Sådanne processer kan ikke udføres i hvert kamera med den nuværende AI‑behandling, vi har. Skal de sendes ud af byen til et fjerntliggende datacenter for at blive behandlet? Det er upraktisk på grund af datalovgivning og også omkostningerne ved at flytte så store datamængder.
En nylig Gallup‑undersøgelse viser, at omkring 30 % af private og offentlige sektors ansatte bruger AI i deres rolle, og tallene stiger. Disse sektorer — hvad enten det er banker, hospitaler eller offentlige organisationer — støder på de samme problemer. De ønsker AI‑infrastruktur inden for deres egen jurisdiktion og fysisk tæt nok på for at kunne kontrollere den. Deres interaktive stemmesystemer og videoapplikationer forringes, når netværkslatensen stiger. Selv hvis problemet i starten kan omgås ved at beholde en menneskelig operatør for den første generation af autonome systemer, er den supervision i sig selv ikke særlig tolerant over for latens. For eksempel kræver leveringsrobotter og hjemme‑robotter, der overvåges via en video‑forbindelse, en fuld kommunikationssløjfe, der skal holde sig under omtrent 80 millisekunder ifølge en fjern‑robotisk teleoperationsundersøgelse. Autonome biler er derimod undtagelsen: kørslen foregår ombord af sikkerhedshensyn, og Waymos fjernoperatører arbejder med en kvart sekunders latens, nogle af dem fra et andet kontinent. Det, byen arver fra autonome flåder, er deres data, ikke deres rat.
Datacentermarkedet undervurderer denne efterspørgselsstigning. The World Bank offentliggjorde et papir viser hvordan kommuner i lande som Argentina, Indien og Etiopien, blandt andre, har taget AI i brug inden for retfærdighed, antikorruption, told, offentlig administration og serviceforbedring. Dette er ikke en lokal forekomst. Det er en global transformation. Hos Teravolt er vores estimat, at et storbyområde med 10 til 15 millioner indbyggere kunne understøtte omkring 6 til 13 MW af kontinuerlig latens‑følsom AI‑belastning inden 2030, før generelle robotter bliver masseproduceret. Det kan argumenteres, at det ikke er et så stort tal efter hyperskala‑standarder, men at finde det på det rette sted er betydeligt sværere, end det ser ud. I 2036 vil det samme storbyområde gå op på 22 til 50 MW af latens‑følsom belastning — og til 60 til 100 MW, hvis bilindustrien begynder at producere robotter i bilskala. Efterspørgselsekonomien er ubarmhjertig på den bedste måde: et par hundrede dollars om året i serveromkostninger på en maskine, der erstatter $30.000 til $60.000 i arbejdskraft, er en efterspørgsel, der ikke forhandler om prisen.
Tilføjelse af et fjerde lag til beregning
I øjeblikket findes beregningskraft til AI på tre niveauer. Det øverste lag består af gigafabrikker, der bruges til at træne modeller. Deres placering betyder kun noget for udviklere i det omfang, de sikrer store mængder strøm til en acceptabel pris. Derefter kommer regionale AI‑faciliteter, typisk omkring 20 til 200 MW, hvor en stor del af den tilbagevendende inferens‑efterspørgsel i store cloud‑ og enterprise‑operationer forekommer. Endelig har vi beregningskraft, der er indlejret direkte i enheden eller robotten.
Der ser ud til at være et hul mellem de sidste to lag, som jeg identificerer som det urbane lag – hullet, der er ansvarligt for latenstidsproblemer. Disse skal placeres inde i eller meget tæt på store byer. De skal måles i enkeltcifrede eller lave tocifrede megawatt, mens de er placeret inden for storbyområder og forbundet til høj‑kvalitets fiber. Udgangspunktet kan være omkring 2 MW, hvis stedet har garanteret strøm. For at illustrere praktikaliteten, overvej en leveringsrobot. Den håndterer forskellige anmodninger, og ikke alle kan behandles på selve enheden. Mens den trænes på gigafabrikken, vil mere avanceret assistance i realtid skulle behandles af en nærliggende urban facilitet i stedet for at sende den til en regional facilitet hver gang.
Problemet med tovejs trafik
Urbane datacentre vil ikke blot være mellemliggende punkter for modtagelse af data fra træningscentre, men de vil også producere store mængder data, som skal sendes tilbage op gennem pipeline’en.
Alle autonome maskiner og sensorsvære systemer vil akkumulere information, som skal behandles og sendes tilbage for at blive integreret i træning. Flåder af robotter, der vender tilbage til deres opladningsstationer efter en vagt, vil sende enorme nyttige oplysninger om kanttilfælde og daglige operationer, som datacentre har brug for at forbedre funktionerne. Forestil dig al denne trafik, der sendes på én gang i samme retning. Det vil skabe en flaskehals. Det er også her, det urbane datacenter er praktisk, da det kan behandle en del af belastningen, før den overvælder den regionale beregningsfacilitet. Det kan identificere og forkaste nogle fejlagtige data, mens det komprimerer og viderefører de nyttige dele.
I bund og grund giver det urbane datacenter et yderligere filtreringslag til de to foregående lag, hvilket gør dataflowet endnu mere organiseret.
Er fremtiden en server på hver blok?
Selvom jeg præsenterer urbane servere som en løsning, er det også simpelthen for dyrt at løse latenstidsproblemer med ukontrolleret udbredelse. Uanset størrelsen kræver et datacenter stadig en netforbindelse, transformere, køling, sikkerhed, netværk og personale. Disse omkostninger falder ikke proportionelt med IT-belastning. For at sætte det i perspektiv bærer en 0.5 MW facilitet stadig mange af de samme faste omkostninger som en meget større facilitet.
I vores projekter har vi set, at et selvstændigt urbant datacenter bliver økonomisk rentabelt ved omkring 5 til 8 MW. Selv hvis man antager, at flere steder kan dele et netværksoperationscenter, falder tærsklen kun til 1,5 til 3 MW. Derfor er bundlinjen stadig den samme. At splitte 20 MW over tyve lokationer i stedet for to eller tre sparer næsten ingen latenstid inden for et storbyområde – byfiberringet er kun et par millisekunder bredt – mens det multiplicerer kapital og driftsomkostninger.
Derfor mener jeg, at branchen skal nedskalere og bygge det, jeg kalder “understationer for intelligens”. I øjeblikket lærer udviklere at bygge regionale faciliteter i området 20 til 100 MW. Det fremtidige mål er at anvende dette på endnu mindre, urbane steder for at nå 2 MW‑niveauet, som er egnet til store byer.
Den politiske hindring
Udover den økonomiske rentabilitet forbliver den politiske udfordring stadig. Datacentre er blevet stadig mere fordømt i medierne for deres negative påvirkning af miljøet. Ifølge en Pew‑undersøgelse mener mere end halvdelen af amerikanerne, at datacentre er skadelige for miljøet og har en negativ holdning til dem. Argumentet om jobskabelse blegner i forhold til den mængde vand, jord og elektricitet, der forbruges; samt støj og emissioner, der genereres. At få godkendelser selv for mindre urbane faciliteter vil vise sig at være svært.
Vi ser allerede eksempler på, at datacenter‑udviklere og bymyndigheder er i konflikt. I USA har xAI’s brug af gasturbiner til at accelerere deres udbygning i Memphis ført til tilladelsesstridigheder, lokalsamfundsmotstand og retssager. Europa er gået længere: Amsterdam indførte et moratorium for faciliteter over 70 MW, Dublin tillader nu kun nye datacentre, hvis de medbringer egen generation eller lagring, og den centrale understation i West London‑korridoren vil ikke blive forstærket før begyndelsen af 2030‑erne. Selv uden sådanne højprofilerede sager, da dette er et nyt stridspunkt, har mange bymyndigheder ikke en klar godkendelsesproces for at godkende yderligere 10 MW AI‑infrastruktur inden for det urbane område. Som bemærket i en National League of Cities‑rapport, er en af de mest almindelige udfordringer for byer, at ældre lokale zoneringskoder ikke eksplicit adresserer datacentre, hvilket fører til sags‑for‑sag‑gennemgang. Sådanne juridiske usikkerheder kan forsinke selv teknisk gennemførlige projekter.
Infrastrukturbeslutninger i dag former vores kapacitet for fremtiden
Alt dette betyder, at vi skal planlægge og bygge den nødvendige infrastruktur for fremtidige fremskridt inden for AI på forhånd. Fordi mens modeller udvikler sig hurtigt, afhænger den strøm, der kræves for at køre dem, af en type infrastruktur, der tager tid at opføre. Netforbindelser kan tage år, og i nogle store datacentermarkeder er køerne nu strækker sig til syv til ti år. Så hvis byerne øger AI-beregningskapaciteten inden 2030, skal den elektriske infrastruktur være på plads allerede nu. Hos Teravolt estimerer vores arbejdsmodel den globale urbane AI-efterspørgsel til 9–18 GW i 2036. Det indebærer omkring 1000 til 1500 betydelige by- og storbysteder verden over, afhængigt af den gennemsnitlige anlægsstørrelse, og samlet set kunne det udgøre et marked på cirka $500 milliarder til $1 billion.
Hvis den nødvendige planlægning ikke gennemføres, vil vi sidde fast med avanceret AI-kapacitet, som vi ikke kan udnytte. Mobilæraen krævede en infrastruktur af tårne for radiodækning, så folk kunne følge med, ellers ville mobiltelefonen have været overflødig. På samme måde skal vi erkende mismatchen mellem AI’s udvikling og opbygningen af den elektriske infrastruktur. Hvor mobilæraen målte dækning i signalstyrker, vil AI-æraen måle den i millisekunder og watt per indbygger — og den vil ikke have brug for millioner af tårne, men snarere omkring tusind faciliteter på størrelse med en transformatorstation. Fiber, millisekunder og megawatt er valutaen i dette felt, og de, der forudser denne knaphed, er bedre rustet til at forme fremtiden.


