
Interviews
Roshanak Houmanfar, vicepræsident for maskinlæringsprodukter hos integrate.ai – interviewserie

 Føj Unite.AI til dine foretrukne kilder på Google
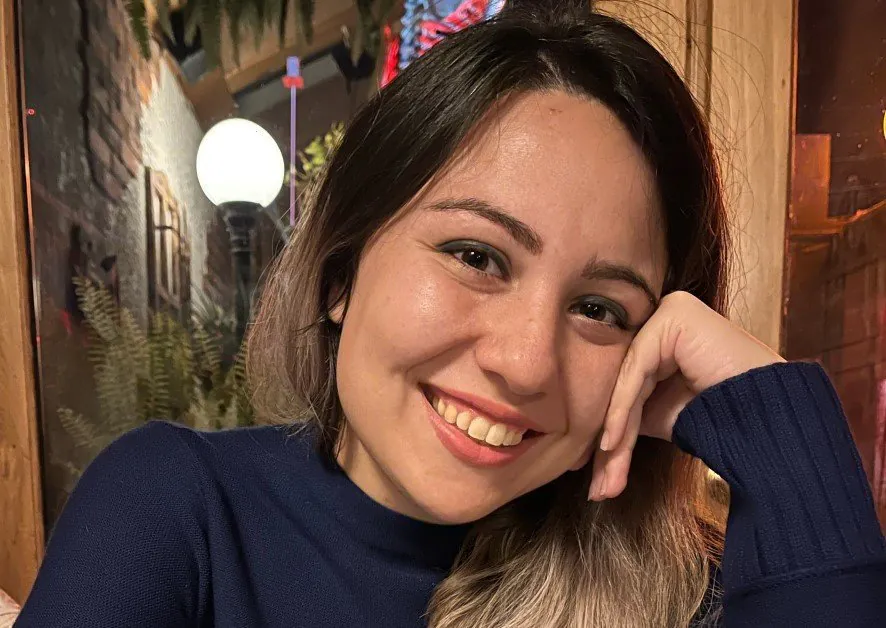
Roshanak (Ro) Houmanfar er vicepræsident for produkter inden for maskinlæring hos integrate.ai, en virksomhed, der hjælper udviklere med at løse verdens vigtigste problemer uden at bringe følsomme data i fare. Ro har et særligt talent for at finde nye måder at forenkle komplekse AI-begreber på og forbinde dem med brugernes behov. Med denne ekspertise står hun i spidsen for integrate.ai’s mission om at gøre teknologi, der styrker privatlivets fred, tilgængelig for alle.
Hvad tiltrak dig oprindeligt ved datavidenskab og maskinlæring?
Jeg begyndte min rejse inden for robotteknologi. Efter at have afprøvet forskellige sider af robotteknologien og brændt et svejselaboratorium ned indså jeg, at jeg var mere tiltrukket af den kunstige intelligens i mit fagområde. Det førte mig ind i maskinlæringens vidunderlige verden.
Kan du beskrive din nuværende rolle og en typisk arbejdsdag?
Jeg er vicepræsident for produkter hos integrate.ai, en SaaS-virksomhed, der hjælper udviklere med at løse verdens vigtigste problemer uden at bringe følsomme data i fare. Vi udvikler værktøjer til maskinlæring og analyse, der beskytter privatlivet, til en fremtid med distribuerede data.
I mit daglige arbejde samarbejder jeg med teams på tværs af funktioner om tre ting:
At overveje, hvordan fremtidens intelligens kan se ud, og hvordan vi kan forme den, så intelligensen løser de mest afgørende problemer.
At forstå kundernes udfordringer, og hvordan vi kan skabe nye løsninger, der gør deres arbejde mere virkningsfuldt og effektivt.
At sikre, at vores vision og kundernes tilbagemeldinger altid indgår i produktudviklingen, og samarbejde med vores teams om at levere de bedste funktioner.
Syntetiske data er meget populære inden for maskinlæring, men integrate.ai vælger en lidt anderledes tilgang. Hvornår er syntetiske data måske ikke et ønskeligt valg?
For at forstå, hvornår syntetiske data ikke er den bedste løsning, må man først forstå, hvornår de er det. Syntetiske data er bedst, når der kun findes få eller slet ingen virkelige data til modelleringsopgaven, for eksempel ved koldstartproblemer og træning af tekst- og billedbaserede modeller. Nogle gange er der ganske enkelt ikke tilstrækkelige data til at træne en model. Her er syntetiske data en god løsning.
Syntetiske data bruges imidlertid i stigende grad, når der findes masser af virkelige data, som er isoleret på grund af privatlivsregler, centraliseringsomkostninger eller andre hindringer for interoperabilitet. Det er et åbenlyst misbrug af syntetiske data. I disse tilfælde er det vanskeligt at vælge det rette abstraktionsniveau ved fremstillingen af syntetiske data. Resultatet bliver data af lav kvalitet, som kan skabe indbyggede skævheder eller andre problemer, der senere er vanskelige at fejlfinde. Modeller trænet på syntetiske data kan heller ikke måle sig med modeller trænet på virkelige, detaljerede kildedata af høj kvalitet.
Integrate.ai tilbyder løsninger til fødereret læring. Kan du beskrive, hvad det er?
Ved traditionel maskinlæring skal alle modellens træningsdata samles i én database. Ved fødereret læring kan modeller trænes på decentrale, distribuerede datasæt, altså data i to eller flere separate databaser, som ikke let kan flyttes. Dele af en maskinlæringsmodel trænes der, hvor dataene befinder sig, og modelparametrene deles mellem de deltagende datasæt for at skabe en forbedret global model. Fordi ingen data flyttes i systemet, kan organisationer træne modeller uden hindringer som privatlivs- og sikkerhedsregler, omkostninger eller andre problemer ved centralisering.
De træningsdata, der er tilgængelige gennem fødereret læring, er generelt også af langt højere kvalitet. Centraliserede data mister typisk noget af deres detaljeringsgrad til gengæld for, at de er let tilgængelige ét sted.
Hvordan finder en virksomhed de bedste anvendelser af fødereret læring?
Fødereret læring er en samling maskinlæringsteknologier til situationer, hvor det er besværligt at få adgang til data eller føre dem ind i en traditionel maskinlæringsinfrastruktur med centrale datasøer. Fødereret læring er relevant, hvis du oplever et af følgende forhold:
- Du tilbyder intelligente produkter baseret på analyse og maskinlæring, men kan ikke skabe netværkseffekter for produkterne, fordi kunderne ejer dataene.
- Du arbejder med langvarige rammeaftaler om tjenester eller aftaler om datadeling for at få adgang til partneres data.
- Du bruger meget tid på samarbejdsaftaler med partnere, især når resultatet af datasamarbejdet er uklart.
- Du har mange data og vil tjene penge på dine datasæt, men frygter konsekvenserne for dit omdømme.
- Du tjener allerede penge på dine data, men bruger meget tid, arbejde og mange penge på at gøre dem sikre at dele.
- Din infrastruktur er blevet efterladt under overgangen til skyen, men du har stadig brug for analyse og maskinlæring.
- Du har mange datterselskaber i samme organisation, som ikke kan dele data direkte med hinanden.
- Dine datasæt er for store eller dyre at flytte, så du har valgt ikke at bruge dem, eller dine ETL-processer koster meget.
- Du har en anvendelse eller mulighed, som du mener kan gøre en væsentlig forskel, men mangler selv de nødvendige data.
- Dine maskinlæringsmodeller er holdt op med at forbedre sig, og du ved ikke, hvordan du kan forbedre dem yderligere.
Differentiel privatlivsbeskyttelse bruges ofte sammen med fødereret læring. Hvad er det helt præcist?
Differentiel privatlivsbeskyttelse sikrer privatlivet, samtidig med at man udnytter maskinlæringens muligheder. Den bruger andre matematiske metoder end almindelige afidentifikationsteknikker og tilføjer støj under den lokale modeltræning. Dermed bevares de fleste statistiske egenskaber i datasættet, mens risikoen for at identificere en enkelt persons data begrænses.
I ideelle implementeringer bringer differentiel privatlivsbeskyttelse risikoen tæt på nul, mens maskinlæringsmodellerne bevarer en tilsvarende ydeevne. Det giver den nødvendige sikkerhed ved afidentifikation af data uden at forringe kvaliteten af modellens resultater.
Differentiel privatlivsbeskyttelse er som standard indbygget i integrate.ai‘s platform, så udviklere kan sikre, at individuelle data ikke kan udledes af modelparametrene.
Kan du beskrive, hvordan integrate.ai’s platform til fødereret læring fungerer?
Vores platform bruger fødereret læring og differentiel privatlivsbeskyttelse til at åbne en række muligheder for maskinlæring og analyse på data, som ellers ville være vanskelige eller umulige at få adgang til på grund af privatliv, fortrolighed eller tekniske hindringer. Modeltræning og analyse udføres lokalt, og kun de endelige resultater sammenlægges sikkert og fortroligt.
integrate.ai leveres som et udviklerværktøj. Med et brugervenligt softwareudviklingssæt (SDK) og en tilhørende skytjeneste til styring af hele processen kan udviklere integrere funktionerne i næsten enhver løsning. Efter integrationen kan slutbrugere samarbejde på tværs af følsomme datasæt, mens de dataansvarlige bevarer fuld kontrol. Løsninger med integrate.ai kan både være effektive forsøgsredskaber og tjenester, der er klar til produktion.
Kan du give eksempler på anvendelser inden for præcisionsdiagnostik?
Et af vores partnernetværk, Autism Sharing Initiative, indsamler oplysninger om autismediagnostik og prøver af genomdata for at forstå sammenhængene mellem forskellige genotyper, fænotyper og autismediagnoser. Hvert enkelt datasted har ikke nok data til velfungerende maskinlæringsmodeller, men tilsammen skaber de en meningsfuld stikprøvestørrelse. Flytning af data indebærer imidlertid stor risiko for sikkerhed og privatliv. På grund af regler og hospitalernes politikker har forskningsinstitutionerne derfor altid som udgangspunkt undladt at dele data.
I et andet netværk med en lignende opbygning ønsker forskerne at forbedre fordelingen af patienter til kliniske forsøg ud fra et mere samlet billede af hver patients sygehistorie.
Institutionerne har forskellige oplysninger om hver patient. Ét laboratorium har medicinske scanninger, et andet har genomoplysninger, og en tredje institution har resultaterne fra kliniske forsøg. Organisationerne kan dog ikke dele oplysninger direkte med hinanden.
Med integrate.ai’s løsning kan hver organisation få adgang til de andres data til sine egne formål, uden at dataene flyttes væk fra de dataansvarlige, og dermed overholde sine interne politikker.
Hvorfor er det vigtigt at gøre privatlivsbeskyttelse forståelig, og hvordan hjælper integrate.ai?
Forståelig privatlivsbeskyttelse åbner mange døre for virksomheder og organisationer, som tidligere var lukket på grund af uklarhed om risikoen. Privatlivsregler som GDPR, CCPA og HIPPA er meget komplekse og kan variere med branche, region og datatype. Det gør det svært at afgøre, hvilke dataprojekter der beskytter privatlivet. I stedet for at bruge tid og arbejdskraft på at kontrollere hvert krav tilbyder integrate.ai’s platform indbygget differentiel privatlivsbeskyttelse, homomorf kryptering og sikker flerpartsberegning. Udviklere og dataansvarlige kan derfor være trygge ved, at projekterne automatisk overholder reglerne uden at skulle gennemgå hver kategoris formaliteter separat.
Er der andet, du vil fortælle om integrate.ai?
integrate.ai’s løsning er et meget udviklervenligt værktøj til maskinlæring og analyse på følsomme datakilder med overholdelse af regler, beskyttelse af privatlivet og sikkerhed. Gennem brugervenlige API’er skjules kompleksiteten ved regeloverholdelse og kontrakter om følsomme data. Dataforskere og softwareudviklere kan administrere deres arbejdsopgaver sikkert med minimal påvirkning af deres nuværende infrastruktur og arbejdsgange.
Tak for interviewet. Læsere, der vil vide mere, kan besøge integrate.ai.






