
Interviews
Razi Raziuddin, medstifter og administrerende direktør for FeatureByte – Interviewserie

 Føj Unite.AI til dine foretrukne kilder på Google
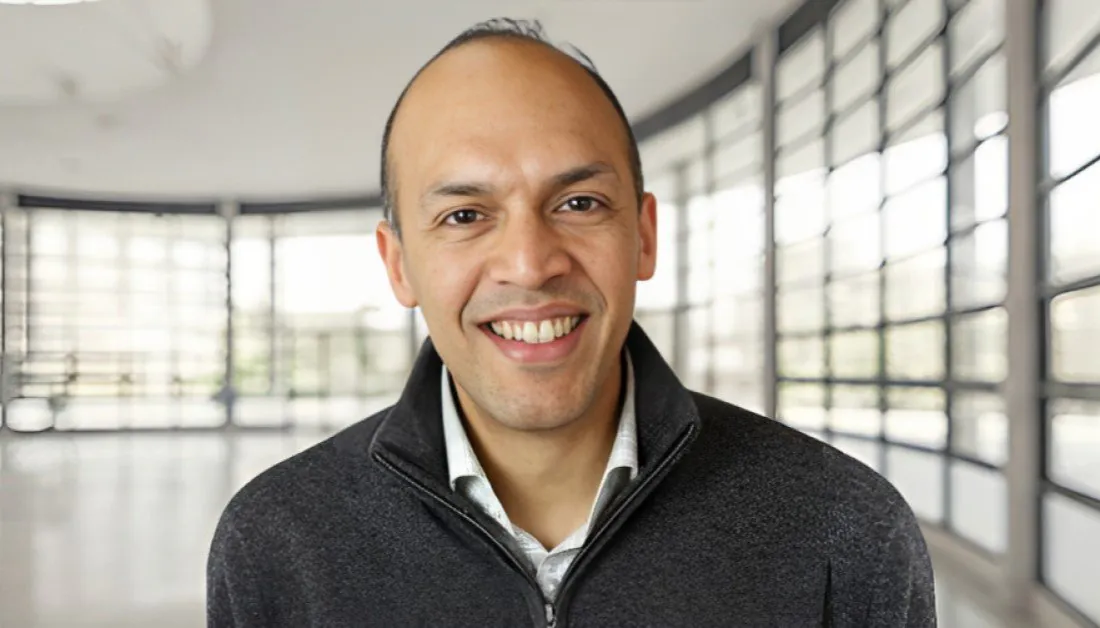
Razi Raziuddin er medstifter og administrerende direktør for FeatureByte, hans vision er at løse den sidste store hindring for at skalere AI i virksomhederne. Razi’s erfaring med analytics og vækst omfatter ledelsesholdet i to unicorn-startups. Razi hjalp med at skalere DataRobot fra 10 til 850 ansatte på under seks år. Han var pioner for en services-led go-to-market-strategi, der blev et kendetegn for DataRobots hurtige vækst.
FeatureByte er på en mission til at skalere enterprise AI ved at radikalt simplificere og industrialisere AI-data. Feature engineering og management (FEM) platformen giver data scientists mulighed for at oprette og dele state-of-the-art modelvariable og produktionsklare data pipelines på få minutter – i stedet for uger eller måneder.
Hvad var det, der oprindeligt tiltrak dig til computervidenskab og maskinlæring?
Som en person, der startede med at kode i gymnasiet, var jeg fascineret af en maskine, som jeg kunne “tale” til og kontrollere gennem kode. Jeg var straks fascineret af de uendelige muligheder for nye anvendelser. Maskinlæring repræsenterede et paradigmeskift i programmering, der tillod maskiner at lære og udføre opgaver uden at man behøver at angive trinnene i kode. De uendelige muligheder for ML-anvendelser er det, der får mig til at være begejstret hver dag.
Du var den første forretningsansættelse i DataRobot, en automatiseret maskinlæring platform, der giver virksomheder mulighed for at blive AI-drevne. Du hjalp derefter med at skalere virksomheden fra 10 til 1.000 ansatte på under 6 år. Hvad var nogle af de vigtigste erfaringer fra denne oplevelse?
At gå fra nul til én er svært, men utrolig spændende og givende. Hver fase i virksomhedens udvikling præsenterer et nyt sæt udfordringer, men at se virksomheden vokse og lykkes er en fantastisk følelse.
Min erfaring med AutoML åbnede mine øjne for de ubegrænsede muligheder for AI. Det er fascinerende at se, hvordan denne teknologi kan anvendes på tværs af så mange forskellige brancher og anvendelser. Til sidst handler det om at skabe en ny kategori, hvilket er en sjælden præstation, men en utrolig givende oplevelse. Mine vigtigste erfaringer fra oplevelsen:
- Byg et fantastisk produkt, og undgå at jagte kortvarige modeluner
- Vær ikke bange for at gå imod strømmen
- Fokuser på at løse kundernes problemer og give værdi
- Vær altid åben for innovation og prøv nye ting
- Skab og forankr den rette virksomhedskultur fra begyndelsen
Kan du dele historien bag FeatureByte?
Det er en velkendt kendsgerning i AI/ML-verdenen – at god AI begynder med gode data. Men forberedelse, implementering og administration af AI-data (eller modelvariable) er kompleks og tidskrævende. Min medstifter, Xavier Conort, og jeg så dette problem førstehånds på DataRobot. Mens modellering er blevet kraftigt simplificeret takket være AutoML-værktøjer, forbliver feature engineering og management en enorm udfordring. Baseret på vores kombinerede erfaring og ekspertise følte Xavier og jeg, at vi kunne hjælpe virksomheder med at løse denne udfordring og opfylde løftet om AI overalt.
Feature engineering er i centrum af FeatureByte, kan du forklare, hvad dette er for vores læsere?
I sidste ende bestemmer datakvaliteten kvaliteten og ydeevnen af AI-modeller. Data, der indsættes i modeller for at træne dem og forudsige fremtidige resultater, kaldes modelvariable. Modelvariable repræsenterer information om enheder og begivenheder, såsom demografisk eller psykografisk data om forbrugere, eller afstanden mellem en kortholder og en forhandler for en kreditkortstransaktion eller antallet af varer af forskellige kategorier fra en butikskøb.
Processen med at omdanne rådata til modelvariable – for at træne ML-modeller og forudsige fremtidige resultater – kaldes feature engineering.
Hvorfor er feature engineering en af de mest komplicerede aspekter af maskinlæringsprojekter?
Feature engineering er super vigtigt, fordi processen er direkte ansvarlig for ydeevnen af ML-modeller. God feature engineering kræver tre ret uafhængige færdigheder, der kommer sammen – domæneviden, datavidenskab og dataingeniørarbejde. Domæneviden hjælper data scientists med at bestemme, hvilke signaler der skal udtrækkes fra data for et bestemt problem eller brugstilfælde. Du har brug for datavidenskabsfærdigheder for at udtrække disse signaler. Og endelig hjælper dataingeniørarbejde dig med at implementere pipelines og udføre alle disse operationer på stor skala på store datavolumener.
I de fleste organisationer bor disse færdigheder i forskellige hold. Disse hold bruger forskellige værktøjer og kommunikerer ikke godt med hinanden. Dette fører til en masse friktion i processen og bremser den, indtil den går i stå.
Kan du dele nogle indsigt i, hvorfor feature engineering er det svageste led i at skalere AI?
Ifølge Andrew Ng, en anerkendt ekspert i AI, “Anvendt maskinlæring handler grundlæggende om at udvikle modelvariable.” Trods dets kritiske betydning for maskinlæringslivscyklussen forbliver feature engineering kompleks, tidskrævende og afhængig af ekspertviden. Der er en alvorlig mangel på værktøjer til at gøre processen lettere, hurtigere og mere industrialiseret. Den indsats og ekspertise, der kræves, holder virksomheder tilbage fra at kunne implementere AI i stor skala.
Kan du dele nogle af udfordringerne bag at bygge en datacentrisk AI-løsning, der radikalt simplificerer feature engineering for data scientists?
At bygge et produkt, der har en 10X fordel over status quo, er super svært. Heldigvis har Xavier dyb datavidenskabelig ekspertise, som han anvender til at genoverveje hele feature-arbejdsgangen ud fra grundlæggende principper. Vi har et verdensklassehold af full-stack data scientists og ingeniører, der kan omdanne vores vision til virkelighed. Og brugere og udviklingspartnere til at rådgive os om at strømline UX til at løse deres udfordringer bedst muligt.
Hvordan vil FeatureByte-platformen fremskynde forberedelsen af data til maskinlæringsanvendelser?
Dataforberedning til ML er en iterativ proces, der afhænger af hurtig eksperimentering. Den open source FeatureByte SDK er en deklarativ ramme for at oprette state-of-the-art-modelvariable med kun få linjer kode og implementere data pipelines på få minutter i stedet for uger eller måneder. Dette giver data scientists mulighed for at fokusere på kreativ problemløsning og iterere hurtigt på live-data, i stedet for at bekymre sig om den tekniske grundinfrastruktur.
Resultatet er ikke kun hurtigere dataforberedning og servering i produktion, men også forbedret modelydeevne gennem kraftfulde modelvariable.
Kan du diskutere, hvordan FeatureByte-platformen yderligere vil tilbyde mulighed for at strømline forskellige pågående administrationsopgaver?
FeatureByte-platformen er designet til at administrere hele livscyklussen for modelvariable. Den deklarative ramme giver FeatureByte mulighed for at implementere data pipelines automatisk, mens den udtrækker metadata, der er relevant for administration af miljøet. Brugere kan overvåge pipeline-sundhed og omkostninger, og administrere modelvariablenes dataoprindelse, versioner og korrekthed alt fra samme GUI. Enterprise-klasse rollebaseret adgang og godkendelsesarbejdsprocesser sikrer databeskyttelse og sikkerhed, mens de undgår ukontrolleret vækst i antallet af modelvariable.
Er der noget andet, du gerne vil dele om FeatureByte?
De fleste enterprise AI-værktøjer fokuserer på at forbedre maskinlæringsmodeller. Vi har gjort det til en mission at hjælpe virksomheder med at skalere deres AI, ved at simplificere og industrialisere AI-data. Hos FeatureByte adresserer vi den største udfordring for AI-praktikere: At give en konsekvent, skalerbar måde at forberede, servere og administrere data på tværs af hele livscyklussen for en model, mens vi radikalt simplificerer hele processen.
Hvis du er en data scientist eller ingeniør, der er interesseret i at holde dig på forkanten af datavidenskab, ville jeg opfordre dig til at opleve kraften af FeatureByte gratis.
Tak for det gode interview, læsere, der ønsker at lære mere, skal besøge FeatureByte.


