
Interviews
Gil Elbaz, medstifter og teknisk direktør i Datagen – Interview Serie

 Føj Unite.AI til dine foretrukne kilder på Google
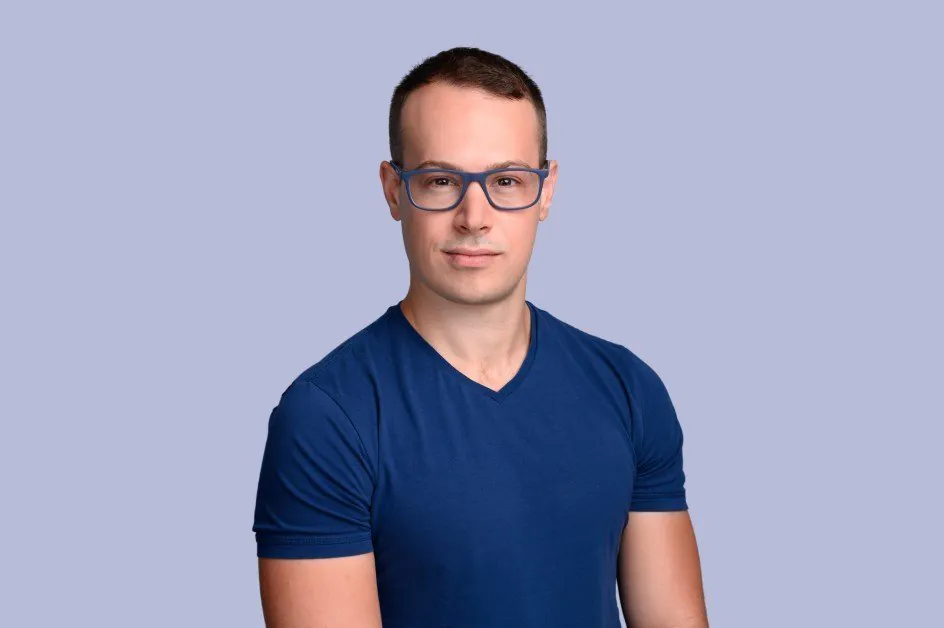
Gil Elbaz er Datagens tekniske direktør og medstifter, beliggende i Tel Aviv. Han modtog sin B.Sc og M.Sc fra Technion. Gils afhandling var fokuseret på 3D-computervision og er blevet offentliggjort på CVPR, den førende computervisionsforskningskonference i verden. Datagen er en pioner inden for det nye felt for Simuleret Data, en undergruppe af syntetisk data, som koncentrerer sig om at genskabe verden omkring os på en fotorealistisk måde. Selskabet lancerede fra stealth med over 18 millioner dollars i finansiering i marts 2021 og arbejder nu med en række Fortune 100-selskaber inden for forstærket/virtuel virkelighed, robotteknologi og bilindustri, herunder de fleste af de førende amerikanske teknologiselskaber.
Hvad var det, der oprindeligt tiltrak dig til robotteknologi og maskinlæring?
Science fiction-bøger, som Isaac Asimovs Foundation-serie og iRobot, fik mig til at tænke over en fremtid, hvor robotter var en integreret del af vores daglige liv. Der er så mange kedelige, gentagne opgaver, som mennesker udfører; jeg vidste, at jeg ikke ville udføre dem, og jeg kunne ikke forestille mig, at nogen andre ville ønske at gøre det. Da robotteknologi er en teknologisk uundgåelighed, mente jeg, at det ville være en klog, “fremtidssikker” karrierebeslutning.
Sådan tilgang til feltet med fokus på de fysiske aspekter af emnet og fik min uddannelse i maskinteknik fra Technion i Haifa, Israel. Mod slutningen af min uddannelse begyndte jeg at dykke dybt ind i verden af CAD-værktøjer og -muligheder. Disse værktøjer giver maskiningeniører mulighed for at designe strukturer og mekaniske enheder (alt fra en bro til en bil). Jeg så en enorm mulighed for at have en stor indvirkning uden at skulle beskæftige mig med de langsomme iterationer i den fysiske verden. I praksis havde disse programmer meget lidt, hvis overhovedet, maskinlærings-/computervisionsfunktioner integreret, der hjalp ingeniører med at skabe enklere, billigere og mere stabile mekaniske systemer (dette var tilbage i 2015). Jeg satte kurs mod computervision på 3D-data med dyb læring (meget nyt dengang) med målet om at skabe klogere CAD-programmer. Arbejdet i de tidlige dage af moderne dyb læring føltes som at være en del af noget, der kunne være rigtig stort – ligesom internettet.
I praksis var min forskning den første til at bringe den dybe læringsrevolution til vores fakultet på Technion. Dette resulterede senere i en artikel, der blev accepteret på den førende computervisionskonference i verden, CVPR, og jeg fløj til Hawaii til CVPR 2017. Præsentationen af min artikel og mødet med menneskene åbnede mine øjne for størrelsen af computervisionsfællesskabet (der i dag er mindst 10 gange større), tusinder af deltagere, der alle lidenskabeligt arbejdede på forskning i feltet. Den begivenhed cementerede næsten min retning og viste mig kraften i computervision og den potentiale, der ventede på at blive låst op.
Kunne du dele historien bag Datagen?
Datagen blev grundlagt i 2018 med en mission om at transformere, hvordan hold får deres data til computervisionsnetværkstræning. Året før havde vi set en demo af Oculus Rift, der bestod af en VR-hovedtelefon og en håndholdt fjernbetjening. Efter demoen fandt vi os selv med at undre os over, “med avancerede kameraer integreret i hovedtelefonen, hvorfor var en håndholdt enhed nødvendig for at forbinde den virtuelle verden med den fysiske verden (dvs. spore håndbevægelser)?” De neurale netværk var allerede tilstrækkeligt avancerede til at klare det, så hvad var problemet?” Og det var, da lyspæren gik ud – Data! Vi så straks den enorme mulighed for at løse 3D-rumlige nærværudsfordringer ved hjælp af avanceret computervision og 3D-metadata. I stedet for at fokusere udelukkende på VR/AR tog vi en mere holistisk tilgang, hvor vi koncentrerede os om det tilsyneladende uløselige problem med at generere tilstrækkeligt (og nøjagtigt) træningsdata til at muliggøre virkelige 3D-AI-anvendelser.
Med fokus på mennesker og menneskeligt miljø er Datagen en pioner inden for det nye felt for Simuleret Data, en undergruppe af syntetisk data, som koncentrerer sig om at genskabe verden omkring os på en fotorealistisk måde. I dag arbejder vi med de mest innovative selskaber i verden for at fremme og accelerere deres computervisionsudvikling og er støttet af nogle af de mest respekterede investorer i branchen.
For læsere, der ikke er bekendt med, kunne du forklare, hvad syntetisk data specifikt er?
Syntetisk data er enhver træningsdata, der – i stedet for at blive indsamlet via direkte måling eller observation af den virkelige verden – genereres enten algorithmisk eller via simulation. I sammenhæng med computervision er syntetisk data computer-genererede billeder med tilhørende metadata, der er nødvendige for at træne kunstig intelligens. Med hensyn til privatlivsproblemer og meget reelle fysiske og økonomiske begrænsninger for virkelige verdensdata, er det svært at overvurdere betydningen af syntetisk data for maskinlæring og AI. I en ny rapport forudsagde Gartner, at mere end 60% af de data, der bruges i AI-feltet, vil være kunstigt genererede inden 2024.
Hvad er nogle af fordelene ved syntetisk data i forhold til manuel dataindsamling?
Det korte svar er, at man skal tænke over alle aspekter af manuel dataindsamling, der er uønskede, og fjern dem fra processen – det er fordelene ved syntetisk data.
Generering af diverse datasæt i stor skala til computervisions-træning er en kostbar og tidskrævende proces, og variationen er meget begrænset af den enkle kendsgerning, at det er kompliceret at placere mennesker i bestemte lokaliteter og fotografere dem – en proces, der er langt mere kompliceret og dyr end at gøre det i en simuleret omgang. En anden stor fordel er, at man effektivt kan eliminere behovet for manuel annotering, der er kedelig, tidskrævende og udsat for menneskelige fejl.
Datagen henviser til simuleret data som en undergruppe af syntetisk data. Kunne du uddybe, hvad simuleret data er?
Simuleret data er syntetisk data, der genereres gennem simulation. Vi bruger GAN’er (samt andre avancerede maskinlæringsmetoder) til at generere 3D-objekter og placere dem i meget realistiske 3D-simulationer af den virkelige verden. Det ser ud som en førstepersons “virtuel billedtagning”-proces, men opererer inden for et fotorealistisk, fysisk-baseret system. Disse simulationer producerer visuel data (som om det var indsamlet i den virkelige verden) sammen med en fuld række annoteringer (fysik, lys osv.). Således er simuleret data syntetisk data, der er fotorealistisk, kontekstligt genereret, 3D-billeder, indsamlet i en simuleret omgang.
Hvordan genererer Datagen tilpasset simuleret data?
Datagens teknologi genererer simuleret data, der er både skalerbar og tilpasset til at imødekomme de unikke behov for hver enkelt kundes specifikke anvendelse. Vi gør det ved at tage hensyn til alle aspekter af hvert projekt – fra det computervisionsystem, der anvendes, til den demografiske sammensætning af regionen, hvor det skal anvendes. Enten vi arbejder direkte med vores kunder eller blot muliggør deres egne ingeniører, begynder Datagen-processen med at fastlægge nøgleparametre for hver specifik anvendelse, såsom linse-specifikationer, lys, miljø, demografisk distribution osv. Datagen bruger GAN’er og andre avancerede værktøjer og -teknikker til at generere en enorm variation af aktiver, herunder alt fra menneskehoveder med dynamiske ansigtsudtryk til at træne AI i følelsesanalyse til bilinteriører til overvågning af passagerer i kabine og hjemmemiljøer til videoconferencer-applikationer, blot for at nævne nogle få. For hver type aktiv introducerer Datagen variation på utallige diskrete akser (fra hudfarve og øjenbrynshøjde til størrelse, farve og form på husmøbler), ved hjælp af parametre, der er finjusteret til at afspejle den specifikke anvendelse i spørgsmål.
Takket være disse kapaciteter er Datagens datasæt ikke kun store og meget varierede, men også optimeret til formålet med at træne et unikt system til at udføre en unik opgave (eller en række opgaver) i den unikke omgang eller miljø, hvor det skal anvendes – alt uden at gå på kompromis med evnen til at skalerer. Vi tager også hensyn til de specifikke annoterings-/metadatakrav for hver anvendelse.
Hvad er nogle eksempler på løsninger inden for robotteknologi, hvor syntetisk og/eller simuleret data anvendes?
En af de største fordelene ved at anvende simuleret data i robotteknologi er evnen til at generere billeder af hardware, der stadig er under udvikling. Dette giver mulighed for, at din robots hjerte (AI) og krop (hardware) kan udvikles side om side. Nu kan træningen udvikle sig, efterhånden som specifikationerne udvikler sig, i stedet for at vente, til dit færdige produkt er fuldt ud prototyperet, før du kan tage billeder af det og begynde at udvikle AI.
Også fordi simuleret data genereres i kontekst, kan du med større lethed tage hensyn til interaktionen mellem din robot og dens omgang. Så hvis du forestiller dig en robot, der griber og fjerner defekte produkter fra en samlebånd, ville simuleret data give dig mulighed for ikke kun at generere data for hver fysisk defekt, der kan forestilles i produktet, men også fra robotens perspektiv for at fange robotarmens fulde bevægelighedsområde, dens interaktion med objektet, den griber. Hvad mere er, 3D-metadata betyder, at der ikke er behov for at annotere billed efter billed for at sikre, at robotten kan korrekt identificere produktet, defekterne, dens arm eller noget andet i dens synsfelt.
Hvad er nogle brugs eksempler for anvendelse af simuleret data i intelligente biler?
Simuleret data i udviklingen af intelligente biler gør det langt lettere at udvikle datasæt for bestemte bilmodeller, mens de udvikles, og itererer i koncert med bilen selv, efterhånden som den går gennem de forskellige faser af design og produktion. Med simuleret billeddata kan ingeniører også anvende kabinevision mere effektivt til at identificere søvndrukne eller distraherede chauffører, hvis en chauffør har fjernet sin hånd fra rattet eller enhver anden form for kanttilfælde for at tage hensyn til chaufførens sikkerhed. Det giver også mulighed for at tage hensyn til en større variation i chauffører og passagerer og introducere variation i form af billedvinkel og lys – alt uden at krænke privatlivet for rigtige mennesker.
For nylig annoncerede Datagen en stor mængde spændende nye ansættelser, hvad betyder det for fremtiden for selskabet?
De seneste tilføjelser til vores bestyrelse og ledelse inkluderer nogle af de mest brillante og erfarne fagfolk inden for AI og computervision. Deres viden, indsigt og erfaring vil hjælpe med at orientere og accelerere Datagens vækst, mens vi navigerer i en branche, der stadig er ung og fuld af muligheder. I et felt med så mange ukendte faktorer er der intet mere værdifuldt end viden.
Er der noget andet, du gerne vil dele om Datagen?
Baseret i Tel Aviv er Datagen en del af en langt større økonomisk og kulturel forandring, der har fundet sted i Israel, og vi er stolte af at være en del af det. På en kort periode er Israel (især Tel Aviv) vokset til at blive et større globalt tech-hub med en blomstrende startup-økosystem og en energisk investeringskommunitet. Selv om Israel ofte betragtes som et cyber-sikkerheds-orienteret tech-hub, er AI- og data-centreret teknologi vokset eksponentielt i de seneste år her. I dag er der mere end 680 kunstig intelligens-selskaber i Israel, der samlet har indsamlet 4,5 milliarder dollars. Denne væksteksplosion over de seneste par år skyldes i høj grad den høje koncentration af ingeniører og Israels verdensberømte universiteter. Disse akademiske institutioner giver adgang til talent og ny, avanceret teknologi i feltet. I de seneste to måneder har Datagen ansat mere end 20 medarbejdere og planlægger at ansætte yderligere teammedlemmer på tværs af salg og marketing, software og DevOps samt produktafdelinger.
Tak for det gode interview, læsere, der ønsker at lære mere, skal besøge Datagen.


