
Interviews
Dr. Jaime Bland, medstifter og CEO af Aquila Health – Interview Serie

 Føj Unite.AI til dine foretrukne kilder på Google
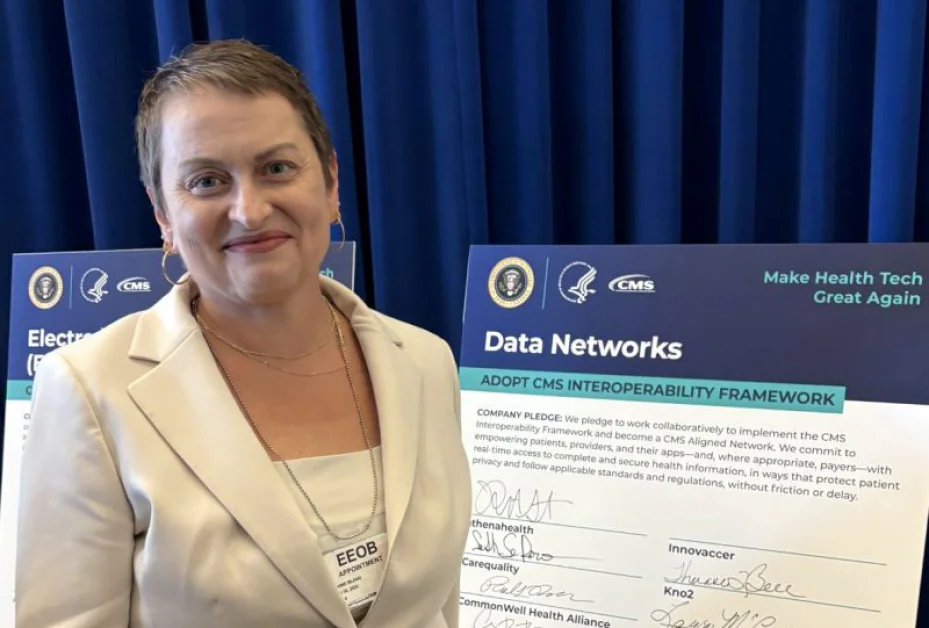
Dr. Jaime Bland, medstifter og CEO af Aquila Health, er en leder inden for sundheds-teknologi, der fokuserer på at løse en af industrens mest vedvarende udfordringer: fragmenterede og utilgængelige data. Hun stiftede Aquila Health for at opbygge en samlet data-infrastruktur, der giver sundhedsorganisationer mulighed for at gå ud over silo-baserede systemer, ved at udnytte maskinlæring og struktureret analyse til at generere handlingsorienteret indsigt, samtidig med at klinisk oversigt opretholdes. Hendes arbejde handler om at forbedre interoperabilitet, aktivere befolkningsniveau sundheds-intelligens og støtte tidligere opdagelse af fremvoksende sundheds-trusler gennem integrerede kliniske, krav- og genetiske datasystemer.
Aquila Health er en AI-dreven sundheds-data-platform, der er designet til at samle forskellige data-kilder i ét, interoperabelt system, der understøtter både operationel effektivitet og avanceret analyse. Platformen indtager store mængder sundheds-data-formater, såsom HL7 og FHIR, og muliggør således en problemfri integration på tværs af hospitaler, offentlige sundhedssystemer og andre interessenter. Ved at kombinere strukturerede maskinlærings-tilgange med en menneske-i-løkken-valideringsmodel, fokuserer Aquila på at levere pålidelige indsigt for befolknings-sundheds-styring, afvigelse-afvikling og realtids-beslutningstagning, snarere end at afhænge udelukkende af uigennemsigtige AI-systemer. Dette placerer virksomheden på skæringspunktet mellem data-infrastruktur og anvendt AI, hvor forbedring af data-kvalitet og -tilgængelighed er grundlæggende for at låse det fulde potentiale for sundheds-intelligens.
Du ledede CyncHealth gennem massiv vækst, hvor du udvidede interoperabilitet på tværs af millioner af patient-optegnelser og multiple stater, før du stiftede Aquila Health. Hvad var de væsentligste begrænsninger eller system-fejl, du mødte under denne rejse, der til sidst fik dig til at bygge Aquila fra bunden?
På CyncHealth brugte vi år på at opbygge infrastrukturen til at forbinde sundhedsorganisationer på tværs af Nebraska og Iowa. Vi forbandede over 1.100 plejesteder og millioner af patient-optegnelser, der dækkede en befolkning på over fem millioner mennesker.
Men det, vi hele tiden stødte på, var, at at forbinde systemer og faktisk gøre data brugbar er to meget forskellige problemer. For eksempel arbejdede vi på at oprette en dashboard for opioid-overdosis, der koordinerede data, vi modtog fra multiple kilder. Det tog måneder med hundredvis af FTE-timer og koordination på tværs af mange interessenter for at gøre denne enkeltte data-punkt forståelig i en offentlig sundheds- og sundheds kontekst. Og efter alt det var billedet stadig ufuldstændigt.
Den oplevelse var frøet til Aquila. Den arvede måde at forbinde grænseflader uden at forstå fuldstændigheden og kvaliteten af data-eksporten vil ikke opfylde behovet med de fremskridt, vi har set i AI de seneste år. Når AI kan opnå på få timer, hvad der tidligere tog et hold måneder, og gøre det med højere kvalitet til en brøkdel af omkostningerne, må du bruge den viden til at genopbygge fra en ny grund. Det er, hvad vi gjorde med Aquila, vi fokuserer på moderne værktøjer, der reducerer omkostningerne ved at forbinde, så vi kan fokusere på at fuldføre det hele billede af sundhed – ikke kun data, der stammer fra traditionelle EHI-kilder, men det hele billede.
Aquila er netop kommet ud af stealth med en platform, der fokuserer på at samle fragmenterede sundheds-data i ét, AI-klar lag. Hvad var de centrale tekniske gennembrud, der gjorde dette muligt nu, i modsætning til blot få år siden?
AI-kapaciteterne har drevet denne ændring næsten fuldstændigt.
Jeg tilbragte år med at se dygtige ingeniører manuelt afklare data-standarder, én kilde ad gangen. Det fungerede, men den model kan aldrig skala. Du kunne ikke hyre dig ud af det hurtigt nok til at følge med den mængde og variation af data, sundhedssektoren genererer.
Hvad der er anderledes nu, er, at AI kan udføre normaliseringsarbejdet kontinuerligt på data-laget, mens informationer flytter gennem systemet. Det er ikke en batch-proces, der kører om natten. Det sker i næsten realtid. Det ændrer, hvad der er muligt for kliniske og offentlige sundheds-hold, fordi data, de har brug for, er struktureret og valideret (gjort brugbar), før det når dem.
Klinikere er vant til at træffe beslutninger uden det fulde patient-billede. Offentlig sundhed er vant til at drive programmer uden ny data til at bakke det op. Aquila ændrer landskabet og giver den hastighed, der gør effektivt data-dreven beslutningstagning mulig på tværs af hele sundhedssektoren.
Vi byggede TREUE ™ som rammeværket, der organiserer EHR-afledt klinisk data, laboratorie-, offentlig sundheds-, krav-, apotek- og sociale data i en samlet struktur. AI erstatter ikke god data-styring; det gør god data-styring skalerbar for første gang.
Du har understreget, at den virkelige udfordring i sundheds-AI ikke er modellerne, men data selv. Hvad er de mest kritiske huller i dagens sundheds-data-infrastruktur, der forhindrer AI i at levere meningsfulde resultater?
Branchen taler om AI-modellen, men modellen er ikke det hårde.
Det hårde er, at en patient kan gå ind på tre forskellige faciliteter på en enkelt dag og fremstå som tre forskellige personer i tre forskellige systemer. Laboratorie-dataene matcher ikke de kliniske noter. Payer-optegnelsen har en anden identifikator end hospital-optegnelsen, og offentlig sundhed bruger en helt anden identifikator. Inden du får alt det sorteret manuelt, er det kliniske vindue lukket.
Stærke tekniske forbindelser kan ikke fikse optegnelser, der ankommer ufuldstændige eller udenfor rækkefølge. AI kan ikke detektere en mønster, der ikke er i data, og det kan ikke give en pålidelig anbefaling fra en optegnelse, der mangler halvdelen af den historiske eller nuværende information, den bør indeholde.
Hullet er ikke proceskraft, det er tillid til den underliggende data. Det er det, der skal løses først, og løsning på skala er, hvor AI faktisk kan tjene sin plads.
Aquila positionerer sig selv som “data-forberedelses-lag” før AI-indtagelse. Kan du føre os igennem, hvad dette lag faktisk gør i praksis, især når det handler om højst heterogene indgange som kliniske optegnelser, krav-data og realtids-feeds?
Brug eksemplet fra tidligere, overvej, hvad der ankommer, når en patient-møde genererer data. Du får en HL7-besked fra hospitalet, en krav-optegnelse fra forsikringsselskabet, en laboratorie-resultat fra en reference-laboratorium, der bruger en anden identifikator, og en offentlig sundheds-rapport, der er indgivet på en helt anden tidsplan. Ingen af disse var designet til at blive forsonet med hinanden.
Vores forberedelses-lag, TREUE ™, er det, der sidder mellem disse indgange og enhver nedstrøms-analyse eller AI-anvendelse. Dets job er at evaluere hver optegnelse, mens den ankommer, matche identiteter på tværs af kilder, normalisere formater og flag, hvad der mangler eller er inkonsistent, før data flytter videre.
I praksis betyder det, at en kliniker, der ser på en patient, arbejder fra en optegnelse, der er valideret og aligneret på tværs af kilder, snarere end manuelt at afklare fire forskellige system-visninger under en pleje-møde. For offentlige sundheds-hold betyder det, at udbrudssignaler ikke er forsinket af data, der ankom i forskellige formater fra forskellige jurisdiktioner.
Det er infrastruktur-arbejde. Det er ikke glamorøst, men intet nedstrøms fungerer uden det.
Interoperabilitets-standarder som Fast Healthcare Interoperability Resources (FHIR) og United States Core Data for Interoperability (USCDI) har været til stede i år, men fragmentering består stadig. Hvad mangler stadig fra et standard-perspektiv, og hvordan løser Aquila disse huller anderledes?
FHIR og USCDI gav branchen et fælles sprog for data-udveksling. Det var vigtig fremgang.
Her er hullet: sundheds-data kommer ikke fra én domæne. Kliniske systemer, offentlige sundheds-registre, laboratorier og sociale data-kilder har hver deres regulerings-krav, tidsplaner og definitioner af, hvad et felt betyder. FHIR fortæller dig ikke, hvordan du forsoner en social bestemmelses-datasæt med en klinisk optegnelse fra en anden jurisdiktion.
Hvad TREUE ™ tilføjer, er et samlet rammeværk for, hvordan data fra alle disse domæner kan organiseres og valideres sammen, samtidig med at det respekterer regulerings-reglerne, der gælder for hver kilde. Resultatet er data, du faktisk kan analysere på tværs af domæner, ikke kun data, der er blevet transmitteret med succes.
Aquila opererer i høj-konsekvens-miljøer, hvor fejl ikke er en mulighed. Hvordan designer du AI-systemer, der balancerer realtids-ydelse med strenge krav omkring regulerings-krav, revision og tillid?
Du må bygge regulerings-krav ind i arkitekturen, før du skriver den første linje af program-kode. Det skal ikke være et lag, du tilføjer efterfølgende.
I sundheds- og regerings-miljøer er beslutningerne, der informeres af denne data, patient-pleje, udbrud-svar og hvordan offentlige ressourcer allokeres. Enhver handling, der udføres på data, skal være sporbar, og adgang skal være tæt kontrolleret. Systemet skal opfylde regulerings-kravene i de miljøer, det opererer i.
For Aquila betyder det, at operere inden for regerings-grads cloud-infrastruktur, zero-trust-adgangskontrol og sikkerheds-praksis, der er aligneret med HIPAA og føderale standarder. Vi har aktive kontrakter i gang med statlige regeringer, føderale agenturer og sundheds-organisationer, og disse miljøer har meget forskellige regulerings-krav, som platformen skal opfylde samtidig.
Menneske-i-løkken-komponenten er lige så vigtig. AI kan overflade-signaler, men kliniske eksperter validerer afvigelser, før de informerer operationelle beslutninger. Teknologien gør det lettere at finde disse signaler. Det erstatter ikke dommen af de mennesker, der skal handle på dem.
Din platform understøtter sikker, på-enhed AI-udvikling og data-suverænitet. Hvordan vigtig er decentralisering i sundheds-AI, især med stigende bekymringer omkring data-privatliv og regulerings-overholdelse?
Det bliver essentiel, og jeg tror, branchen er kun begyndt at forstå, hvorfor.
Sundheds-organisationer opererer under strenge privatlivs-forpligtelser. Følsomme patient-data kan ikke blot centraliseres og processeres i et fælles miljø. Forskellige stater har forskellige regler. Føderale agenturer har forskellige regler. International sundheds-data har endnu en anden sæt begrænsninger. Enhver arkitektur, der kræver, at følsomme data flyttes til en central beliggenhed, vil løbende støde på disse barrierer.
Retningen, der faktisk fungerer, er at generere indsigt tættere på, hvor data allerede bor. Organisationer kan bidrage til fælles analyse uden at give op kontrol over deres underliggende data. Det er, hvad fæderede modeller tillader.
Vores platform er bygget til at operere i et sådant reguleret, decentraliseret miljø – regulerings-krav, der rejser med data, snarere end at blive anvendt på ét punkt. Det er en hårdere arkitektur at bygge, men det er den, der faktisk er kompatibel med, hvordan sundheds-data-styring fungerer i praksis.
Mange AI-startups læner tungt op ad sorte-kasse-modeller, mens Aquila inkorporerer menneske-i-løkken-validering. Hvor ser du grænsen mellem automatisering og menneskelig oversigt i kliniske AI-systemer?
Jeg startede min karriere som sygeplejerske. Den oplevelse former, hvordan jeg tænker om, hvor AI hører hjemme i en klinisk kontekst, og hvor det ikke gør.
AI er meget god til at finde mønstre i store datasæt. Det er ikke godt til at vide, hvad et mønster betyder for en specifik patient med en specifik historie i en specifik samfundskontekst. Det er stadig en menneskelig dømmekraft.
Den rette rolle for AI i kliniske systemer er at overflade-signaler, som et menneske måske ville overse i volumen, ikke at erstatte den kliniske resonans, der følger. Hos Aquila går afvigelser og indsigt, der er flaget af systemet, til klinikere og domæne-eksperter til gennemgang, før de driver operationelle beslutninger. Teknologien fortæller dig, hvor du skal se, og professionen fortæller dig, hvad det betyder.
Hvor jeg tror, grænsen hører til: automatiser afvikling, behold fortolkningen med mennesker, der er ansvarlige for resultatet.
Aquila arbejder på tværs af offentlig sundhed, regerings-systemer og regulerede industrier. Hvordan adskiller kravene til AI-infrastruktur sig mellem disse miljøer sammenlignet med traditionelle enterprise AI-udviklinger?
I en typisk enterprise AI-udvikling arbejder du normalt inden for ét organisations data-miljø, ét sæt regulerings-krav, ét compliance-ramme.
Offentlige sundheds- og regerings-miljøer er strukturelt forskellige. Du koordinerer på tværs af multiple jurisdiktioner, multiple agenturer, multiple kliniske indstillinger, der hver især opererer på forskellige rapporteringstidsplaner og under forskellige lovgivnings-rammer. Et hospital i en stat, en offentlig sundheds-agentur i en anden stat, en føderal program med sine egne data-krav. Alle disse skal udveksle data og generere indsigt uden, at nogen enkelt enhed har ukontrolleret adgang til en andens optegnelser.
Infrastrukturen skal understøtte høj-volumen-behandling, mens den opretholder streng revision på tværs af alle disse grænser. Den skal integrere med arvede sundheds-besked-formater, fordi disse systemer ikke forsvinder. Og den skal operere pålideligt i miljøer, hvor downtime ikke kun er et forretnings-problem, men et patient-sikkerheds-problem.
Den kompleksitet er, hvorfor vi startede Aquila med disse miljøer snarere end den traditionelle enterprise-marked. Hvis du kan bygge infrastruktur, der fungerer her, fungerer det overalt.
AI-kapaciteter fortsætter med at avancere hurtigere end regulerings-rammer. Hvad er ansvarligheden for grundlæggere og platform-byggere for at sikre, at disse systemer er udviklet på en etisk og sikker måde fra dag én?
Jeg tror, ansvarligheden er ligetil, selv om det at opfylde den ikke er. Hvis du bygger AI, der påvirker kliniske beslutninger eller offentlige sundheds-resultater, får du ikke lov til at behandle regulerings-krav som en produkt-vej-kort-punkt, du vil nå til sidst. Det skal være designet fra starten.
Hvad det betyder i praksis er, at hver handling på data skal være revisionssikker. Modellerne skal være tilstrækkeligt fortolkningsfulde, så en kliniker kan forstå, hvorfor et signal er flaget. Kliniske eksperter skal være en del af gennemgangs-processen, ikke en eftertanke. Og organisationen skal være ærlig om, hvad systemet kan og ikke kan pålideligt gøre.
Jeg har tilbragt min karriere i miljøer, hvor data-fejl har reelle konsekvenser for reelle mennesker. Det former, hvordan jeg tænker om dette. Kapaciteterne avancerer hurtigt, og ansvarligheden for, hvordan de er udviklet, kan ikke være allowed til at ligge efter. Grundlæggere, der bygger disse systemer, må holde denne standard for sig selv, ikke vente på, at regulerings-krav påligger det.
Tak for den indsigtsgivende diskussion. Læsere, der er interesseret i at udforske platformen og dens tilgang til sundheds-data-infrastruktur, kan lære mere ved at besøge Aquila Health.






