
AI-modeller og platforme
DIRFA Forvandler Lydklip til Livlige Digitale Ansigter

 Føj Unite.AI til dine foretrukne kilder på Google
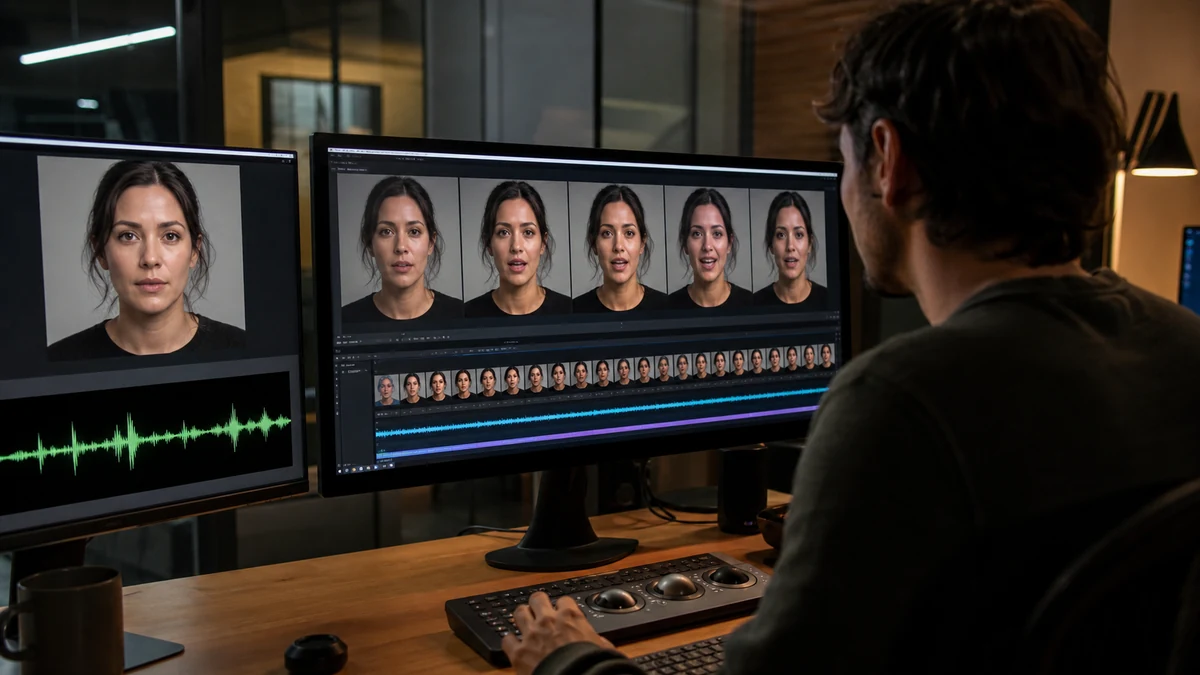
I et bemærkelsesværdigt spring fremad for kunstig intelligens og multimedie-kommunikation har et hold af forskere ved Nanyang Technological University, Singapore (NTU Singapore) præsenteret et innovativt computerprogram kaldet DIRFA (Diverse yet Realistic Facial Animations).
Dette AI-baserede gennembrud demonstrerer en stærk evne: at omdanne en simpel lydklip og et statisk ansigtsbillede til realistiske, 3D-animerede videoer. Videoerne viser ikke kun nøjagtig lip-synkronisering med lyden, men også en rigtig mængde af ansigtsudtryk og naturlige hovedbevægelser, hvilket udvider grænserne for digital medieproduktion.
Udviklingen af DIRFA
DIRFAs kernefunktion ligger i dets avancerede algoritme, der ubemærket kombinerer lydindput med fotografisk billedmateriale for at generere tredimensionelle videoer. Ved at omhyggeligt analysere talemønstre og toner i lyden, forudsiger og reproducerer DIRFA intelligently tilsvarende ansigtsudtryk og hovedbevægelser. Dette betyder, at den resulterende video viser taleren med en høj grad af realisme, deres ansigtsbevægelser perfekt synkroniseret med nuancerne i deres talte ord.
DIRFAs udvikling markerer en betydelig forbedring i forhold til tidligere teknologier på dette område, der ofte kæmpede med kompleksiteten af varierende poser og emotionelle udtryk.
Traditionelle metoder havde typisk svært ved at nøjagtigt genskabe subtiliteterne af menneskelige emotioner eller var begrænsede i deres evne til at håndtere forskellige hovedposer. DIRFA, derimod, excellerer i at fange en bred vifte af emotionelle nuancer og kan tilpasse sig forskellige hovedretninger, hvilket giver en langt mere alsidig og realistisk output.
Dette fremskridt er ikke kun et skridt fremad i AI-teknologi, men åbner også op for nye horisonter i, hvordan vi kan interagere med og udnytte digitalt medie, og giver en glimt af en fremtid, hvor digital kommunikation antager en mere personlig og udtryksfuld karakter.
Træning og Teknologi Bag DIRFA
DIRFAs evne til at genskabe menneskelignende ansigtsudtryk og hovedbevægelser med sådan en nøjagtighed er et resultat af en omfattende træningsproces. Holdet ved NTU Singapore trænede programmet på en massiv dataset – over en million audiovisuelle klip fra VoxCeleb2-datasættet.
Dette datasæt omfatter en bred vifte af ansigtsudtryk, hovedbevægelser og talemønstre fra over 6.000 individer. Ved at udsætte DIRFA for sådan en vældig og varieret samling af audiovisuelle data, lærte programmet at identificere og genskabe de subtile nuancer, der kendetegner menneskelige udtryk og tale.
Associate Professor Lu Shijian, den medfølgende forfatter af studiet, og Dr. Wu Rongliang, den første forfatter, har delt værdifulde indsighter i betydningen af deres arbejde.
“Studiets indvirkning kan være dybtgående og langtrækkende, da det revolutionerer området for multimedie-kommunikation ved at muliggøre skabelsen af højrealistiske videoer af individer, der taler, kombinerer teknikker som AI og maskinlæring,” sagde Assoc. Prof. Lu. “Vores program bygger også på tidligere studier og repræsenterer en fremgang i teknologien, da videoer skabt med vores program er komplet med nøjagtige lipbevægelser, levende ansigtsudtryk og naturlige hovedposer, kun ved hjælp af deres lydoptagelser og statiske billeder.”
Dr. Wu Rongliang tilføjede, “Tale viser en mangfoldighed af variationer. Individer udtaler de samme ord forskelligt i forskellige sammenhænge, omfattende variationer i varighed, amplitude, tone og mere. Desuden, ud over dens sproglige indhold, kommunikerer tale rig information om talerens emotionelle tilstand og identitetsfaktorer som køn, alder, etnicitet og selv personlighedstræk. Vores tilgang repræsenterer en pionerindsats i forbedring af præstationen fra synspunktet på audio-repræsentationslæring i AI og maskinlæring.”

Sammenligninger af DIRFA med state-of-the-art audio-drevne talking face generation-tilgange. (NTU Singapore)
Potentielle Anvendelser
En af de mest lovende anvendelser af DIRFA er inden for sundhedssektoren, især i udviklingen af sofistikerede virtuelle assistenter og chatbots. Med dets evne til at skabe realistiske og responsive ansigtsanimationer, kan DIRFA betydeligt forbedre brugeroplevelsen på digitale sundhedsplatforme, gøre interaktioner mere personlige og engagerende. Denne teknologi kan være afgørende i at give emotionel trøst og personlig omsorg gennem virtuelle medier, et væsentligt aspekt, der ofte mangler i nuværende digitale sundheds løsninger.
DIRFA har også en enorm potentiale i at hjælpe individer med tale- eller ansigts-handicaps. For dem, der har svært ved at kommunikere verbalt eller gennem ansigtsudtryk, kan DIRFA fungere som et kraftfuldt værktøj, der giver dem mulighed for at udtrykke deres tanker og følelser gennem udtryksfulde avatarer eller digitale repræsentationer. Det kan forbedre deres evne til at kommunikere effektivt, brokke mellem deres intentioner og udtryk. Ved at give en digital måde at udtrykke sig på, kan DIRFA spille en afgørende rolle i at give disse individer en ny vej til at interagere og udtrykke sig i den digitale verden.
Udfordringer og Fremtidige Retninger
At skabe livlige ansigtsudtryk udelukkende fra lydindput præsenterer en kompleks udfordring inden for AI og multimedie-kommunikation. DIRFAs nuværende succes på dette område er bemærkelsesværdig, men kompleksiteten af menneskelige udtryk betyder, at der altid er plads til forbedring. Hver enkelt persons talepattern er unikt, og deres ansigtsudtryk kan variere dramatisk, selv med samme lydindput. At fange denne diversitet og subtilitet forbliver en nøgleudfordring for DIRFA-holdet.
Dr. Wu anerkender visse begrænsninger i DIRFAs nuværende iteration. Specifikt, programmets interface og graden af kontrol, det tilbyder over output-udtryk, har brug for forbedring. For eksempel, evnen til at justere bestemte udtryk, som at ændre en sur mine til et smil, er en begrænsning, de søger at overvinde. At løse disse begrænsninger er afgørende for at udvide DIRFAs anvendelighed og brugeradgang.
I fremtiden planlægger NTU-holdet at forbedre DIRFA med en mere diversificeret række datasæt, der omfatter en bredere vifte af ansigtsudtryk og tale-lydklip. Denne udvidelse forventes at yderligere forfine nøjagtigheden og realisme af de ansigtsanimationer, der genereres af DIRFA, gøre dem mere alsidige og tilpasselige til forskellige sammenhænge og anvendelser.
DIRFAs Indvirkning og Potentiale
DIRFA, med sin banebrydende tilgang til at syntetisere realistiske ansigtsanimationer fra lyd, er klar til at revolutionere området for multimedie-kommunikation. Denne teknologi udvider grænserne for digital interaktion, udvisker grænsen mellem den digitale og fysiske verden. Ved at muliggøre skabelsen af nøjagtige, livlige digitale repræsentationer, forbedrer DIRFA kvaliteten og autenticiteten af digital kommunikation.
Fremtiden for teknologier som DIRFA i at forbedre digital kommunikation og repræsentation er vældig og spændende. Da disse teknologier fortsætter med at udvikle sig, lover de at tilbyde mere immersive, personlige og udtryksfulde måder at interagere i den digitale verden.
DU kan finde den publicerede studie her.


