Grundlæggende AI
Kodning og AI: En nybegynders vej ind i kunstig intelligens

 Føj Unite.AI til dine foretrukne kilder på Google
Du kan begynde at lære AI uden tidligere professionel programmeringserfaring, men at bygge pålidelige systemer kræver til sidst tilstrækkelige færdigheder inden for kodning, data og evaluering for at kunne inspicere, hvad værktøjerne gør. Den hurtigste vej er en lille række projekter, der er knyttet til grundlæggende principper, frem for en lang række uafhængige tutorials.
AI‑assisteret kodning kan forklare syntaks, generere eksempler og hjælpe med fejlsøgning. Betragt dens output som et udkast: kør det, test det, læs dokumentationen, og forstå dataene og tilladelserne, før du stoler på det.
Vigtige pointer
- Lær grundlæggende Python, notebooks, Git, kommandolinjen og hvordan man læser fejl.
- Byg et lille superviseret læringsprojekt, før du springer til agenter eller store modeller.
- Brug trænings-, validerings- og testdata korrekt; sammenlign med en simpel baseline.
- Lad AI assistere feedback‑loopet, men verificer selv kode, kilder, licenser, sikkerhed og resultater.
Trin 1: programmeringsgrundlag
Lær variabler, samlinger, betingelser, løkker, funktioner, moduler, filer, miljøer og undtagelser. Øv dig i at læse en CSV, transformere poster, kalde et dokumenteret API, skrive en test og bruge Git til at spore ændringer.
Du behøver ikke avanceret matematik, før du begynder at kode, men du bør lære grundlæggende sandsynlighed, vektorer, gennemsnit, fordelinger og grafer, når de bliver relevante. Computational tænkning hjælper med at omsætte et vagt mål til testbare trin.
Trin 2: et komplet ML‑projekt
Vælg et lille offentligt datasæt og et klart forudsigelses‑spørgsmål. Udforsk dataene, opdel dem uafhængigt, byg en baseline, træn en simpel model, inspicer fejl, og noter begrænsninger. Brug scikit-learn før et tilpasset neuralt netværk, når det er passende.
Dette projekt gør maskinlæring konkrete: funktioner, labels, lækage, overfitting, målemetrik, reproducerbarhed og forskellen mellem en modelscore og en brugbar beslutning.
Trin 3: dyb læring og sprogmodeller
Lær tensorer, batches, tab, gradientnedstigning og backpropagation gennem en lille billed‑ eller tekstmodel. Brug derefter en foruddannet model via et API eller et åbent bibliotek, registrer prompts og versioner, og sammenlign den med en enklere metode.
Udforsk generativ AI gennem en afgrænset anvendelse med genfinding eller værktøjsbrug. Tilføj validering, kildehenvisninger, tilladelser og fallback, så projektet lærer systemteknik såvel som prompting.
Brug AI‑kodningsassistenter bevidst
Bed om små funktioner, tests, forklaringer, kanttilfælde og dokumentationsreferencer. Kør statiske checks og tests, gennemgå afhængighedsændringer, og indsæt aldrig hemmeligheder eller private data uden autorisation. Hvis du ikke kan forklare en kritisk linje, så sænk tempoet.
En brugbar portefølje viser spørgsmålet, datarettigheder, baseline, metode, evaluering, fejl og hvad du ville forbedre. Afsluttede, dokumenterede små projekter demonstrerer mere dømmekraft end kopieret kode fra en stor demo.
En praktisk læringssti fra problem til prototype
Start med en specifik opgave og et lille sæt repræsentative eksempler i stedet for en bred ambition om at ‘lære AI’. Klassificering af supportbeskeder, udtrækning af fakturafelter eller besvarelse af spørgsmål fra godkendte dokumenter giver observerbare input og output. Beskriv, hvordan et godt resultat ser ud, før du vælger en model eller et værktøj.
No‑code‑grænseflader kan lære prompting, datapreparation, evaluering og workflow‑design, men de fjerner ikke behovet for teknisk dømmekraft. Lær tabeller, filer, API’er, autentificering, variabler, betingelser og grundlæggende statistik. Disse begreber forklarer, hvordan data bevæger sig, hvorfor integrationer fejler, og hvad et modelresultat betyder – og hvad det ikke betyder.
Byg en baseline med en simpel regel, søgemetode, regneark eller lille model. Sammenlign derefter en AI‑tilgang på de samme testcases. En baseline afslører, om kompleksitet tilfører værdi, og giver nybegyndere et konkret fejlsøgningsmål. Hold testdata adskilt fra eksempler, der bruges til at konfigurere eller prompt systemet.
Prompting, API’er og overgangen til kode
En brugbar prompt angiver opgaven, relevant kontekst, begrænsninger, output‑skema og eksempler, når det er nødvendigt. Prompt‑ændringer er software‑ændringer: versionér dem, test dem mod et fast evalueringssæt, og inspicer fejl. Behandl ikke flydende forklaringer fra modellen som bevis på, at svaret eller den citerede evidens er korrekt.
Workflow‑byggere forbinder model‑kald til formularer, databaser, filer og forretningsapplikationer. Forstå, hvilke data hvert trin sender til tredjeparter, hvordan legitimationsoplysninger gemmes, og hvad der sker ved timeout eller genforsøg. Tilføj input‑validering, struktureret output, hastighedsbegrænsninger, menneskelig godkendelse og logning, før du bruger en prototype med rigtige brugere.
Kode bliver værdifuld, når workflowet kræver tilpasset logik, gentagelige tests, skala, ydeevne, portabilitet eller detaljeret sikkerhedskontrol. Python og JavaScript er almindelige indgangspunkter, men sproget betyder mindre end grundprincipperne: funktioner, datastrukturer, pakker, fejl, versionsstyring og tests. Brug kun genereret kode efter at have læst og kørt den sikkert.
Porteføljeprojekter, evaluering og karriereudvikling
Et solidt nybegynderprojekt dokumenterer problemet, brugerne, datatilladelser, baseline, arkitektur, evalueringssæt, målemetrik, fejl, risici og næste skridt. Et poleret interface uden evaluering viser mindre end et lille, reproducerbart eksperiment. Fjern private data og hemmeligheder, før du offentliggør kode, skærmbilleder, prompts eller logfiler.
Evaluer opgavens succes frem for modellens imponerende egenskaber. Klassificering kræver klasse‑specifik præcision og recall; udtrækning kræver feltnøjagtighed; genfinding kræver dækning af evidens; generering kræver faktualitet, nytte, sikkerhed, latenstid og omkostninger. Gennemgå ydeevne på tværs af sprog, kanttilfælde og berørte grupper, og definer hvornår et menneske skal træffe beslutning.
AI‑arbejde omfatter produktledelse, domæneekspertise, data‑operationer, evaluering, design, sikkerhed, politik og forandringsledelse såvel som modeludvikling. Opbyg dybde inden for ét domæne og tilstrækkelig teknisk læsefærdighed til at samarbejde på tværs af roller. Troværdige porteføljer forklarer afvejninger og begrænsninger i stedet for at præsentere hver prototype som produktionsklar automatisering.
Eksempel: en nybegynder bygger en dokumenttriage‑assistent
En elev indsamler et lille sæt offentlige eller tilladte dokumenter og definerer tre kategorier plus et ‘usikkert’ udfald. De mærker eksempler ved hjælp af en skriftlig regel, reserverer et test‑sæt, og implementerer en nøgleords‑baseline i et regneark. En no‑code‑model eller API returnerer derefter en struktureret kategori og sikkerhed, som sammenlignes med de samme sager. Forkerte og tvetydige eksempler bliver læringsmaterialet, ikke noget skjult i en demo.
Workflowet accepterer en fil, udtrækker tekst, fjerner ikke‑understøttede formater, kalder modellen med et fast skema, validerer svaret, og sender usikre sager til gennemgang. Det gemmer kun nødvendige felter og inkluderer aldrig legitimationsoplysninger i prompts eller delte skærmbilleder. Eleven registrerer modelnavn, prompt‑version, latenstid, omkostninger og output, så ændringer kan testes i stedet for at blive vurderet ud fra hukommelsen.
En portefølje‑rapport beskriver præcision og recall pr. klasse, privatlivs‑antagelser, fejl‑eksempler og grænsen mellem prototype og produktion. Det næste kodningstrin kan erstatte en skrøbelig manuel integration med en lille testet funktion eller API. Denne progression lærer overførbare færdigheder: problemdefinition, datakvalitet, evaluering, grænseflader, fejlhåndtering, sikkerhed og kommunikation. Disse grundprincipper betyder mere end at påstå, at man har bygget en sofistikeret agent efter ét succesfuldt eksempel.
Praktisk implementeringscheckliste
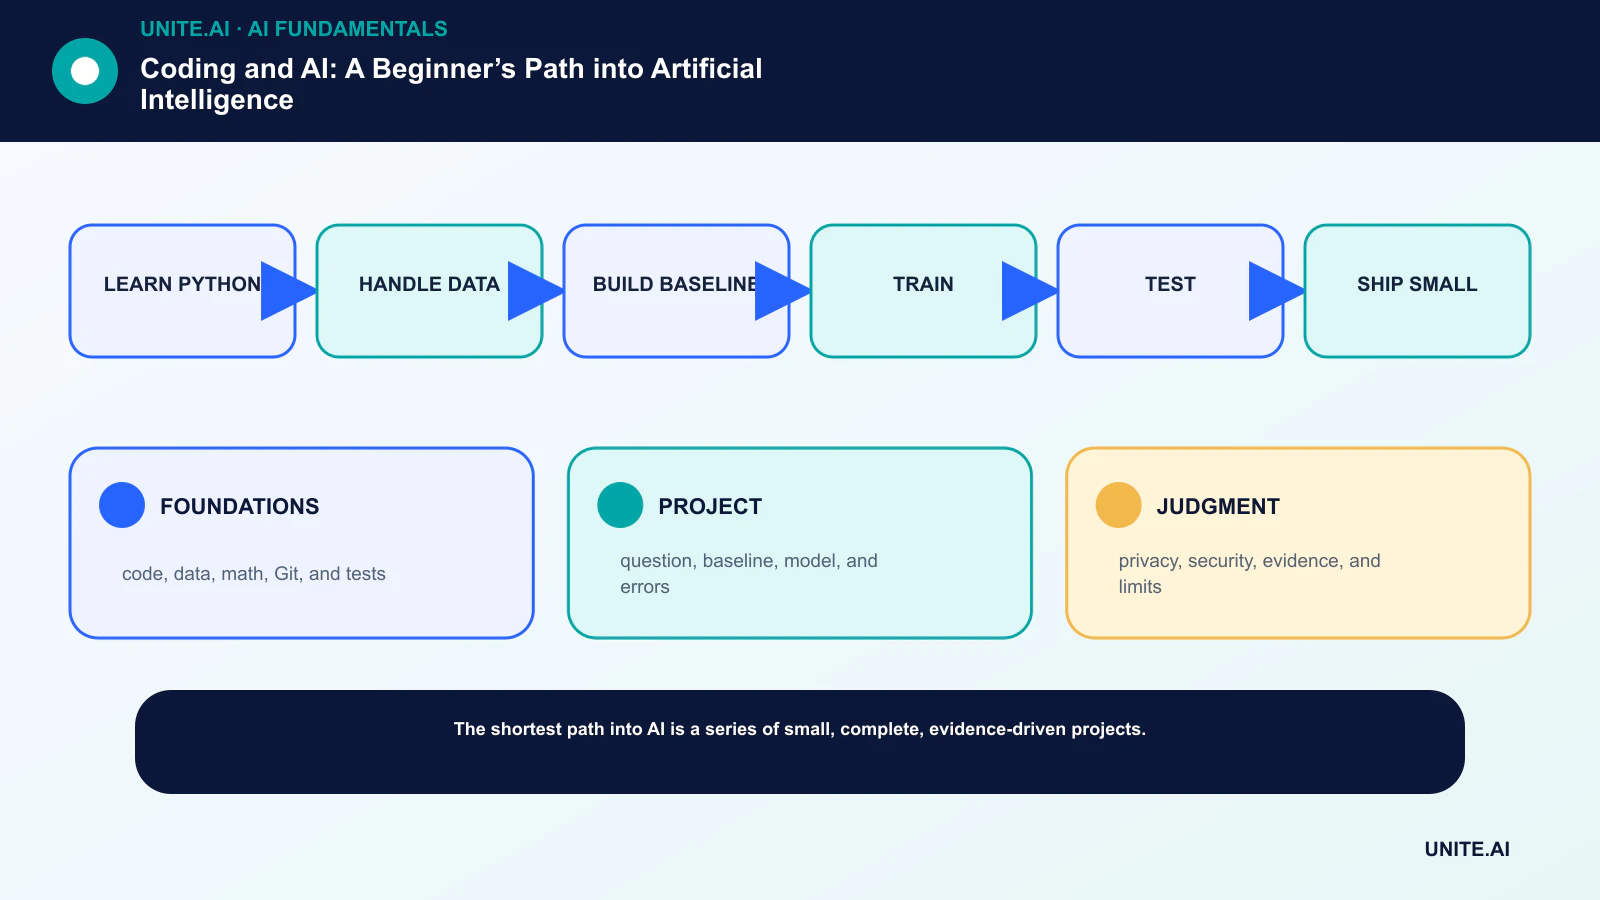
Omform konceptet til et afgrænset, testbart workflow: lær python → håndter data → byg baseline → træn → test → lever lille. Udpeg en ansvarlig ejer, dokumenter data og afhængigheder, etabler en simpel baseline, fastsæt accept‑ og stop‑kriterier, test repræsentative fejl, og definer overvågning, rollback og gennemgang, før du udvider omfanget. Registrer versioner og antagelser, så et andet team kan reproducere resultatet og forstå, hvad der er ændret.
Før lancering skal du gennemføre en dokumenteret beredskabs‑gennemgang med de personer, der bygger, driver, sikrer og påvirkes af systemet. Test normale tilfælde, grænsetilstande, afhængighedsfejl og misbrug; bevar evidensen og uafklarede risici. Definér hvem der kan godkende udgivelse, ændre en tærskel, tilsidesætte et output eller stoppe driften. Genovervej beslutningen, når data fra den virkelige verden ankommer, fordi en teknisk succesfuld pilot ikke garanterer pålidelig ydeevne i større skala.
- GRUNDLAG: kode, data, matematik, Git og tests.
- PROJEKT: spørgsmål, baseline, model og fejl.
- VURDERING: privatliv, sikkerhed, evidens og begrænsninger.
Ofte stillede spørgsmål
Behøver jeg en datalogiuddannelse for at arbejde med AI?
Nej. Roller omfatter engineering, research, product, design, operations, data, evaluation, policy og domæneekspertise. Hver rolle har et forskelligt krav til kodningsdybde.
Hvilket programmeringssprog bør en nybegynder lære?
Python er et praktisk førstevalg, fordi syntaksen er let tilgængelig, og dets data‑ og ML‑økosystem er bredt. De underliggende problemløsningsfærdigheder overføres til andre sprog.
Primære referencer