
Det bedste
10 bedste AI-værktøjer til webskrabning (november 2026)

 Føj Unite.AI til dine foretrukne kilder på Google
Unite.AI kan modtage betaling, når du bruger links til produkter, vi anmelder. Det påvirker ikke vores redaktionelle vurderinger. Læs vores affiliateoplysning.
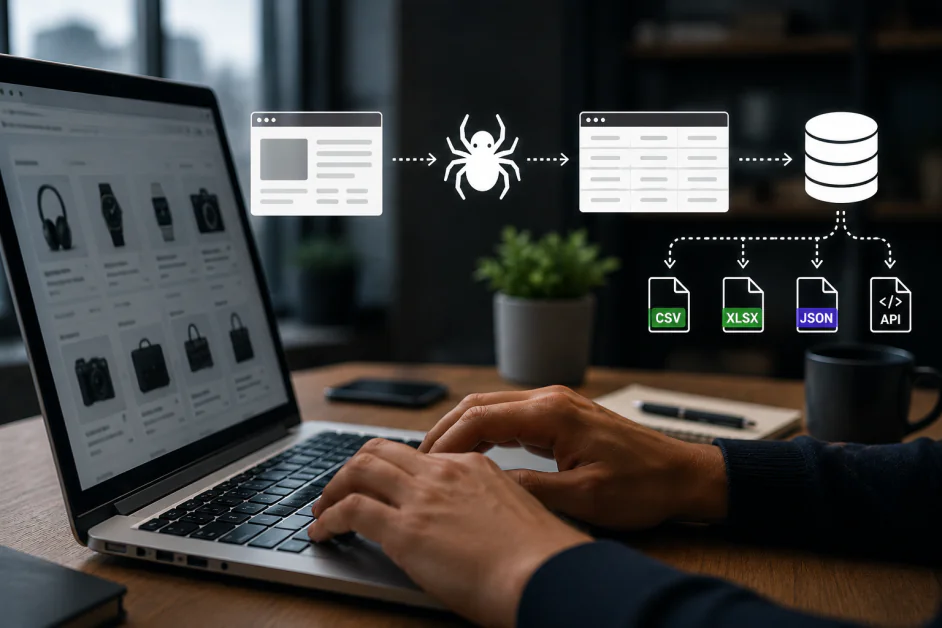
Det bedste AI-værktøj til webskrabning afhænger af, hvad du vil gøre, når en side er indlæst. En researchassistent har brug for læsbart indhold og kildelinks. Et system til markedsindsigt har brug for ensartede dataposter i stor skala. En interaktiv agent kan have brug for en browser, der kan klikke sig gennem flere trin og holde sessionen aktiv.
Denne guide gennemgår ti værktøjer til disse opgaver, herunder platforme til dataindsamling på virksomhedsniveau, indholds-API’er, værktøjer til webskrabning uden kode, tjenester med søgedata og administrerede browsere. Vi vurderer, hvordan hvert produkt indsamler oplysninger, hvem der kan vedligeholde arbejdsgangen, og hvilke afvejninger der er vigtige, når en prototype bliver til en tilbagevendende proces.
Vores team har evalueret hver løsning i denne guide uafhængigt og vurderet dens funktioner, praktiske styrker, begrænsninger og egnethed til de anvendelsesscenarier, som vores rangeringer afspejler.
De bedste AI-værktøjer til webskrabning sammenlignet
| AI-værktøj | Bedst til | Vigtigste styrker |
|---|---|---|
| Bright Data | Dataindsamling på virksomhedsniveau og alsidige datapipelines | Scraper-API’er, Browser API, Scraper Studio, datasæt, proxyer |
| Firecrawl | Webindhold til AI-applikationer | Søgning, scraping, kortlægning, crawling, Markdown, JSON, interaktion, MCP |
| Apify | Genanvendelige scraping-opgaver og orkestrering i skyen | Actors, Crawlee, tidsplaner, lagring, proxyer, API’er, MCP |
| Browse AI | Dataindsamling uden kode og overvågning af ændringer | AI-assisteret opsætning, robotter, alarmer, tidsplaner, integrationer |
| SearchAPI | Strukturerede søgeresultater og lokaliseret research | Google, Maps, shopping, video, AI-søgeflader, JSON |
| Octoparse | Visuel scraping med gentagen kørsel i skyen | Skabeloner, AI-assistent, automatisk registrering, kørsler i skyen, eksport |
| Browserless | Administrerede browsere til Puppeteer og Playwright | Browsere hostet i skyen, vedvarende sessioner, REST-API’er, MCP |
| ScrapingBee | Administreret dataudtræk via en applikations-API | AI-dataudtræk, CSS/XPath, Markdown, JS-scenarier, MCP |
| Oxylabs | Administreret dataindsamling fra krævende offentlige websites | Web API /Scrape, rendering, struktureret output, MCP |
| Diffbot | Automatisk dataudtræk og indsigt i entiteter | Udtræk, standardskemaer, crawling, vidensgraf |
Sådan vælger du et AI-værktøj til webskrabning
Vælg værktøj efter opgaven
Til en AI-vidensbase bør du prioritere læsbar tekst, struktureret output og bevarelse af kilde-URL’er. Til tilbagevendende virksomhedsresearch kan en visuel robot og alarmer om ændringer være vigtigere end et programmeringsinterface. Til en interaktiv agent bør du se på, om sessionen kan fortsætte, og på browserstyringen. API’er til søgeresultater løser en anden opgave: De leverer søgedata, mens indsamling af de linkede sider er et særskilt trin.
Afgør, hvem der har ansvaret for arbejdsgangen
En platform uden kode gør det muligt for en analytiker selv at justere trinnene i dataudtrækket. En API giver udviklere et enkelt interface til at integrere dataindsamlingen i en applikation. En platform til skybaserede opgaver tilføjer tidsplanlægning og lagring, mens en administreret browser overlader en større del af automatiseringslogikken til dit team. Det rigtige valg placerer vedligeholdelsen hos dem, der både forstår kildewebsitesene og det ønskede output.
Læg budget efter brugbare dataposter, ikke imponerende antal forespørgsler
Sammenlign prisen på en fuldført opgave med de felter, du har brug for. Rendering, premium-proxyer, browserens køretid, AI-dataudtræk, lagring og gentagne forsøg kan påvirke den samlede pris. En gratis kredit, en browserenhed og en søgeforespørgsel er forskellige måleenheder. Ved tilbagevendende arbejde bør du, ud over vellykkede svar, holde øje med fuldstændighed, dubletter, aktualitet og prisen pr. brugbar datapost.
10 bedste AI-værktøjer til webskrabning
1. Bright Data
Bright Data er vores samlede anbefaling til organisationer, der har brug for flere måder at indsamle webdata på inden for én platform. Udvalget omfatter færdige Scraper-API’er, forudindsamlede datasæt, Scraper Studio, Web Unlocker og proxytjenester. Et team, der arbejder med e-handelsindsigt, kan for eksempel bruge strukturerede datafeeds til velkendte detailhandlere og samtidig udvikle en skræddersyet løsning til dataindsamling fra en specialiseret markedsplads. Den brede vifte gør platformen særligt nyttig, når dataarbejdet omfatter mere end ét website eller én afdeling.
Til interaktive sider stiller Browser API browsere til rådighed, som udviklere kan styre med Puppeteer, Playwright eller Selenium. Tjenesten kombinerer browserafvikling med proxyadministration og CAPTCHA-håndtering, mens understøttelse af Chrome DevTools hjælper udviklere med at undersøge problematiske sessioner. Det er værdifuldt, når en arbejdsgang kræver navigation eller interaktion med siden, før de ønskede oplysninger bliver tilgængelige, i stedet for blot at hente et eksisterende datasæt.
Den væsentligste afvejning handler om valg af produkt og styring af omkostninger. Browsertrafik, resultater fra dataudtræk og køb af datasæt dækker forskellige arbejdsmængder, så én samlet listepris kan ikke beskrive hele platformen. Bright Data passer til teams, der har en ansvarlig for kvaliteten af dataindsamlingen, dækningen af de ønskede mål og udgifterne. Et projekt med et snævert afgrænset omfang kan muligvis komme hurtigere i produktion med et enklere API til dataudtræk.
Fordele og ulemper
- Mange muligheder for dataindsamling på én platform
- Hostede browsere understøtter velafprøvede automatiseringsbiblioteker
- Færdige API’er og datasæt gør opsætningen hurtigere
- Forskellige produkter kræver særskilt planlægning af omkostningerne
- Tilpassede datapipelines kræver stadig teknisk ansvar
2. Firecrawl
Firecrawl er vores anbefaling til udviklere, der omdanner webindhold til nyttig kontekst for en AI-applikation. Værktøjerne til søgning, dataudtræk, kortlægning og crawling dækker hele forløbet fra at finde en side til at indsamle indhold fra et websted. Markdown og struktureret JSON mindsker behovet for efterbehandling af de indhentede data. En researchassistent eller en vidensbase kan derfor bruge mere tid på at besvare spørgsmål og mindre tid på at fjerne navigationsmenuer fra rå HTML.
Det aktuelle tilbud Interact udvider platformen med opgaver i en aktiv browser. Agenter kan beskrive handlinger i naturligt sprog eller afvikle browserkode, bevare tilstanden mellem kald og genbruge godkendte profiler. Det er en væsentlig tilføjelse til sider, hvor man skal klikke, vælge filtre eller logge ind, før data kan hentes. Adgang via MCP og kommandolinjen gør også Firecrawl velegnet i udviklingsarbejdsgange for agenter, frem for kun som et traditionelt API til applikationer.
Firecrawl fungerer bedst, når indsamling af indhold er det umiddelbare behov, og applikationen allerede håndterer lagring og hentning. Teams skal stadig fastlægge grænserne for crawling, bevare kilde-URL’er og skelne mellem et manglende felt og et tomt felt. Kildekoden med åben kildekode giver en anden mulighed for implementering, men teams bør vurdere de konkrete funktioner og driftskrav for den valgte implementering i stedet for at antage, at de hostede og selvadministrerede versioner er identiske.
Fordele og ulemper
- Markdown og JSON passer til AI-pipelines
- Interact understøtter browseropgaver, der bevarer tilstanden
- Adgang via API, MCP og CLI
- Indhentet indhold skal stadig valideres
- Selvadministrerede implementeringer kræver driftsarbejde
3. Apify
Apify er det stærkeste valg her for teams, der ønsker genanvendelige værktøjer til dataudtræk og et sted at drive dem. Markedspladsen distribuerer Actors: færdigpakkede programmer, der modtager input, kører i skyen og returnerer resultater. Eksisterende Actors kan fremskynde almindelige dataindsamlingsopgaver, mens tilpassede Actors giver udviklere mulighed for at bevare deres egen logik til dataudtræk. Det gør Apify til et nyttigt bindeled mellem et eksperiment og en gentagelig produktionsopgave.
Den omgivende platform håndterer vigtige driftsopgaver, herunder planlægning, lagring af resultater, proxyadgang, overvågning og integrationer. Udviklere kan også bygge med Crawlee, Apifys open source-bibliotek til crawling og browserautomatisering. Apifys MCP-server gør Actors tilgængelige for AI-agenter, så det samme færdigpakkede værktøj kan bruges i en applikation, en planlagt pipeline eller en assistent uden at kræve en separat scraperimplementering til hver grænseflade.
Valget af Actor fortjener lige så stor opmærksomhed som valget af platform. Forskellige udgivere kan tilbyde forskellige priser, vedligeholdelsesniveauer, inputmuligheder og datakvalitet. En vellykket kørsel er heller ikke ensbetydende med, at alle forventede poster er indsamlet. Apify er mest oplagt, når nogen har ansvaret for opgavens skema, overvåger ændringer og budgetterer med udgifterne til den valgte Actor og infrastrukturen. En manuel dataudtrækning fra en enkelt side kræver sjældent så omfattende orkestrering.
Fordele og ulemper
- Færdige og tilpassede Actors bruger samme platform
- Planlægning, lagring og overvågning understøtter gentagelige opgaver
- MCP integrerer Actors i agentarbejdsgange
- Vedligeholdelse og kvalitet varierer fra Actor til Actor
- Der skal budgetteres med forbrug og Actor-gebyrer
4. Browse AI
Browse AI er vores anbefaling til erhvervsbrugere, der har brug for løbende webdata uden at skulle udvikle et softwareprojekt. Den nuværende opsætning kan læse en angivet side, foreslå en datastruktur og lade brugeren gennemgå eller justere felterne. Træning af robotten er fortsat afgørende for, at data kan udtrækkes på en ensartet måde. Det er en praktisk løsning for drifts- og marketingteams, der indsamler produktoversigter, poster fra registre eller oplysninger om konkurrenter i velkendte tabeller.
Overvågning er en af løsningens særlige styrker. Robotter kan kontrollere sider efter en tidsplan, registrere tilføjelser eller ændringer og sende beskeder, der forklarer, hvad der er ændret. Arbejdsgange kan forbinde indsamling på tværs af sider, mens integrationer med API’er, webhooks og regneark hjælper med at overføre resultaterne til de værktøjer, teamet allerede bruger. En arbejdsgang til priskontrol kan dermed blive en løbende forretningsproces i stedet for en række manuelle browsertjek.
Den lave adgangstærskel fjerner ikke behovet for en tydelig definition af dataene. Brugerne bør beslutte, hvilke ændringer der skal udløse en besked, og kontrollere, at sideinddeling, logintrin og tomme resultater fungerer korrekt. Større redesign kan stadig kræve manuel indgriben. Browse AI er bedst egnet, når et forretningsteam kan gennemgå de udtrukne rækker og vedligeholde robotten; udviklere, der har brug for nøje versionsstyret browserlogik, foretrækker måske en kodebaseret tjeneste.
Fordele og ulemper
- AI-assisteret opsætning af felter sænker adgangstærsklen
- Planlagt overvågning fremhæver væsentlige ændringer
- Forbindelser til regneark, API’er og webhooks
- Større ændringer på websites kan kræve ny træning
- Kompleks logik kræver omhyggelig udformning af arbejdsgangen
5. SearchAPI
SearchAPI er vores specialistanbefaling til indsamling af søgeresultater som strukturerede data. Tjenestens Google-API kan returnere links til resultater og søgefunktioner i JSON, så man slipper for at vedligeholde en parser til en søgeresultatside, der ændrer sig. Det bredere katalog omfatter kilder som Maps, shopping, nyheder, video og understøttede AI-søgetjenester. Værktøjet er især nyttigt, når søgning og synlighed i søgeresultaterne er selve dataene, snarere end et skridt på vejen mod at gennemgå et andet website.
Lokalisering er en vigtig del af denne anvendelse. Parametre for placering, land, sprog og enhed gør det muligt for teams at undersøge et marked ud fra en bestemt søgekontekst. En SEO-applikation kan følge en søgeforespørgsel i én by, mens en researchassistent kan finde relevante kilder og gemme de returnerede links til senere brug. Dokumentationen for de enkelte søgemaskiner er vigtig, fordi tilgængelige parametre og resultatfelter varierer mellem søgeprodukter.
SearchAPI bør vælges ud fra de søgemaskiner og felter, som arbejdsgangen faktisk kræver. Et søgeresultat indeholder ikke hele indholdet på den tilknyttede side, og mere omfattende visninger af søgeresultater følger ikke alle det samme skema. Teams bør budgettere efter antallet af forespørgsler, afklare kravene til gennemløbskapacitet og håndtere manglende resultatsektioner på en hensigtsmæssig måde. Til udtræk af data fra vilkårlige websites eller en interaktiv browsersession er et andet værktøj i denne guide et bedre udgangspunkt.
Fordele og ulemper
- Strukturerede resultater fjerner behovet for at vedligeholde en SERP-parser
- Bredt katalog af søge- og relaterede søgemaskiner
- Detaljerede indstillinger for lokalisering
- Søgeresultater erstatter ikke dataudtræk fra destinationssider
- Felter og parametre varierer fra søgemaskine til søgemaskine
6. Octoparse
Octoparse demonstrerer sin AI Copilot og automatisering med menneskelig medvirken. Video: Octoparse.
Octoparse er velegnet til analytikere, der vil udforme en scraper visuelt og derefter køre den gentagne gange. Den nuværende platform tilbyder færdige skabeloner, opsætning med AI Assistant og automatisk registrering af sider i desktopapplikationen. Brugerne kan tilpasse den resulterende opgave i stedet for at begynde med browserkode. Fleksibiliteten er nyttig ved indsamling af produktkataloger, registre eller oversigter, hvor rækkefølgen af siderne er lige så vigtig som felterne på hver side.
Kørsel i skyen gør en klargjort opgave til en tilbagevendende indsamlingsproces, uden at en personlig computer behøver at være tændt. Planlægning, parallelle opgaver, rotering af IP-adresser og forbindelser til eksport gør det lettere at håndtere større opgaver end en prototype på en enkelt computer. Den visuelle tilgang tiltaler især teams, der kender deres kildewebsites og datakrav, men ikke ønsker at vedligeholde en skræddersyet tjeneste til browserautomatisering.
Octoparse belønner stadig omhyggelig udformning af opgaver. Sideinddeling, uendelig rulning, formulartrin og dublerede poster kan ændre betydningen af en kørsel, der tilsyneladende er gennemført uden problemer. Kvoter for kørsel i skyen og funktionerne i abonnementet bør passe til den planlagte tidsplan og datamængde. Vi anbefaler værktøjet til teams, der ønsker større kontrol over dataudtrækkets trin, end et hurtigt værktøj med ét klik tilbyder, og som har en navngiven ansvarlig, der kan tilpasse opgaven, når kildesiderne ændres.
Fordele og ulemper
- Skabeloner og AI-assistance gør opsætningen enklere
- Visuel redigering understøtter detaljerede dataudtræksopgaver
- Kørsel i skyen understøtter planlagt dataindsamling
- Komplekse websites kræver finjustering af opgaven
- Cloudfunktioner afhænger af den valgte plan
7. Browserless
Vi anbefaler Browserless til udviklere, der vil styre en browser, mens de overlader hosting og skalering til en administreret tjeneste. Eksisterende Puppeteer- eller Playwright-scripts kan oprette forbindelse til fjernbrowsere, hvilket gør løsningen attraktiv for projekter, der allerede har fungerende automatiseringskode. Det er især nyttigt, når dataindsamlingen omfatter flere interaktioner, en JavaScript-tung brugerflade eller en session, der skal kunne fortsætte ud over en enkelt, simpel forespørgsel.
Tjenesten tilbyder også REST-API’er til scraping, skærmbilleder, PDF-filer og brugerdefinerede browserfunktioner. Den hostede MCP-server gør browserværktøjer tilgængelige for AI-agenter, mens sessionsfunktioner og godkendte profiler understøtter arbejdsgange, der kræver kontinuitet. Browserless egner sig derfor både til udviklere, der bygger deres egen dataindsamler, og til agenter, der skal navigere og indsamle oplysninger via en rigtig browser.
Det vigtigste at overveje ved valg af tjeneste er, hvordan browserforbruget måles. Gratisplanen omfatter i øjeblikket 1.000 enheder om måneden og to samtidige browsere, ikke 1.000 garanterede scrapingjob. Browserbrug forbruger enheder, og der opkræves ekstra for proxytrafik og vellykkede CAPTCHA-løsninger; sessionsbegrænsningerne varierer efter plan. Teamene er fortsat ansvarlige for udtrækslogikken og kontrollen af resultaterne, så Browserless er mest oplagt, når browserstyring er vigtigere end et visuelt værktøj til at bygge robotter.
Fordele og ulemper
- Bevarer velkendte arbejdsgange med Puppeteer og Playwright
- REST-API’er dækker scraping og eksport af sider
- Sessionsfunktioner og MCP egner sig til interaktive agenter
- Browserbrug og tilføjelser påvirker enhedsforbruget
- Brugerdefineret dataudtræk kræver stadig applikationslogik
8. ScrapingBee
ScrapingBee er et godt valg for udviklere, der ønsker en administreret scrapingforespørgsel frem for direkte kontrol over en browser, der kører i længere tid. API’et kombinerer hentning af sider og JavaScript-rendering med proxyadministration, mens data kan udtrækkes ved hjælp af CSS- eller XPath-regler eller AI-instruktioner. Kombinationen er nyttig, når et projekt skal hente strukturerede data fra flere websites, men ikke ønsker at drive sin egen browserflåde.
JavaScript-scenarier kan klikke, rulle, skrive eller vente, før dataene indsamles. Markdown-output understøtter AI-indholdsarbejdsgange, og skærmbilleder gør det muligt at indfange den renderede side. Det aktuelle produkt tilbyder også dedikerede API’er til udvalgte mål samt adgang via CLI og MCP. Udviklere kan bruge eksplicitte udtræksregler til stabile felter og udtræk med naturlige sproginstruktioner, når sidens struktur eller spørgsmålet er mindre forudsigeligt.
Forskellen fra en hostet browserplatform er praktisk: ScrapingBee fokuserer på forespørgslen og det returnerede resultat, mens en brugerdefineret applikation står for den overordnede opgave. Håndtering af flere sider, fjernelse af dubletter, opdateringsplaner og validering af poster skal stadig håndteres et sted. Kreditforbruget ændrer sig også afhængigt af de anvendte funktioner, herunder rendering og proxyindstillinger. Vi anbefaler løsningen til applikationsteams, der foretrækker en enkel HTTP-grænseflade og vil styre orkestreringen af deres datapipeline i egen kode.
Fordele og ulemper
- Vælgerregler og AI-udtræk giver fleksibilitet
- Rendering og scenarier håndterer interaktive sider
- Markdown, CLI og MCP understøtter AI-arbejdsgange
- Avancerede forespørgselsindstillinger øger kreditforbruget
- Opgaver på flere sider kræver stadig orkestrering
9. Oxylabs
Oxylabs er en stærk løsning for teams, der ønsker administreret adgang til vanskelige offentlige websites og mulighed for at indsamle data i større mængder. Den aktuelle Web API omfatter tilbuddet /Scrape til hentning og strukturering af webdata, med JavaScript-rendering og adgangshåndtering integreret i tjenesten. Produktudvalget omfatter også /Search og browserinfrastruktur, hvilket giver teams flere muligheder afhængigt af, om opgaven begynder med research, dataudtræk eller interaktion.
Målrettede muligheder hjælper med at hente nyttige felter fra almindelige søge- og handelswebsites, mens forbindelser via MCP og Agent Skills integrerer dataindsamlingen i AI-arbejdsgange. Oxylabs dokumenterer fortsat også Classic Web Scraper API separat. Denne forskel er vigtig for eksisterende integrationer: Et team, der vedligeholder Classic API, bør bruge den tilhørende dokumentation i stedet for at gå ud fra, at et nyere eksempel fra Web API kan bruges på samme måde.
Oxylabs er mest oplagt, når målwebsitets kompleksitet, datamængden eller omkostningerne ved at vedligeholde adgangsinfrastrukturen berettiger en administreret platform. Applikationen skal stadig definere det ønskede skema, hvor aktuelle dataene skal være, og hvordan ufuldstændige poster skal håndteres. Før en udrulning bør I afstemme den valgte API-generation, målindstillingerne og forbrugsmodellen med den konkrete opgave. Til mindre, manuelle dataudtræk kan et visuelt scrapingværktøj være mere ligetil.
Fordele og ulemper
- Administreret infrastruktur til gengivelse og adgang
- Målrettede muligheder for struktureret dataudtræk
- Den aktuelle web-API understøtter integrationer med agenter
- De klassiske og aktuelle API’er kræver hver sin opsætning
- Kvaliteten af outputtet skal stadig kontrolleres i applikationen
10. Diffbot
Diffbot er vores valg, når det er vigtigere at forstå informationen på en side end at gengive dens layout. Extract bruger computersyn og naturlig sprogbehandling til at klassificere sider og generere struktureret JSON efter standardiserede skemaer. For et team, der indsamler artikler eller produkter fra mange kilder, kan det mindske mængden af webstedsspecifik kode til datafortolkning, der skal til for at omdanne siderne til sammenlignelige dataposter.
Diffbots Knowledge Graph dækker et beslægtet, men særskilt behov: at arbejde med enheder som organisationer, personer og artikler, der allerede er samlet fra det offentligt tilgængelige web. Poster kan kombinere oplysninger fra flere kilder og forbinde enheder gennem meningsfulde relationer. Det gør Diffbot nyttig til berigelse, virksomhedsresearch og efterretningsapplikationer, der har brug for kontekst ud over de felter, der er synlige på en enkelt side.
Kompromiset består i at tilpasse sig Diffbots datamodel. Standardiseret dataudtræk er værdifuldt, når sidetyperne og felterne passer til opgaven, men usædvanlige felter eller specialiserede interaktioner kan stadig kræve en anden tilgang. Teams bør skelne mellem at hente data fra de valgte URL’er og at forespørge i en eksisterende vidensgraf og derefter vurdere dækning og kildernes aktualitet i overensstemmelse hermed. Diffbot egner sig bedre til tekniske teams, der udvikler normaliserede informationsprodukter, end til brugere, der blot har brug for at kopiere nogle få rækker til et regneark.
Fordele og ulemper
- Automatisk klassificering mindsker behovet for parserarbejde
- Standardskemaer gør det lettere at normalisere lignende sider
- Knowledge Graph tilføjer kontekst om enheder
- Standardfelter dækker muligvis ikke specialiserede behov
- Dataudtræk og adgang til vidensgraf understøtter forskellige arbejdsgange
Ofte stillede spørgsmål
Hvad gør et webscrapingværktøj AI-drevet?
AI kan hjælpe med at identificere felter, fortolke sideindhold, generere trin til dataudtræk eller styre handlinger i browseren. Nogle værktøjer bruger AI under opsætningen, mens andre bruger det ved hvert dataudtræk. En tjeneste kan også understøtte AI-applikationer ved at levere rent indhold uden at bruge en sprogmodel til hver forespørgsel. Vælg den funktion, der løser dit indsamlingsbehov, i stedet for at stole på betegnelsen.
Hvad er forskellen på scraping og browserautomatisering?
Scraping indsamler oplysninger. Browserautomatisering udfører handlinger på sider, f.eks. åbner menuer, indtaster en søgning eller gennemgår en arbejdsgang med flere trin. De bruges ofte sammen: En automatiseret browser åbner den relevante sidetilstand, hvorefter et dataudtræk indsamler felterne. En direkte API-anmodning er som regel enklere, når sådanne interaktioner ikke er nødvendige.
Hvilke værktøjer egner sig bedst til et team uden tekniske kompetencer?
Browse AI er vores første anbefaling til enkel, tilbagevendende dataindsamling og overvågning af ændringer. Octoparse er et godt alternativ, når teamet ønsker større visuel kontrol over opgavetrinnene. Begge fungerer bedst, når nogen gennemgår de resulterende dataposter og er opmærksom på, hvornår kildewebstedet er ændret.
Hvilke oplysninger bør en AI- eller RAG-pipeline bevare fra et scrape?
Bevar kilde-URL’en, indsamlingstidspunktet, sidetitlen og den tekst eller de strukturerede felter, som applikationen har brug for. Markdown kan bevare dokumentets læsbare struktur, mens JSON understøtter definerede dataposter. Fjern dubleret indhold, og undgå at blande navigationstekst sammen med hovedindholdet. Når oplysninger om kildernes oprindelse bevares, bliver det lettere at spore og opdatere senere svar.
Hvornår kan det betale sig at bruge en administreret browser?
En administreret browser er nyttig, når dataindsamlingen kræver JavaScript-afvikling, flere interaktioner eller vedvarende sessioner, og teamet vil undgå at hoste browserprocesser. Browserless er en specialiseret løsning til eksisterende Puppeteer- eller Playwright-kode. Til en enkelt statisk side kan en enklere hente- eller dataudtræks-API kræve færre ressourcer.
Er 1.000 gratis enheder det samme som 1.000 scrapingkørsler?
Nej. Enheder og kreditter følger hver udbyders egne regler. Browserless måler browserforbindelser i intervaller på op til 30 sekunder, og proxytrafik samt løsning af CAPTCHA’er medfører yderligere enhedsforbrug. Andre tjenester opkræver betaling efter anmodningsindstillinger, dataposter eller beregningsforbrug. Beregn omkostningerne for hele arbejdsgangen i stedet for at sidestille forskellige gratis kvoter.
Kan man stole på resultatet af AI-baseret dataudtræk uden at kontrollere det?
Et gyldigt JSON-svar kan stadig mangle en datapost eller fejlfortolke et felt. Definér de obligatoriske felter, kontrollér datatyper og intervaller, stikprøvekontrollér kildesiderne, og hold øje med ændringer i antallet af dataposter. Ved tilbagevendende opgaver er tydelige fejltilstande og tilstande med tomme resultater mere nyttige end at betragte hvert svar som et komplet datasæt.
Afsluttende tanker om AI-værktøjer til webscraping
Bright Data er vores bedste samlede valg til et bredt program for indsamling af webdata, mens Firecrawl er det bedste sted at starte, hvis websider skal omdannes til AI-egnet indhold. Vælg Apify, når genanvendelige værktøjer, planlagte jobs og drift i skyen er centrale for projektet.
Til virksomhedsteams gør Browse AI løbende overvågning let at gå til, mens Octoparse giver brugerne en visuel måde at finjustere mere omfattende dataudtræksopgaver på. SearchAPI er det specialiserede valg, når det ønskede resultat er strukturerede søgedata.
Browserless fortjener sin plads blandt værktøjerne til udviklere, der ønsker administreret browserafvikling med velkendte automatiseringsbiblioteker. ScrapingBee er et stærkt alternativ, når en administreret anmodning om dataudtræk passer bedre til applikationen. Oxylabs egner sig til krævende indsamling af data fra det offentlige web, mens Diffbot skiller sig ud med standardiseret dataudtræk og entitetsanalyse.
Det bedste valg på lang sigt er det, der leverer de nødvendige oplysninger gennem en arbejdsgang, som teamet kan vedligeholde. Tilpas indsamlingsmetoden til opgaven, bevar konteksten fra kilden, og vurder værdien ud fra, hvor anvendelige resultaterne er, ikke ud fra antallet af sider, der er anmodet om.




