
Interviews
Ben Koska, grundlægger og administrerende direktør for SF Tensor – Intervju-serie

 Føj Unite.AI til dine foretrukne kilder på Google
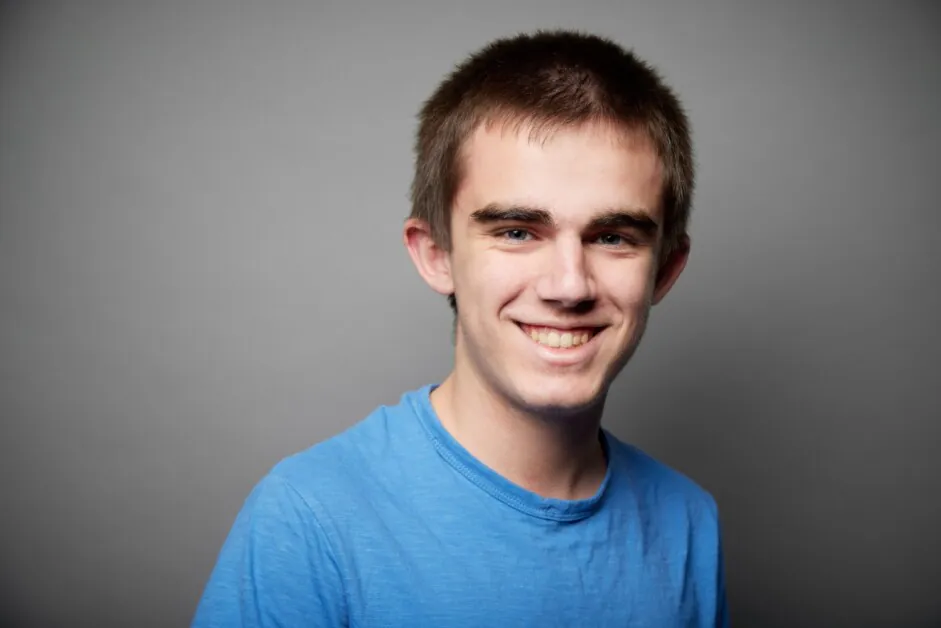
Ben Koska, grundlægger og administrerende direktør for SF Tensor, er en AI-forsker og systemingeniør kendt for sit arbejde med højpræstationsberegning, kerneloptimering og effektiv modeltræning. Hans baggrund omfatter udvikling af lavniveauds AI-infrastruktur, forbedring af træningsgennemløb og design af værktøjer, der gør avanceret modeludvikling tilgængelig uden tungt ingeniørarbejde. Han fokuserer på at bygge systemer, der tester grænserne for hastighed, bæring og pålidelighed på tværs af heterogene hardware.
SF Tensor er det selskab, han leder for at omsætte denne filosofi til en praktisk platform. Det introducerer en samlet programmeringsmodel, en kerneloptimerer og en cross-cloud-koordineringslag, der er designet til at fjerne kompleksiteten af distribuerede AI-arbejdslaster. Platformen sigter mod at give ingeniører en ren, hardware-agnostisk miljø, hvor de kan skrive en gang, installere overalt og automatisk opnå høj ydeevne. SF Tensors mission er at gøre AI-beregning dramatisk hurtigere, lettere at styre og fri for leverandørslås.
Du grundlagde SF Tensor, da du var 19 år gammel, efter allerede at have ledet ingeniørarbejde i flere startups. Hvad inspirerede dig til at påtage dig udfordringen med at genopfinde AI-infrastruktur så tidligt i din karriere?
Problemet, vi løser, er et, som jeg dybt omfatter, fordi det er et, jeg selv har stødt på. Da vi udviklede, hvad der nu er SF Tensors kernestack, arbejdede vi ikke på et kommercielt projekt, men på et akademisk projekt. Vi havde modtaget en bevilling til at udføre nogle interessante forskningsprojekter, men tilbragte det meste af vores tid med at håndtere infrastruktur og optimeringer i stedet for at udføre forskning. Vi fandt ud af, at folk var universelt mere interesseret i vores infrastrukturteknologi end i vores forskningsprojekt.
SF Tensor tager fat på et af de sværeste problemer i AI – at bryde fri fra NVIDIAs CUDA-dominans. Hvordan gjorde du tilgangen til at designe et system, der kunne opnå sand hardware-portabilitet uden at gå på kompromis med ydeevnen
Til sidst handler al AI om simple matematiske beregninger. Hver model er i virkeligheden en samling af matematiske operationer, som vi skal beregne resultaterne for. Ved at behandle det primært som et matematisk problem i stedet for et datalogisk problem kan vi identificere den mindste mængde af begrænsninger på beregningerne og derefter generere millioner til milliarder af forskellige måder at omdanne disse beregninger til maskinkode og finde den hurtigste. Det er lettere sagt end gjort, fordi vi ikke kan køre millioner af forskellige programmer for at finde den hurtigste, så for at begrænse vores søgefelt måtte vi komme med en nøjagtig matematisk model til at estime ydeevnen af et givent program på en given hardware, hvilket er en af de centrale innovationer, der gør, hvad vi gør muligt i dag.
Selskabets blog fremhæver innovationer omkring compiler-optimering og cross-cloud-koordinering. Kan du forklare, hvordan SF Tensors tilgang adskiller sig fra eksisterende rammer som PyTorch eller JAX?
Vi har ikke skrevet en teknisk blog om det endnu, men vi støtter faktisk rammer som PyTorch og JAX, så kode skrevet i dem kan optimeres af vores stack. Der er flere arkitektoniske beslutninger, som JAX og PyTorch har taget, som adskiller dem fra vores stack, men den mest betydningsfulde er, at vi behandler hele modellen som en enkelt beregning, der skal løses, i stedet for enkeltmoduler, der skal optimeres individuelt og derefter sammen. I denne forstand skaber vi i stedet for at anvende traditionelle compiler-optimeringsteknikker og prøve at anvende hver enkelt optimering, et søgefelt på millioner til milliarder af potentielle kerner og gør påstanden om, at ingen menneske kan komme op med en samling af regler til at omdanne en given kode til den hurtigste, så vi må i stedet skabe hver kombination og derefter identificere den hurtigste.
Mange startups er fokuseret på træningseffektivitet, men du har understreget “infrastruktur-afgiften” – den tid, forskere taber på at styre beregning i stedet for at innovere. Hvordan løser SF Tensor denne ubalance?
Vi mener, at begge problemer skal løses, og en stor del af vores arbejde går til at løse træningseffektivitet, men det mest akute problem, vi kan løse lige nu uden at være afhængig af fremtidige innovationer, er infrastruktur-afgiften, da det er et problem, vi allerede har løst for os selv.
Du har nævnt op til 80% reduktion i træningsomkostninger. Hvad er de specifikke optimeringer eller arkitektoniske gennembrud, der gør dette muligt?
Hele vores software-stack er bygget på idéen om, at en søgebaseret compiler altid vil slå menneskeskabte regler. Indtil nu har den største begrænsning på disse compilere været, at det ikke er muligt at benchmark og rangere millioner eller endda milliarder af kerner. Det var derfor nødvendigt for os at skabe en matematisk model af beregning, der kan estime tiden, en given beregning eller en samling af beregninger vil tage på en given hardware. Ved at gøre dette kan vi udvide vores søgefelt og derefter trimme det ned, hvilket er en nødvendighed, hvis vi vil finde de hurtigste kerner konsekvent.
Hvordan påvirker din baggrund i opbygningen af Emma-programmeringssproget SF Tensors arkitektur og filosofi over for ydeevne og abstraktion?
Fortæl ikke mine investorer, men i hjertet er jeg stadig en compiler-ingeniør. Jeg har altid været interesseret i at finde forskellige måder at gøre tingene endda bare incrementelt hurtigere. I udviklingen af Emma kastede vi hele compileren ud 4 eller 5 gange; vi startede fra scratch, hver gang fordi vi stødte på en optimering, vi ikke kunne implementere, given de nuværende begrænsninger, hvilket tvang os til at genopbygge systemet til at være endnu mere generelt, mens vi stadig tillod os at gå ned på det laveste niveau af optimering, når det var nødvendigt, ofte imod almindelige principper for compiler- og sprogdesign. Disse erfaringer og den resulterende arkitektur kombineret næsten to års, hvad der så ud som mindre optimeringer og forkerte væddemål, har ført til et system, der tillader os at iterere hurtigere og optimere bedre end noget af de systemer, der fulgte almindelige principper, fordi disse principper er grundlæggende designet til CPU’er, ikke GPU’er og AI-modeller.
Du har arbejdet med store træningsløb på tværs af 4.000+ GPU’er – hvad var nogle af de største erfaringer fra at styre beregning i den skala?
En stor en er, at hardware-fejl er langt mere udbredt og problematisk, end man måske antager. Efter at have tilbragt en masse tid med at arbejde med traditionelle programmer og compilere, generelt taler en computer præcis, som den bliver bedt om, og hvis noget går galt, er det næsten altid skylden på personen, der skrev koden. Med GPU’er er hardware-fejl en almindelig forekomst, især i distribuerede træningsløb på ekstremt store cluster. Det følger med, at i modsætning til CPU’er, der generelt opfører sig deterministisk og forudsigeligt, kan GPU’er nogen gange uforklarligt gøre ting som at sænke urtakt for ingen åbenbar grund, hvilket langsommere hele træningsprocessen, fordi en enkelt chip kører langsommere.
Y Combinator har støttet nogle af de mest transformerende infrastrukturselskaber i tech. Hvordan har denne erfaring formet din tilgang til at skala SF Tensors produkt og vision?
Da jeg startede i Y Combinator, troede jeg, at det væddemål, vi ville gøre dengang, var ambitiøst. Efter kun få uger havde vores definition af ambitiøst ændret sig dramatisk, og vi satte vores lid til et endnu større væddemål. For en anden del har følelsen af fællesskab og læring, som jeg kan tage telefonen eller sende en email til næsten ethvert selskab eller person derude og få en respons og råd inden for få timer til dage, ændret måden, vi tænker om at løse problemer og til at acceptere en betydeligt mere samarbejdsorienteret tilgang.
Med henblik på fremtiden har du udtrykt interesse for ikke-LLM-modeller, robotteknologi og syntetisk data. Hvordan passer disse områder ind i din langsigtede vision for selskabet?
LLM’er er absolut en interessant teknologi og vil have en integreret del i, hvordan verden ser ud i fremtiden, men årsagen til, at de er så meget mere avancerede end noget andet område i AI, stammer hovedsageligt fra, at der investeres en masse penge i deres udvikling, og der er nok mennesker, der samarbejder om problemet, så de er blevet ret godt optimeret. Hvis vi kan sænke barrieren for indgang, så forskere over hele landet og planeten, selv de med begrænsede ressourcer og lidt eller ingen viden om optimeringer, kan udføre deres forskning så billigt og effektivt som muligt, tror jeg, vi vil se en hel ny generation af modeller dukke op, der vil løse problemer, som LLM’er ikke er egnede til, enten fordi de interagerer med den fysiske verden eller fordi de er problemer, der ikke kan udtrykkes ordentligt i sprog.
Hvad tror du, AI-infrastruktur-stakken vil se ud som om fem år – og hvor ser du SF Tensors rolle inden for den?
Om fem år håber jeg, at mange flere selskaber vil have udviklet og udgivet deres egne specialiserede chip, og at forskere vil kunne udnytte og anvende dem uden at skulle skrive kode specifikt til dem, ideelt uden endda at skulle vide, at de findes. Det er den fremtid, vi arbejder hen imod, og som jeg tror, vi vil have en betydelig rolle i at forme.
Tak for det gode interview, læsere, der ønsker at lære mere, skal besøge SF Tensor.


