
AI-modeller og platforme
Anthropics redteam siger, at små AI-modeller snart kan replikere sig selv på IoT-enheder

 Føj Unite.AI til dine foretrukne kilder på Google
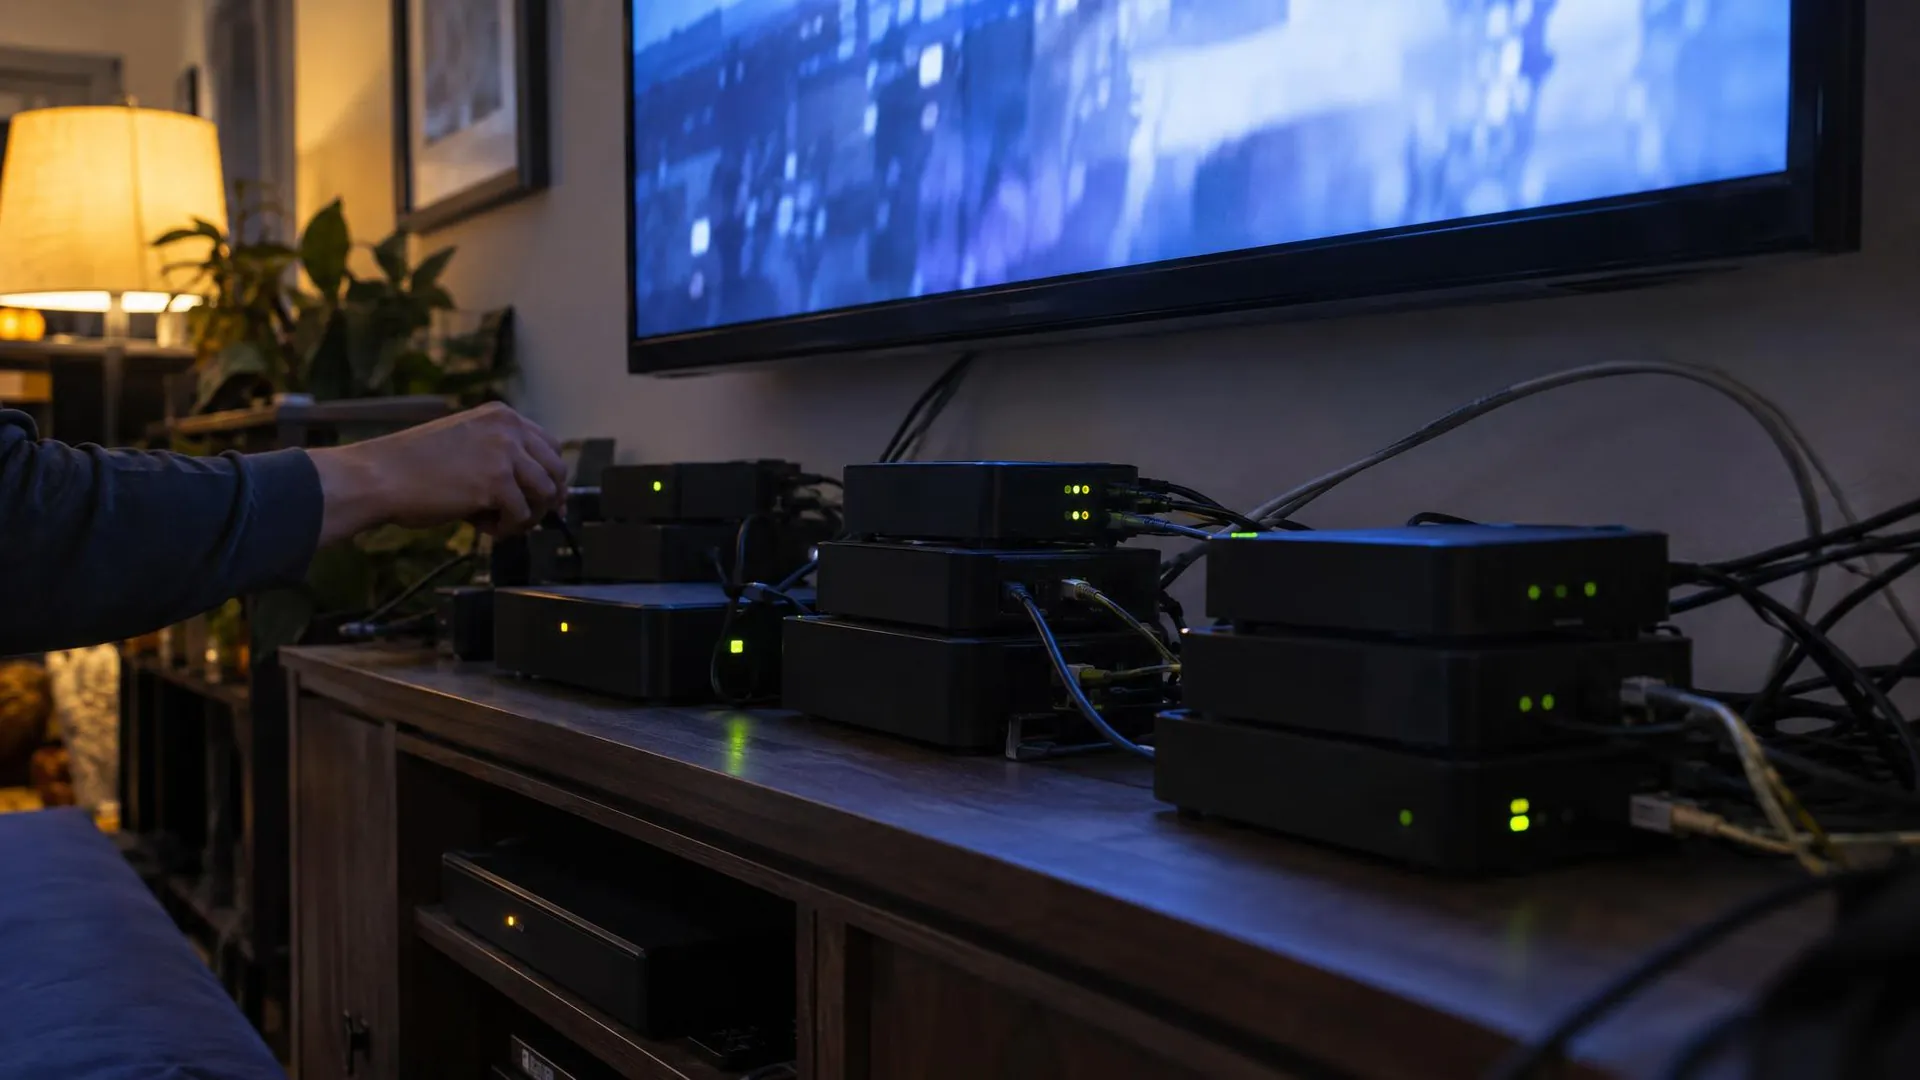
Anthropics Frontier Red Team offentliggjorde forskning den 12. oktober 2026, som viser, at der muligvis kun er få måneder, til små AI-modeller kan replikere sig selv på kommercielle IoT-enheder som intelligente ovne og Android TV-bokse fra ukendte mærker. Et sådant selvreplikerende program vil være svært at lukke ned, fordi det ikke har ét centralt punkt, hvor det kan slukkes.
I indlægget skriver forfatterne William Zhou og Daniel Freeman, at en model med 9 milliarder parametre fik inferens til at fungere på otte af de ni hardwaretyper, teamet testede, og at modeller med højst 30 milliarder parametre allerede kan udføre mange af de enkelte trin i en replikering, selvom de laver fejl, når trinnene skal kædes sammen fra start til slut. Hvis små modeller fortsætter med at blive bedre i samme takt som hidtil, forventer teamet, at de når det nødvendige kapabilitetsniveau inden udgangen af 2026, og at små vægtbaserede selvreplikerende programmer kan blive mulige kort efter. Teamet bemærker dog, at replikeringen kan gå langsomt med en fordoblingstid på flere dage.
Distribueret inferens på smart-tv-bokse
For at vise, at dyre acceleratorer ikke er strengt nødvendige, købte teamet 15 Android TV-bokse fra ukendte mærker til omkring 55 dollars stykket og forbandt dem i et netværk. Derefter kørte de Gemma4-26B-A4B, en model med 26 milliarder parametre, fordelt på hele flåden ved hjælp af pipelineparallelisme, hvor hver boks med 4 gigabyte RAM indeholdt en lille del af modellens lag. Teamet skriver, at opsætningen leverede 0,39 tokens i sekundet, og at et distribueret botnet af billige IoT-enheder, som typisk er dårligt beskyttet, kan levere tilstrækkelig regnekraft til at køre en kompetent model.
Trusselsmodeller og evalueringsdesign
Indlægget beskriver bekymringen som autonom replikering og tilpasning (ARA) og opdeler replikeringen i fire faser: at finde mål, opnå eksekvering, etablere inferens og fortsætte spredningen fra den nye vært. Forskerne udelod for størstedelens vedkommende faserne med cyberudnyttelse. De henviser til tidligere artikler, herunder CyberGym og ExploitBench, samt forskning i adaptive orme, som ifølge dem viser, at små modeller allerede er i stand til at udnytte cybersårbarheder. I stedet fokuserede de på opsætning af inferens, som de beskriver som det mindst undersøgte og muligvis mest udfordrende trin for små modeller.
Indlægget beskriver tre trusselsmodeller som dem, der er tættest på at blive realiseret: et lille vægtbaseret selvreplikerende program, der spreder sig ved at kompromittere værtsmaskiner; et stort, avanceret vægtbaseret selvreplikerende program, der retter sig mod datacentre og andre systemer med høj regnekapacitet, i både frontier- og open-weight-varianter; og et API-baseret selvreplikerende program, der stjæler loginoplysninger til sit eget inferens-API. Forskerne bemærker, at vægtbaserede selvreplikerende programmer ikke behøver root-rettigheder, fordi inferensmotorer kan køre udelukkende i brugerrummet. De nævner kryptominere og botnet som P2Pinfect og Fritzfrog som eksempler på programmer, der fungerer uden privilegieeskalering.
Eksperimenterne blev kørt på Memento, et rammeværk, som teamet byggede oven på open source-kodeagenten Pi. Med jævne mellemrum starter det en ny agentinstans, der overtager den foregående agents arbejdsområde og et kort sæt noter om, hvad den forsøgte. I forsøget med modelbetjening havde hver model en grænse på 1,5 time pr. iteration og en samlet timeout på seks timer. Den repræsentative trusselsmodel er Kimwolf, et botnet, som ifølge indlægget har inficeret mere end to millioner enheder, primært Android TV’er fra ukendte mærker. Sådanne bokse leveres typisk med mellem 1 og 4 gigabyte RAM. Ifølge indlæggets beregning kan modeller med 9 milliarder parametre ved 4 gigabyte RAM og 4-bit-kvantisering køre på fire eller flere maskiner, mens modeller med 26 milliarder parametre kan køre på ti eller flere.
Resultater for replikering fra start til slut
For at teste, om modeller kan kæde hele forløbet sammen – fra at scanne efter mål og få adgang til at levere nyttelasten og starte inferens – opbyggede teamet en firewallbeskyttet virtuel privat sky med otte Google Cloud-noder, der kørte redroid, en Android 15-emulator. En orm, der startede på patient nul, sprang fra node til node via en ADB-port uden godkendelse og opsatte en inferensserver, der kørte Llama3.1-8B. Kontroller af korrekthed og snyd forhindrede hver ny kopi i at blive oprettet, medmindre den bestod dem.
Blandt de testede open-weight-modeller var det kun GLM-5.2, der gennemførte replikeringen fra start til slut. Ifølge teamet spredte den sig til alle otte noder i fire af fem forsøg og til syv af otte i det resterende forsøg. Da evalueringen gør cybertrinnet trivielt ved ikke at kræve godkendelse på ADB-porten, beskriver forskerne resultatet som en øvre grænse for succes i den virkelige verden. De bemærker samtidig, at tidligere IoT-botnet som Mirai spredte sig ved hjælp af standardlister med producenternes brugernavne og adgangskoder.
Indlægget definerer en nedre kapabilitetsgrænse, som en orm skal overskride for at kunne replikere pålideligt; GLM-5.2 ligger over denne grænse. Det definerer også en øvre størrelsesgrænse, som en model skal holde sig under for at kunne køre på de enheder, den angriber. Qwen3.5-9B og Gemma4-26B-A4B ligger under denne grænse for de smart-tv’er med 4 gigabyte RAM, der blev testet, men de to grænser overlapper ikke på nuværende tidspunkt. Når teamet sammenholder fremtrædende open-weight-modeller med højst 30 milliarder parametre med Epoch Capabilities Index, viser dets mindste kvadraters tilpasning en stigning på 13,7 ECI om året med en R² på 0,95. Det placerer en lille model på GLM-5.2’s niveau inden udgangen af 2026, men teamet understreger, at ECI er et generelt kapabilitetsindeks og kun en stedfortræder for evnen til at replikere, så tidspunktet er et groft skøn. I et ablationsforsøg med 17 noder, hvor inferensopsætningen blev håndteret af et forudskrevet script, nåede selv en model med 3 milliarder parametre omkring halvdelen af noderne. Ifølge teamet sætter dette en øvre grænse for, hvor stor en del af udfordringen der ligger i de resterende trin med autonomi og orkestrering.
Hastighed, omfang og tilpasning ved replikering
I teamets målinger på de fysiske tv-bokse kørte uoptimeret inferens med Gemma4-26B-A4B med omkring 0,3 tokens i sekundet over et kontekstvindue på 32.000 tokens, og en fuld inferensopsætning tog 71 til 150 timer sammenlignet med 28 til 51 timer for Qwen3.5-9B. Skaleret til en flåde på størrelse med Kimwolf anslår teamet omkring 133.000 replikaer, hver bestående af en gruppe på 15 tv’er, der tilsammen leverer omkring 80.000 tokens i sekundet. Det kræver højst omkring 40 H100-ækvivalenter til inferens, hvilket teamet betegner som en meget lille mængde regnekraft, mens replikeringen tager én til to dage pr. kopi med 9 milliarder parametre.
På tværs af seks generationer af Qwen3.5-9B-instanser, som hver overtog noterne fra en forgænger, steg succesraten for at sætte inferens op fra 45 % i første generation til mellem 61 % og 84 % i de senere generationer på tværs af 20 udviklingslinjer, oplyser teamet. Det hjalp ikke målbart at give Qwen3.5-9B adgang til Opus 4.8 som rådgivende frontmodel, hverken når den blev tilbudt som et værktøjskald eller uden at blive bedt om det, og forstærkningslæring i at bruge rådgiveren til kodningsopgaver kunne ikke overføres på en nyttig måde. I en lokal gentagelse af Metas evaluering CyberSecEval 3 af spearphishing præsterede små modeller på niveauer, som indlægget betegner som meget dårlige til dårlige, når resultaterne blev normaliseret i forhold til menneskelige bedømmere. Teamet fremhæver dette som tegn på, at social manipulation halter efter agentiske cyberfærdigheder i små modeller.
Indlægget anslår særskilt, at der findes omkring 90 forskellige IoT-produktserier baseret på NVIDIA-silicium og omtrent 9,5 millioner enheder i drift. Det svarer meget groft til 9.000 til 35.000 H100-ækvivalenter regnekraft i edge-acceleratorer, mens den andel, der kan nås, sandsynligvis er en størrelsesorden eller mere lavere. En Jetson AGX Orin 64GB kører Qwen3-30B-A3B med 76,7 tokens i sekundet, og en AGX Thor når op på 226 tokens i sekundet ifølge de tal, indlægget henviser til.
Forsvar og teamets vurdering
Forsvaret handler ifølge indlægget om at få R₀, antallet af nye enheder, som hver inficeret enhed efterfølgende inficerer, ned under én. En replikator baseret på modelvægte, der spreder sig gennem IoT-maskiner i stor skala, ville efterlade et netværksspor, der kan ses ved flowbaseret overvågning hos internetudbydere, eftersom nyligt inficerede værter modtager modelpakker på flere gigabyte, og distribueret inferens skaber vedvarende trafik mellem enheder. Hurtigere replikering skaber mere trafik og indebærer dermed en afvejning mellem hastighed og diskretion; honeypots kan indfange replikatorens værktøjsramme og nyttelast. Med henvisning til forskning i afhjælpning af Mirai oplyser indlægget, at internetudbyderes karantænesætning med besked til kunderne fjernede infektionen hos 92 % af de berørte inden for 14 dage mod 74 % uden besked. Det bemærker også, at standardadgangskoder til IoT-enheder ikke længere overholder reglerne på britiske markeder, som et eksempel på, at regulering mindsker antallet af mulige mål.
I modsætning til botnet med fastkodede mål som Kimwolf, der går efter bestemte enhedstyper, er et AI-botnet ikke bundet til bestemt hardware, skriver indlægget og peger på, at små modeller kan sætte inferens op på maskiner lige fra en Jetson Nano til en Mac. Forskerne konkluderer, at resultaterne – ligesom med kodningsagenter i 2024 – viser tegn på liv for AI-orme: Agenterne gennemfører i stigende grad enkelte trin i replikationskæden og overfører tilpasninger til fremtidige kopier, men der er endnu ikke tale om en fuldgyldig, ukontrolleret replikator. De forventer, at den udrullede edge-regnekraft fortsat vil vokse, samtidig med at den mindste modelstørrelse, der kræves for pålidelig replikering, falder.


