
Interviews
Amy Steier, ledende forsker inden for maskinlæring hos Gretel.ai – Interviewserie

 Føj Unite.AI til dine foretrukne kilder på Google
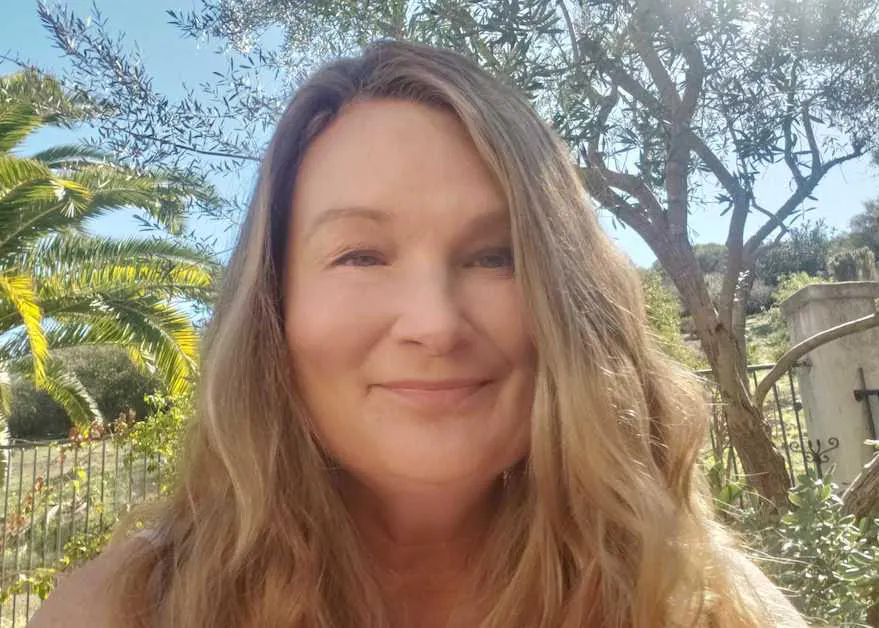
Amy Steier er ledende forsker inden for maskinlæring hos Gretel.ai, verdens mest avancerede platform for teknologi til beskyttelse af privatliv. Gretel gør det let at integrere privatlivsbeskyttelse i data-dreven teknologi. Dets AI-baserede, open-source-biblioteker er designet til at transformere, anonymisere og syntetisere følsomme oplysninger.
Amy er en meget erfaren forsker inden for maskinlæring og datavidenskab med mere end 20 års erfaring. Hendes passion er big data og at afsløre den skjulte intelligens ved hjælp af teknikker fra maskinlæring, dataudvinding, kunstig intelligens og statistik. Hun er meget dygtig i prædiktiv modellering, klassifikation, klaster, afvigelsesdetektering, datavisualisering, ensemblemetoder, informationshenting, cybersecurity-analyse, NLP, anbefalingsmodeller og brugeradfærdsanalyse.
Hvad var det, der oprindeligt tiltrak dig til at forfølge en karriere inden for datalogi og maskinlæring?
Min rene, ubeskedne, varige kærlighed til data. Dataens magt, mysterium, intrige og potentiale har altid fascineret mig. Datalogi og maskinlæring er værktøjer til at udnytte dette potentiale. Det er også frygteligt sjovt at arbejde i et felt, hvor den nyeste teknologi udvikler sig så hurtigt. Jeg elsker skæringen mellem forskning og produkt. Det er meget tilfredsstillende at tage banebrydende idéer, skubbe dem lidt længere og derefter omforme dem til at passe til eksisterende, konkrete produktbehov.
For læsere, der ikke er bekendt med det, kunne du forklare, hvad syntetisk data er?
Syntetisk data er data, der ligner og opfører sig som den originale data, men også er forskellig nok til at tilfredsstille et bestemt formål. Det mest almindelige formål er behovet for at beskytte privatlivets fred i den originale data. Et andet formål er behovet for at oprette yderligere data for at øge størrelsen af den originale dataset. Endnu et formål er at hjælpe med at løse en klasse-ubalance eller måske demografisk fordom i den originale dataset.
Syntetisk data giver os mulighed for at fortsætte med at udvikle nye og innovative produkter og løsninger, når dataene, der er nødvendige for at gøre det, ellers ikke ville være til stede eller tilgængelige.
Hvordan fungerer Gretel-platformen til at oprette syntetisk data via API’er?
Gretel privatlivsingeniør-API’er giver dig mulighed for at indtaste data til Gretel og udforske data, som vi kan udtrække. Disse er de samme API’er, der bruges af vores Console. Ved at eksponere API’erne gennem en intuitiv interface håber vi at give udviklere og datavidenskabsmænd mulighed for at bygge deres egne arbejdsgange omkring Gretel.
mens konsollen gør det meget let at oprette syntetisk data, giver API’erne dig mulighed for at integrere oprettelsen af syntetisk data i din arbejdsgang. Jeg elsker at bruge API’erne, fordi de giver mig mulighed for at tilpasse oprettelsen af syntetisk data til et meget bestemt formål.
Kunne du diskutere nogle af de værktøjer, der tilbydes af Gretel til at hjælpe med at vurderere kvaliteten af den syntetiske data?
Efter oprettelsen af syntetisk data vil Gretel generere en syntetisk rapport. I denne rapport kan du se Syntetisk Datakvalitetsscore (SQS), samt en Privatlivsbeskyttelsesniveau-karakter (PPL).
SQS-scoren er en estimering af, hvor godt den genererede syntetiske data opretholder de samme statistiske egenskaber som den originale dataset. På denne måde kan SQS-scoren ses som en nyttescore eller en tillids-score for, om videnskabelige konklusioner, der er draget fra den syntetiske dataset, ville være de samme, hvis man havde brugt den originale dataset i stedet.
Syntetisk Datakvalitetsscore beregnes ved at kombinere de enkelte kvalitetsmetrikker: Feltfordelingsstabilitet, Feltkorrelationsstabilitet og Dybdestrukturstabilitet.
Feltfordelingsstabilitet er en måling af, hvor godt den syntetiske data opretholder de samme feltfordelinger som i den originale data. Feltkorrelationsstabilitet er en måling af, hvor godt korrelationer mellem felter er opretholdt i den syntetiske data. Og endelig måler Dybdestrukturstabilitet den statistiske integritet af dybere, multifeltfordelinger og korrelationer. For at estimere dette sammenligner Gretel en Principal Component Analysis (PCA) beregnet først på den originale data, derefter igen på den syntetiske data.
Hvordan fungerer Gretel privatlivsfilter?
Gretels privatlivsfiltre var kulminationen af megen forskning i naturen af fjendtlige angreb på syntetisk data. Privatlivsfilterne forhindrer oprettelsen af syntetisk data med svagheder, der ofte udnyttes af fjendtlige angreb. Vi har to Privatlivsfilter, det første er Lighedsfilteret, og det andet er filteret for ekstreme observationer. Lighedsfilteret forhindrer oprettelsen af syntetiske poster, der er for lignende til en træningspost. Disse er primære mål for fjendtlige angreb, der søger at få indsigt i den originale data. Det andet Privatlivsfilter er filteret for ekstreme observationer. Dette forhindrer oprettelsen af syntetiske poster, der ville blive betragtet som en ekstrem observation i det rum, der er defineret af træningsdataen. Ekstreme observationer, der afsløres i en syntetisk dataset, kan udnyttes af Medlemskabsinferenceangreb, Attributinference og en lang række andre fjendtlige angreb. De er en alvorlig privatlivsrisiko.
Hvordan kan syntetisk data hjælpe med at reducere AI-forvrængning?
Den mest almindelige teknik er at løse den repræsentative forvrængning af data, der fødes ind i et AI-system. For eksempel, hvis der er en stærk klasse-ubalance i dine data, eller måske eksisterer der demografisk fordom i dine data, tilbyder Gretel værktøjer til at hjælpe med at måle ubalancen og derefter løse den i den syntetiske data. Ved at fjerne forvrængningen i dataene fjerner du ofte også forvrængningen i AI-systemet, der er bygget på dataene.
Du synes åbenbart at nyde at lære om nye maskinlærings-teknologier, hvordan gør du personligt for at følge med alle ændringerne?
Læs, læs og derefter læs lidt mere, lol! Jeg nyder at starte min dag med at læse om nye ML-teknologier. Medium kender mig så godt. Jeg nyder at læse artikler i Towards Data Science, Analytics Vidhya og nyhedsbreve som The Sequence. Facebook (META ) AI, Google (GOOGL ) AI og OpenMined har alle gode blogs. Der er en masse gode konferencer at følge, som NeurIPS, ICML, ICLR, AISTATS.
Jeg nyder også værktøjer, der sporer citationstrin, hjælper dig med at finde papirer, der ligner dem, du kan lide, og som lærer at kende dine specifikke interesser og altid holder øje med en forskningsartikel, der måske interesserer dig. Zeta Alpha er et sådant værktøj, jeg bruger meget.
Til sidst kan man ikke undervurdere fordelene ved at have kolleger med lignende interesser. Hos Gretel sporer ML-holdet forskningspapirer, der er relevante for de områder, vi udforsker, og mødes ofte for at diskutere interessante papirer.
Hvad er din vision for fremtiden for maskinlæring?
Let adgang til data vil udløse en stor æra af innovation i maskinlæring, der derefter turbo-lader innovation i en bred vifte af felter, såsom sundhedsvæsen, finans, fremstilling og biovidenskab. Historisk set kan mange banebrydende fremskridt i ML tilskrives en stor mængde rig data. Dog har meget forskning historisk set været hæmmet af manglende evne til at få adgang til eller dele data på grund af privatlivsbeskyttelsesproblemer. Da værktøjer som Gretel fjerner denne barriere, vil adgangen til data blive demokratiseret. Hele maskinlæringsfællesskabet vil blive bedre af adgang til rige, store dataset, i stedet for kun et par elite-megavirksomheder.
Er der noget andet, du gerne vil dele om Gretel?
Hvis du elsker data, vil du elske Gretel (så jeg elsker åbenbart Gretel!). Let adgang til data har været torne i siden på enhver datavidenskabsmand, jeg har kendt. Hos Gretel tager vi stor stolthed i at have skabt en console og en samling af API’er, der gør oprettelsen af data, der beskytter privatlivet og kan deles så enkelt som muligt. Vi tror dybt på, at data er mere værdifuldt, når det deles.
Tak for det gode interview og for at dele dine indsigter, læsere, der ønsker at lære mere, skal besøge Gretel.ai.






