
Andersonův úhel
ST-NeRF: Kompozice a editace pro video syntézu

 Přidejte Unite.AI mezi své preferované zdroje na Google

Čínský výzkumný konsorcium vyvinulo techniky pro editaci a kompozici v jednom z nejžhavějších oblastí výzkumu syntézy obrazu za poslední rok – Neural Radiance Fields (NeRF). Systém se nazývá ST-NeRF (Spatio-Temporal Coherent Neural Radiance Field).
To, co vypadá jako fyzická kamera, která se pohybuje v obraze níže, je ve skutečnosti pouze uživatel, který “prochází” pohledy na videoobsah, který existuje ve 4D prostoru. Pohled není vázaný na výkon lidí zobrazených ve videu, jejichž pohyby lze sledovat z libovolné části 180stupňového poloměru.
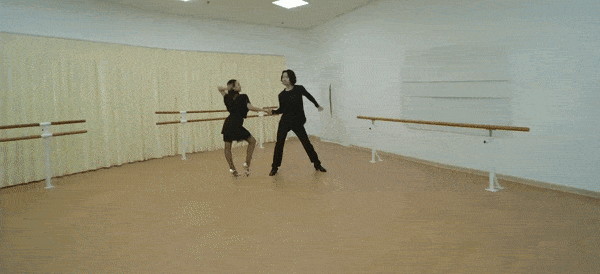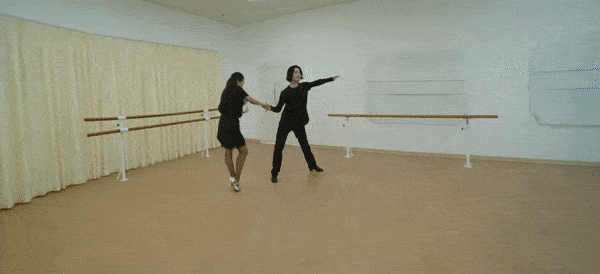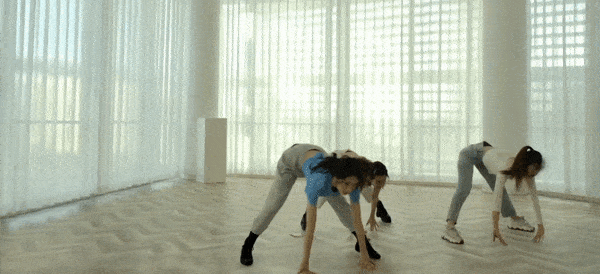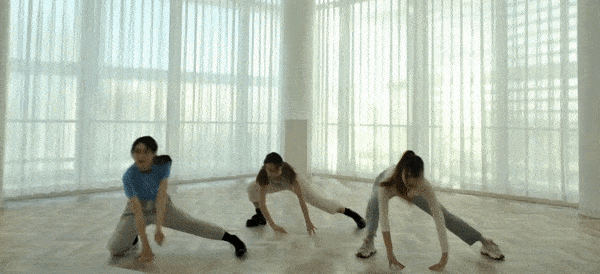
Každá část videa je samostatně zachyceným prvkem, který je složen do soudržné scény, která lze dynamicky prozkoumat.
Tyto části lze volně duplikovat ve scéně nebo měnit velikost:
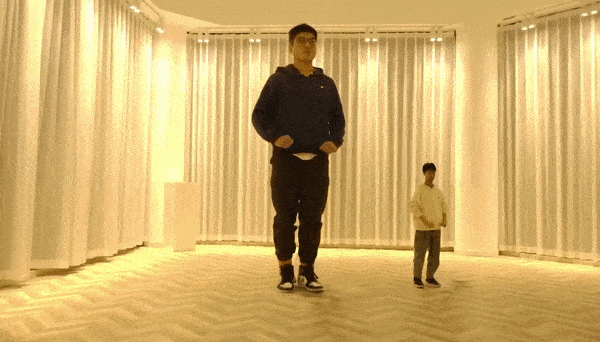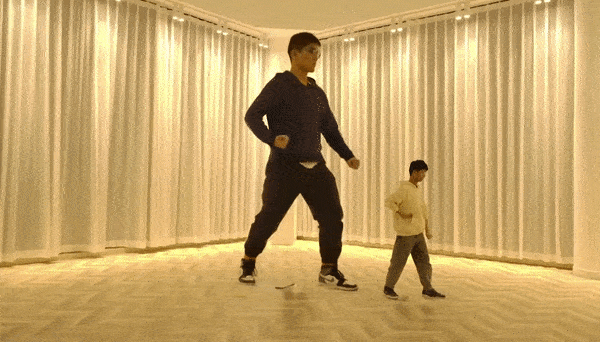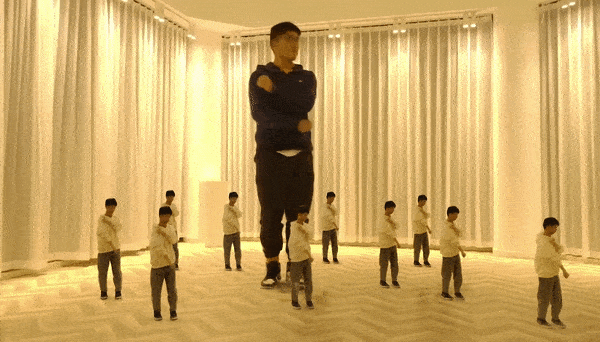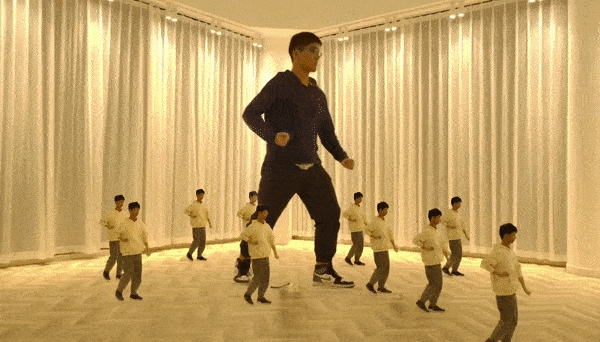
Kromě toho lze snadno upravit temporální chování každé části, zpomalit, spustit pozpátku nebo manipulovat jí mnoha způsoby, což otevírá cestu k architektuře filtrů a extrémně vysoké úrovni interpretability.
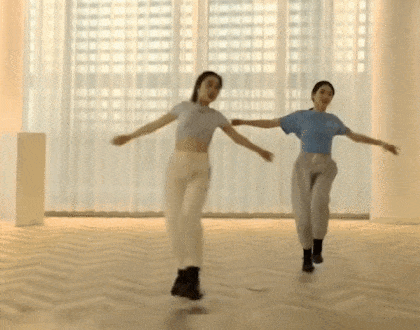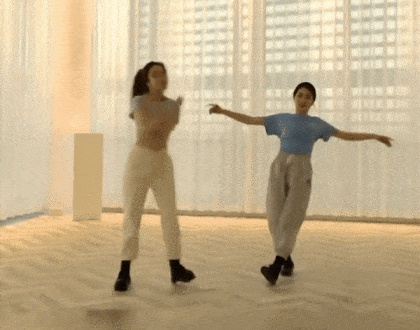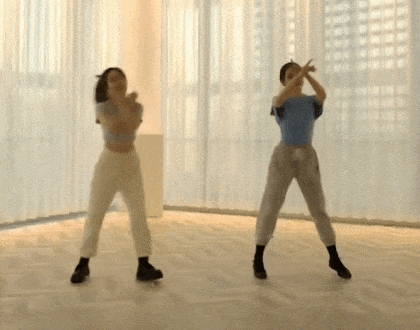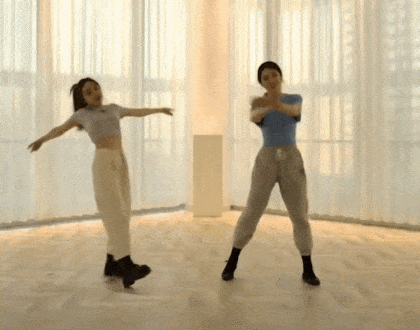
Dvě samostatné NeRF části běží na různých rychlostech ve stejné scéně. Zdroj: https://www.youtube.com/watch?v=Wp4HfOwFGP4

Neexistuje žádná potřeba rotoskopovat výkony nebo prostředí, nebo aby herci prováděli své pohyby slepě a mimo kontext zamýšlené scény. Místo toho je záběr zachycen přirozeně pomocí pole 16 video kamer, které pokrývají 180 stupňů:


Tři prvky zobrazené výše, dvě osoby a prostředí, jsou samostatné a jsou ohraničeny pouze pro ilustrativní účely. Každý z nich lze vyměnit a vložit do scény v jakémkoli bodě jejich individuálního časového rámce.
ST-NeRF je inovací ve výzkumu Neural Radiance Fields (NeRF), frameworku pro strojové učení, který umožňuje syntetizovat multiple pohledy do navigovatelného virtuálního prostoru pomocí rozsáhlého tréninku (i když je také možné použít jeden pohled).

Neural Radiance Fields fungují tak, že shromažďují multiple pohledy do jednoho soudržného a navigovatelného 3D prostoru, přičemž mezery mezi pokrytím jsou odhadnuty a renderovány neuronovou sítí. Pokud se místo statických obrazů používají videa, jsou často vyžadovány značné renderovací zdroje. Zdroj: https://www.matthewtancik.com/nerf
Zájem o NeRF se stal intenzivním za posledních devět měsíců a seznam odvozených nebo průzkumných prací NeRF, který je udržován na Redditu, aktuálně obsahuje šedesát projektů.

Pouze několik z mnoha odvětví původní NeRF práce. Zdroj: https://crossminds.ai/graphlist/nerf-neural-radiance-fields-ai-research-graph-60708936c8663c4cfa875fc2/
Dostupné trénování
Článek je spoluprací mezi výzkumníky na Šanghajské technické univerzitě a DGene Digital Technology a byl přijat s určitým nadšením na Open Review.
ST-NeRF nabízí několik inovací oproti předchozím iniciativám v oblasti ML-derived navigovatelných video prostorů. Nejméně z nich je, že dosahuje vysoké úrovně realismu s pouhými 16 kamerami. I když Facebookův DyNeRF používá pouze o dvě kamery více, nabízí mnohem více omezený navigovatelný oblouk.
Příklad Facebookova DyNeRF prostředí, s mnohem více omezeným pohybem a více kamerami na čtvereční stopu potřebnými k rekonstrukci scény. Zdroj: https://neural-3d-video.github.io
Kromě toho, že postrádá schopnost editovat a komponovat jednotlivé části, je DyNeRF také zvláště drahý z hlediska výpočetních zdrojů. Naopak, čínští výzkumníci uvádějí, že náklady na trénink jejich dat se pohybují kolem 900-3 000 dolarů, ve srovnání s 30 000 dolarů za špičkový model video generace DVDGAN a intenzivní systémy, jako je DyNeRF.
Recenzenti také poznamenali, že ST-NeRF představuje významnou inovaci v oddělení procesu učení pohybu od procesu syntézy obrazu. Toto oddělení je to, co umožňuje editaci a kompozici, zatímco předchozí přístupy byly restriktivní a lineární.
Ačkoli 16 kamer je velmi omezené pole pro takovou plnou polovinu pohledu, výzkumníci doufají, že sníží toto číslo dále v pozdější práci pomocí proxy předem naskenovaných statických pozadí a více datově řízených přístupů k modelování scény. Doufají také, že budou moci začlenit schopnosti re-osvětlení, nedávnou inovaci ve výzkumu NeRF.
Vyřešení limitací ST-NeRF
V kontextu akademických CS prací, které mají tendenci zničit skutečnou použitelnost nového systému v odhozeném závěrečném odstavci, jsou i limitace, které výzkumníci uznávají pro ST-NeRF, neobvyklé.
Pozorují, že systém目前 nemůže individuovat a samostatně vykreslit konkrétní objekty ve scéně, protože lidé ve snímku jsou segmentováni do jednotlivých entit pomocí systému navrženého pro rozpoznávání lidí a ne objektů – problém, který se zdá snadno řešitelný pomocí YOLO a podobných rámců, s tvrdou prací na extrakci lidského videa již provedenou.
Ačkoli výzkumníci poznamenali, že目前 není možné generovat zpomalené pohyby, zdá se, že nic nebrání implementaci tohoto pomocí existujících inovací v interpolaci rámců, jako je DAIN a RIFE.
Stejně jako u všech implementací NeRF a v mnoha dalších oblastech počítačového vidění, ST-NeRF může selhat v případech závažného zakrytí, kde je předmět dočasně zakryt jinou osobou nebo objektem, a může být obtížné jej kontinuálně sledovat nebo přesně znovu získat. Jako jinde, tato obtíž může muset čekat na řešení v horní části. Mezitím výzkumníci uznávají, že je nutná manuální intervence v těchto zakrytých rámcích.
Nakonec výzkumníci pozorují, že postupy pro segmentaci lidí目前 spoléhají na barevné rozdíly, které by mohly vést k neúmyslnému spojení dvou lidí do jednoho segmentačního bloku – kámen úrazu, který není omezen na ST-NeRF, ale je intrinsic k knihovně, kterou se používá, a který by mohl být perhaps vyřešen pomocí optického toku a dalších vznikajících technik.
Poprvé zveřejněno 7. května 2021.


