
هندسة المحفزات
فهم التعديل الدقيق للنماذج اللغوية الكبيرة: تخصيص النماذج اللغوية الكبيرة لتلبية متطلباتك الفريدة

 أضف Unite.AI إلى مصادرك المفضلة على Google

نحن نقف في سبتمبر 2023 ، ولا تزال مناظر النماذج اللغوية الكبيرة تشهد صعود نماذج مثل Alpaca و Falcon و Llama 2 و GPT-4 والعديد من النماذج الأخرى.
الجانب المهم من استغلال إمكانيات هذه النماذج اللغوية الكبيرة يكمن في عملية التعديل الدقيق ، وهي استراتيجية تسمح بتخصيص النماذج المدرّبة مسبقًا لتلبية مهام محددة بدقة. من خلال هذه العملية ، يمكن لهذه النماذج أن تتوافق بشكل حقيقي مع المتطلبات الفردية ، مما يوفر حلولًا مبتكرة ومخصصة لاحتياجات فريدة.

ومع ذلك ، من المهم ملاحظة أن ليس جميع طرق التعديل الدقيق متساوية. على سبيل المثال ، الوصول إلى قدرات التعديل الدقيق ل GPT-4 يأتي بسعر متميز ، يتطلب اشتراكًا مدفوعًا أكثر تكلفة مقارنة بالخيارات الأخرى المتاحة في السوق. من ناحية أخرى ، فإن المجال المفتوح يزخر ببدائل توفر مسارًا أكثر سهولة لاستخدام قوة النماذج اللغوية الكبيرة. هذه الخيارات المفتوحة تحقق الديمقراطية في الوصول إلى التكنولوجيا المتقدمة ، مما يعزز الابتكار والشمولية في مشهد الذكاء الاصطناعي السريع التطور.

لماذا التعديل الدقيق للنماذج اللغوية الكبيرة مهم؟
تعديل النماذج اللغوية الكبيرة أكثر من مجرد تحسين تقني ، إنه جانب حاسم من تطوير نموذج النماذج اللغوية الكبيرة الذي يسمح بتطبيق أكثر تحديدًا ودقة في مهام مختلفة. تعديل النماذج المدرّبة مسبقًا لتحسين أدائها في مهام محددة ، مما يضمن تطبيقًا أكثر تركيزًا. إنه يظهر القدرة الرائعة للنماذج اللغوية الكبيرة على التكيف مع بيانات جديدة ، مما يُظهر مرونة حيوية في الاهتمام المتزايد بتطبيقات الذكاء الاصطناعي.
تعديل النماذج اللغوية الكبيرة يفتح الكثير من الفرص ، مما يسمح لها بالتفوق في مهام محددة تتراوح من تحليل المشاعر إلى مراجعات الأدبيات الطبية. من خلال توجيه النموذج الأساسي إلى حالة استخدام محددة ، نفتح إمكانيات جديدة ، مما يعزز كفاءة النموذج ودقته. بالإضافة إلى ذلك ، يسهل استغلال الموارد بشكل أكثر اقتصادية ، حيث يتطلب التعديل الدقيق قوة حسابية أقل مقارنة بتدريب نموذج من الصفر.
نحن نناقش في هذا الدليل دقائق التعديل الدقيق للنماذج اللغوية الكبيرة ، مما يوفر لنا نظرة شاملة تستند إلى أحدث التطورات وأفضل الممارسات في هذا المجال.
تعديل النماذج اللغوية الكبيرة بالتعليمات
مرحلة التعديل الدقيق في دورة الذكاء الاصطناعي التوليدي، كما هو موضح في الشكل أدناه ، يتميز بدمج مدخلات التعليمات ومخرجاتها ، جنبًا إلى جنب مع أمثلة على الاستدلال خطوة بخطوة. هذا النهج يسمح للنموذج بإنشاء استجابات ليست ذات صلة فحسب ولكن أيضًا متوافقة بدقة مع التعليمات المحددة التي يتم إدخالها إليه. خلال هذه المرحلة ، يتم تعديل النماذج المدرّبة مسبقًا لحل مهام ومواقف مختلفة ، باستخدام مجموعات بيانات مخصصة لتحسين وظائفها.

دورة الذكاء الاصطناعي التوليدي – تعديل دقيق
تعديل النماذج اللغوية الكبيرة لمهام فردية
يعمل تعديل النماذج اللغوية الكبيرة لمهام فردية على تحسين خبرة النموذج في مهمة محددة ، مثل التلخيص. هذا النهج مفيد بشكل خاص في تحسين سير العمل التي تشمل وثائق كبيرة أو سلاسل محادثة ، بما في ذلك الوثائق القانونية وطلبات دعم العملاء. بشكل ملحوظ ، يمكن تحقيق تحسن كبير في الأداء مع مجموعة صغيرة من الأمثلة ، تتراوح من 500 إلى 1000 ، على عكس مليارات الرموز المستخدمة في مرحلة التدريب المسبق.

تجسيد تعديل النماذج اللغوية الكبيرة لمهام فردية
أساسيات تعديل النماذج اللغوية الكبيرة: هيكل الترانسفورمر وما بعده
تبدأ رحلة فهم تعديل النماذج اللغوية الكبيرة بفهم العناصر الأساسية التي تشكل هذه النماذج. في قلب هذه النماذج تقع بنية الترانسفورمر ، وهو شبكة عصبونية تعتمد على آليات الانتباه الذاتي لتحديد سياق الكلمات بدلاً من موضعها في الجملة. هذا النهج المبتكر يسمح بفهم أعمق للعلاقات البعيدة بين الرموز في المدخلات.
عندما نناقش تفاصيل الترانسفورمر ، نجد عملية متعددة المراحل تبدأ بالكودر. هذه المرحلة الأولى تتضمن تحويل المدخلات إلى رموز وإنشاء متجهات التضمين التي تمثل المدخلات وموضعها في الجملة. المراحل اللاحقة تتضمن سلسلة من الحسابات باستخدام مصفوفات تسمى الاستعلام والقيمة والمفتاح ، مما يؤدي إلى حسابات الانتباه الذاتي التي تحدد التركيز على أجزاء مختلفة من الجملة والرموز المختلفة.

هيكل الترانسفورمر
تعديل النماذج اللغوية الكبيرة يعتبر مرحلة حاسمة في تطوير النماذج ، وهي عملية تتضمن إجراء تعديلات دقيقة لتحقيق مخرجات أكثر رغبة. هذه المرحلة ، على الرغم من أهميتها ، تواجه تحديات ، بما في ذلك المتطلبات الحسابية والتخزينية للتعامل مع عدد كبير من المعاملات. تقنيات تعديل النماذج اللغوية الكبيرة مثل PEFT توفر أساليب لخفض عدد المعاملات التي يتم تعديلها ، مما يسهل عملية التدريب.
التدريب المسبق للنماذج اللغوية الكبيرة: إنشاء قاعدة قوية
في المراحل الأولى من تطوير النماذج اللغوية الكبيرة ، يأخذ التدريب المسبق مركز الصدارة ، باستخدام الترانسفورمر ذي العدد الكبير من المعاملات كبنية أساسية. هذه العملية تتضمن نمذجة اللغة الطبيعية بطرق مختلفة ، مثل النمذجة ثنائية الاتجاه أو الانحدار الذاتي أو التسلسل إلى التسلسل ، على مجموعات بيانات كبيرة غير خاضعة للإشراف. الهدف هنا هو إنشاء قاعدة يمكن تعديلها لاحقًا لمهام محددة من خلال إدخال أهداف محددة للمهمة.

التدريب المسبق ، تعديل دقيق
اتجاه ملحوظ في هذا المجال هو الزيادة الحتمية في حجم النماذج اللغوية الكبيرة المُعدَّلة مسبقًا ، مقاسة بعدد المعاملات. البيانات التجريبية تظهر باستمرار أن النماذج الأكبر مع المزيد من البيانات تقريبًا دائمًا تؤدي أداءً أفضل. على سبيل المثال ، GPT-3 ، مع 175 مليار معامل ، قد حدد معيارًا في توليد لغة طبيعية عالية الجودة وأداء مجموعة واسعة من المهام دون أمثلة في الموجه (zero-shot).
تعديل النماذج اللغوية الكبيرة: طريق التكيف مع النموذج
بعد التدريب المسبق ، تخضع النماذج اللغوية الكبيرة إلى تعديل دقيق لتكيفها مع مهام محددة. على الرغم من الأداء الواعد الذي أظهره التعلم في السياق في النماذج اللغوية الكبيرة المُعدَّلة مسبقًا مثل GPT-3 ، يبقى التعديل الدقيق متفوقًا في إعدادات المهام المحددة. ومع ذلك ، يطرح النهج الشائع لتعديل جميع المعاملات تحديات ، بما في ذلك المتطلبات الحسابية والتخزينية ، خاصة عند التعامل مع نماذج كبيرة.
لنماذج اللغة الكبيرة التي تضم أكثر من مليار معامل ، يعتبر إدارة ذاكرة GPU حاسمة. معامل نموذج واحد بدقة 32 بت يتطلب 4 بايت من المساحة ، مما يعني أن هناك حاجة إلى 4 جيجابايت من ذاكرة GPU فقط لتحميل نموذج بمليار معامل. عملية التدريب الفعلي تتطلب المزيد من الذاكرة لتسجيل مكونات مثل حالات المُحسِّن والتدرجات ، مما قد يتطلب ما يصل إلى 80 جيجابايت من ذاكرة GPU لنموذج بهذا الحجم.
للتغلب على قيود ذاكرة GPU ، يتم استخدام التقنيات مثل التكميم، وهو أسلوب تقلل دقة معاملات النموذج ، مما يقلل من متطلبات الذاكرة. على سبيل المثال ، تغيير الدقة من 32 بت إلى 16 بت يمكن أن يقلل من النصف من الذاكرة المطلوبة لكل من تحميل وتدريب النموذج. في وقت لاحق من هذا المقال ، سنتعلم عن QLoRA ، الذي يستخدم مفهوم التكميم للضبط الدقيق.

متطلبات ذاكرة GPU للنماذج اللغوية الكبيرة حسب عدد المعاملات والدقة
استكشاف فئات أساليب PEFT

في عملية تعديل النماذج اللغوية الكبيرة ، من المهم أن يكون لديك إعداد حسابي يمكنه التعامل بفعالية ليس فقط مع أوزان النموذج الكبيرة ، التي تصل الآن إلى أحجام تصل إلى مئات الجيجابايت ، ولكن أيضًا مع عناصر أخرى حاسمة ، بما في ذلك تخصيص الذاكرة لحالات المُحسِّن والتدرجات والتفعيلات الأمامية والذاكرة المؤقتة خلال مراحل مختلفة من إجراء التدريب.
طريقة الإضافة
يمكن أن يضيف هذا النوع من التعديل معاملات أو طبقات إضافية إلى النموذج المدرّب مسبقًا ، مع التركيز على تدريب المعاملات الجديدة فقط. على الرغم من زيادة عدد المعاملات ، تعزز هذه الأساليب كفاءة التدريب من حيث الوقت والذاكرة. طريقة الإضافة تنقسم إلى فئات فرعية:
- المُكيِّفات (Adapters): إضافة شبكات صغيرة كاملة الاتصال بعد الطبقات الفرعية للترانسفورمر ، مع أمثلة ملحوظة مثل AdaMix و KronA و Compactor.
- التحفيزات الناعمة: تعديل جزء من تضمين مدخلات النموذج عن طريق نزول التدرج ، مع أمثلة بارزة مثل IPT و prefix-tuning و WARP.
- أساليب إضافة أخرى: تشمل تقنيات مثل LeTS و AttentionFusion و Ladder-Side Tuning.
طريقة التحديد
تعديل دقيق PEFT يركز على تعديل طبقات محدودة من النموذج بناءً على نوع الطبقة وهيكل النموذج الداخلي. هذه الفئة تشمل أساليب مثل BitFit و LN ، والتي تركز على تعديل عناصر محددة مثل تحيزات النموذج أو صفوف معينة.
طريقة إعادة المعلمة
تستخدم هذه الأساليب تمثيلات منخفضة الرتبة لخفض عدد المعاملات القابلة للتعديل. أشهر هذه الأساليب هو التكيف منخفض الرتبة أو LoRA. هذا الأسلوب يستخدم تحليل مصفوفي منخفض الرتبة لتمثيل تحديث الوزن ، مما يظهر تعديل دقيق فعال في فضاءات منخفضة الرتبة.
1) LoRA (التكيف منخفض الرتبة)
LoRA ظهرت كتقنية PEFT رائدة ، تم تقديمها في ورقة بحثية بواسطة Edward J. Hu وآخرون في عام 2021. يعمل في فئة إعادة المعلمة ، بتجميد الأوزان الأصلية للنموذج ودمج مصفوفات منخفضة الرتبة قابلة للتدريب في كل طبقة من هيكل الترانسفورمر. هذا النهج لا يقلل فقط من عدد المعاملات القابلة للتعديل ، ولكنه يقلل أيضًا من وقت التدريب والموارد الحسابية المطلوبة ، مما يقدم بديلاً أكثر كفاءة لتعديل كامل.
لفهم آليات LoRA ، يجب أن نعود إلى هيكل الترانسفورمر حيث يخضع المدخل إلى عملية تجزئة النص إلى رموز ويتحول إلى متجهات التضمين. هذه المتجهات تنتقل عبر أجزاء الكودر والديكودر من الترانسفورمر ، وتتعامل مع الانتباه الذاتي والشبكات ذات التغذية الأمامية التي تم تدريب أوزانها مسبقًا.
LoRA يستخدم مفهوم تحليل القيمة المفردة (SVD). بشكل أساسي ، يقوم SVD بتفكيك مصفوفة إلى ثلاث مصفوفات منفصلة ، واحدة منها هي مصفوفة قطرية تحتوي على قيم مفردة. هذه القيم المفردة حاسمة لأنها تقيس أهمية الأبعاد المختلفة في المصفوفات ، مع قيم أكبر تشير إلى أهمية أكبر وقيم أصغر تشير إلى أهمية أقل.

تحليل القيمة المفردة (SVD) لمصفوفة م × ن
هذا النهج يسمح LoRA بالحفاظ على الخصائص الأساسية للبيانات مع تقليل الأبعاد ، وبذلك يحسّن عملية التعديل الدقيق.
LoRA يتدخل في هذه العملية ، بتجميد جميع معاملات النموذج الأصلية وإضافة زوج من “مصفوفات التجزئة منخفضة الرتبة” جنبًا إلى جنب مع الأوزان الأصلية. هذه المصفوفات الصغيرة ، المعروفة باسم A و B ، تخضع للتدريب من خلال التعلم الإشرافي.
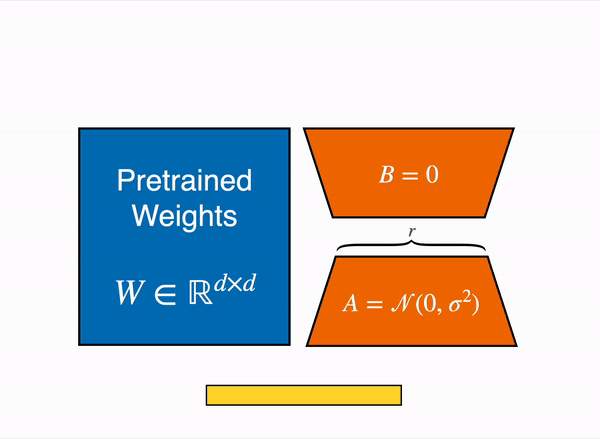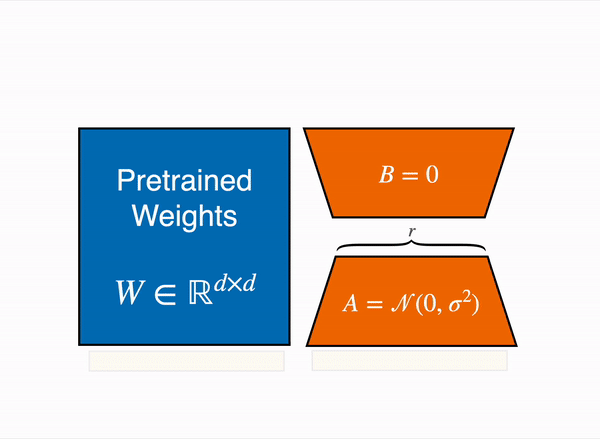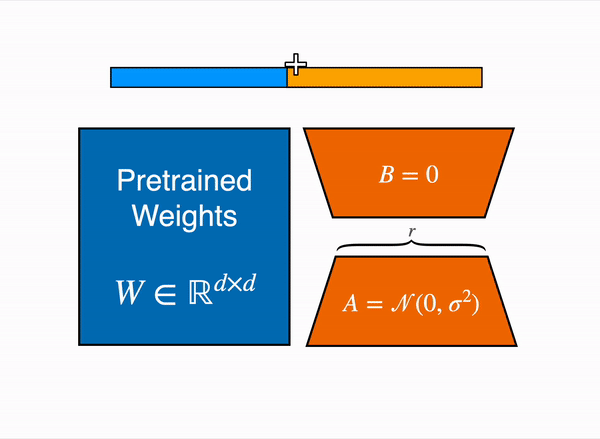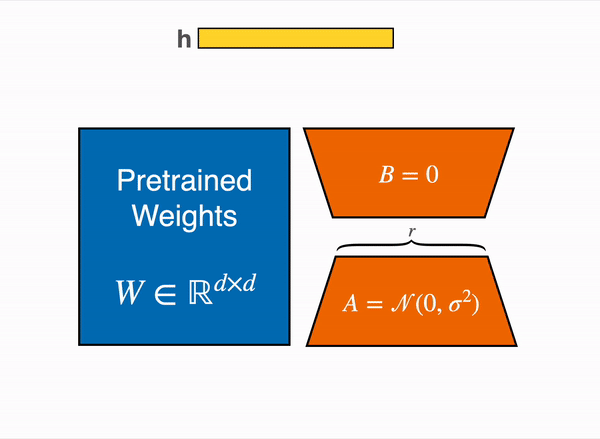
العنصر الحاسم في هذه الاستراتيجية هو معامل يسمى الرتبة (‘r’) ، الذي يحدد حجم مصفوفات منخفضة الرتبة. اختيار دقيق لـ ‘r’ يمكن أن يؤدي إلى نتائج مثيرة للإعجاب ، حتى مع قيمة صغيرة ، مما يخلق مصفوفة منخفضة الرتبة مع عدد أقل من المعاملات للتدريب. تم تنفيذ هذه الاستراتيجية بنجاح باستخدام المكتبات المفتوحة المصدر مثل HuggingFace Transformers ، مما يسهل تعديل LoRA لمجموعة من المهام بفعالية ملحوظة.
2) QLoRA: رفع كفاءة LoRA
بناءً على أساس LoRA ، يقلل QLoRA من متطلبات الذاكرة. تم تقديمه بواسطة Tim Dettmers وآخرون في عام 2023 ، ويجمع بين التكيف منخفض الرتبة مع التكميم، باستخدام تنسيق تكميم من 4 بت يسمى NormalFloat أو nf4. التكميم عملية تنتقل من تمثيل المعلومات الأعلى إلى تمثيل أقل ، ويحافظ هذا النهج على فعالية أساليب التعديل الدقيق 16 بت ، من خلال فك تكميم الأوزان ذات 4 بت إلى 16 بت عند الحاجة أثناء العمليات الحسابية.
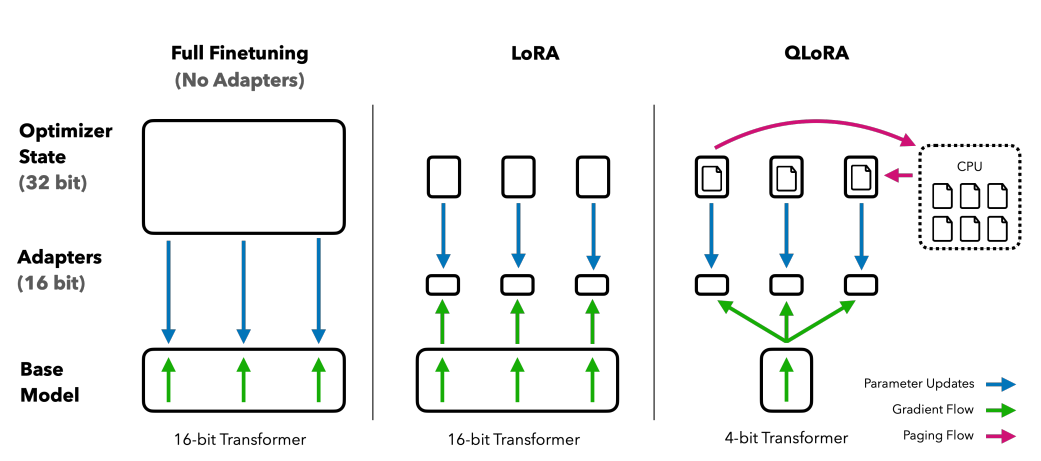
مقارنة أساليب التعديل الدقيق: QLoRA يعزز LoRA بتكميم 4 بت ومُحسِّنات تعتمد على ترحيل الصفحات للتحكم في ذروة الذاكرة
QLoRA يستخدم NumericFloat4 (nf4) ، يستهدف كل طبقة في هيكل الترانسفورمر ، ويقدم مفهوم التكميم المزدوج لتقليل بصمة الذاكرة المطلوبة للتعديل الدقيق. يتم تحقيق ذلك من خلال تكميم الثوابت المكممة بالفعل ، استراتيجية تمنع ذروات الذاكرة الناجمة عن حفظ نقاط التحقق للتدرجات من خلال استخدام مُحسِّنات تعتمد على ترحيل الصفحات وإدارة موحدة للذاكرة.
Guanaco ، وهو مجموعة QLoRA المعدلة ، يحدد معيارًا في حلول الدردشة المفتوحة المصدر. أداؤه ، الذي تم التحقق منه من خلال تقييمات منهجية بشرية وآلية ، يؤكد تفوقه وفعالية في هذا المجال.
النسخة 65B و 33B من Guanaco ، التي تم تعديلها باستخدام نسخة معدلة من مجموعة بيانات OASST1 ، تظهر كمنافسين قويين للنماذج المعروفة مثل ChatGPT وحتى GPT-4.
تعديل النماذج اللغوية الكبيرة باستخدام التعلم بالتعزيز من التغذية الراجعة البشرية
يأتي التعلم بالتعزيز من التغذية الراجعة البشرية (RLHF) عند تعديل النماذج اللغوية الكبيرة المُعدَّلة مسبقًا لتوجيهها بشكل أوثق مع القيم البشرية. تم تقديم هذا المفهوم بواسطة Open AI في عام 2017 ، مما وضع الأساس لتطوير التلخيص المستند إلى الوثائق وتطوير InstructGPT.
في قلب RLHF يوجد نمط التعلم بالتعزيز ، وهو نوع من تقنيات التعلم الآلي حيث يتعلم الوكيل كيفية التصرف في البيئة من خلال أداء إجراءات واستلام مكافآت. إنه حلقة مستمرة من الإجراء و التغذية الراجعة ، حيث يتم تشجيع الوكيل على اتخاذ الخيارات التي ستؤدي إلى أعلى مكافأة.
عند تطبيق هذا على نماذج اللغة ، يكون الوكيل هو النموذج نفسه ، يعمل في البيئة لنافذة سياق معينة ، ويأخذ قرارات بناءً على الحالة ، التي يتم تعريفها بواسطة الرموز الحالية في نافذة السياق. “مساحة الإجراء” تشمل جميع الرموز المحتملة التي يمكن للنموذج اختيارها ، والهدف هو اختيار الرمز الذي يتوافق بشكل أوثق مع التفضيلات البشرية.
عملية RLHF تعتمد بشكل كبير على التغذية الراجعة البشرية ، حيث تستخدم لتدريب نموذج المكافأة. يلعب هذا النموذج دورًا حاسمًا في توجيه النموذج المدرّب مسبقًا خلال عملية التعديل الدقيق ، مما يشجعه على توليد مخرجات أكثر توافقًا مع القيم البشرية. إنه عملية ديناميكية ومتكررة ، حيث يتعلم النموذج من خلال سلسلة من “التجارب” ، وهو مصطلح يستخدم لوصف تسلسل الحالات والإجراءات التي تؤدي إلى مكافأة في سياق توليد اللغة.

إحدى الإمكانيات المذهلة ل RLHF هي قدرته على تعزيز التخصيص في المساعدين الذكاء الاصطناعي ، حيث يمكن توجيههم ليتوافقوا مع تفضيلات المستخدمين الفردية ، سواء كانت حاسة الدعابة أو الروتين اليومي. إنه يفتح طرقًا لإنشاء أنظمة ذكاء اصطناعي لا فقط تقنية ولكن أيضًا ذكية عاطفيًا ، قادرة على فهم و الاستجابة للنواحي الدقيقة في التواصل البشري.
ومع ذلك ، من المهم ملاحظة أن RLHF ليس حلًا خاليًا من الأخطاء. النماذج لا تزال عرضة لتوليد مخرجات غير مرغوب فيها ، مما يعكس البيانات الهائلة التي غالبًا ما تكون غير خاضعة للضبط ومتحيزة التي يتم تدريبها عليها.
الختام
عملية التعديل الدقيق ، وهي خطوة حاسمة في استغلال إمكانيات النماذج اللغوية الكبيرة مثل Alpaca و Falcon و GPT-4 ، أصبحت أكثر دقة وتوجيهًا ، مما يوفر حلولًا مخصصة لمجموعة واسعة من المهام.
لقد رأينا تعديل النماذج اللغوية الكبيرة لمهام فردية ، الذي يركز على تخصص النماذج في أدوار محددة ، وأساليب PEFT بما في ذلك LoRA و QLoRA ، التي تهدف إلى جعل عملية التدريب أكثر كفاءة وأقل تكلفة. هذه التطورات تفتح أبوابًا للوظائف الذكاء الاصطناعي المتقدمة لمجموعة أوسع من المستخدمين.
علاوة على ذلك ، أدخلت Open AI التعلم بالتعزيز من التغذية الراجعة البشرية (RLHF) ، وهو خطوة نحو إنشاء أنظمة ذكاء اصطناعي تتوافق بشكل أوثق مع القيم والتفضيلات البشرية ، مما يضع الأساس لأنظمة ذكاء اصطناعي لا فقط ذكية ولكن أيضًا حساسة لاحتياجات المستخدمين الفردية. يعمل RLHF و PEFT معًا لتعزيز وظائف وكفاءة النماذج اللغوية الكبيرة.
مع الشركات والمؤسسات والأفراد الذين يبحثون عن دمج هذه النماذج اللغوية الكبيرة المعدلة بدقة في عملياتهم ، فإنهم يستقبلون مستقبلًا حيث يكون الذكاء الاصطناعي أكثر من أداة ، إنه شريك يفهم ويتكيف مع السياقات البشرية ، ويقدم حلولًا مبتكرة ومخصصة.


