
زاوية Anderson
نحو بشر افتراضيين بالذكاء الاصطناعي في الزمن الحقيقي باستخدام العرض العصبي للوميغراف

 أضف Unite.AI إلى مصادرك المفضلة على Google
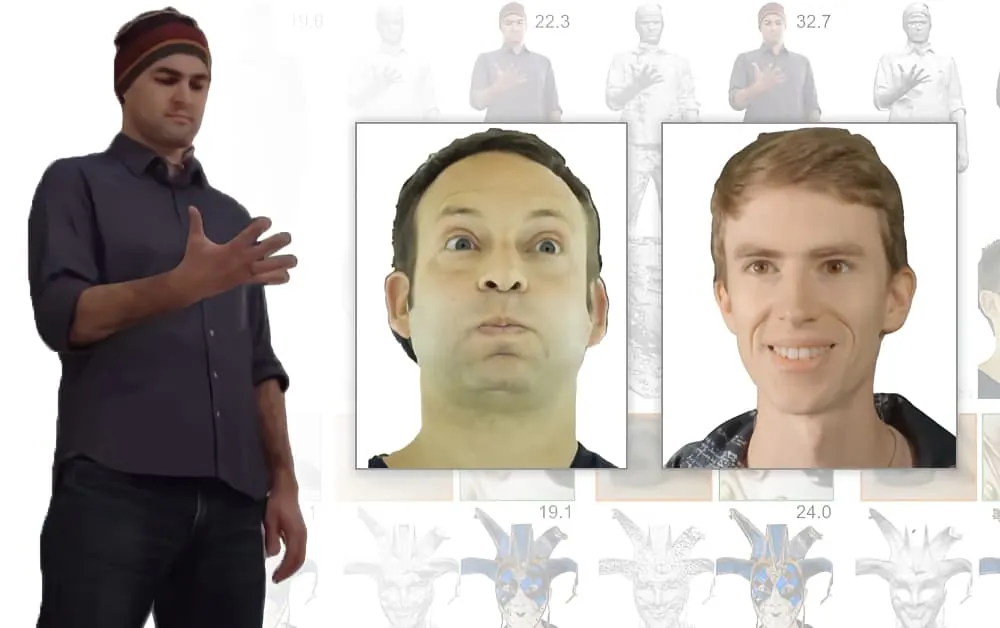
النقاط الرئيسيةيُحسّن Neural Lumigraph Rendering على NeRF بنحو مئتـي ضعف.
عرض المزيد
- يُحسّن Neural Lumigraph Rendering على NeRF بنحو مئتـي ضعف.
- يستخدم NLR شبكات SIREN لدمج مزايا NeRF وIDR من أجل رسومات آنية.
- يفتقر NLR إلى قدرات الإضاءة الديناميكية وإعادة الإضاءة، مما يحصر المخرجات في الإضاءة وقت الالتقاط.
على الرغم من الاهتمام المتزايد حاليًا بحقول الإشعاع العصبية (NeRF)، وهي تقنية قادرة على إنشاء بيئات وأجسام ثلاثية الأبعاد مولّدة بالذكاء الاصطناعي، لا يزال هذا النهج الجديد في تقنية توليد الصور يتطلب وقتًا طويلًا للتدريب، ويفتقر إلى تطبيق يتيح واجهات سريعة الاستجابة في الزمن الحقيقي.
لكن تعاونًا يجمع أسماء بارزة في قطاع الصناعة والأوساط الأكاديمية يطرح مقاربة جديدة لهذا التحدي، المعروف عمومًا باسم توليد المشاهد من زوايا رؤية جديدة (NVS).
تزعم الورقة البحثية المعنونة Neural Lumigraph Rendering أنها تحقق تحسنًا يبلغ نحو رتبتين من حيث المقدار مقارنة بأحدث ما توصلت إليه التقنيات، ما يمثل عدة خطوات نحو عرض الرسومات الحاسوبية في الزمن الحقيقي عبر مسارات عمل قائمة على التعلّم الآلي.

يوفر Neural Lumigraph Rendering (على اليمين) دقة أفضل في معالجة آثار المزج، وتحسينًا في التعامل مع الحجب مقارنة بالأساليب السابقة. المصدر.
على الرغم من أن بيانات الورقة لا تذكر سوى Stanford University وشركة Raxium، المتخصصة في تقنية الشاشات المجسمة (والتي تعمل حاليًا في وضع التخفي)، فإن المساهمين فيها يشملون مهندسًا معماريًا رئيسيًا في مجال التعلم الآلي لدى Google، وعالم حاسوب في Adobe (ADBE )، والمدير التقني التنفيذي في StoryFile (التي تصدرت عناوين الأخبار مؤخرًا بنسخة من William Shatner مولّدة بالذكاء الاصطناعي).
وفي ما يتعلق بالحملة الإعلامية المكثفة الأخيرة حول Shatner، يبدو أن StoryFile تستخدم NLR في عمليتها الجديدة لإنشاء كيانات تفاعلية مولّدة بالذكاء الاصطناعي، تستند إلى سمات أشخاص بعينهم وسيرهم.
تتوقع StoryFile استخدام هذه التقنية في المعارض المتحفية، والسرد التفاعلي عبر الإنترنت، والعروض الهولوغرافية، والواقع المعزز (AR)، وتوثيق التراث؛ كما يبدو أنها تدرس تطبيقات جديدة محتملة لـ NLR في مقابلات التوظيف وتطبيقات المواعدة الافتراضية:

استخدامات مقترحة في مقطع فيديو عبر الإنترنت من StoryFile.
الالتقاط الحجمي لتوليد واجهات ومقاطع فيديو لمشاهد من زوايا رؤية جديدة
يقوم مبدأ الالتقاط الحجمي، كما توضحه مجموعة الأوراق البحثية المتزايدة حول هذا الموضوع، على تصوير عنصر ما بصور ثابتة أو مقاطع فيديو، ثم استخدام التعلّم الآلي لاستكمال زوايا الرؤية التي لم تغطها مجموعة الكاميرات الأصلية.
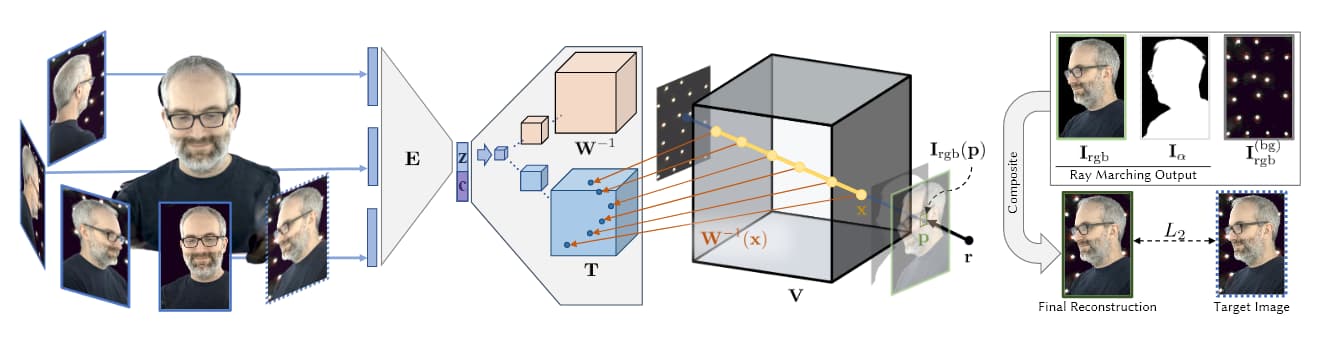
المصدر: https://research.fb.com/wp-content/uploads/2019/06/Neural-Volumes-Learning-Dynamic-Renderable-Volumes-from-Images.pdf
في الصورة أعلاه، المأخوذة من أبحاث Facebook للذكاء الاصطناعي لعام 2019 (انظر أدناه)، نرى المراحل الأربع للالتقاط الحجمي: تلتقط كاميرات متعددة الصور ومقاطع الفيديو؛ وتحسب بنية المُرمِّز/مُفكِّك الترميز (أو بنى أخرى) العلاقات بين زوايا الرؤية وتجمعها؛ وتحسب خوارزميات تتبّع الأشعة وحدات الفوكسل (أو وحدات هندسية مكانية أخرى في إحداثيات XYZ) لكل نقطة في الحيز الحجمي؛ ثم يجري التدريب، في معظم الأوراق البحثية الأحدث، لتوليد كيان متكامل يمكن التلاعب به في الزمن الحقيقي.
إن مرحلة التدريب هذه، التي غالبًا ما تكون طويلة وتتطلب كميات كبيرة من البيانات، هي ما حال حتى الآن دون استخدام توليد المشاهد من زوايا رؤية جديدة في الالتقاط الآني أو سريع الاستجابة.
وبما أن توليد المشاهد من زوايا رؤية جديدة ينشئ خريطة ثلاثية الأبعاد كاملة لحيز حجمي، فمن السهل نسبيًا وصل هذه النقاط بعضها ببعض لتشكيل شبكة تقليدية مولّدة بالحاسوب، ما يتيح التقاط إنسان مولّد بالصور الحاسوبية (أو أي جسم آخر محدود نسبيًا) وتحريكه آنيًا.
تعتمد الأساليب التي تستخدم NeRF على سحب النقاط وخرائط العمق لتوليد القيم الوسيطة بين نقاط الرؤية المتباعدة لأجهزة الالتقاط:
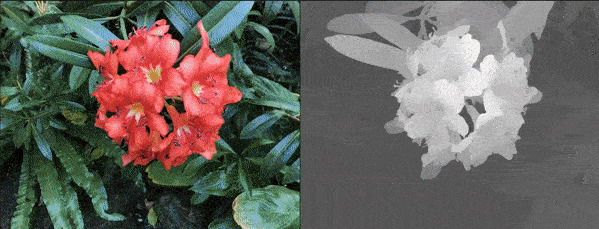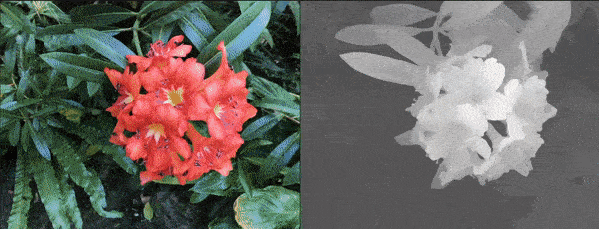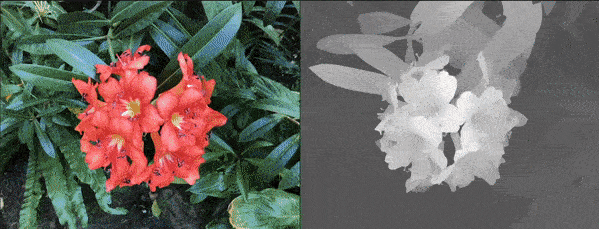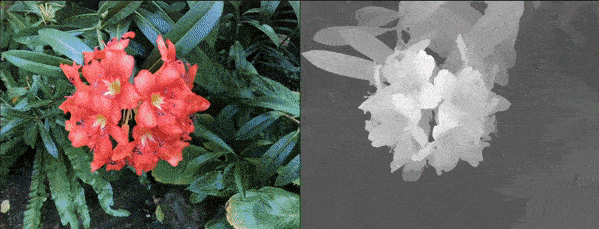
يمكن لـ NeRF توليد العمق الحجمي من خلال حساب خرائط العمق، بدلًا من إنشاء شبكات الرسومات الحاسوبية. المصدر: https://www.youtube.com/watch?v=JuH79E8rdKc
على الرغم من أن NeRF قادر على حساب الشبكات، فإن معظم التطبيقات لا تستخدم هذه الإمكانية لتوليد مشاهد حجمية.
وعلى النقيض من ذلك، يعتمد نهج المُصيّر التفاضلي الضمني (IDR)، الذي نشره معهد وايزمان للعلوم في أكتوبر 2020، على الاستفادة من معلومات الشبكات ثلاثية الأبعاد التي تُنشأ تلقائيًا من مجموعات الالتقاط:
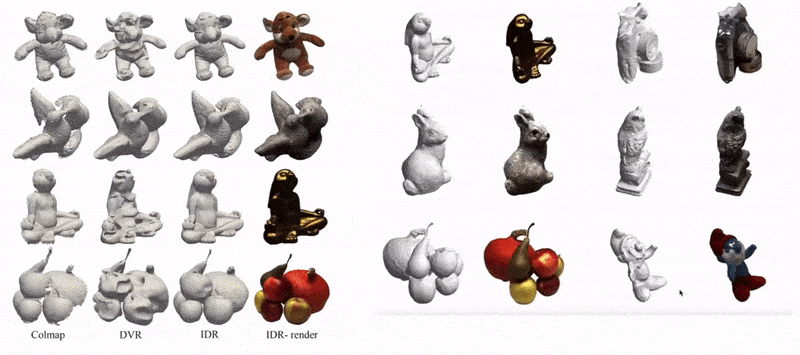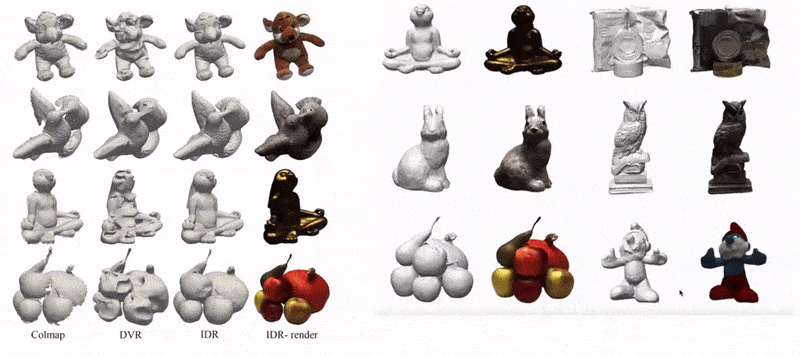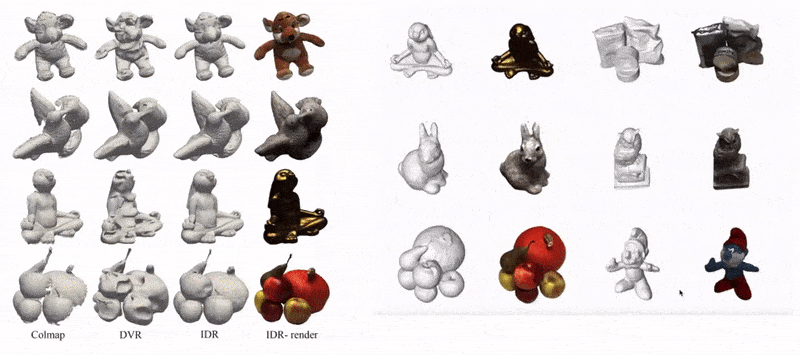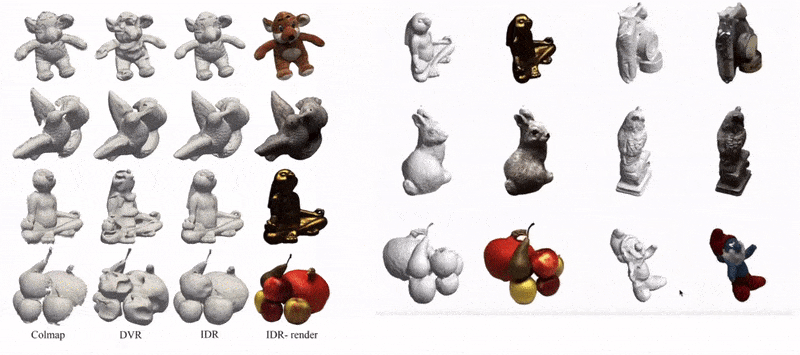
أمثلة على عمليات التقاط IDR التي حُوّلت إلى شبكات تفاعلية للرسومات الحاسوبية. المصدر: https://www.youtube.com/watch?v=C55y7RhJ1fE
بينما يفتقر NeRF إلى قدرة IDR على تقدير الشكل، لا يستطيع IDR مجاراة جودة الصور التي يقدمها NeRF، ويتطلب كلاهما موارد كبيرة للتدريب وتجميع البيانات (مع أن الابتكارات الحديثة في NeRF بدأت بمعالجة ذلك).

منصة كاميرات مخصصة لـ NLR تضم 16 كاميرا GoPro HERO7 و6 كاميرات مركزية من طراز Back-Bone H7PRO. ولأغراض العرض «الآني»، تعمل هذه الكاميرات بمعدل لا يقل عن 60 إطارًا في الثانية. المصدر: https://arxiv.org/pdf/2103.11571.pdf
بدلًا من ذلك، يستخدم Neural Lumigraph Rendering شبكات SIREN (شبكات التمثيل الجيبي) لدمج نقاط قوة كل نهج ضمن إطار عمله، الذي يهدف إلى إنتاج مخرجات قابلة للاستخدام مباشرةً في خطوط معالجة الرسوميات الآنية القائمة.
استُخدمت تطبيقات مماثلة لـ SIREN خلال العام الماضي، وأصبحت الآن استدعاءً شائعًا لواجهة API في دفاتر Colab التي ينشئها الهواة ضمن مجتمعات توليد الصور؛ غير أن ابتكار NLR يكمن في تطبيق شبكات SIREN على الإشراف على الصور متعددة المناظير ثنائية الأبعاد، وهو أمر إشكالي نظرًا إلى أن SIREN ينتج مخرجات مفرطة المواءمة بدلًا من مخرجات قابلة للتعميم.
بعد استخراج شبكة الرسوم الحاسوبية من صور المصفوفة، تُحوّل الشبكة إلى صيغة نقطية باستخدام OpenGL، وتُسقط مواضع رؤوسها على وحدات البكسل المناسبة، ثم يُحسب المزج بين الخرائط المختلفة المساهمة في الصورة.
الشبكة الناتجة أكثر قابلية للتعميم وتمثيلًا من شبكة NeRF (انظر الصورة أدناه)، وتتطلب حسابات أقل، ولا تضيف تفاصيل مفرطة إلى مناطق (مثل بشرة الوجه الناعمة) لا تستفيد منها:

المصدر: https://arxiv.org/pdf/2103.11571.pdf
أما الجانب السلبي، فهو أن NLR لا يتيح حتى الآن الإضاءة الديناميكية أو إعادة الإضاءة، كما تقتصر مخرجاته على خرائط الظلال وغيرها من معطيات الإضاءة التي جُمعت وقت الالتقاط. ويعتزم الباحثون معالجة ذلك في أعمالهم المستقبلية.
ويقرّ البحث أيضًا بأن الأشكال التي يولدها NLR ليست بدقة بعض الأساليب البديلة، مثل اختيار المنظور على مستوى البكسل للتصوير المجسّم متعدد المناظير غير المنظّم، أو أبحاث معهد وايزمان المذكورة سابقًا.
ازدهار توليد الصور الحجمية
تعود فكرة إنشاء كيانات ثلاثية الأبعاد من مجموعة محدودة من الصور باستخدام الشبكات العصبية إلى ما قبل NeRF، إذ نُشرت أبحاث رائدة حولها في عام 2007 أو قبله. وفي عام 2019، نشر قسم أبحاث الذكاء الاصطناعي في Facebook بحثًا تأسيسيًا بعنوان الأحجام العصبية: تعلّم أحجام قابلة للتصيير الديناميكي من الصور، أتاح للمرة الأولى إنشاء واجهات تفاعلية لبشر اصطناعيين مولّدين باستخدام الالتقاط الحجمي القائم على تعلّم الآلة.
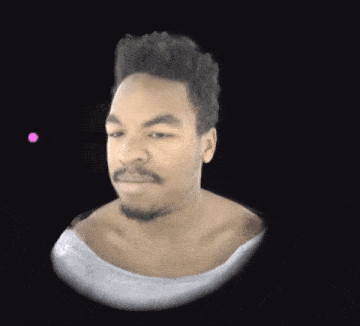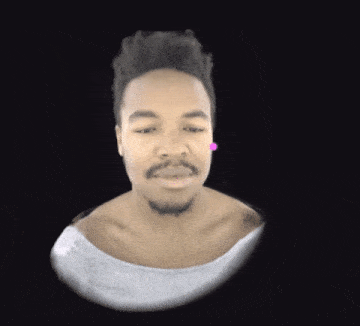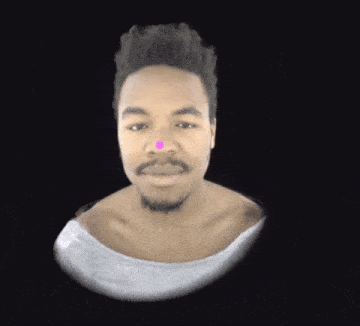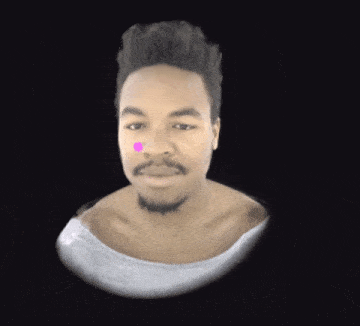
أتاحت أبحاث Facebook لعام 2019 إنشاء واجهة مستخدم تفاعلية لشخص ممثّل حجميًا. المصدر: https://research.fb.com/publications/neural-volumes-learning-dynamic-renderable-volumes-from-images/


