
أساسيات الذكاء الاصطناعي
ما هو الـ NPU؟ شرح وحدات المعالجة العصبية

 أضف Unite.AI إلى مصادرك المفضلة على Google
وحدة المعالجة العصبية (NPU) هي مسرّع متخصص صُمم لتنفيذ عمليات الشبكات العصبية الشائعة بكفاءة. في الهواتف، وأجهزة الكمبيوتر، والمركبات، والكاميرات، والأنظمة المدمجة، يمكنها تشغيل أحمال الذكاء الاصطناعي المدعومة باستخدام طاقة أقل أو تحرير وحدة المعالجة المركزية (CPU) ووحدة معالجة الرسوميات (GPU) لمهام أخرى.
الـ NPU هو مصطلح صناعي واسع وليس بنية موحدة. تعتمد الأداء على المشغلات المدعومة، والصيغ العددية، والذاكرة، والمترجم ووقت التشغيل، والحدود الحرارية، ومدى إمكانية بقاء جزء من التطبيق على المسرّع.
نقاط رئيسية
- تركّز وحدات الـ NPU على عمليات المصفوفات والمتجهات والتنسورات مع إعادة استخدام عالية للبيانات واستهلاك منخفض للطاقة.
- قيمة TOPS القصوى ليست معيارًا لتطبيق كامل وقد تفترض دقة أو فراغية محددة.
- قد يتطلب النموذج تحويلًا، وتكميمًا، وتقسيمًا للرسم البياني، واستخدامًا احتياطيًا للعمليات غير المدعومة.
- قارن بين زمن الاستجابة، ومعدل النقل، واستهلاك الطاقة، والذاكرة، والجودة، والخصوصية، وقابلية النقل على عبء العمل الفعلي.
أدوار الـ CPU والـ GPU والـ NPU
تتفوق وحدات المعالجة المركزية (CPU) في تدفق التحكم العام والتوافق الواسع. توفر وحدات معالجة الرسوميات (GPU) قدرة موازية قابلة للبرمجة ونظامًا إيكولوجيًا برمجيًا كبيرًا. تتخصص وحدات الـ NPU في عمليات التنسور المتكررة وقد تشمل ذاكرة محلية، ومصفوفات الضرب والتجميع، وتدفق بيانات مُحسّن للاستدلال.
تقوم الأنظمة المتنوعة بجدولة الأجزاء المختلفة في الأماكن الأنسب لها. وهذا مهم بالنسبة لـ الذكاء الاصطناعي الطرفي، حيث يمكن أن تكون القدرة المستمرة والاستجابة أكثر أهمية من أقصى معدل نقل لمراكز البيانات.
تجميع النموذج وتنفيذه
يتم تحويل رسم بياني لإطار العمل إلى تمثيل وسيط، ثم تحسينه، وتكميمه حيثما كان مناسبًا، وتجميعه للمشغلات المدعومة. قد يقوم وقت التشغيل بتقسيم الرسم البياني بحيث تُنفّذ الطبقات غير المدعومة على الـ CPU أو الـ GPU.
يمكن أن تُفقد مزايا المسرّع بسبب النقل بين المعالجات. تؤثر الأشكال الثابتة، وتنسيق الذاكرة، والدقة، وتجمّع الدفعات، وإعادة استخدام الذاكرة على الأداء. اختبر الأداة المجمعة لأن جودة نموذج التعلم العميق قد تتغيّر بعد التحويل.
فهم مقاييس TOPS ومزاعم الكفاءة
تقارير TOPS تُظهر تريليونات العمليات في الثانية وفق افتراضات محددة. قد تحسب الشركات الضرب والإضافة بشكل منفصل، أو تستخدم دقة عددية منخفضة البت، أو تفترض الفراغية. الرقم الأعلى لا يضمن زمن استجابة أقل لنموذج معين.
قِس بدء التشغيل البارد والساخن، وزمن الاستجابة لكل استعلام، ومعدل النقل، واستهلاك الطاقة، والذاكرة القصوى، وتثبيط الحرارة، وحجم السياق أو الصورة المدعوم، ونسبة الرسم البياني المُسرّع. استخدم دقة متساوية وإصدارات برمجية مماثلة.
مقايضات الذكاء الاصطناعي على الجهاز
يمكن للتنفيذ المحلي أن يقلل الاعتماد على الشبكة ويحافظ على المدخلات الخام على الجهاز، لكن النماذج التي تم تحميلها، والسجلات، والنسخ الاحتياطية، والاعتماد على السحابة لا يزال يخلق تدفقات بيانات. لا يزال تسليم النماذج بأمان وتحديثات المنصات ضروريين.
يمكن للـ NPU دعم تطبيقات الرؤية، والصوت، واللغة، وأجهزة الاستشعار، بما في ذلك الأحمال المجاورة لـ TinyML. يجب على المطورين تصميم حلول احتياطية سلسة وإبلاغ المستخدم عندما ينتقل المعالجة خارج الجهاز.
معمارية الـ NPU والعمليات المدعومة
تُسرّع الـ NPU عمليات التنسور باستخدام مصفوفات من وحدات الضرب والتجميع، وذاكرة محلية، وجدولة تدفق البيانات، وصيغ عددية متخصصة. إبقاء الأوزان والنشطات بالقرب من وحدة المعالجة يقلل من حركة البيانات المكلفة. تختلف الأجهزة الفعلية في دعم المشغلات، وهيكل الذاكرة، والدقة، والفراغية، والبرمجة، وكيفية مشاركة العمل مع الـ CPU والـ GPU.
غالبًا ما يُعلن عن الأداء القمي في TOPS، لكن TOPS لا يحدد الدقة، أو الاستفادة، أو حدود الذاكرة، أو تغطية المشغلات، أو زمن الاستجابة من البداية إلى النهاية. قد يختلف أداء معالجين يحملان نفس الرقم الرئيسي عند تشغيل نفس النموذج. قِم بعمل اختبار قياسي للنموذج المجمّع، وأحجام دفعات وتسلسلات واقعية، ومعالجة ما قبل التنفيذ، والنقل، ووضع الطاقة.
تكون الـ NPU فعّالة للعبء العصبي المدعوم مثل الرؤية، والصوت، وإزالة الضوضاء، وتأثيرات الخلفية، والنماذج اللغوية المدمجة. قد تُعيد المشغلات غير المدعومة التنفيذ إلى الـ CPU أو الـ GPU، مما يخلق عمليات نقل وزمن استجابة غير متوقع. افحص تقارير المترجم وتتبع وقت التشغيل لتأكيد موضع التنفيذ بدلاً من افتراض أن الرسم البياني بأكمله يستخدم المسرّع.
تحويل النموذج، التكميم، والنشر
عادةً ما ينتقل النشر من إطار التدريب عبر التصدير، وتحسين الرسم البياني، والتكميم، وتجميع البائع، وتكامل وقت التشغيل. الأشكال الثابتة والمشغلات الشائعة هي الأسهل لتسريعها. قد يتطلب تدفق التحكم الديناميكي، والنوى المخصصة، والتنسورات الوسيطة الكبيرة، وأنماط التطبيع أو الانتباه غير المدعومة تغييرات في الرسم البياني أو تنفيذًا هجينًا.
تقلل الصيغ العددية ذات الدقة المنخفضة أو الصحيحة حجم النموذج، وعرض النطاق الترددي، والطاقة، وزمن الاستجابة، لكن يجب أن تمثل بيانات المعايرة المدخلات الحقيقية. قارن بين التكميم بعد التدريب والتكميم المدرك للتدريب عندما تكون الجودة حساسة. قيّم السلوك لكل فئة والحالات الأسوأ لأن الدقة المتوسطة قد تخفي تدهورًا في الحالات النادرة أو ذات الصلة بالسلامة.
تحسّن الاستدلال على الجهاز زمن الاستجابة، والعمل دون اتصال، والخصوصية عن طريق تقليل نقل البيانات، لكن الجهاز لا يزال بحاجة إلى نماذج آمنة، ووصول للبيانات مع مراعاة الأذونات، وآليات تحديث. احمِ ملفات النماذج حيثما كان ذلك مناسبًا، ووقّع التحديثات، وكشف عن الاعتماد على السحابة، وتأكد من أن بيانات القياس لا تعيد إظهار مخاطر الخصوصية التي صُممت بنية الجهاز لتقليلها.
تقييم الأداء ومقايضات مستوى النظام
قِس زمن الاستجابة عند بدء التشغيل البارد والحالة المستقرة، ومعدل النقل، والطاقة لكل استدلال، والذاكرة، والسلوك الحراري، والدقة، وتأثير البطارية. تكشف الاختبارات الطويلة عن التثبيط الذي قد يغفله الاختبار القصير. اشمل معالجة ما قبل وما بعد التنفيذ لأن تغيير الحجم، أو التجزئة، أو فك الترميز، أو نسخ البيانات قد يهيمن على المسرّع السريع بخلاف ذلك.
الجدولة هي مشكلة نظامية. يدير الـ CPU منطق التطبيق، وقد يقوم الـ GPU بالعرض أو تنفيذ الطبقات غير المدعومة، وتنفّذ الـ NPU الرسوم البيانية المتوافقة. تتنافس أحمال الكاميرا، والصوت، والعرض، والذكاء الاصطناعي المتزامنة على عرض النطاق الترددي للذاكرة والطاقة. اختبر سيناريو المستخدم الكامل بدلاً من نموذج معزول في أداة البائع.
تظل قابلية النقل محدودة عبر المترجمات وأوقات التشغيل. فضل تمثيلات النماذج القياسية حيثما تعمل، وعزل الشيفرة الخاصة بالبائع خلف واجهات، وحفظ المخرجات المرجعية، والحفاظ على تغطية اختبار الجهاز. اختر العتاد بناءً على أحمال العمل التي تم التحقق منها، ودعم البرمجيات، وأفق التحديث، وتكلفة النظام الكلية—ليس مجرد مواصفات مسرّع واحد.
مثال عملي: نشر نموذج رؤية على حاسوب محمول مزود بـ NPU
يقوم فريق بتدريب نموذج تجزئة لتأثيرات الخلفية، ويصدّره إلى صيغة تبادل مدعومة، ويستبدل المشغلات غير المدعومة، ويُجري تكميمًا صحيحًا باستخدام كاميرات وإضاءات وألوان بشرة وملابس وخلفيات تمثيلية. يُظهر مُترجم البائع أي العقد تُنفّذ على الـ NPU وأيها تُعتمد كحل احتياطي. يعتبر الفريق أي انتقال احتياطي تكلفة نظامية، لأن نقل التنسورات قد يهيمن على نواة سريعة منفردة.
تقيس الاختبارات المعيارية ما قبل معالجة الكاميرا، وتنفيذ النموذج، والتركيب، والذاكرة، وبدء التشغيل البارد، وزمن الاستجابة المستقر، وثبات الإطارات، والطاقة، وتثبيط الحرارة أثناء مكالمة فيديو حقيقية. تُقارن النتائج مع مسارات الـ CPU والـ GPU بجودة إخراج متساوية. يستخدم التطبيق كشف القدرة وحلًا احتياطيًا مُختبرًا بدلاً من افتراض وجود المسرّع أو دعمه لنفس الرسم البياني بعد تحديث برنامج التشغيل.
تشمل اختبارات الإصدار نماذج الأجهزة، وإصدارات نظام التشغيل وبرامج التشغيل، والأحمال المتزامنة، ووضعيات البطارية، والمدخلات غير الصالحة. تُوقّع حزم النماذج وتُعطى إصداراتها؛ تسجّل بيانات القياس الأداء والأخطاء دون جمع فيديو غير ضروري. يوضح المنتج متى يبقى المعالجة على الجهاز ومتى تُستَخدم ميزات السحابة. تكسب الـ NPU مكانتها من خلال تحسين التجربة الكاملة ضمن قيود واقعية، وليس بتحقيق معيار TOPS أو اختبار نواة معزول.
قائمة التحقق العملية للتنفيذ
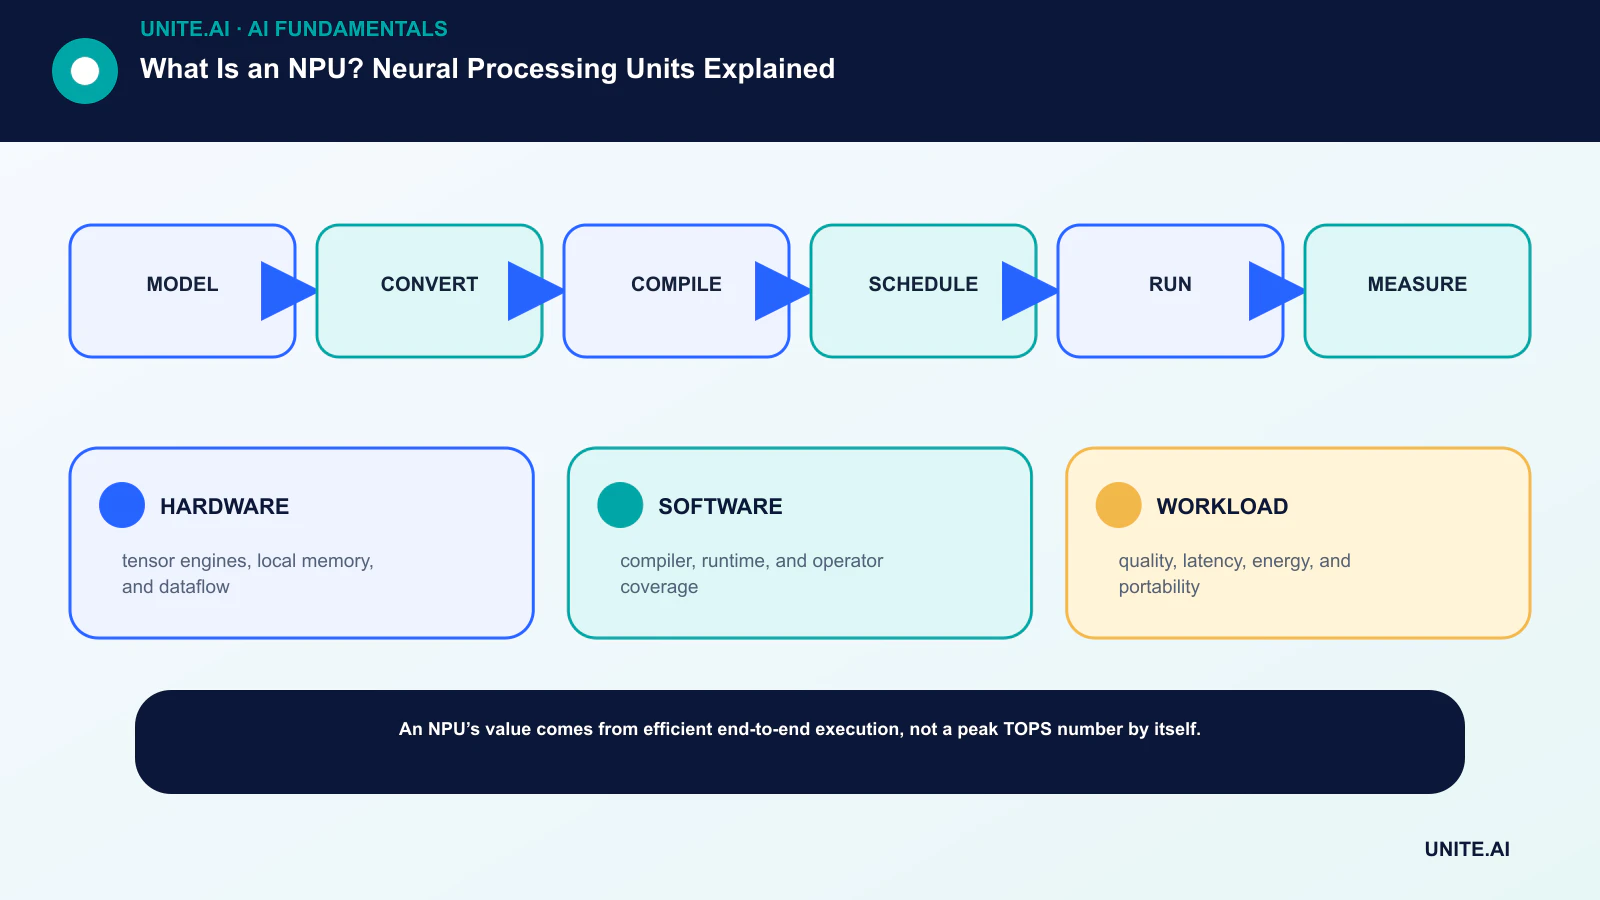
حوّل الفكرة إلى سير عمل محدد وقابل للاختبار: نموذج → تحويل → تجميع → جدولة → تشغيل → قياس. عيّن مالكًا مسؤولًا، وثّق البيانات والاعتمادات، وضع أساسًا بسيطًا، حدد معايير القبول والإيقاف، اختبر حالات الفشل التمثيلية، وحدد المراقبة، والعودة إلى الحالة السابقة، والمراجعة قبل توسيع النطاق. سجّل الإصدارات والافتراضات حتى يتمكن فريق آخر من إعادة إنتاج النتيجة وفهم ما تم تغييره.
قبل الإطلاق، أجرِ مراجعة جاهزية موثقة مع الأشخاص الذين يبنون النظام، ويشغلونه، ويؤمنونه، ويتأثرون به. اختبر الحالات العادية، وظروف الحدود، وفشل الاعتمادات، وسوء الاستخدام؛ احفظ الأدلة والمخاطر غير المحلولة. حدّد من يمكنه الموافقة على الإصدار، وتغيير عتبة، وتجاوز مخرجات، أو إيقاف العملية. أعد النظر في القرار بعد وصول بيانات العالم الحقيقي، لأن نجاح تجريبي تقني لا يضمن أداءً موثوقًا على نطاق أوسع.
- الأجهزة: محركات التنسور، والذاكرة المحلية، وتدفق البيانات.
- البرمجيات: المترجم، ووقت التشغيل، وتغطية المشغلات.
- عبء العمل: الجودة، وزمن الاستجابة، والطاقة، وقابلية النقل.
الأسئلة المتكررة
هل الـ NPU أسرع من الـ GPU؟
يعتمد ذلك على النموذج، والدقة، ودعم المشغلات، وحجم الدفعة، وحدود الطاقة، والبرمجيات. قد تكون الـ NPU أكثر كفاءة لحمولة عمل مدعومة على الجهاز بينما يكون الـ GPU أسرع أو أكثر مرونة في أماكن أخرى.
هل تحافظ الـ NPU على خصوصية جميع بيانات الذكاء الاصطناعي؟
لا. تتيح المعالجة المحلية، لكن قد يرسل التطبيق البيانات أو المخرجات إلى خدمات السحابة. تعتمد الخصوصية على بنية النظام الكاملة والسياسة المتبعة.
المراجع الأساسية












