
نماذج ومنصات الذكاء الاصطناعي
تطور الذكاء الاصطناعي متعدد الوسائط مع اكتساب ChatGPT قدرات بصرية عبر GPT-4V

 أضف Unite.AI إلى مصادرك المفضلة على Google

النقاط الرئيسيةأضافت OpenAI خاصية تحليل الصور إلى ChatGPT عبر GPT-4V، مما وسع نطاق الذكاء الاصطناعي…
عرض المزيد
- أضافت OpenAI خاصية تحليل الصور إلى ChatGPT عبر GPT-4V، مما وسع نطاق الذكاء الاصطناعي ليتجاوز النصوص.
- يظهر GPT-4V إمكانات واعدة في المهام التقنية لكنه يعاني من عيوب حرجة في الاستخدام الطبي.
- النماذج متعددة الوسائط مثل Med-PaLM M تُحرز تقدماً في مجالات متخصصة كالرعاية الصحية.
في الجهود المستمرة لجعل الذكاء الاصطناعي أكثر تشابهًا مع البشر، دفعت نماذج GPT من OpenAI باستمرار الحدود. يمكن لـ GPT-4 الآن قبول مدخلات من النص والصور.
تعدد الوسائط في الذكاء الاصطناعي التوليدي تشير إلى قدرة النموذج على إنتاج مخرجات متنوعة مثل النص أو الصور أو الصوت بناءً على المدخل. يتم تدريب هذه النماذج على بيانات محددة لتعلم الأنماط الأساسية لتوليد بيانات جديدة مشابهة، مما يثرى تطبيقات الذكاء الاصطناعي.
الخطوات الحديثة في الذكاء الاصطناعي متعدد الوسائط
خطوة ملحوظة مؤخرًا في هذا المجال هي دمج DALL-E 3 في ChatGPT، وهو تحسين كبير في تقنية النص إلى الصورة من OpenAI. يسمح هذا الدمج بالتفاعل الأسهل حيث يساعد ChatGPT في صياغة تعليمات دقيقة ل DALL-E 3، مما يحوّل أفكار المستخدم إلى فن مولّد بواسطة الذكاء الاصطناعي بشكل واضح.
يمكنك الاطلاع على المزيد حول DALL-E 3 ودمجها مع ChatGPT هنا. هذا التعاون لا يظهر فقط التقدم في الذكاء الاصطناعي متعدد الوسائط، بل يجعل إنشاء فن الذكاء الاصطناعي أمرًا سهلًا للمستخدمين.

من ناحية أخرى، قدمت Google Health Med-PaLM M في يونيو من هذا العام. وهو نموذج توليدي متعدد الوسائط ماهر في ترميز وتفسير بيانات بيولوجية متنوعة. تم تحقيق ذلك من خلال الضبط الدقيق لنموذج PaLM-E، نموذج لغة، للاستجابة للمجالات الطبية باستخدام معيار مفتوح المصدر، MultiMedBench. يتكون هذا المعيار من أكثر من مليون عينة عبر 7 أنواع بيانات بيولوجية و 14 مهمة مثل الإجابة على الأسئلة الطبية وتوليد تقارير الأشعة.
تعتمد الصناعات المختلفة أدوات الذكاء الاصطناعي متعددة الوسائط المبتكرة لتعزيز التوسع التجاري، وتبسيط العمليات، وتعزيز تفاعل العملاء. يساهم تقدم القدرات الصوتية والفيديوية والنصية في دفع نمو الذكاء الاصطناعي متعدد الوسائط.
تسعى الشركات إلى تطبيقات الذكاء الاصطناعي متعدد الوسائط القادرة على إعادة هيكلة نماذج الأعمال والعمليات، مما يفتح مجالات نمو عبر نظام الذكاء الاصطناعي التوليدي، من أدوات البيانات إلى التطبيقات الناشئة.
بعد إطلاق GPT-4 في مارس، لاحظ بعض المستخدمين انخفاضًا في جودة الاستجابة بمرور الوقت، وهو موضوع أشار إليه المطورون البارزون ومناقشات منتدى OpenAI. في البداية، تم رفضه من قبل OpenAI، لكن ظهرت لاحقًا مناقشات حول دراسة أفادت نسختها الأولى، المنشورة في يوليو 2023، بأن الدقة في مهمة محددة للتعرف على الأعداد الأولية انخفضت من 97.6% في مارس إلى 2.4% في يونيو. وتخص هذه النسب ذلك الاختبار، لا الدقة العامة لـGPT-4.

ChatGPT (الأزرق) والذكاء الاصطناعي (الأحمر) اتجاهات البحث في Google
يعود الاهتمام حول OpenAI ChatGPT الآن. يأتي الآن مع ميزة الرؤية GPT-4V، مما يسمح للمستخدمين بتحليل الصور المعطاة لهم. هذه هي الميزة الجديدة التي تم فتحها للمستخدمين.
يُعتبر إضافة تحليل الصور إلى نماذج اللغة الكبيرة مثل GPT-4 خطوة كبيرة إلى الأمام في أبحاث وتنمية الذكاء الاصطناعي. يفتح هذا النوع من نماذج اللغة متعددة الوسائط إمكانيات جديدة، حيث يأخذ نماذج اللغة إلى ما وراء النص لتقديم واجهات جديدة وحل مهام جديدة، مما يخلق تجارب جديدة للمستخدمين.
تم الانتهاء من تدريب GPT-4V في عام 2022، مع إطلاق الوصول المبكر في مارس 2023. يتم تشغيل الميزة البصرية في GPT-4V بواسطة تقنية GPT-4. بقيت عملية التدريب كما هي. في البداية، تم تدريب النموذج على توقع الكلمة التالية في النص باستخدام مجموعة بيانات ضخمة من النص والصور من مصادر مختلفة بما في ذلك الإنترنت.
بعد ذلك، تم ضبطه بدقة بمزيد من البيانات، باستخدام طريقة تعلم التعزيز من التغذية المرتدة البشرية (RLHF)، لتوليد مخرجات تفضلها البشر.
ميكانيكا رؤية GPT-4
على الرغم من قدرات لغة الرؤية المذهلة لـ GPT-4، تظل الأساليب الأساسية على السطح.
للتحقيق في هذه الفرضية، تم تقديم نموذج رؤية-لغة جديد، MiniGPT-4، باستخدام نموذج لغة متقدم يسمى Vicuna. يستخدم هذا النموذج مُرمّز بصري مع مكونات مسبقة التدريب للرؤية، ويحاذي الميزات البصرية المرمزة مع نموذج لغة Vicuna من خلال طبقة إسقاط واحدة. تكون هيكلة MiniGPT-4 بسيطة وفعالة، مع التركيز على محاذاة الميزات البصرية واللغة لتحسين القدرات الحوارية البصرية.
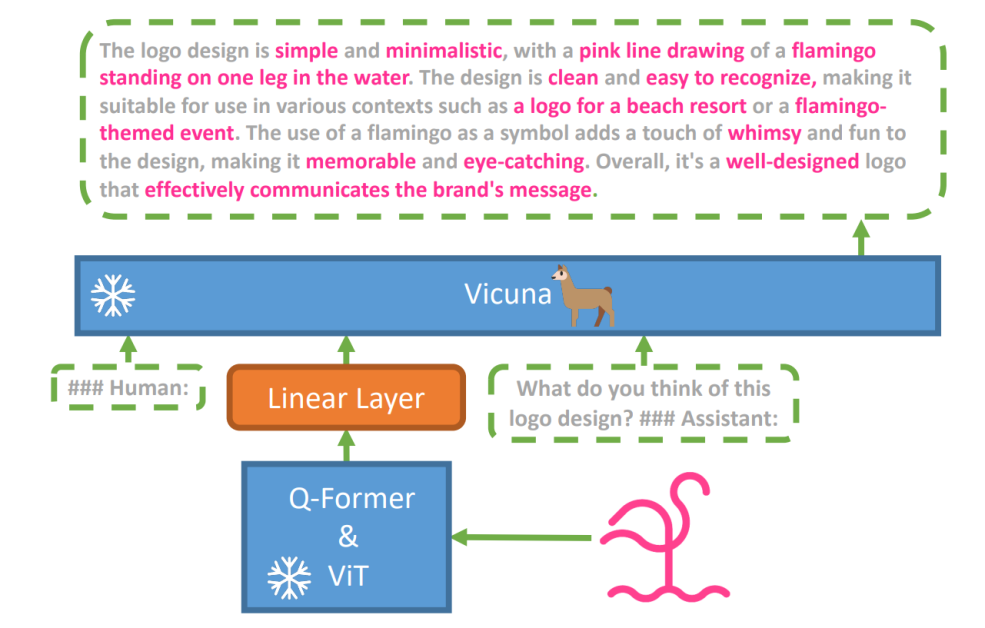
تحتوي هيكلة MiniGPT-4 على مُرمّز بصري مع ViT و Q-Former، وطبقة إسقاط خطية واحدة، ونموذج لغة Vicuna المتقدم.
كما نما الاتجاه نحو نماذج اللغة ذات الانحدار الذاتي في مهام الرؤية-اللغة، مستفيدة من النقل العابر بين اللغة والبيئات متعددة الوسائط لتبادل المعرفة.
يحقق MiniGPT-4 ربط المجالات البصرية واللغة من خلال محاذاة المعلومات البصرية من مُرمّز بصري مسبق التدريب مع نموذج لغة متقدم. يستخدم النموذج Vicuna بوصفه مفكّك ترميز لغويًا ويتبع نهج تدريب من مرحلتين. يتم تدريبه في البداية على مجموعة بيانات كبيرة من أزواج الصور والنص لاكتساب معرفة الرؤية-اللغة، يليه ضبط دقيق على مجموعة بيانات أصغر وأعلى جودة لتعزيز موثوقية وسهولة الإنتاج.
لتحسين طبيعية وسهولة اللغة المولدة في MiniGPT-4، طوّر الباحثون عملية محاذاة من مرحلتين، لمواجهة نقص قواعد البيانات الكافية لمحاذاة الرؤية-اللغة. قاموا بإنشاء مجموعة بيانات متخصصة لهذا الغرض.
في البداية، أنتج النموذج وصفًا مفصلاً للصور المدخلة، مما يحسن التفاصيل باستخدام سؤال حواري محاذي لتنسيق نموذج لغة Vicuna.
سؤال وصف الصورة الأولي:
###Human: <Img><ImageFeature></Img> وصف هذه الصورة بالتفصيل. قدم كل التفاصيل الممكنة. قل كل ما ترى. ###Assistant:
للمعالجة اللاحقة للبيانات، تم تصحيح أي عدم اتساق أو أخطاء في الوصف المولدة باستخدام ChatGPT، يليها التحقق اليدوي لضمان الجودة العالية.
مطالبة الضبط الدقيق في المرحلة الثانية:
###Human: <Img><ImageFeature></Img><Instruction>###Assistant:
تفتح هذه الاستكشافات نافذة لفهم ميكانيكا الذكاء الاصطناعي متعدد الوسائط مثل GPT-4، مما يلقي الضوء على كيفية دمج الوضعية البصرية واللغة بشكل فعال لإنتاج مخرجات متسقة وغنية سياقيًا.
استكشاف رؤية GPT-4
تحديد أصل الصور مع ChatGPT
تُحسّن رؤية GPT-4 قدرة ChatGPT على تحليل الصور وتحديد أصلها الجغرافي. هذه الميزة تنتقل التفاعلات المستخدم إلى مزيج من النص والصورة، مما يصبح أداة مفيدة لأولئك الذين يريدون معرفة المزيد حول الأماكن المختلفة من خلال بيانات الصورة.

سؤال ChatGPT عن المكان الذي التُقطت فيه صورة معلم
مفاهيم الرياضيات المعقدة
تتميز رؤية GPT-4 في استكشاف المفاهيم الرياضية المعقدة من خلال تحليل التعبيرات الرسومية أو المكتوبة باليد. تعمل هذه الميزة كأداة مفيدة للأفراد الذين يبحثون عن حل مشاكل رياضية معقدة، مما يجعل رؤية GPT-4 مساهمة ملحوظة في المجالات التعليمية والاكاديمية.

سؤال ChatGPT عن فهم مفهوم رياضي معقد
تحويل المدخلات المكتوبة باليد إلى رموز LaTeX
تتمتع GPT-4V بقدرة ملحوظة على ترجمة المدخلات المكتوبة باليد إلى رموز LaTeX. تعتبر هذه الميزة نعمة للباحثين والأساتذة والطلاب الذين يحتاجون غالبًا إلى تحويل التعبيرات الرياضية المكتوبة باليد أو المعلومات الفنية الأخرى إلى تنسيق رقمي. يوسع تحويل المكتوب باليد إلى LaTeX أفق ترميز المستندات ويعزز عملية الكتابة الفنية.

قدرة GPT-4V على تحويل المدخلات المكتوبة باليد إلى شيفرة LaTeX
استخراج تفاصيل الجدول
تُظهر GPT-4V مهارة في استخراج التفاصيل من الجداول والاستجابة للأسئلة ذات الصلة، وهو مورد حاسم في تحليل البيانات. يمكن للمستخدمين استخدام GPT-4V لفرز الجداول وجمع المعلومات الرئيسية والاستجابة للأسئلة، مما يجعله أداة قوية لمحللي البيانات والمهنيين الآخرين.

GPT-4V يفهم تفاصيل الجدول ويجيب عن الأسئلة ذات الصلة
فهم الإشارة البصرية
تضيف قدرة GPT-4V الفريدة على فهم الإشارة البصرية بعدًا جديدًا إلى التفاعل المستخدم. من خلال فهم الإشارات البصرية، يمكن لـ GPT-4V الاستجابة للأسئلة بفهم سياقي أعلى.

GPT-4V يُظهر القدرة على فهم الإشارة البصرية
بناء مواقع ويب بسيطة باستخدام الرسم
مُلهمًا بهذا التغريد، حاولت إنشاء نموذج لموقع unite.ai.
على الرغم من أن النتيجة لم تتطابق تمامًا مع رؤيتي الأولية، إليك النتيجة التي حققتها.

واجهة HTML مولّدة باستخدام ChatGPT Vision
قيود GPT-4V وأوجه قصوره
من أجل تحليل GPT-4V، أجرى فريق Open AI تقييمات نوعية وكمية. شملت التقييمات النوعية الاختبارات الداخلية ومراجعات الخبراء الخارجية، بينما قاس التقييمات الكمية رفض النموذج ودقته في مختلف السيناريوهات مثل تحديد المحتوى الضار والتعرف على الديموغرافيا وقلق الخصوصية والتحديد الجغرافي وأمان السيبرانية ومحاولات تجاوز قيود السلامة متعددة الوسائط.
ومع ذلك، النموذج ليس مثاليًا.
تُبرز الورقة قيود GPT-4V، مثل الاستدلالات الخاطئة وإغفال نصوص أو محارف في الصور. قد يهلوس أو يختلق حقائق. على وجه الخصوص، لا يصلح لتحديد المواد الخطرة في الصور، وغالبًا ما يُخلط بينها.
في التصوير الطبي، يمكن أن توفر GPT-4V استجابات غير متسقة وتنقصها الوعي بالممارسات القياسية، مما يؤدي إلى تشخيصات خاطئة محتملة.

أداء غير موثوق به للأغراض الطبية (المصدر)
كما يفشل في فهم دقائق بعض رموز الكراهية ويمكن أن يولد محتوى غير مناسب بناءً على المدخلات البصرية. ينصح OpenAI بعدم استخدام GPT-4V للاستجابات الحاسمة، خاصة في السياقات الطبية أو الحساسة.
الختام

أُنشئت باستخدام Fast Stable Diffusion XL https://huggingface.co/spaces/google/sdxl
يأتي وصول GPT-4 Vision (GPT-4V) مع مجموعة من الإمكانيات الجديدة والتحديات الجديدة. قبل إطلاقه، تم بذل الكثير من الجهد لضمان أن المخاطر، خاصة عند التعامل مع صور الأشخاص، يتم فحصها وتقليلها. من المثير أن نرى كيف قفز GPT-4V إلى الأمام، مما يظهر الكثير من الوعد في مجالات صعبة مثل الطب والعلوم.
الآن، هناك بعض الأسئلة الكبيرة على الطاولة. على سبيل المثال، هل ينبغي أن تكون هذه النماذج قادرة على تحديد الأشخاص المشهورين من الصور؟ وهل ينبغي أن تخمّن جنس الشخص أو عرقه أو مشاعره من صورة؟ ويجب أن يكون هناك تعديلات خاصة لمساعدة الأشخاص المعوقين بصريًا؟ تفتح هذه الأسئلة مجموعة معقدة من القضايا حول الخصوصية والعدالة وكيف يجب أن يلائم الذكاء الاصطناعي حياتنا، وهو أمر يجب أن يكون للجميع رأي فيه.


