
زاوية Anderson
كيف يمكن أن يتطور Stable Diffusion إلى منتج استهلاكي واسع الانتشار

 أضف Unite.AI إلى مصادرك المفضلة على Google
من المفارقات أن Stable Diffusion، إطار توليد الصور الجديد بالذكاء الاصطناعي الذي اجتاح العالم، ليس مستقرًا ولا واسع الانتشار بعد.
تتوزع قدرات النظام الكاملة على عروض متغيرة باستمرار يصنعها عدد قليل من المطورين، الذين يتبادلون بحماس أحدث المعلومات والنظريات في نقاشات متعددة على Discord. ومعظم إجراءات تثبيت الحزم التي ينشئونها أو يعدلونها أبعد ما تكون عن التشغيل المباشر السهل.
بل تتطلب عادة التثبيت عبر سطر الأوامر أو ملفات BAT، باستخدام GIT وConda وPython وMiniconda وغيرها من أطر التطوير المتقدمة. وهذه حزم نادرة لدى المستهلك العادي، حتى إن مزودي مكافحة الفيروسات والبرمجيات الخبيثة كثيرًا ما يصنفون تثبيتها دليلًا على اختراق النظام المضيف.

جزء صغير فقط من الخطوات التي يتطلبها حاليًا التثبيت القياسي لـStable Diffusion. وتحتاج توزيعات كثيرة أيضًا إلى إصدارات محددة من Python قد تتعارض مع الموجودة على جهاز المستخدم. ويمكن تجاوز ذلك بتثبيتات تعتمد على Docker، وإلى حد ما ببيئات Conda.
تمتلئ سلاسل النقاش في مجتمعات Stable Diffusion، سواء المصنفة SFW أو NSFW، بنصائح لتعديل نصوص Python والتثبيتات القياسية لتحسين الوظائف أو معالجة أخطاء الاعتماديات المتكررة والمشكلات الأخرى.
وهذا يترك المستهلك العادي المهتم بإنشاء صور مذهلة من المطالبات النصية تحت رحمة عدد متزايد من واجهات API المدفوعة عبر الويب. ومعظمها يتيح عددًا ضئيلًا من الصور المجانية قبل طلب شراء الرموز.
وفوق ذلك، ترفض هذه الخدمات تقريبًا كلها إنتاج محتوى NSFW، الذي قد يشمل موضوعات عامة غير إباحية مثل الحرب. وهذه القدرة هي ما يميز Stable Diffusion عن خدمة DALL-E 2 الخاضعة للرقابة من OpenAI.
Photoshop خاص بـStable Diffusion
ينبهر الجمهور بالصور الخيالية أو الجريئة أو الغريبة التي تملأ وسم #stablediffusion على Twitter يوميًا، لكنه ينتظر Photoshop خاصًا بـStable Diffusion: تطبيقًا قابلًا للتثبيت على منصات متعددة، يجمع أفضل وظائف بنية Stability.ai وأقواها مع الابتكارات المبدعة لمجتمع مطوري SD. وذلك دون نوافذ سطر أوامر منبثقة، أو إجراءات تثبيت وتحديث غامضة ومتغيرة باستمرار، أو وظائف ناقصة.
أما حاليًا، ففي معظم التثبيتات الأغنى بالوظائف نجد صفحة ويب متفاوتة الصقل بجوار نافذة مستقلة لسطر الأوامر، ويشير عنوانها إلى منفذ localhost.

على غرار تطبيقات التوليد المعتمدة على سطر الأوامر مثل FaceSwap، وDeepFaceLab المعتمد على BAT، يكشف تثبيت prepack لـStable Diffusion عن جذوره في سطر الأوامر. وتُفتح الواجهة عبر منفذ localhost، كما يظهر أعلى الصورة، وتتواصل مع وظائف Stable Diffusion القائمة على سطر الأوامر.
لا شك أن تطبيقًا أسهل استخدامًا في الطريق. وتوجد بالفعل تطبيقات متكاملة قابلة للتنزيل عبر Patreon، مثل GRisk وNMKD، كما في الصورة أدناه. لكن لا أحد منها يجمع بعد كل الوظائف التي توفرها بعض تطبيقات Stable Diffusion الأحدث والأصعب وصولًا.

حزم Stable Diffusion المبكرة المتاحة عبر Patreon، والتي تحولت جزئيًا فقط إلى تطبيقات كاملة. وNMKD أول حزمة تدمج مخرجات سطر الأوامر مباشرة في الواجهة الرسومية.
لننظر كيف يمكن أن يبدو تنفيذ أكثر صقلًا وتكاملًا لهذا المنتج المفتوح المصدر الرائع، وما التحديات التي قد يواجهها.
اعتبارات قانونية لتطبيق تجاري جيد التمويل لـStable Diffusion
عامل NSFW
نُشرت الشفرة المصدرية لـStable Diffusion بموجب ترخيص متساهل جدًا لا يمنع إعادة التنفيذ التجاري والأعمال المشتقة التي تعتمد بكثافة على الشفرة.
إلى جانب العدد المتزايد من الحزم السابقة المتاحة عبر Patreon، والإضافات الكثيرة الجاري تطويرها لـFigma وKrita وPhotoshop وGIMP وBlender وغيرها، لا يوجد سبب عملي يمنع شركة برمجيات جيدة التمويل من إنشاء تطبيق Stable Diffusion أكثر تطورًا وقوة بكثير. ومن منظور السوق، توجد أسباب كافية للاعتقاد بأن عدة مبادرات من هذا النوع وصلت بالفعل إلى مراحل متقدمة.
وتواجه هذه الجهود فورًا معضلة: هل سيتيح التطبيق، مثل معظم واجهات Stable Diffusion عبر الويب، إيقاف مرشح NSFW المدمج، وهو جزء من الشفرة؟
إخفاء مفتاح NSFW
يتضمن ترخيص Stability.ai المفتوح لـStable Diffusion قائمة واسعة التأويل باستخدامات يُحظر توظيف النظام فيها. وقد تشمل المحتوى الإباحي والتزييف العميق. لكن الطريقة الوحيدة لمنعها بفعالية هي تجميع مرشح NSFW في ملف تنفيذي معتم بدل تركه معاملًا في ملف Python، أو فرض مقارنة للمجموع الاختباري لملف Python أو DLL الذي يحتوي على تعليمات NSFW. عندها لا يمكن توليد الصور إذا غيّر المستخدمون الإعداد.
وهذا يترك التطبيق مقيد القدرات على نحو يشبه الوضع الحالي لـDALL-E 2، فيضعف جاذبيته التجارية. كما ستظهر حتمًا نسخ فُك تجميعها وعُدلت من هذه المكونات في مجتمعات التورنت والاختراق، سواء كانت عناصر تشغيل Python الأصلية أو ملفات DLL المجمعة مثل المستخدمة في أدوات Topaz لتحسين الصور بالذكاء الاصطناعي. ويكفي استبدال العناصر المعيقة وإبطال متطلبات المجموع الاختباري لتجاوز القيود.
وفي النهاية قد يكتفي المزود بتكرار تحذير Stability.ai من إساءة الاستخدام، الذي يظهر عند التشغيل الأول لكثير من التوزيعات الحالية.
لكن مطوري البرمجيات المفتوحة المصدر الصغار الذين يستخدمون هذه الإخلاءات غير الرسمية للمسؤولية لديهم ما يخسرونه أقل بكثير من شركة استثمرت وقتًا ومالًا كبيرين لجعل Stable Diffusion كامل الوظائف وسهل الوصول. وهذا يستدعي دراسة أعمق.
المسؤولية عن التزييف العميق
كما أشرنا مؤخرًا، فإن قاعدة LAION-aesthetics، التي تمثل جزءًا من 4.2 مليار صورة تدربت عليها نماذج Stable Diffusion الجاري تطويرها، تضم صورًا كثيرة للمشاهير. وهذا يتيح إنشاء تزييف عميق، بما فيه محتوى إباحي مزيف للمشاهير.

من مقالنا السابق: أربع مراحل من مسيرة Jennifer Connelly الممتدة أربعة عقود، كما ولّدها Stable Diffusion.
وهذه مسألة منفصلة وأشد إثارة للجدل من توليد محتوى إباحي تجريدي، وهو قانوني عادة ولا يصور أشخاصًا حقيقيين. ومع ذلك تُستنتج هذه الصور أيضًا من صور حقيقية عديدة في مواد التدريب.
ومع إعداد مزيد من الولايات الأمريكية والدول قوانين تحظر المحتوى الإباحي بالتزييف العميق أو تطبيقها، قد تعني قدرة Stable Diffusion على إنتاجه للمشاهير أن التطبيق التجاري غير الخاضع لرقابة كاملة، أي القادر على إنتاج مواد إباحية، قد يحتاج رغم ذلك إلى تصفية الوجوه التي يتعرف عليها بوصفها لمشاهير.
ومن الطرق توفير قائمة داخلية بمصطلحات لا يقبلها التطبيق في مطالبة المستخدم، تتعلق بأسماء المشاهير والشخصيات الخيالية المرتبطة بهم. وربما يلزم تطبيقها بلغات تتجاوز الإنجليزية لأن البيانات الأصلية تتضمن لغات أخرى. ويمكن أيضًا إدماج أنظمة تعرف المشاهير مثل التي تطورها Clarifai.
وقد يضطر منتجو البرمجيات إلى إدراج هذه الطرق، وربما تكون معطلة أولًا، للمساعدة على منع التطبيق المستقل الكامل من توليد وجوه المشاهير، ريثما تصدر تشريعات قد تجعل هذه الوظيفة غير قانونية.
لكن يمكن للأطراف المهتمة فك تجميع هذه الوظائف وإبطالها أيضًا. ومع ذلك، يستطيع المنتج اعتبار ذلك تخريبًا غير مصرح به، ما دامت الهندسة العكسية ليست سهلة إلى حد مفرط.
ميزات يمكن تضمينها
يُتوقع من أي تطبيق تجاري جيد التمويل أن يقدم الوظائف الأساسية الموجودة في توزيعات Stable Diffusion: استخدام المطالبات النصية لتوليد صور مناسبة، أي نص إلى صورة، واستخدام الرسوم أو الصور الأخرى دليلًا للصور الجديدة، أي صورة إلى صورة، وضبط مدى إبداع النظام، والموازنة بين وقت التوليد والجودة. وتشمل الأساسيات أيضًا الأرشفة التلقائية الاختيارية للصور والمطالبات، والتكبير المعتاد الاختياري عبر RealESRGAN، وتصحيح الوجه الأساسي على الأقل بواسطة GFPGAN أو CodeFormer.
وهذا إعداد أساسي إلى حد كبير. لننظر إلى بعض الوظائف المتقدمة الجاري تطويرها أو توسيعها، والتي يمكن تضمينها في تطبيق تقليدي كامل لـStable Diffusion.
تجميد الترميز العشوائي
حتى عند إعادة استخدام البذرة من توليد سابق ناجح، يصعب جدًا جعل Stable Diffusion يكرر التحويل بدقة إذا تغير أي جزء من المطالبة أو الصورة المصدرية، أو كليهما، في التوليد التالي.
وهذا يسبب مشكلة عند استخدام EbSynth لتطبيق تحويلات Stable Diffusion على فيديو حقيقي باتساق زمني. ومع ذلك، قد تكون التقنية فعالة جدًا في لقطات الرأس والكتفين البسيطة.
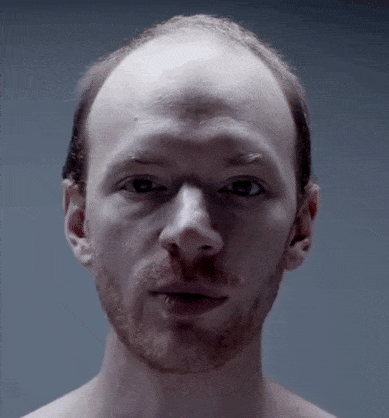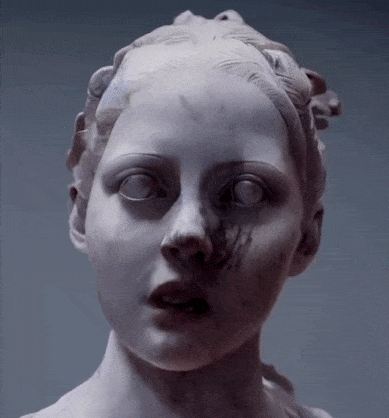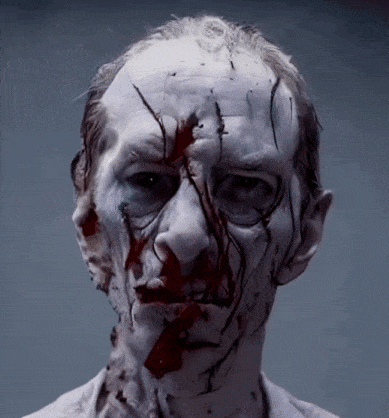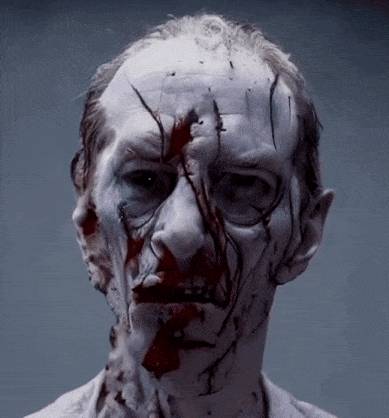
عندما تكون الحركة محدودة، قد يكون EbSynth وسيلة فعالة لتطبيق تحويلات Stable Diffusion في فيديو واقعي. المصدر: https://streamable.com/u0pgzd
يعمل EbSynth بتعميم عدد صغير من الإطارات الرئيسية المعدلة على فيديو فُكك إلى سلسلة ملفات صور، يمكن جمعها لاحقًا في فيديو من جديد.

في هذا المثال من موقع EbSynth، لُوّن عدد قليل من إطارات الفيديو بأسلوب فني. ويستخدمها EbSynth أدلة أسلوبية لتعديل الفيديو كله بالطريقة نفسها ومطابقة الأسلوب المرسوم. المصدر: https://www.youtube.com/embed/eghGQtQhY38
في المثال أدناه، تكاد مدربة اليوغا الشقراء الحقيقية على اليسار لا تتحرك. ومع ذلك، يعاني Stable Diffusion للحفاظ على وجه متسق، لأن الصور الثلاث المحولة كإطارات رئيسية لا تتطابق تمامًا رغم استخدام البذرة العددية نفسها.

حتى مع المطالبة والبذرة نفسيهما في التحويلات الثلاثة، والتغير الضئيل بين الإطارات المصدرية، تختلف عضلات الجسم في الحجم والشكل. والأهم أن الوجه غير متسق، مما يعوق الاتساق الزمني في فيديو EbSynth محتمل.
فيديو EbSynth/SD أدناه مبتكر جدًا، إذ تتحول أصابع المستخدم إلى سروال يمشي وبطة، على الترتيب. لكن عدم اتساق السروال يجسد صعوبة الحفاظ على الاتساق بين إطارات رئيسية مختلفة، حتى إذا تشابهت الإطارات المصدرية وثبتت البذرة.
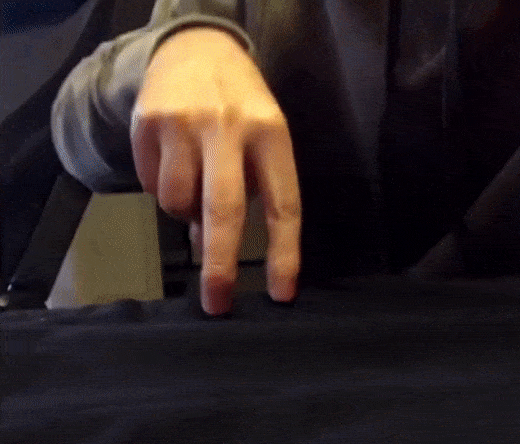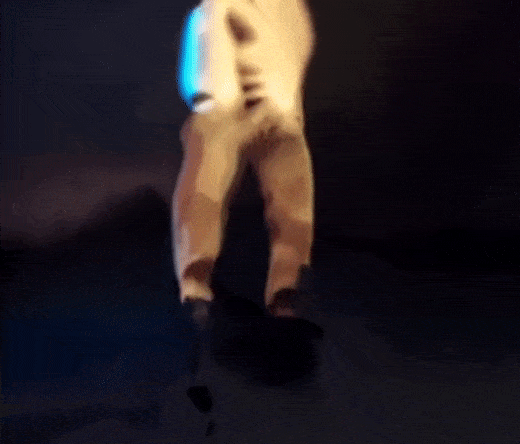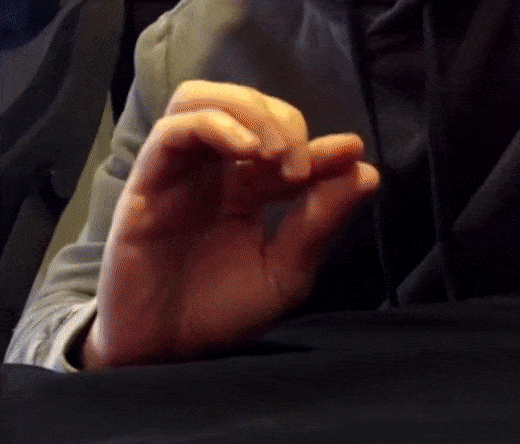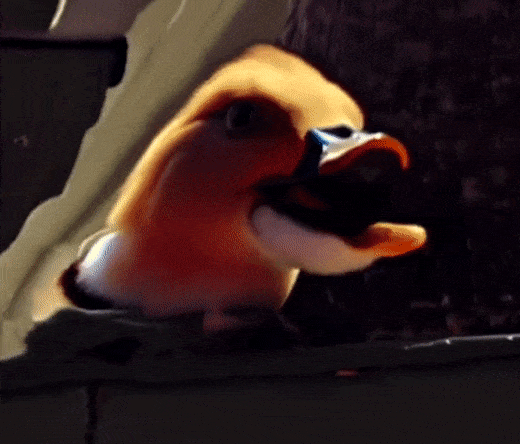
أصابع رجل تتحول إلى رجل يمشي وبطة، بواسطة Stable Diffusion وEbSynth. المصدر: https://old.reddit.com/r/StableDiffusion/comments/x92itm/proof_of_concept_using_img2img_ebsynth_to_animate/
المستخدم الذي صنع الفيديو علّق بأن تحويل البطة، وهو ربما الأنجح بين الاثنين وإن كان أقل لفتًا للانتباه وأصالة، احتاج إلى إطار رئيسي معدل واحد فقط. أما السروال الماشي فاحتاج إلى توليد 50 صورة بـStable Diffusion، مع عدم اتساق زمني أوضح. وأضاف أنه احتاج إلى خمس محاولات لتحقيق الاتساق لكل واحد من الإطارات الخمسين.
لذلك ستكون ميزة كبيرة أن يقدم التطبيق الشامل فعلًا وظيفة تحافظ على الخصائص إلى أقصى حد بين الإطارات الرئيسية.
أحد الاحتمالات هو السماح بتجميد الترميز العشوائي للتحويل في كل إطار، وهو ما يتطلب حاليًا تعديل الشفرة المصدرية يدويًا. وكما يظهر أدناه، يساعد ذلك على الاتساق الزمني لكنه بالتأكيد لا يحل المشكلة تمامًا.
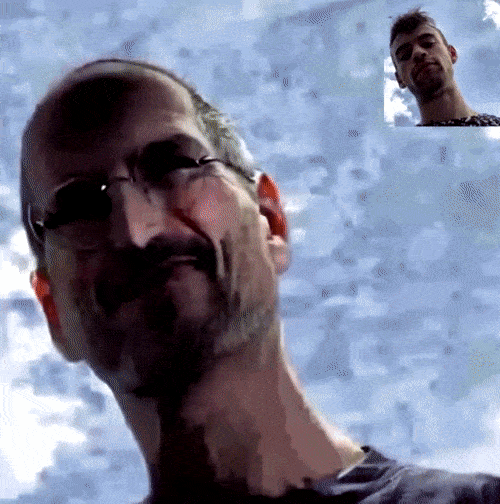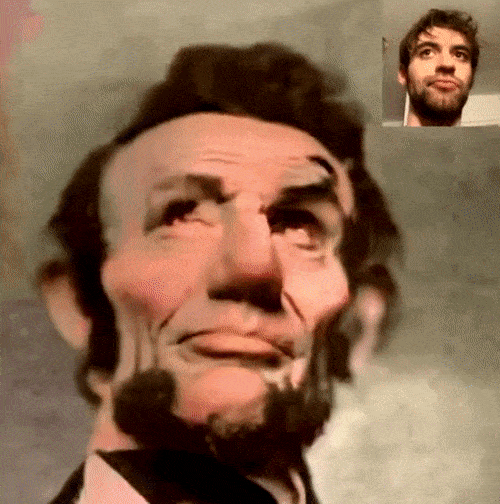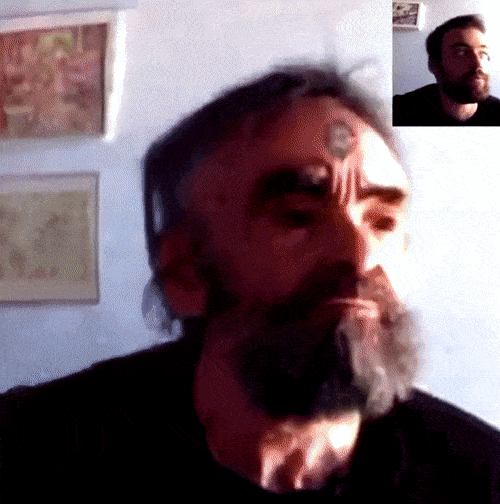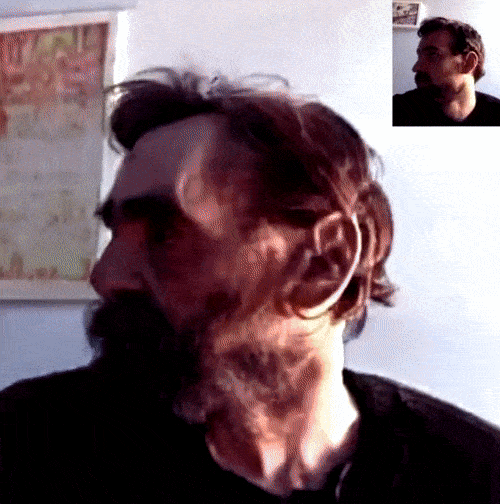
حوّل مستخدم Reddit صور كاميرا الويب الخاصة به إلى مشاهير مختلفين. ولم يثبت البذرة فقط، وهو ممكن في كل تطبيقات Stable Diffusion، بل جعل معامل stochastic_encode() متطابقًا في كل تحويل. وقد تحقق ذلك بتعديل الشفرة، لكن يمكن بسهولة تحويله إلى مفتاح متاح للمستخدم. ومع ذلك، يتضح أنه لا يعالج جميع المشكلات الزمنية. المصدر: https://old.reddit.com/r/StableDiffusion/comments/wyeoqq/turning_img2img_into_vid2vid/
العكس النصي عبر السحابة
حل أفضل للحصول على شخصيات وأشياء متسقة زمنيًا هو تضمينها في ملف عكس نصي، حجمه 5 كيلوبايت، يمكن تدريبه في ساعات قليلة باستخدام خمس صور مشروحة فقط. ثم يُستدعى بمطالبة خاصة تتضمن *، مما يتيح مثلًا الحفاظ على المظهر نفسه لشخصيات جديدة ضمن قصة.

يمكن تحويل الصور المرتبطة بوسوم مناسبة إلى كيانات مستقلة بالعكس النصي، واستدعاؤها بكلمات رمزية خاصة دون غموض وفي السياق والأسلوب الصحيحين. المصدر: https://huggingface.co/docs/diffusers/training/text_inversion
ملفات العكس النصي إضافات إلى النموذج الضخم المدرب بالكامل الذي يستخدمه Stable Diffusion. وتُدمج في عملية الاستدعاء والمطالبات بحيث يمكن أن تشارك في المشاهد التي يولدها النموذج، وتستفيد من معرفته الهائلة بالأشياء والأساليب والبيئات والتفاعلات.
لا يستغرق تدريبها طويلًا، لكنه يحتاج إلى قدر كبير من VRAM؛ إذ تذكر الشروح الحالية 12 و20 وحتى 40 جيجابايت.
ولأن معظم المستخدمين العاديين لا يملكون هذه السعة من وحدات GPU، ظهرت خدمات سحابية تتولى المهمة، ومنها نسخة Hugging Face. وتوجد تطبيقات Google Colab تنشئ ملفات العكس النصي لـStable Diffusion، لكن متطلبات الذاكرة والوقت قد تصعب المهمة على مستخدمي Colab المجاني.
في تطبيق تثبيت كامل وجيد التمويل، يبدو نقل هذه المهمة الثقيلة إلى خوادم الشركة السحابية استراتيجية واضحة لتحقيق الدخل. وذلك بافتراض أن التطبيق المنخفض التكلفة أو المجاني يتضمن وظائف مدفوعة كهذه، وهو مرجح في تطبيقات كثيرة قد تظهر من هذه التقنية خلال الأشهر الستة إلى التسعة المقبلة.
كما يمكن أتمتة عملية شرح الصور والنصوص المقدمة وتنسيقها، وهي معقدة نسبيًا، داخل بيئة متكاملة. وقد يكون إنشاء عناصر فريدة تستكشف عوالم Stable Diffusion الواسعة وتتفاعل معها شديد الإدمان، سواء للهواة عمومًا أو للمستخدمين الأصغر سنًا.
أوزان مرنة للمطالبات
تتيح تطبيقات حالية كثيرة زيادة التأكيد على جزء من مطالبة نصية طويلة، لكن آليات التحكم تختلف كثيرًا، وغالبًا ما تكون ثقيلة أو غير بديهية.
فمثلًا، يمكن لتفرع Stable Diffusion الشائع جدًا من AUTOMATIC1111 خفض قيمة كلمة في المطالبة بإحاطتها بزوج واحد أو عدة أزواج من الأقواس المستديرة، أو زيادة التأكيد بالأقواس المربعة.

يمكن للأقواس المربعة والمستديرة تغيير إفطارك في هذا الإصدار من أوزان مطالبات Stable Diffusion، لكن النتيجة كابوس من الكوليسترول في كلتا الحالتين.
تستخدم إصدارات أخرى علامات التعجب للتأكيد، بينما تتيح الأكثر مرونة تعيين وزن لكل كلمة في المطالبة عبر الواجهة الرسومية.
وينبغي أن يسمح النظام أيضًا بأوزان سالبة للمطالبات، لا لمحبي الرعب وحدهم؛ فقد يحتوي الفضاء الكامن لـStable Diffusion على أسرار أقل إثارة للقلق وأكثر إلهامًا مما يستطيع استخدامنا المحدود للغة استدعاءه.
الرسم خارج حدود الصورة
بعد وقت قصير من الضجة التي أثارها فتح مصدر Stable Diffusion، حاولت OpenAI، دون نجاح يُذكر، استعادة بعض الاهتمام بـDALL-E 2 من خلال الإعلان عن الرسم خارج حدود الصورة. وهو يتيح توسيع الصورة خارج إطارها بمنطق دلالي واتساق بصري.
وطبيعيًا، نُفذت هذه الوظيفة منذ ذلك الحين بأشكال مختلفة لـStable Diffusion، وكذلك داخل Krita. ويجب بالتأكيد تضمينها في إصدار شامل يشبه Photoshop.
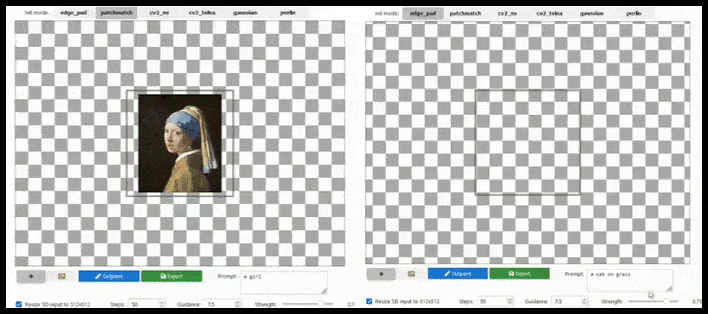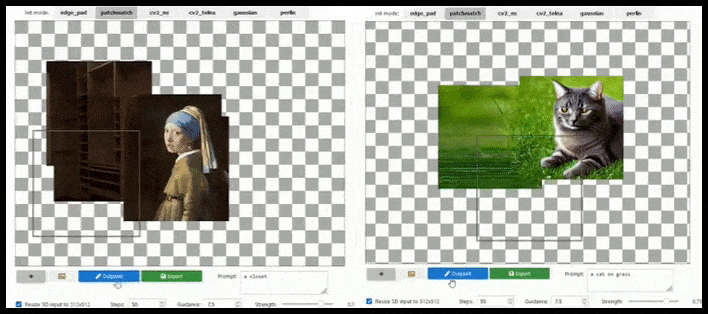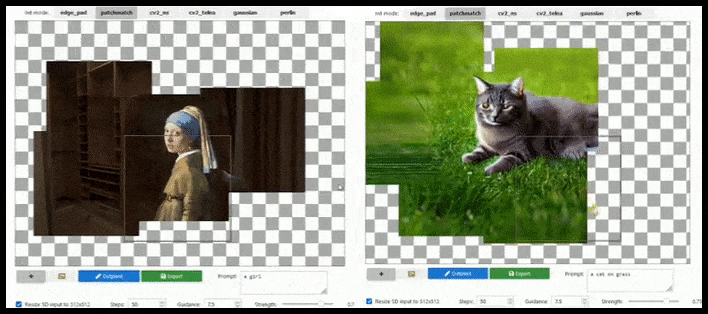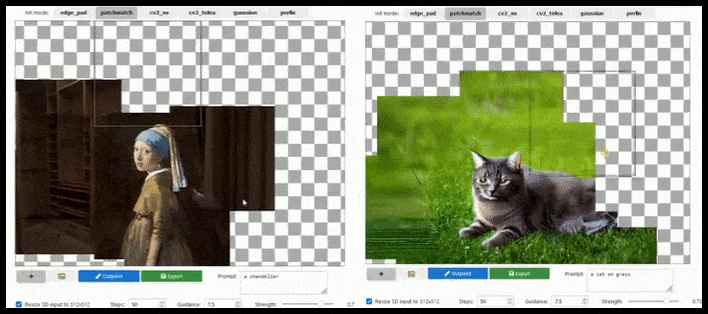
يمكن للتوسيع القائم على القطع أن يمد ناتجًا قياسيًا بحجم 512×512 إلى ما لا نهاية تقريبًا، ما دامت المطالبات والصورة الحالية والمنطق الدلالي تسمح بذلك. المصدر: https://github.com/lkwq007/stablediffusion-infinity
لأن Stable Diffusion تدرب على صور بحجم 512×512 بكسل، ولأسباب أخرى عديدة، فإنه كثيرًا ما يقتطع رؤوس الأشخاص أو أجزاء أساسية أخرى من أجسامهم، حتى عندما تنص المطالبة بوضوح على إبراز الرأس.

أمثلة نموذجية لاقتطاع الرؤوس في Stable Diffusion، لكن الرسم خارج الحدود قد يعيد George إلى الصورة.
أي تطبيق من نوع الرسم خارج الحدود الظاهر في الصورة المتحركة أعلاه، الذي يعتمد حصرًا على مكتبات Unix لكن ينبغي إمكان تنفيذه على Windows، يجب أن يوفر أيضًا علاجًا لهذه المشكلة بنقرة واحدة أو مطالبة واحدة.
حاليًا يمد بعض المستخدمين مساحة الصور المقتطعة الرأس إلى الأعلى، ويملؤون منطقة الرأس مبدئيًا، ثم يستخدمون img2img لإكمال الناتج المعيب.
أقنعة فعالة تفهم السياق
استخدام الأقنعة في Stable Diffusion قد يكون متقلب النتائج للغاية بحسب التفرع أو الإصدار. وحتى عندما يمكن رسم قناع متماسك، كثيرًا ما تُملأ المنطقة المحددة بمحتوى لا يراعي الصورة كلها.
ذات مرة وضعت قناعًا على قرنيتي العينين في صورة وجه وقدمت المطالبة «عينان زرقاوان» لإعادة ملء المنطقة. فبدت النتيجة كأنني أنظر عبر عينين بشريتين مقتطعتين إلى صورة بعيدة لذئب غريب المظهر. أظنني محظوظًا أنه لم يكن Frank Sinatra.
ويمكن أيضًا التحرير الدلالي عبر تحديد الضوضاء التي ولدت الصورة أصلًا، مما يتيح معالجة عناصر بنيوية معينة دون التأثير في الباقي.

يمكن تغيير عنصر واحد دون قناع تقليدي أو تغيير المحتوى المجاور، بتحديد الضوضاء التي أنشأت الصورة أولًا ومعالجة أجزائها التي أسهمت في المنطقة المستهدفة. المصدر: https://old.reddit.com/r/StableDiffusion/comments/xboy90/a_better_way_of_doing_img2img_by_finding_the/
تستند هذه الطريقة إلى أداة أخذ العينات K-Diffusion.
مرشحات دلالية للأخطاء التشريحية
كما أشرنا سابقًا، قد يضيف Stable Diffusion الأطراف أو يحذفها كثيرًا، بسبب مشكلات البيانات ونقص الشروح المصاحبة لصور التدريب.

مثل الطفل المشاغب الذي أخرج لسانه في الصورة الجماعية المدرسية، لا تظهر غرائب Stable Diffusion التشريحية فورًا دائمًا. وربما تنشر أحدث تحفة ذكاء اصطناعي على Instagram قبل أن تلاحظ الأيدي الزائدة أو الأطراف الذائبة.
يصعب إصلاح هذه الأخطاء جدًا؛ لذا سيكون مفيدًا أن يتضمن التطبيق الكامل نظام تعرف تشريحي يستخدم التجزئة الدلالية لحساب ما إذا كانت الصورة الواردة تحتوي على عيوب شديدة، كما في المثال أعلاه، ثم يستبعدها ويولد بديلًا قبل عرضها للمستخدم.

بالطبع قد ترغب في توليد الإلهة Kali أو Doctor Octopus، أو إنقاذ الجزء السليم من صورة ذات أطراف معيبة. لذلك ينبغي أن تكون هذه الوظيفة اختيارية قابلة للتشغيل والإيقاف.
وإذا تقبل المستخدمون جانب القياس عن بعد، فقد تُرسل هذه الإخفاقات دون كشف الهوية ضمن جهد جماعي للتعلم الاتحادي، لمساعدة النماذج المستقبلية على فهم المنطق التشريحي بصورة أفضل.
تحسين تلقائي للوجوه اعتمادًا على LAION
كما أشرت في نظرتي السابقة إلى ثلاثة أمور يمكن لـStable Diffusion معالجتها مستقبلًا، لا ينبغي ترك محاولة تحسين الوجوه في النواتج الأولى لنسخة من GFPGAN وحدها.
تحسيناته نمطية للغاية، وكثيرًا ما تضعف هوية الشخص المصور. كما أنه يعمل فقط على وجه وُلد أصلًا بجودة ضعيفة، لأنه لم يحصل على وقت معالجة أو اهتمام أكبر من بقية الصورة.
لذلك ينبغي للبرنامج الاحترافي التعرف على الوجه بمكتبة قياسية وخفيفة نسبيًا مثل YOLO، وتسخير كامل قدرة GPU المتاحة لإعادة توليده، ثم دمج الوجه المحسن في الناتج الأصلي الكامل السياق، أو حفظه مستقلًا لإعادة التركيب يدويًا. وهذه عملية تتطلب حاليًا تدخلًا يدويًا كبيرًا.
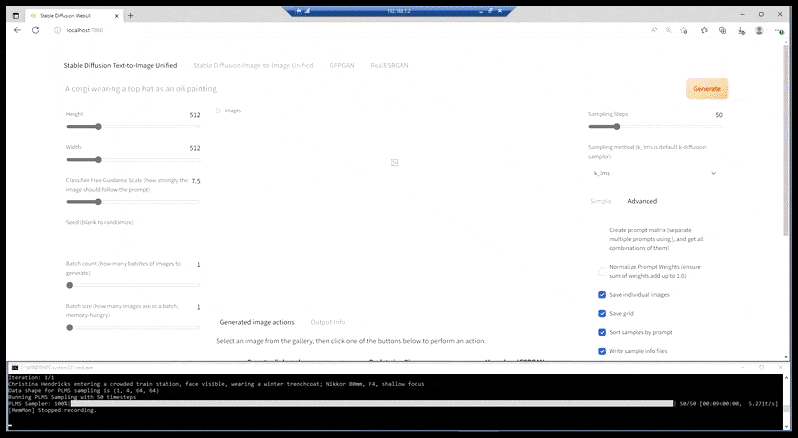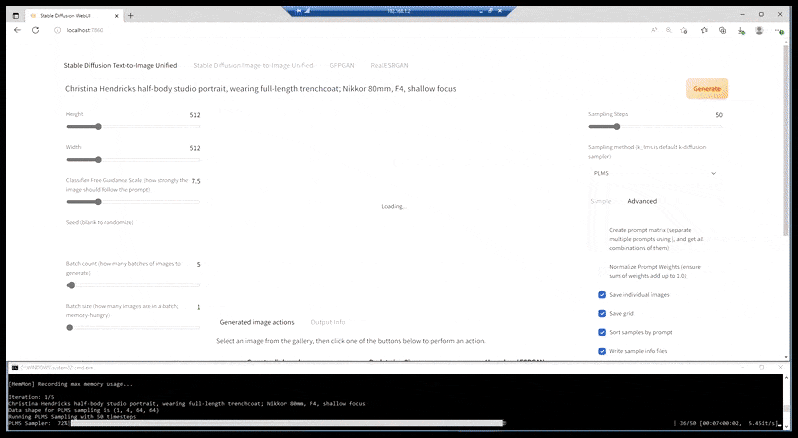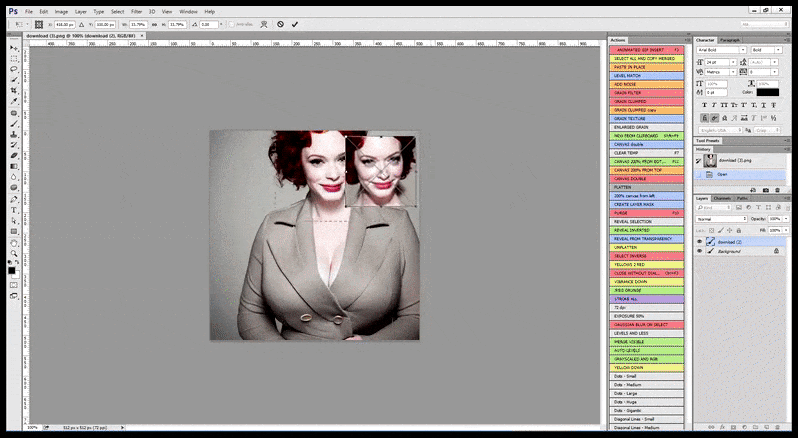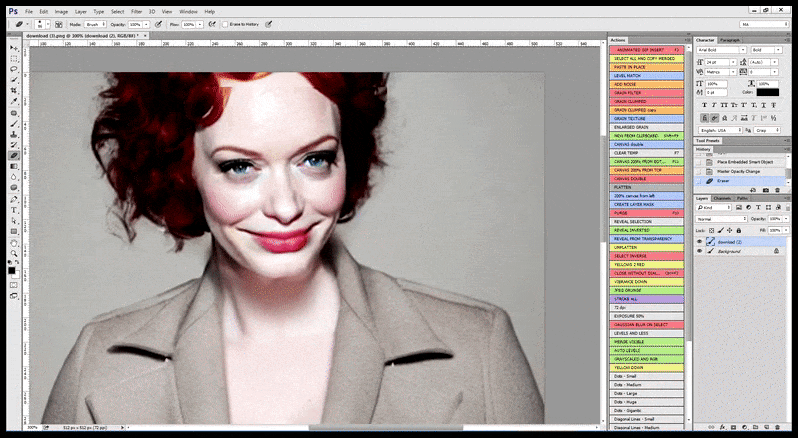
عندما يتدرب Stable Diffusion على صور كافية لأحد المشاهير، يمكن تخصيص قدرة GPU الكاملة في توليد لاحق لوجه الصورة وحده. وهذا يحسن النتيجة عادة بوضوح، ويستفيد، بخلاف GFPGAN، من معلومات بيانات تدريب LAION بدل الاكتفاء بتعديل البكسلات المولدة.
البحث في LAION داخل التطبيق
منذ أن أدرك المستخدمون أن البحث عن مفاهيم وأشخاص وموضوعات في قاعدة LAION قد يساعد على استخدام Stable Diffusion أفضل، أُنشئت أدوات استكشاف عبر الإنترنت، منها haveibeentrained.com.

تتيح وظيفة البحث في haveibeentrained.com استكشاف الصور التي يقوم عليها Stable Diffusion، ومعرفة احتمال وجود الأشياء أو الأشخاص أو الأفكار المراد توليدها في التدريب. وتفيد أيضًا في اكتشاف كيانات مجاورة، مثل كيفية تجمع المشاهير أو الفكرة التالية التي تنشأ من الحالية. المصدر: https://haveibeentrained.com/?search_text=bowl%20of%20fruit
تكشف قواعد الويب هذه كثيرًا عن بعض وسوم الصور، لكن عملية التعميم أثناء تدريب النموذج تعني أنه من غير المرجح استدعاء صورة بعينها بمجرد استخدام وسمها مطالبة.
كما أن إزالة كلمات الوقف، واستخراج الجذور والصيغ المعجمية في معالجة اللغة الطبيعية، تعني أن كثيرًا من العبارات المعروضة قُسمت أو حُذفت قبل إدخالها في تدريب Stable Diffusion.
ومع ذلك، فإن طريقة ترابط المجموعات الجمالية في هذه الواجهات تعلم المستخدم الكثير عن منطق Stable Diffusion، أو شخصيته إن شئنا، وتساعد على إنتاج صور أفضل.
الخاتمة
هناك وظائف أخرى كثيرة أود رؤيتها في تنفيذ أصلي مكتمل لسطح المكتب، مثل تحليل الصور المدمج المعتمد على CLIP. فهو يعكس عملية Stable Diffusion المعتادة ويتيح استخراج العبارات والكلمات التي يربطها النظام طبيعيًا بالصورة الأصلية أو الناتج.
وسيكون التكبير الحقيقي القائم على القطع إضافة مرحبًا بها، لأن ESRGAN أداة خشنة تقريبًا بقدر GFPGAN. ولحسن الحظ، فإن خطط دمج تنفيذ txt2imghd من GOBIG تحقق ذلك بسرعة في التوزيعات، ويبدو خيارًا واضحًا لنسخة سطح المكتب.
بعض الطلبات الشائعة الأخرى في Discord تهمني أقل، مثل قواميس المطالبات المدمجة وقوائم الفنانين والأساليب القابلة للتطبيق. لكن دفترًا داخل التطبيق أو معجم عبارات قابلًا للتخصيص سيكون إضافة منطقية.
وبالمثل، لا يزال تحريك البشر في Stable Diffusion، رغم انطلاقته مع CogVideo ومشاريع أخرى، في مرحلة مبكرة جدًا، ورهن أبحاث أساسية عن المعرفة المسبقة الزمنية المرتبطة بحركة الإنسان الحقيقية.
حاليًا تبدو فيديوهات Stable Diffusion هلوسية تمامًا، لكن قد يكون مستقبلها القريب أكثر إشراقًا في تحريك شخصيات التزييف العميق عبر EbSynth وغيرها من مبادرات النص إلى الفيديو الناشئة. ويجدر ملاحظة عدم وجود أشخاص مولدين أو معدلين في أحدث فيديو ترويجي لـRunway.
ومن الوظائف القيمة الأخرى تمرير الصور بسلاسة من Photoshop وإليه، كما هو معمول به منذ وقت طويل في محرر الخامات بـCinema4D وأدوات مشابهة. وهكذا يمكن نقل الصور بسهولة بين التطبيقات واستخدام كل منها للتحويلات التي يتقنها.
وأخيرًا، وربما الأهم، ينبغي للبرنامج الكامل أن يتيح ليس فقط التبديل السهل بين نقاط التحقق، أي إصدارات النموذج الأساسي الذي يشغل النظام، بل أيضًا تحديث ملفات العكس النصي المخصصة التي عملت مع إصدارات رسمية سابقة وقد تتوقف مع الإصدارات الأحدث، كما أشار المطورون على Discord الرسمي.
ومن المفارقات أن Adobe، الأقدر على إنشاء منظومة أدوات بهذه القوة والتكامل لـStable Diffusion، ارتبطت بشدة بـمبادرة أصالة المحتوى، بحيث قد تبدو هذه الخطوة تراجعًا في العلاقات العامة. والاستثناء هو أن تقيد قدراته التوليدية بالقدر نفسه الذي فعلته OpenAI مع DALL-E 2، وتقدمه تطورًا طبيعيًا لأصولها الكبيرة في الصور المخزنة.
نُشر أول مرة في 15 سبتمبر 2022.


