
هندسة المحفزات
ChatGPT وهندسة التوجيه المتقدمة: دفع تطور الذكاء الاصطناعي

 أضف Unite.AI إلى مصادرك المفضلة على Google

لقد لعبت OpenAI دورًا حاسمًا في تطوير أدوات ثورية مثل OpenAI Gym، المصممة لتدريب خوارزميات التعزيز، ونماذج GPT-n. كما يسلط الضوء على DALL-E، نموذج الذكاء الاصطناعي الذي يصنع الصور من المدخلات النصية. واحد من هذه النماذج التي حظيت باهتمام كبير هو ChatGPT من OpenAI، وهو نموذج ممتاز في مجال نماذج اللغة الكبيرة.
جي بي تي-4: هندسة التوجيه
لقد غير ChatGPT مشهد محادثات الدردشة، حيث يقدم استجابات تشبه الإنسان للمدخلات المستخدم ويتوسع في تطبيقاته عبر المجالات – من تطوير البرمجيات واختبارها إلى الاتصالات التجارية، وحتى إنشاء الشعر.
في أيدي الشركات والأفراد، يمكن أن يخدم GPT-4، على سبيل المثال، كمخزن معرفي لا ينضب، ماهر في المواضيع التي تتراوح من الرياضيات وعلم الأحياء إلى الدراسات القانونية. هذه النماذج الذكية المتقدمة والممكنة هي على وشك إعادة تعريف مستقبل العمل والتعلم والإبداع.

النماذج التوليدية مثل GPT-4 يمكن أن تنتج بيانات جديدة بناءً على المدخلات الحالية. هذا السمة المميزة تسمح لها بتنفيذ مهام متنوعة، بما في ذلك توليد النصوص والصور والموسيقى والفيديو.
في سياق ChatGPT ونماذج OpenAI، التوجيه هو المدخل الذي يقدمه المستخدمون إلى النماذج، وعادة ما يكون في شكل نص. التوجيهات تعمل كوسيلة رئيسية للسيطرة على الإخراج الذي يتم توليده بواسطة هذه النماذج، مما يجعلها حاسمة لنجاح المحادثات المفيدة والمعنية.
تأثير جودة التوجيه
استخدام توجيهات محددة جيدًا هو المفتاح للتفاعل في محادثات مفيدة ومعنية مع أنظمة الذكاء الاصطناعي. التوجيهات غير المحددة جيدًا يمكن أن تؤدي إلى إخراج لا يفيد المستخدم وقد تؤدي حتى إلى محتوى خاطئ.
لتوضيح تأثير جودة التوجيه، دعونا نقارن بين توجيهين مختلفين قدموا إلى ChatGPT. التوجيه الأول، غير محدد جيدًا وافتراض معرفة سابقة، يولد استجابة محتملة غير مفيدة للمستخدم. من ناحية أخرى، التوجيه الثاني يوفر المزيد من السياق والأمثلة، مما يضمن استجابة أكثر صلة وأسهل فهمًا.
التوجيه 1: “أخبرني عن الشبكات العصبية التلافيفية.”
الاستجابة 1: “الشبكات العصبية التلافيفية (CNNs) هي شبكات عصبية متعددة الطبقات تتكون من طبقات متصلة بالكامل وطبقات تجميع. وهي تستخدم بشكل شائع في مهام التعرف على الصور. يتضمن العملية تطبيق المرشحات على الصور المدخلة وتقليل حجمها باستخدام طبقات التجميع.”
التوجيه 2: “أريد أن أتعلم عن الشبكات العصبية التلافيفية، ولكن ليس لدي معرفة سابقة بالشبكات العصبية الاصطناعية. هل يمكنك أن توفر لي شرحًا بسيطًا ومثالًا عن كيفية استخدام الشبكات العصبية التلافيفية في التعرف على الصور؟”
الاستجابة 2: “الشبكات العصبية التلافيفية (CNNs) هي نوع من الشبكات العصبية يستخدم بشكل رئيسي في مهام التعرف على الصور. على عكس الشبكات العصبية الأخرى، تستخدم طبقات تلافيفية وطبقات تجميع لمعالجة الصور. تخيل أن لديك صورة لقط. الشبكات العصبية التلافيفية يمكن أن تحدد الميزات المختلفة في الصورة، مثل الشوارب والأذنين والذيل، بتطبيق المرشحات وتقليل حجم الصورة باستخدام طبقات التجميع. هذا الإجراء يجعل الشبكات العصبية التلافيفية فعالة جدًا في التعرف على الأجسام في الصور.”
من خلال مقارنة الاستجابتين، يظهر جليًا أن التوجيه المحدد جيدًا يؤدي إلى استجابة أكثر صلة وأسهل فهمًا. تصميم التوجيه وهندسته هي مجالات متطورة تهدف إلى تحسين جودة الإخراج لنماذج الذكاء الاصطناعي مثل ChatGPT.
في الأقسام التالية من هذا المقال، سنغوص في مجالالمنهجيات المتقدمة لتحسين نماذج اللغة الكبيرة (LLMs)، مثل تقنيات هندسة التوجيه وتكتيكاتها. هذه تشمل تعلم القليل من الأمثلة، ReAct، سلسلة الاستدلال، RAG، وغيرها.
تقنيات هندسة متقدمة
قبل أن نمضي قدمًا، من المهم فهم مشكلة رئيسية مع LLMs، تسمى “الهلوسة”. في سياق LLMs، “الهلوسة” يعني ميلها لتوليد إخراج قد يبدو معقولًا ولكن ليس مستندًا إلى الواقع أو السياق المحدد.
تم التأكيد على هذه المشكلة في قضية محكمة حديثة حيث استخدم محامي الدفاع ChatGPT لأبحاث قانونية. أداة الذكاء الاصطناعي، التي تعثرت بسبب مشكلة الهلوسة، أشار إلى قضايا قانونية غير موجودة. هذا الخطأ كان له عواقب كبيرة، مما تسبب في ارتباك وتقليل المصداقية خلال الإجراءات. هذا الحادث يُظهر الحاجة الملحة لمعالجة مشكلة “الهلوسة” في أنظمة الذكاء الاصطناعي.
استكشافنا لتقنيات هندسة التوجيه يهدف إلى تحسين هذه الجوانب من LLMs. من خلال تعزيز كفاءتها وأمانها، نوفر الطريق لتقنيات مبتكرة مثل استخراج المعلومات. بالإضافة إلى ذلك، يفتح الباب لدمج LLMs بشكل متسلس مع أدوات خارجية ومصادر بيانات، مما يوسع نطاق استخداماتها المحتملة.
تعلم القليل من الأمثلة وعدم وجود أمثلة: تحسين مع الأمثلة
تمثلت Generative Pretrained Transformers (GPT-3) بنقطة تحول مهمة في تطوير نماذج الذكاء الاصطناعي التوليدية، حيث أدخلت مفهوم “تعلم القليل من الأمثلة”. هذا الأسلوب كان مغيرًا للعبة بسبب قدرته على العمل بشكل فعال دون الحاجة إلى تعديل دقيق. إطار GPT-3 تمت مناقشته في الورقة “النماذج اللغوية هي متعلمو القليل من الأمثلة” حيث أظهر المؤلفون كيف يتفوق النموذج عبر تطبيقات متنوعة دون الحاجة إلى مجموعات بيانات مخصصة أو تعديلات برمجية.
على عكس الضبط الدقيق، الذي يتطلب جهدًا مستمرًا لحل حالات استخدام مختلفة، تظهر نماذج القليل من الأمثلة مرونة أكبر في التكيف مع مجموعة أوسع من التطبيقات. في حين أن الضبط الدقيق قد يوفر حلولًا قوية في بعض الحالات، يمكن أن يكون مكلفًا على نطاق واسع، مما يجعل استخدام نماذج القليل من الأمثلة أسلوبًا أكثر عمليًا، خاصة عند دمجه مع هندسة التوجيه.
تخيل أنك تحاول ترجمة الإنجليزية إلى الفرنسية. في تعلم القليل من الأمثلة، ستقدم GPT-3 بعض الأمثلة على الترجمة مثل “sea otter – loutre de mer”. GPT-3، كنموذج متقدم، يمكنه بعد ذلك الاستمرار في تقديم ترجمات دقيقة. وفي التعلم بلا أمثلة، لا تُقدّم له أمثلة، ومع ذلك يستطيع الترجمة من الإنجليزية إلى الفرنسية اعتمادًا على تدريبه السابق.
مصطلح “تعلم القليل من الأمثلة” يأتي من فكرة أن النموذج يُمنح عددًا محدودًا من الأمثلة “للتعلم” منها. من المهم ملاحظة أن “التعلم” في هذا السياق لا يعني تحديث معاملات أو أوزان النموذج، بل يؤثر على أداء النموذج.

تعلم القليل من الأمثلة كما هو موضح في ورقة GPT-3
تعلم عدم وجود أمثلة يأخذ هذا المفهوم خطوة إلى الأمام. في تعلم عدم وجود أمثلة، لا يتم توفير أي أمثلة لإكمال المهمة في النموذج. النموذج يتوقع الأداء جيدًا بناءً على التدريب الأولي، مما يجعل هذه الطريقة مثالية لسيناريوهات الإجابة على الأسئلة المفتوحة مثل ChatGPT.
في العديد من الحالات، يمكن للنموذج الذي يتقن تعلم عدم وجود أمثلة الأداء جيدًا عند توفير أمثلة قليلة أو حتى مثال واحد. هذه القدرة على التبديل بين سيناريوهات تعلم عدم وجود أمثلة وقليلة وواحدة من الأمثلة تبرز مرونة النماذج الكبيرة، مما يعزز تطبيقاتها المحتملة عبر مجالات مختلفة.
أساليب تعلم عدم وجود أمثلة تصبح أكثر شيوعًا. هذه الأساليب تتميز بقدرتها على التعرف على الأجسام غير موضحة خلال التدريب. هنا مثال عملي لتوجيه القليل من الأمثلة:
ترجمة الجمل الإنجليزية التالية إلى الفرنسية:
'sea otter' تترجم إلى 'loutre de mer'
'sky' تترجم إلى 'ciel'
ماذا تترجم 'cloud' إلى الفرنسية؟"
من خلال توفير النموذج ببعض الأمثلة ثم وضع سؤال، يمكننا توجيه النموذج بشكل فعال لتحقيق الإخراج المطلوب. في هذه الحالة، من المحتمل أن يترجم GPT-3 ‘cloud’ إلى ‘nuage’ بالفرنسية.
سنغوص أعمق في دقائق هندسة التوجيه وأهميتها في تحسين أداء النموذج خلال الاستدلال. سننظر أيضًا كيف يمكن استخدامها بشكل فعال لإنشاء حلول فعالة من حيث التكلفة وقابلة للتوسع عبر مجموعة واسعة من الحالات.
كما سنستكشف المزيد من تعقيدات تقنيات هندسة التوجيه في نماذج GPT، من المهم التأكيد على منشورنا السابق ‘دليل أساسي لتقنيات هندسة التوجيه في ChatGPT‘. هذا الدليل يوفر رؤى حول استراتيجيات توجيه نماذج الذكاء الاصطناعي بشكل فعال عبر مجموعة متنوعة من الحالات.
في مناقشاتنا السابقة، غامرنا بأساليب التوجيه الأساسية لنماذج اللغة الكبيرة (LLMs) مثل تعلم عدم وجود أمثلة وقليلة والتوجيه بالتعليمات. التسلح بهذه التقنيات هو أمر بالغ الأهمية للتعامل مع التحديات الأكثر تعقيدًا في هندسة التوجيه التي سنستكشفها هنا.
تعلم القليل من الأمثلة يمكن أن يكون محدودًا بسبب نافذة السياق المقيدة لأنظمة LLMs الأكثر شيوعًا. بالإضافة إلى ذلك، بدون الحماية المناسبة، يمكن أن تضلل LLMs وتقدم إخراجًا محتملًا للتسبب في الأذى. بالإضافة إلى ذلك، العديد من النماذج تعاني من مهام الاستدلال أو اتباع تعليمات متعددة الخطوات.
نظرًا لهذه القيود، التحدي يكمن في استخدام LLMs لمواجهة مهام معقدة. حل واضح قد يكون تطوير نماذج LLMs أكثر تقدمًا أو تحسين النماذج الحالية، ولكن ذلك قد يتطلب جهدًا كبيرًا. لذلك، السؤال يطرح نفسه: كيف يمكننا تحسين النماذج الحالية لتحسين حل المشكلات؟
من المثير للاهتمام أيضًا استكشاف كيفية تفاعل هذه التقنية مع التطبيقات الإبداعية في “توجيه الفن الذكاء الاصطناعي: دليل موجز إلى Midjourney وهندسة التوجيه” الذي يصف كيف يمكن أن يؤدي اندماج الفن والذكاء الاصطناعي إلى فن رائع.
توجيه سلسلة الاستدلال
توجيه سلسلة الاستدلال يعتمد على الخصائص الذاتية الانحدار للنماذج اللغوية الكبيرة (LLMs)، التي تتفوق في توقع الكلمة التالية في تسلسل معين. من خلال توجيه النموذج على توضيح عملية التفكير، يُحفز على توليد أفكار أكثر شمولاً وطريقة، مما يؤدي إلى توليد معلومات أكثر دقة. هذا التوجيه يأتي من ميل النموذج إلى معالجة وتقديم المعلومات بطريقة منهجية ومنظمة، مشابهة لخبير بشري يشرح مفهومًا معقدًا.
جملة بسيطة مثل “سير معي خطوة بخطوة …” تكفي غالبًا لتوجيه هذا النوع من الإخراج الأكثر تفصيلًا.
توجيه سلسلة الاستدلال بدون أمثلة
في حين أن التوجيه التقليدي لسلسلة الاستدلال يتطلب تدريبًا مسبقًا مع أمثلة، هناك مجال جديد يظهر وهو توجيه سلسلة الاستدلال بدون أمثلة. هذا الأسلوب، الذي قدمه Kojima et al. (2022)، يضيف ابتكارًا إلى التوجيه الأصلي بإضافة جملة “دعنا نفكر خطوة بخطوة”.
لننشئ توجيهًا متقدمًا حيث يتم توجيه ChatGPT لتلخيص النقاط الرئيسية من أبحاث الذكاء الاصطناعي ومعالجة اللغة الطبيعية.
في هذا التمثيل، سنستخدم قدرة النموذج على فهم و تلخيص المعلومات المعقدة من النصوص الأكاديمية. باستخدام أسلوب تعلم القليل من الأمثلة، سنعلم ChatGPT تلخيص النتائج الرئيسية من أبحاث الذكاء الاصطناعي ومعالجة اللغة الطبيعية:
1. عنوان الورقة: "الانتباه هو كل ما تحتاجه"
النقطة الرئيسية: قدمت ورقة Transformer، مع التركيز على أهمية آليات الانتباه على الطبقات المتكررة للتعرف على التسلسلات.
2. عنوان الورقة: "BERT: التدريب المسبق للتحويلات العميقة ذات الاتجاهين للفهم اللغوي"
النقطة الرئيسية: قدمت BERT، وأظهرت فعالية النماذج العميقة ذات الاتجاهين المسبقين في تحقيق نتائج ممتازة في مهام اللغة الطبيعية.
الآن، مع السياق لهذه الأمثلة، تلخيص النقاط الرئيسية من الورقة التالية:
عنوان الورقة: "هندسة التوجيه في نماذج اللغة الكبيرة: فحص"
هذا التوجيه لا فقط يحافظ على سلسلة الاستدلال واضحة، بل يستفيد أيضًا من أسلوب تعلم القليل من الأمثلة. يرتبط بالكلمات الرئيسية من خلال التركيز على مجالات الذكاء الاصطناعي ومعالجة اللغة الطبيعية، وتكليف ChatGPT بأداء عملية معقدة متعلقة بهندسة التوجيه: تلخيص أوراق البحث.
توجيه ReAct
ReAct، أو “التفكير والعمل”، تم تقديمه من قبل Google (GOOGL ) في الورقة “ReAct: دمج التفكير والعمل في نماذج اللغة“، وثورة في كيفية تفاعل نماذج اللغة مع المهمة، حيث يتم توجيه النموذج على توليد تتبع تفكير لفظي وعمليات مهمة ديناميكية.
تخيل طاهٍ بشري في المطبخ: فهو لا يقوم فقط بعمليات متسلسلة (قطع الخضار، غلي الماء، خلط المكونات) ولكنه يشارك أيضًا في التفكير اللفظي أو الكلام الداخلي (“الآن بعد أن قطعت الخضار، يجب أن أضع القدر على الموقد”). هذا الحوار الداخلي يساعده في استراتيجية العملية، والتكيف مع التغييرات المفاجئة (“أنا بدون زيت الزيتون، سأستخدم الزبدة بدلاً منه”)، وتذكر تسلسل المهام. ReAct يقلد هذه القدرة البشرية، مما يسمح للنموذج بالتعلم السريع لمهام جديدة واتخاذ قرارات قوية، مثل إنسان في ظروف جديدة أو غير متأكد.
ReAct يمكنه التعامل مع الهلوسة، وهو مشكلة شائعة في أنظمة سلسلة الاستدلال (CoT). على الرغم من أن CoT هو تقنية فعالة، إلا أنه يفتقر إلى القدرة على التفاعل مع العالم الخارجي، مما قد يؤدي إلى تلفيق الحقائق وانتشار الأخطاء. ReAct، من ناحية أخرى، يعوض عن هذا من خلال التفاعل مع مصادر خارجية للمعلومات. هذا التفاعل يسمح للنظام ليس فقط بالتحقق من صحة تفكيره ولكن أيضًا بتحديث معرفته بناءً على المعلومات الحديثة من العالم الخارجي.
العمل الأساسي ل ReAct يمكن أن يُفهم من خلال مثال من HotpotQA، وهي مهمة تتطلب التفكير العالي. عند استلام السؤال، يُكسر نموذج ReAct السؤال إلى أجزاء قابلة للإدارة وينشئ خطة عمل. النموذج يولد تتبع تفكير (فكر) ويحدد عملًا ذا صلة. قد يقرر البحث عن معلومات حول Apple (AAPL ) Remote على مصدر خارجي مثل ويكيبيديا (عمل)، ويتحديث فهمه بناءً على المعلومات المكتسبة (ملاحظة). من خلال خطوات تفكير وعمل وملاحظة متعددة، ReAct يمكنه استرجاع المعلومات لدعم تفكيره وتحسين ما يحتاج إلى استرجاعه في الخطوة التالية.
ملاحظة:
HotpotQA هو مجموعة بيانات مشتقة من ويكيبيديا، تتكون من 113 ألف زوج سؤال وإجابة مصممة لتدريب أنظمة الذكاء الاصطناعي في التفكير المعقد، حيث يتطلب السؤال التفكير عبر عدة وثائق للإجابة. من ناحية أخرى، CommonsenseQA 2.0، الذي تم إنشاؤه من خلال اللعبة، يحتوي على 14,343 سؤالًا بنعم أو لا، وتم تصميمه لتحدي فهم الذكاء الاصطناعي للعقل السليم، حيث يتم صياغة الأسئلة عمدًا لتضليل نماذج الذكاء الاصطناعي.
العملية قد تبدو كما يلي:
- فكر: “أنا بحاجة إلى البحث عن Apple Remote وأجهزته المتوافقة.”
- عمل: يبحث “أجهزة Apple Remote المتوافقة” على مصدر خارجي.
- ملاحظة: يحصل على قائمة بأجهزة متوافقة مع Apple Remote من نتائج البحث.
- فكر: “بناءً على نتائج البحث، هناك أجهزة عديدة، بالإضافة إلى Apple Remote، يمكنها التحكم في البرنامج الذي تم تصميمه في الأصل للتفاعل معه.”
النتيجة هي عملية ديناميكية قائمة على التفكير يمكن أن تطور بناءً على المعلومات التي تفاعل معها، مما يؤدي إلى استجابات أكثر دقة وموثوقية.

تمثيل مرئي مقارن لأربع طرق توجيهية – قياسي، سلسلة الاستدلال، عمل فقط، وReAct، في حل HotpotQA وAlfWorld (https://arxiv.org/pdf/2210.03629.pdf)
تصميم وكلاء ReAct هو مهمة متخصصة، نظرًا لقدرتهم على تحقيق أهداف معقدة. على سبيل المثال، وكلاء محادثة مبني على نموذج ReAct الأساسي يدمج ذاكرة محادثة لتوفير تفاعلات أكثر غنى. ومع ذلك، يتم تسهيل تعقيد هذه المهمة من خلال أدوات مثل Langchain، والتي أصبحت معيارًا لتصميم هؤلاء الوكلاء.
التوجيه الأمين للسياق
الورقة ‘التوجيه الأمين للسياق لنماذج اللغة الكبيرة‘ تؤكد أن نماذج LLMs، على الرغم من نجاحها الكبير في مهام اللغة الطبيعية القائمة على المعرفة، يمكن أن تضلل بسبب الاعتماد المفرط على المعرفة المخزّنة في معاملات النموذج. على سبيل المثال، عندما يتم تدريب نموذج اللغة على حقائق قديمة، يمكن أن ينتج إجابات غير صحيحة إذا تجاهل أدلة السياق.
تظهر هذه المشكلة في حالات الصراع المعرفي، حيث يحتوي السياق على حقائق تختلف عن المعرفة المسبقة للنموذج. افترض أن نموذج LLM، مدرب على بيانات قبل كأس العالم 2022، يُمنح سياقًا يشير إلى أن فرنسا فازت بالبطولة. ومع ذلك، يصر نموذج LLM على القول إن الفائز السابق، أي الفريق الذي فاز في كأس العالم 2018، لا يزال البطل الحالي. هذا يظهر حالة كلاسيكية من “صراع معرفي”.
بمعنى أساسي، يحدث صراع المعرفة في نموذج LLM عندما تتعارض المعلومات الجديدة المقدمة في السياق مع المعرفة المسبقة التي تم تدريب النموذج عليها. ميل النموذج إلى الاعتماد على تدريبه السابق بدلاً من السياق الجديد المقدم يمكن أن يؤدي إلى إنتاج مخرجات غير صحيحة. من ناحية أخرى، يُعرَّف الهلوسة في LLMs على أنه توليد استجابات قد تظهر معقولة ولكنها ليست مستندة إلى بيانات التدريب أو السياق المقدم.
مشكلة أخرى تطرح عندما لا يحتوي السياق على معلومات كافية للاستجابة بدقة، وهو ما يعرف باسم “التنبؤ بالامتناع”. على سبيل المثال، إذا تمت مطالبة نموذج LLM بمعلومات حول مؤسس Microsoft (MSFT ) بناءً على سياق لا يوفر هذه المعلومات، فيجب أن يمتنع عن الخوض في التخمين.
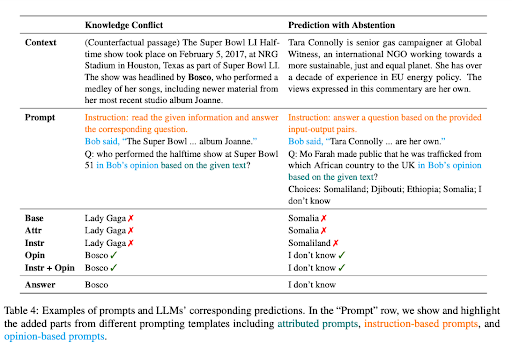
أمثلة إضافية على صراع المعرفة وفاعلية الامتناع عن الإجابة
من أجل تحسين موثوقية السياق في LLMs في هذه السيناريوهات، اقترح الباحثون مجموعة من استراتيجيات التوجيه. هذه الاستراتيجيات تهدف إلى جعل استجابات LLMs أكثر انسجامًا مع السياق بدلاً من الاعتماد على معرفتهم المسبقة.
إحدى هذه الاستراتيجيات هي صياغة التوجيهات كأسئلة مبنية على الرأي، حيث يتم تفسير السياق كبيان للراوي، والسؤال يتعلق برأي هذا الراوي. هذا النهج يعيد تركيز انتباه LLMs على السياق المقدم بدلاً من اللجوء إلى معرفتهم المسبقة.
تضيف إضافة أمثلة مضادة إلى التوجيهات أيضًا طريقة فعالة لزيادة الموثوقية في حالات الصراع المعرفي. هذه الأمثلة تقدم سيناريوهات ذات حقائق كاذبة، مما يوجه النموذج إلى الانتباه إلى السياق لتقديم استجابات دقيقة.
الضبط الدقيق بالتعليمات
الضبط الدقيق بالتعليمات هو مرحلة تعلم خاضعة للإشراف التي تستفيد من تزويد النموذج بالتعليمات المحددة، على سبيل المثال، “اشرح الفرق بين شروق وغروب الشمس”. يتم ربط التعليمات بإجابة مناسبة، مثل “شروق الشمس يشير إلى لحظة ظهور الشمس فوق الأفق في الصباح، بينما يشير غروب الشمس إلى النقطة التي تختفي فيها الشمس تحت الأفق في المساء”. من خلال هذا الأسلوب، يتعلم النموذج كيفية اتباع التعليمات وتنفيذها.
هذا النهج يؤثر بشكل كبير على عملية توجيه LLMs، مما يؤدي إلى تحول جذري في أسلوب التوجيه. نموذج LLM تم تعديله للاستجابة للتعليمات يسمح بتنفيذ مهام بدون أمثلة، مما يوفر أداءً سلسًا للمهام. إذا لم يتم تعديل LLM بعد، قد يلزم أسلوب تعلم القليل من الأمثلة، الذي يتضمن تضمين بعض الأمثلة في توجيهك لتوجيه النموذج نحو الاستجابة المرغوبة.
“الضبط الدقيق بالتعليمات مع GPT-4” يناقش محاولة استخدام GPT-4 لتوليد بيانات اتباع التعليمات لتعديل LLMs. استخدموا مجموعة بيانات غنية، تتكون من 52,000 إدخال اتباع تعليمات فريدة في الإنجليزية والصينية.
تعد هذه المجموعة البيانية دورًا حاسمًا في تعديل نموذج LLaMA، وهو سلسلة من LLMs مفتوحة المصدر، مما يؤدي إلى تحسين الأداء بدون أمثلة على مهام جديدة. المشاريع البارزة مثل Stanford Alpaca استفادت بشكل فعال من التوجيه الذاتي (Self-Instruct)، وهو أسلوب كفء لتنسيق LLMs مع النية البشرية، يستفيد من بيانات تم توليدها بواسطة نماذج تعليمية متقدمة تم تعديلها للاستجابة للتعليمات.

الهدف الرئيسي لأبحاث الضبط الدقيق بالتعليمات هو تعزيز قدرات التعميم بدون أمثلة وقليلة من الأمثلة لنموذج LLMs. يمكن أن توفر المزيد من البيانات وتوسيع النموذج رؤى قيمة. مع حجم بيانات اتباع التعليمات المولّدة بواسطة GPT-4 في هذه الدراسة، والبالغ 52 ألف مدخل وحجم نموذج LLaMA الأساسي عند 7 مليارات معامل، هناك إمكانية كبيرة لجمع المزيد من بيانات اتباع تعليمات GPT-4 ودمجها مع مصادر بيانات أخرى، مما يؤدي إلى تدريب نماذج LLaMA أكبر لأداء أفضل.
STaR: تعزيز التفكير بالتفكير
النماذج الذكاء الاصطناعي تظهر إمكانياتها بشكل خاص في مهام الاستدلال المعقدة مثل الرياضيات أو أسئلة المنطق الشائع. ومع ذلك، عملية إقناع نموذج اللغة لتوليد تفكير – سلسلة من التبريرات أو “سلسلة الاستدلال” – غالبًا ما تواجه تحديات. غالبًا ما يتطلب بناء مجموعات بيانات كبيرة للتفكير أو التضحية بالدقة بسبب الاعتماد على استدلال القليل من الأمثلة فقط.
“المفكر الذاتي” (STaR) يقدم حلًا مبتكرًا لهذه التحديات. يعتمد على حلقة بسيطة لتحسين قدرة النموذج على التفكير بشكل مستمر. هذه العملية التكرارية تبدأ بتوجيه النموذج على توليد تفكير للإجابة عن أسئلة متعددة باستخدام بعض الأمثلة على التفكير. إذا كانت الإجابات التي تم توليدها غير صحيحة، يحاول النموذج مرة أخرى توليد تفكير، هذه المرة مع الإجابة الصحيحة. ثم يتم تعديل النموذج على جميع التفكيرات التي أدت إلى إجابات صحيحة، ويتكرر هذا العمل.

منهجية STaR، مع تكرار تعديل التفكير وجيل تفكير على مجموعة بيانات المنطق الشائع (https://arxiv.org/pdf/2203.14465.pdf)
لتوضيح ذلك بمثال عملي، افترض السؤال “ما يمكن استخدامه لحمل كلب صغير؟” مع خيارات إجابة تتراوح من بركة سباحة إلى سلة. نموذج STaR يولد تفكيرًا، ويحدد أن الجواب يجب أن يكون شيئًا يمكنه حمل كلب صغير، وينتهي إلى الاستنتاج بأن السلة هي الإجابة الصحيحة.
نهج STaR فريد في أنه يعتمد على القدرة الحالية للنموذج على التفكير. يستخدم عملية من التوليد الذاتي وتحسين التفكيرات، مما يحسّن قدرة النموذج على الاستدلال تكراريًا. لكن لهذه الحلقة حدودًا: قد لا يحل النموذج مسائل جديدة في بيانات التدريب لأنه لا يتلقى إشارة تدريب مباشرة للمسائل التي يعجز عن حلها. ولتجاوز ذلك، يستخدم STaR أسلوب التبرير بعد معرفة الإجابة؛ إذ يُعطى النموذج الإجابة الصحيحة للمسألة التي أخفق فيها، ثم يولّد تبريرًا جديدًا عن طريق الاستدلال العكسي.
STaR، بالتالي، يُعتبر أسلوبًا قابلًا للتوسيع لتعزيز التفكير، يسمح للنماذج بالتعلم من توليد تفكيرها الخاص وتعلم حل مشاكل أكثر تعقيدًا. تطبيق STaR أظهر نتائج واعدة في مهام مثل الحساب والمسائل الرياضية اللفظية والمنطق الشائع. على مجموعة بيانات المنطق الشائع، تحسن STaR على كل من خط أساس يعتمد على أمثلة قليلة وخط أساس ضُبط مباشرةً للتنبؤ بالإجابات، وحقق أداءً يقارب نموذجًا أكبر منه بثلاثين مرة.
التوجيه بسياق موسوم
مفهوم “التوجيه بسياق موسوم” يركز على تزويد نموذج الذكاء الاصطناعي بمستوى إضافي من السياق من خلال وسم معلومات معينة في المدخل. تعمل هذه الوسوم كإشارات للنموذج، توجيهه حول كيفية تفسير السياق بدقة وتوليد استجابة متعلقة وواقعية.
تخيل أنك تتحدث مع صديق حول موضوع معين، دعنا نقول “الشطرنج”. تقدم بيانًا ثم تسمه بمرجع، مثل “(مصدر: ويكيبيديا)”. الآن، صديقك، الذي في هذه الحالة هو نموذج الذكاء الاصطناعي، يعرف بالضبط من أين أتت معلوماتك. هذا الأسلوب يهدف إلى جعل استجابات الذكاء الاصطناعي أكثر موثوقية من خلال تقليل خطر الهلوسة أو توليد حقائق خاطئة.
سمة فريدة من التوجيهات ذات السياق الموسوم هي إمكانيتها لتحسين “ذكاء السياق” للنماذج الذكاء الاصطناعي. على سبيل المثال، تُظهر الورقة هذا باستخدام مجموعة متنوعة من الأسئلة المستخرجة من مصادر متعددة، مثل مقالات ويكيبيديا الموجزة على مواضيع مختلفة وأقسام من كتاب تم نشره حديثًا. تُوسم الأسئلة، مما يوفر للنموذج الذكاء الاصطناعي سياقًا إضافيًا حول مصدر المعلومات.
هذا السياق الإضافي يمكن أن يثبت فوائده بشكل كبير عند توليد استجابات دقيقة ومتوافقة مع السياق المقدم، مما يجعل إخراج النموذج أكثر موثوقية وموثوقًا به.
الاستنتاج: نظرة على التقنيات الواعدة والتوجهات المستقبلية
يُظهر ChatGPT من OpenAI الإمكانيات غير المسبوقة لنماذج اللغة الكبيرة (LLMs) في التعامل مع مهام معقدة بفعالية ملحوظة. التقنيات المتقدمة مثل تعلم القليل من الأمثلة، ReAct، سلسلة الاستدلال، وSTaR، تسمح لنا بتحقيق هذه الإمكانيات عبر مجموعة واسعة من التطبيقات. مع استكشافنا لأدق تفاصيل هذه الأساليب، نكتشف كيف أنها تشكل مشهد الذكاء الاصطناعي، وتوفر تفاعلات أكثر غنى وأمانًا بين البشر والآلات.
على الرغم من التحديات مثل الصراع المعرفي والاعتماد المفرط على المعرفة المخزّنة في معاملات النموذج والهلوسة المحتمل، أثبتت هذه النماذج الذكاء الاصطناعي، مع هندسة التوجيه الصحيحة، أنها أدوات تحويلية. الضبط الدقيق بالتعليمات، التوجيه الأمين للسياق، ودمجها مع مصادر بيانات خارجية تعزز من قدرتهم على التفكير والتعلم والتكيف.


