
الأفضل
أفضل 10 أدوات استخراج ويب بالذكاء الاصطناعي (سبتمبر 2026)

 أضف Unite.AI إلى مصادرك المفضلة على Google
قد تتلقى Unite.AI تعويضًا عند استخدام روابط لمنتجات نراجعها. لا يؤثر ذلك في تقييماتنا التحريرية. اقرأ إفصاح الشراكات التسويقية.
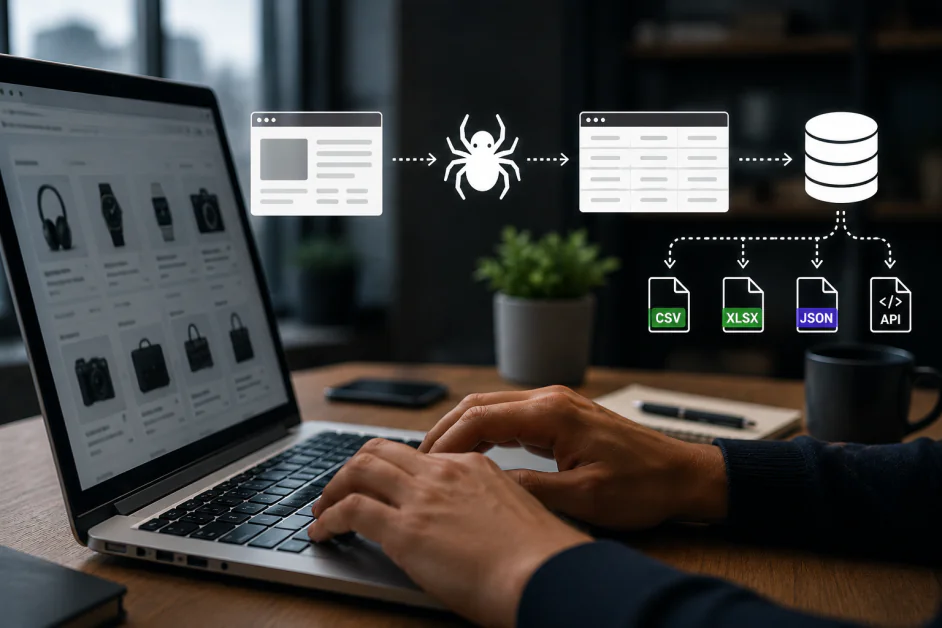
أدوات استخراج الويب بالذكاء الاصطناعي لم تعد مجرد محللات للصفحات. الآن تساعد المنصات الأفضل الفرق على جمع بيانات الويب العامة، وتحويل الصفحات الفوضوية إلى مجموعات بيانات منظمة، وتغذية أنظمة الاسترجاع المدعومة بالتوليد، ومراقبة الأسواق، وتزويد الوكلاء الذكائيين بسياق ويب موثوق.
هذا التحول مهم لأن استخراج البيانات أصبح أكثر قيمة وصعوبة في التنفيذ. المواقع الحديثة ديناميكية، مخصصة، مكتوبة بكثافة، وغالبًا ما تكون محمية بأنظمة مكافحة الإساءة. يجب أن تتجاوز أداة الاستخراج مجرد سحب HTML؛ فهي تحتاج إلى التعامل مع التقديم، منطق الاستخراج، الجدولة، جودة البيانات، الامتثال، وتسليم النتائج إلى الأنظمة التي تُستَخدم فيها.
يعتمد الاختيار الصحيح على المهمة. تحتاج بعض الفرق إلى بنية تحتية من مستوى المؤسسة لبرامج البيانات العامة الضخمة. بينما يحتاج البعض الآخر إلى تنسيق Markdown جاهز للـ LLM، أو روبوت بدون كود للبحث المتكرر، أو منصة للمطورين لأتمتة المتصفح، أو واجهة برمجة تطبيقات مخصصة لنتائج البحث. الأدوات أدناه تغطي هذه النهج المتنوعة.
قامت فرقنا بتقييم كل حل في هذا الدليل بشكل مستقل، مع تحليل قدراته، نقاط قوته العملية، قيوده، ومدى ملاءمته لحالات الاستخدام التي تعكس ترتيبنا.
أفضل أدوات استخراج ويب بالذكاء الاصطناعي مقارنة
| أداة الذكاء الاصطناعي | الأفضل لـ | نقاط القوة الرئيسية |
|---|---|---|
| Bright Data | استخراج ويب مؤسسي، بنية تحتية للوكيل، وسلاسل بيانات الذكاء الاصطناعي | واجهات برمجة تطبيقات السحب، واجهة برمجة تطبيقات المتصفح، استوديو السحب، فك الحظر، بنية تحتية للوكيل، مجموعات بيانات، سير عمل RAG |
| Firecrawl | تحويل المواقع إلى محتوى نظيف جاهز للـ LLM لتطبيقات الذكاء الاصطناعي | سحب، زحف، بحث، خريطة، مراقبة، Markdown، JSON منظم، تفاعل المتصفح، API، MCP، مفتوح المصدر |
| Apify | المطورون الذين يبنون سحابات سحب، أتمتة المتصفح، وعوامل بيانات | سوق الممثلين، Crawlee، Playwright، Puppeteer، Selenium، جدولة، وكلاء، مجموعات بيانات، APIs، تكاملات MCP |
| Browse AI | استخراج ويب بدون كود، مراقبة المواقع، وجمع بيانات أعمال متكررة | روبوتات ذكاء اصطناعي، تدريب بالنقر والإشارة، مراقبة المواقع، استخراج مجدول، روبوتات مسبقة الصنع، تكاملات |
| SearchAPI | بيانات محركات البحث في الوقت الفعلي للذكاء الاصطناعي، تحسين محركات البحث، وسير عمل البحث | Google، Google Maps، Bing، YouTube، بيانات التسوق والأخبار، JSON منظم، استهداف جغرافي، تدوير الوكيل، محاولات إعادة، MCP |
| ScrapingBee | واجهة برمجة تطبيقات سحب صديقة للمطورين مع استخراج ذكائي وتقديم جافاسكريبت | استخراج بلغة طبيعية، JSON منظم، Markdown، سيناريوهات جافاسكريبت، تدوير وكيل، لقطات شاشة، APIs مخصصة، CLI، MCP |
| Octoparse | استخراج بصري بدون كود للمواقع الديناميكية والوظائف السحابية المتكررة | منشئ سير عمل بصري، اكتشاف تلقائي بالذكاء الاصطناعي، استخراج سحابي، قوالب، تدوير IP، جدولة، تصدير، APIs |
| Oxylabs | واجهات برمجة تطبيقات استخراج مؤسسية، ذكاء اصطناعي، ومواقع عامة صعبة | Web Scraper API، AI Studio، متصفح بدون رأس، فك الحظر، Fast Search API، بيانات منظمة، استهداف جغرافي |
| Diffbot | تصنيف صفحات تلقائي، استخراج كيانات، والوصول إلى Knowledge Graph | Extract API، Crawl API، Knowledge Graph، إثراء الكيانات، معالجة لغة طبيعية، رؤية حاسوبية، مجموعات بيانات منظمة |
| ScrapeGraphAI | استخراج بلغة طبيعية مع JSON منظم وتكاملات أطر الذكاء الاصطناعي | استخراج قائم على المطالبة، مخططات JSON، زحف، مراقبة، تقديم جافاسكريبت، SDKs، CLI، MCP، تكاملات LangChain و CrewAI |
كيفية اختيار أداة استخراج ويب بالذكاء الاصطناعي
ابدأ بتحديد نوع مشكلة بيانات الويب التي تواجهها. إذا كان الهدف هو تزويد منتج ذكائي بسياق ويب نظيف، أعطِ الأولوية لـ Markdown، JSON منظم، أدوات الزحف، ومخرجات صديقة للاسترجاع. إذا كان الهدف هو بحث أعمال متكرر، قد يكون الروبوت بدون كود أو منشئ سير عمل بصري أسرع. إذا كان الهدف هو جمع بيانات عامة على نطاق واسع، ابحث عن عمق بنية تحتية: تقديم، قوائم انتظار، تحكم بالوكيل، فك الحظر، مراقبة، وتسليم موثوق.
السؤال الثاني هو من سيصون سير العمل. فريق تسويق يتتبع صفحات المنافسين يحتاج إلى منتج مختلف تمامًا عن فريق هندسة يبني خط أنابيب بيانات. تجعل الأنظمة الجيدة الاستخراج قابلًا للتكرار، لكنها لا تلغي الحاجة إلى التحقق. المواقع تتغير، الحقول تنحرف، واستخراج الذكاء الاصطناعي قد يبدو واثقًا حتى عندما تكون الصفحة غامضة. الإعداد المثالي هو ما يتناسب مع مهارات فريقك التقنية، عملية المراجعة، والالتزامات التنظيمية.
أفضل 10 أدوات استخراج ويب بالذكاء الاصطناعي
1. Bright Data
يُعد Bright Data الخيار الأقوى عندما يكون جمع بيانات الويب نظامًا أساسيًا للأعمال وليس مجرد مشروع جانبي. يجمع بين واجهات برمجة تطبيقات السحب، بنية المتصفح، إدارة الوكيل، تقنية فك الحظر، ومجموعات بيانات جاهزة، بحيث يمكن للفرق جمع بيانات ويب عامة على نطاق كبير دون الحاجة لتجميع كل طبقة يدويًا.
تكون المنصة مفيدة بشكل خاص للشركات التي تبني ذكاءً تجاريًا، مراقبة تجارة إلكترونية، استخبارات بحث، مجموعات بيانات لتدريب الذكاء الاصطناعي، سير عمل RAG، أو منتجات بيانات تنافسية. يمنح Bright Data الفرق التقنية سيطرة كافية لبناء سير عمل معقد بينما يوفر مسارات مُدارة للفرق التي تريد بيانات منظمة دون صيانة بنية سحب هشة.
هذا النطاق هو أيضًا ما يُشكل اعتبار الشراء. يصبح Bright Data منطقيًا عندما تستطيع المؤسسة تخصيص فريق هندسة أو عمليات بيانات، تعريف أهداف معتمدة، ومراقبة الجودة والتكلفة بمرور الوقت. قد تكون الفرق الصغيرة ذات قائمة مواقع سهلة أفضل خدمةً عبر API أخف أو خدمة بدون كود، بينما يجب على البرامج الخاضعة للرقابة مواءمة سياسات الجمع مع مراجعات قانونية وخصوصية.
الإيجابيات والسلبيات
- أوسع تغطية بنية تحتية في هذا التصنيف
- ملاءمة قوية للمواقع العامة ذات الحجم الكبير والصعوبة
- مجموعات سحب ومجموعات بيانات جاهزة تقلل وقت الإنشاء
- مفيدة لسلاسل بيانات الذكاء الاصطناعي، استخبارات البحث، ومراقبة التجارة الإلكترونية
- بنية تحتية أكثر مما تحتاجه المشاريع الصغيرة المتقطعة
- الفرق لا يزال بحاجة إلى حوكمة بيانات واضحة وقواعد للمواقع المستهدفة
- الاستخدامات المتقدمة تتطلب إعدادًا تقنيًا ومراقبة
2. Firecrawl
تم بناء Firecrawl لعصر الذكاء الاصطناعي في استخراج الويب. بدلاً من إجبار المطورين على تنظيف HTML الخام، إدارة تقديم الصفحات، وتطبيع محتوى المواقع الفوضوي يدويًا، يحول الصفحات إلى Markdown نظيف أو بيانات منظمة يمكنها تغذية الوكلاء، أنظمة الاسترجاع، أدوات البحث، وسير عمل المنتجات.
الجاذبية تكمن في البساطة على طبقة التطبيق. يمكن للمطورين سحب صفحة، زحف موقع، بحث الويب، رسم خريطة URLs، مراقبة تغييرات، أو طلب مخرجات منظمة مع جهد أقل بكثير مقارنةً ببيئة سحب تقليدية. Firecrawl مناسب بشكل خاص عندما يكون المنتج النهائي مساعدًا ذكائيًا، قاعدة معرفة، سير بحث، أو نظام توليد مدعوم بالاسترجاع.
يجب على الفرق اعتبار Firecrawl كطبقة اكتساب محتوى وليس كمنصة بيانات شاملة. لا يزال الاستخدام الإنتاجي يتطلب تحديد نطاق المصدر، إزالة التكرار، قواعد حداثة، تحقق من المخطط، ومراقبة عندما تتغير المواقع. قيمته أعلى عندما يرغب المطورون في API مختصر وإمكانية استضافة ذاتية، لكنهم لا يحتاجون إلى تحكم واسع في الوكيل أو مجموعات بيانات مُدارة تقدمها مزودات البنية التحتية المؤسسية.
الإيجابيات والسلبيات
- ملاءمة ممتازة لتطبيقات الذكاء الاصطناعي التي تحتاج إلى سياق ويب نظيف
- Markdown ومخرجات منظمة تقلل من التنظيف اللاحق
- سطح API مفيد للسحب، الزحف، البحث، الرسم الخريطي، والمراقبة
- الخيار المفتوح المصدر يمنح الفرق التقنية مرونة أكبر في النشر
- ليس منصة وكيل أو بنية تحتية بيانات مؤسسية كاملة
- الاستخراج المعقد لا يزال يستفيد من تصميم مخطط والتحقق
- الفرق ذات المتطلبات الصارمة للامتثال يجب أن تراجع خيارات النشر والاحتفاظ بعناية
3. Apify
Apify خيار قوي للفرق التي تريد منصة مطورين وسوقًا كبيرًا من أدوات أتمتة الويب الجاهزة. يجعل نموذج الـ Actor من الممكن حزم السحابات، أتمتة المتصفح، وسير عمل البيانات كوظائف سحابية قابلة لإعادة الاستخدام يمكن جدولتها، استدعاؤها عبر API، ربطها بالتخزين، ومشاركتها عبر الفريق.
يحصل المطورون على مسار عملي من النموذج الأولي إلى الإنتاج. يمكنهم البناء باستخدام Crawlee، Playwright، Puppeteer، Selenium، أو ممثلين موجودين، ثم استخدام Apify للتنفيذ، قوائم الانتظار، الوكلاء، مجموعات البيانات، webhooks، والتكاملات. هذا يجعلها مفيدة بشكل خاص للفرق التي تحتاج إلى وظائف بيانات متكررة بدلاً من استخراج صفحة لمرة واحدة.
مرونة Apify هي قوة ومسؤولية. تحتاج الفرق إلى اختيار ممثلين موثوقين، التحكم في الإصدارات، مراقبة التنفيذ، وتخصيص ميزانية للكمبيوتر، الوكيل، واستخدام التخزين مع نمو الأحمال. هي الأنسب للمطورين الذين يرغبون في كتل بناء قابلة لإعادة الاستخدام وعمليات سحابية في مكان واحد؛ قد يجد المستخدمون العرضيين أداة سحب مخصصة أسرع في التعلم.
الإيجابيات والسلبيات
- سوق كبير من الـ Actors الجاهزة للأهداف الشائعة
- أدوات مطورين قوية للسحب المخصص وأتمتة المتصفح
- ملاءمة جيدة لسير عمل جمع بيانات مجدولة ومتكررة
- دعم Crawlee يمنح الفرق التقنية أساسًا مفتوح المصدر مرنًا
- جودة السوق تختلف حسب الـ Actor وحالة الاستخدام
- الوظائف المخصصة لا تزال تحتاج صيانة عندما تتغير المواقع
- المستخدمون غير التقنيون قد يفضلون أداة سحب بصرية أبسط
4. Browse AI
Browse AI هو الأنسب للفرق التجارية التي تحتاج إلى بيانات ويب دون الحاجة لبناء سحابات. يقوم المستخدمون بتدريب روبوت عن طريق إظهار ما يجب جمعه، ثم تشغيل ذلك الروبوت حسب الطلب أو وفق جدول. يجعل ذلك الأداة مفيدة لتتبع المنافسين، مراقبة القوائم، جمع العملاء المحتملين، مراقبة المخزون، أو تحويل أبحاث متكررة إلى سير عمل متجدد.
تكمن قوته في سهولة الوصول. يوفّر Browse AI طريقة عملية للعمليات، التسويق، التوظيف، التجارة الإلكترونية، والفرق البحثية لجمع بيانات منظمة من المواقع دون طلب من الهندسة صيانة كل محدد. لا يسعى لأن يكون أعمق منصة للمطورين؛ بل يهدف إلى جعل جمع بيانات الويب القابل للتكرار سهل الوصول.
يعمل Browse AI بأفضل شكل عندما يمكن توضيح سير العمل المستهدف بوضوح ومراجعته من قبل إنسان. يجب على المستخدمين اختبار الصفحات المتعددة، خطوات الدخول، الحالات الفارغة، وتغييرات التخطيط قبل الاعتماد على الأتمتة في اتخاذ القرارات. هو خيار قوي للمشاريع القسمية، لكن قد تحتاج البرامج التي تقودها الهندسة إلى تحكم أكثر دقة في إعادة المحاولة، عقود البيانات، والنشر.
الإيجابيات والسلبيات
- تجربة بدون كود قوية للمستخدمين التجاريين
- ملاءمة جيدة للمراقبة المتكررة وسير عمل على نمط الجداول
- تدريب الروبوت بالنقر والإشارة أسهل من الإعداد القائم على المحددات
- مفيد للفرق التي تحتاج إلى بيانات ويب دون دعم هندسي
- أقل مرونة من المنصات الموجهة للمطورين للمنطق المعقد
- قد تحتاج الروبوتات إلى تعديل عندما تتغير الصفحات المستهدفة بشكل كبير
- البرامج الكبيرة أو المخصصة بشدة قد تتجاوز نهج بدون كود
5. SearchAPI
SearchAPI هي خدمة سحب متخصصة للفرق التي تحتاج إلى نتائج محركات بحث حالية كبيانات منظمة بدلاً من صفحات نتائج خام. يمكن لواجهة برمجة تطبيقات واحدة إرجاع روابط عضوية، إعلانات، أخبار، قوائم خرائط، نتائج تسوق، لوحات معرفة، أسئلة “الناس أيضًا يسألون”، ميزات بحث مولدة بالذكاء الاصطناعي، وأنواع نتائج أخرى بصيغة JSON، بحسب المحرك المختار.
تكون المنصة مفيدة بشكل خاص لمراقبة تحسين محركات البحث، تحليل البحث المحلي، أبحاث السوق، استخبارات المنتج، والوكلاء الذكائيين الذين يحتاجون إلى سياق بحث في الوقت الفعلي. تدير SearchAPI تقديم المتصفح، تدوير الوكيل، محاولات إعادة، ومعالجة CAPTCHA خلف الطلب، بينما تدعم معلمات التوطين البلد، اللغة، الموقع، والاستعلامات الخاصة بالجهاز. تمتد محركاتها الموثقة إلى ما وراء نتائج Google القياسية لتشمل Google Maps، Bing، YouTube، الأخبار، وتجارب البحث التجاري.
توفر SearchAPI أيضًا خادم MCP لربط المساعدين الذكائيين المدعومين وبيئات التطوير بأدوات البحث الخاصة بها. المقايضة هي التخصص: هذه طبقة بيانات بحث قوية، ليست زاحفًا عامًا لاستخراج حقول عشوائية من أي موقع. يجب على المشترين نمذجة الاستخدام بعناية لأن الخطط تعتمد على الرصيد، والقدرة على التحمل تختلف حسب الفئة، ولا تزال أسطح البحث الغنية تحتاج إلى فحص المخطط عندما تتغير تخطيطات المصدر.
الإيجابيات والسلبيات
- يرجع بيانات SERP في الوقت الفعلي ومنظمة دون الحاجة لصيانة سحابات بحث أو بنية وكيل
- يدعم محركات بحث، خرائط، فيديو، أخبار، تسوق، ومحركات نتائج متخصصة أخرى
- تحكم بالموقع، اللغة، البلد، والجهاز يناسب تتبع الترتيب وأبحاث السوق
- الوصول عبر API وMCP يجعل بيانات البحث عملية للتطبيقات والوكلاء الذكائيين
- مركز على بيانات نتائج محركات البحث وليس على زحف مواقع عشوائية
- الخطط القائمة على الرصيد وحدود القدرة تتطلب توقعات لأحمال حجمية عالية
- يجب على التطبيقات التحقق من الحقول مع تغير تخطيطات محركات البحث
6. ScrapingBee
ScrapingBee هي واجهة برمجة تطبيقات صديقة للمطورين للفرق التي تريد جمع بيانات ويب وتنسيقها دون صيانة متصفحات بدون رأس أو بنية وكيل. تجمع بين تقديم جافاسكريبت، تدوير الوكيل، لقطات شاشة، استخراج CSS/XPath، وطبقة استخراج ذكائية تحول الطلبات بلغة طبيعية وقواعد الحقول إلى JSON منظم.
تكون المنصة مفيدة بشكل خاص عندما يرغب المطورون في نقطة نهاية واحدة لكل من الصفحات البسيطة والمواقع التفاعلية. يمكن للسيناريوهات الجافاسكريبت النقر، التمرير، الكتابة، أو الانتظار قبل الاستخراج، بينما يسهّل إخراج Markdown، APIs مخصصة، CLI، وتكاملات MCP نقل المحتوى المستخرج إلى التحليلات، الأتمتة، وسير عمل الذكاء الاصطناعي. ScrapingBee أبسط في الاعتماد مقارنةً ببيئة سحب كاملة، رغم أن استهلاك الرصيد قد يتقلب مع الوكلاء المميزين، التقديم، وميزات الذكاء.
يتناسب ScrapingBee أفضل عندما يرغب المهندسون في طبقة طلب مُدارة مع الحفاظ على تنظيم الأوركسترا وجودة البيانات داخل تطبيقهم. يجب على الفرق تحديد قواعد إعادة المحاولة، المخططات، حدود الزحف، والتحقق للوظائف المتعددة الصفحات بدلاً من اعتبار كل استجابة HTTP ناجحة بيانات موثوقة. سيكون أداة سحب سطح مكتب بصرية أسهل للمستخدمين غير التقنيين، لكن فرق API ستحصل على سيطرة مباشرة أكبر على التكامل والنشر.
الإيجابيات والسلبيات
- استخراج ذكائي بلغة طبيعية يمكنه إرجاع JSON منظم دون الحاجة لمحددات يدوية
- تقديم جافاسكريبت وإجراءات برمجية تتعامل مع العديد من سير عمل الصفحات الديناميكية
- تدوير وكيل، لقطات شاشة، إخراج Markdown، وAPIs مخصصة متاحة عبر خدمة واحدة
- CLI، MCP، وتكاملات أتمتة تناسب سير عمل المطورين والوكلاء
- استهلاك الرصيد يرتفع عندما تُضاف استخراج ذكائي أو وكلاء مميزين أو تقديم جافاسكريبت
- هو منتج يركز على API وليس أداة سحب سطح مكتب بصرية
- الزحف المتعدد الصفحات المعقد لا يزال يتطلب أوركسترا وفحوص جودة
7. Octoparse
Octoparse هي أداة سحب بدون كود ناضجة للمستخدمين الذين يفضلون سير عمل بصري بدلاً من إطار عمل للمطورين. يمكنها اكتشاف بيانات الصفحة، إرشاد المستخدمين خلال خطوات الاستخراج، وتشغيل وظائف السحب في السحابة، مما يجعلها مفيدة للجمع المتكرر من مواقع التجارة الإلكترونية، الأدلة، القوائم، صفحات البحث، وغيرها من مصادر الويب المهيكلة.
تكون المنصة أقوى عندما يحتاج الفريق إلى تحكم أكبر في سير العمل مقارنةً بأداة سحب امتداد متصفح سريعة، لكن لا يزال يرغب في تجنب كتابة كود. القوالب، الجدولة، الاستخراج السحابي، الصادرات التلقائية، ودعم الصفحات الديناميكية تجعل Octoparse نقطة وسط عملية بين الأدوات البسيطة بدون كود ومنصات السحب التي تقودها الهندسة.
نموذجها البصري لا يزال يتطلب تصميم سير عمل مدروس. يجب على الفرق اختبار الصفحات المتعددة، التمرير اللامتناهي، حالات الدخول، السجلات المكررة، وفروع الأخطاء قبل الاعتماد على الوظائف المجدولة. Octoparse ملائمة للمحللين ومستخدمي العمليات الذين يمكنهم تحمل هذه الفحوصات، بينما قد يفضل المطورون الذين يبنون خطوط أنابيب ذات إصدارات محكمة واجهة برمجة تطبيقات أو إطار عمل برمجي يضمن تحكمًا أقوى في المصدر والاختبار الآلي.
الإيجابيات والسلبيات
- منشئ سير عمل بصري يمنح المستخدمين تحكمًا أكبر من الأدوات بنقرة واحدة
- الاستخراج السحابي يساعد الوظائف المتكررة على التشغيل دون جهاز محلي
- القوالب تقلل وقت الإعداد للمواقع والبيانات الشائعة
- ملاءمة جيدة للفرق التشغيلية التي تحتاج إلى مجموعات بيانات مهيكلة متكررة
- تصميم سير العمل قد يستغرق وقتًا على المواقع المعقدة
- أقل طبيعية للفرق المطورة التي تفضل خطوط أنابيب برمجية أولاً
- لا يزال يتطلب مراقبة مستمرة عندما تتغير المواقع المستهدفة
8. Oxylabs
Oxylabs يناسب الفرق التي تحتاج إلى وصول موثوق إلى بيانات الويب العامة على نطاق واسع ولا ترغب في إدارة تدوير الوكيل، التقديم، وطبقات الحماية بأنفسهم. تم تصميم واجهة Web Scraper API الخاصة به لجمع بيانات عامة منظمة من مجموعة واسعة من الأهداف مع معالجة معظم بنية السحب خلف الكواليس.
كما دفعت الشركة قدمًا نحو سير عمل بيانات الذكاء الاصطناعي عبر AI Studio، Fast Search API، أتمتة المتصفح، وحالات الاستخدام الموجهة للتمكين. يجعل ذلك Oxylabs ذات صلة للمنظمات التي تبني أنظمة استخبارات السوق، مراقبة البحث، خطوط أنابيب تمكين النماذج، مجموعات بيانات تجارة إلكترونية، وسير عمل الوكلاء التي تحتاج إلى سياق ويب حديث.
تكون Oxylabs أكثر إقناعًا عندما تبرر الموثوقية، صعوبة الهدف، أو الوصول الجغرافي خدمة موجهة للمؤسسات. يجب على المشترين رسم خريطة المواقع المستهدفة، متطلبات الإخراج، أوقات الاستجابة، وملكية الامتثال قبل اختيار تكوين المنتج. قد لا تستفيد المشاريع الصغيرة من عمق البنية التحتية بالكامل، بينما لا تزال البرامج الكبيرة تحتاج إلى مراقبة جودة مستقلة لأن الجمع الناجح لا يضمن تطبيعًا دقيقًا.
الإيجابيات والسلبيات
- بنية تحتية قوية على مستوى المؤسسة لاستخراج وكيل
- مفيدة لسلاسل بيانات الويب العامة التي تحتاج إلى نطاق وموثوقية
- AI Studio وFast Search API يدعمان سير عمل الوكلاء والتمكين
- ملاءمة جيدة للمواقع الديناميكية الصعبة وجمع البيانات المستهدف جغرافيًا
- مناسب للفرق ذات المتطلبات التقنية والامتثال المحددة
- قد تكون بنية تحتية أكثر مما تتطلبه المشاريع الصغيرة بدون كود
- الوظائف المتقدمة تحتاج إلى اختيار هدف دقيق والتحقق
9. Diffbot
Diffbot يختلف عن معظم أدوات استخراج الويب لأنه يركز على فهم الصفحات والكيانات، لا مجرد جمع الحقول. تقنيته في الاستخراج تصنف الصفحات، تحدد الكيانات المهيكلة، وتربط بيانات الويب بـ Knowledge Graph أوسع، وهو ما يكون مفيدًا عندما يكون الهدف معلومات مُغنية ومُعالجة بدلاً من صفوف سحب خام.
هذا يجعل Diffbot ذا صلة خاصة للفرق التي تعمل على ذكاء الكيانات، بيانات الشركات والأشخاص، أبحاث السوق، Knowledge Graphs، مراقبة الإعلام، وأنظمة الذكاء الاصطناعي التي تحتاج إلى حقائق مُهيكلة من الويب المفتوح. هو أقل أداة سحب بنقرة واحدة وأكثر طبقة استخراج ومعرفة على مستوى الويب.
السؤال الأساسي للشراء هو ما إذا كان نموذج بيانات Diffbot يتطابق مع الكيانات والعلاقات التي يحتاجها المشروع. عندما يتطابق، يمكن للفرق تجنب بناء محللات صفحات مخصصة وخطوط إثراء من الصفر. عندما لا يتطابق، قد توفر أداة سحب تقليدية تحكمًا مباشرًا أكثر. يجب أن تشمل التقييمات صفحات تمثيلية، تغطية الحقول، تواتر التحديث، حل الكيانات، وكيفية الحفاظ على المصدر في المراحل اللاحقة.
الإيجابيات والسلبيات
- استخراج تلقائي قوي وفهم للكيانات
- الوصول إلى Knowledge Graph يضيف سياقًا يتجاوز الصفحة الواحدة
- مفيد للتغذية، البحث، وسير عمل الذكاء الاصطناعي المهيكلة
- ملاءمة جيدة عندما تكون الكيانات المُعالجة أكثر أهمية من جداول الصفحات الخام
- أقل بديهية للاستخراج على نمط الجداول البسيطة
- أفضل النتائج تعتمد على مدى توافق نماذج Diffbot مع نوع المحتوى المستهدف
- الفرق بحاجة إلى فهم Knowledge Graph ونموذج API لتحقيق القيمة الكاملة
10. ScrapeGraphAI
ScrapeGraphAI مصمم للمستخدمين الذين يرغبون في وصف البيانات المطلوبة بلغة طبيعية والحصول على مخرجات منظمة. بدلاً من كتابة محددات لكل حقل، يمكن للفرق تقديم URL، تحديد المعلومات المطلوبة، واستخدام استخراج مدعوم بالذكاء الاصطناعي لإرجاع JSON نظيف للتطبيقات، سير عمل البحث، أو الوكلاء.
إنه ملاءم للمطورين الذين يبنون سير عمل ذكائي حول بيانات الويب، خاصة عندما يتغير مهمة الاستخراج بشكل متكرر أو تحتاج إلى الارتباط بأطر مثل LangChain، CrewAI، SDKs، أدوات سطر الأوامر، أو بيئات مدعومة بـ MCP. الميزة الرئيسية هي المرونة: يمكن أن يكون منطق الاستخراج مدفوعًا بالمطالبة بدلاً من الاعتماد كليًا على محددات الصفحات الهشة.
تجعل هذه المرونة التحقق أمرًا مهمًا للغاية. يجب على الفرق تعريف مخططات، سلوك إعادة المحاولة، حقول الأدلة، وقواعد مراجعة عينات قبل الاستخدام الإنتاجي، لأن الإجابة المعقولة ليست بالضرورة استخراجًا كاملًا. ScrapeGraphAI جذاب للتجارب وسير عمل متكيّف، بينما قد تستفيد الوظائف ذات الحجم العالي والثبات من محددات حتمية أو نهج هجين يستخدم الذكاء الاصطناعي فقط عندما يختلف هيكل الصفحة.
الإيجابيات والسلبيات
- استخراج بلغة طبيعية مفيد للمهام المتغيرة أو الاستكشافية
- إخراج JSON منظم يتناسب مع تطبيقات الذكاء الاصطناعي وسير الأتمتة
- تكاملات المطورين تدعم حالات استخدام الوكلاء والتنسيق
- مفيد عندما يكون صيانة المحددات عائقًا أمام التجريب
- يجب التحقق من استخراج الذكاء الاصطناعي قبل الاستخدام الإنتاجي
- تصميم المطالبة والمخططات يؤثران على اتساق المخرجات
- أقل ملاءمة للفرق التي تحتاج إلى سير عمل بصري كامل بدون كود
أسئلة شائعة
ما الذي يجعل أداة استخراج الويب مدعومة بالذكاء الاصطناعي؟
عادةً ما تساعد أدوات السحب المدعومة بالذكاء الاصطناعي في واحدة أو أكثر من أربع مهام: تحديد الحقول على الصفحة، تحويل محتوى الصفحة إلى بيانات منظمة، التحكم في المتصفح عبر تعليمات بلغة طبيعية، أو إعداد المحتوى المستخرج للأنظمة الذكائية. لا تزال الأدوات الأفضل تحتاج إلى توجيهات واضحة، مخططات، تحقق، وقواعد حول ما يجب جمعه.
ما الفرق بين السحب وأتمتة المتصفح؟
يركز السحب على استخراج البيانات من الصفحات. تتحكم أتمتة المتصفح في المتصفح للنقر، التمرير، تسجيل الدخول، ملء النماذج، الانتظار للمحتوى الديناميكي، أو الانتقال عبر سير عمل متعدد الخطوات. تجمع العديد من الأدوات الحديثة بين الاثنين، لكن التمييز مهم: قائمة منتجات ثابتة هي مهمة سحب، بينما سير عمل يتطلب تنقلًا وتفاعلًا قد يحتاج إلى أتمتة المتصفح.
أي صيغة إخراج هي الأفضل لنظام RAG؟
عادةً ما تعمل أنظمة الاسترجاع المدعومة بالتوليد بشكل أفضل مع نص نظيف، Markdown، JSON منظم، بيانات وصفية، وروابط مصدر ثابتة. الهدف ليس فقط جمع المحتوى بل الحفاظ على بنية كافية للتجزئة، الاسترجاع، الاستشهاد، وفحوص الجودة. يمكن أن يكون HTML الخام مفيدًا، لكنه غالبًا ما يخلق عمل تنظيف إضافي قبل أن يصبح البيانات صالحة لتطبيق ذكائي.
هل يمكن لأدوات السحب الذكائية التعامل مع مواقع جافاسكريبت؟
العديد منها يمكنه ذلك، لكن الجودة تعتمد على المنتج. بعض الأدوات تقدم تقديم الصفحات في متصفح، بعضها يستخدم بنية متصفح بدون رأس، والبعض الآخر يعتمد على استخراج بعد تحميل الصفحة. دعم جافاسكريبت مهم للتجارة الإلكترونية، الأسواق، المنصات الاجتماعية، لوحات التحكم، وتطبيقات الويب الحديثة حيث تظهر البيانات المفيدة بعد الاستجابة الأولية للصفحة.
هل أدوات السحب بدون كود مناسبة للمشاريع الكبيرة؟
يمكن لأدوات السحب بدون كود أن تكون ممتازة لسير عمل تجاري متكرر، مراقبة المنافسين، بحث العملاء المحتملين، ومهام العمليات. قد تحتاج البرامج الأكبر في النهاية إلى APIs، قوائم انتظار، مراقبة، بنية وكيل، تحكم بالإصدار، تحقق من البيانات، وملكية هندسية. تكون الأدوات بدون كود الأقوى عندما يكون سير العمل واضحًا والفريق يريد السرعة دون بناء ساحب مخصص.
هل استخراج الويب قانوني؟
قانون استخراج الويب يختلف حسب الولاية القضائية، الموقع المستهدف، نوع البيانات، طريقة الوصول، وكيفية استخدام البيانات. لا يزال جمع بيانات الويب العامة قد يثير قضايا تعاقدية، خصوصية، ملكية فكرية، أمن سيبراني، وسياسات المنصات. يجب على الفرق مراجعة القوانين المعمول بها، robots.txt والشروط ذات الصلة، سياسات الامتثال الداخلية، وحساسية البيانات قبل تشغيل برنامج سحب.
هل يجب التحقق من نتائج الاستخراج التي يولدها الذكاء الاصطناعي؟
نعم. يمكن للذكاء الاصطناعي أن يجعل السحب أكثر مرونة، لكنه قد يخطئ في قراءة الصفحات، دمج الحقول، إغفال السياق المخفي، أو إرجاع هياكل غير متسقة عندما تتغير التخطيطات. يجب أن تشمل سير العمل الإنتاجية فحوص المخططات، مراجعات عينات، تنبيهات تغيير، معالجة أخطاء، ومراجعة بشرية للقرارات الحساسة.
أفكار ختامية حول أدوات استخراج ويب بالذكاء الاصطناعي
Bright Data هو الاختيار الأقوى بشكل عام للفرق التي تحتاج إلى بنية تحتية جادة وبرامج بيانات عامة ضخمة. Firecrawl هو الأنسب لتطبيقات الذكاء الاصطناعي التي تحتاج إلى سياق ويب جاهز للـ LLM، بينما Apify يمنح المطورين منصة مرنة للسحابات المخصصة، الـ Actors، وأتمتة المتصفح.
للفرق التجارية، تجعل Browse AI وOctoparse جمع البيانات المتكرر أكثر سهولة دون الحاجة إلى تحويل كل سير عمل إلى مشروع هندسي. ScrapingBee هو API صديق للمطورين لاستخراج بلغة طبيعية، تقديم جافاسكريبت، وإخراج منظم دون صيانة المتصفح والوكيل.
SearchAPI يبرز عندما يكون المتطلب هو بيانات محرك بحث حديثة، منظمة، للـ SEO، البحث، أو الوكلاء الذكائيين بدلاً من زحف مواقع عشوائية. Oxylabs هو الأفضل لواجهات برمجة تطبيقات سحب مؤسسية ومواقع عامة صعبة، Diffbot جذاب عندما تكون استخراج الكيانات وسياق Knowledge Graph مهمين، وScrapeGraphAI خيار استخراج مرن قائم على المطالبة لسير عمل الذكاء الاصطناعي.




