
مقابلات
بن كوسكا، المؤسس والرئيس التنفيذي لشركة SF Tensor – سلسلة المقابلات

 أضف Unite.AI إلى مصادرك المفضلة على Google
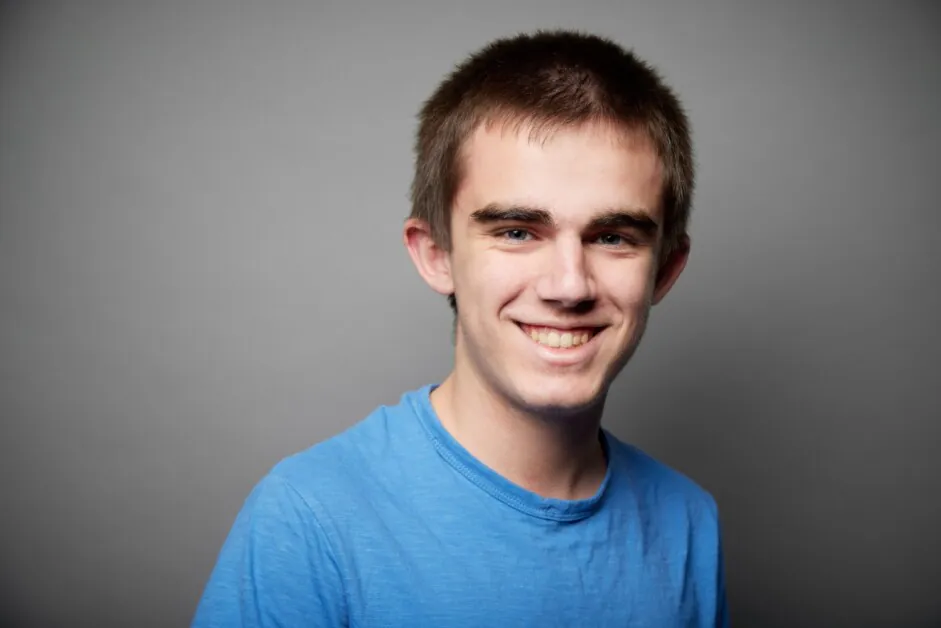
بن كوسكا، المؤسس والرئيس التنفيذي لشركة SF Tensor، هو باحث في مجال الذكاء الاصطناعي ومهندس أنظمة معروف بعمله على الحوسبة عالية الأداء وتحسين النواة وتنمية النماذج الكفية. يمتد خلفيته إلى تطوير البنية التحتية للذكاء الاصطناعي منخفضة المستوى، وتحسين إنتاجية التدريب، وتصميم أدوات تجعل تطوير النماذج المتقدمة ميسوراً دون الحاجة إلى هندسة ثقيلة. يركز على بناء أنظمة تدفع حدود السرعة والتنقل والموثوقية عبر الأجهزة المتنوعة.
SF Tensor هي الشركة التي يقودها لتحويل هذه الفلسفة إلى منصة عملية. تقدم نموذج برمجة موحد، ومحسن نواة، وطبقة تنسيق متعددة السحابة مصممة لإزالة تعقيدات حمولات الذكاء الاصطناعي الموزعة. تهدف المنصة إلى تقديم بيئة نظيفة ومستقلة عن الأجهزة للمهندسين، حيث يمكنهم كتابة البرامج مرة واحدة ونشرها في أي مكان وتحقيق الأداء العالي تلقائياً. تتمثل مهمة SF Tensor في جعل حوسبة الذكاء الاصطناعي أسرع بكثير وأسهل في الإدارة ومستقلة عن تكنولوجيا البائع.
لقد أسست شركة SF Tensor في سن التاسعة عشر بعد قيادة الهندسة في عدة شركات ناشئة. ما هو ما دفعك لتحمل تحدي إعادة اختراع بنية تحتية للذكاء الاصطناعي في هذه المرحلة المبكرة من مسيرتك المهنية؟
المشكلة التي نحلها هي مشكلة أحبها كثيراً، لأنها مشكلة واجهتها بنفسي. عندما طورنا ما يُعرف الآن باسم حزمة SF Tensor الأساسية، لم نكن نعمل على مشروع تجاري، بل كان مشروعاً أكاديمياً. تلقينا منحة لconducting بعض الأبحاث المثيرة للاهتمام، ولكننا قضينا معظم وقتنا في التعامل مع البنية التحتية والتحسينات، بدلاً من القيام بالأبحاث. وجدنا أن الناس مهتمون بشكل عام بأدواتنا التكنولوجية أكثر من مشروعنا البحثي.
تتناول شركة SF Tensor واحدة من أصعب المشاكل في مجال الذكاء الاصطناعي – كسر هيمنة NVIDIA على تكنولوجيا CUDA. كيف قمت بتصميم نظام يمكن أن يحقق قابلية النقل الحقيقية للأجهزة دون المساس بالأداء؟
في النهاية، يعود كل شيء في مجال الذكاء الاصطناعي إلى الرياضيات البسيطة. كل نموذج هو في الأساس مجموعة من العمليات الرياضية التي نحتاج إلى حساب النتائج لها. من خلال معاملتها بشكل رئيسي كمشكلة رياضية بدلاً من مشكلة علوم الحاسوب، يمكننا تحديد أصغر مجموعة من القيود على الحسابات، ثم توليد ملايين إلى مليارات الطرق المختلفة لتحويل هذه الحسابات إلى كود آلة، وfinding أسرعها. هذا أسهل مما يبدو، لأننا لا نستطيع تشغيل مليارات البرامج المختلفة لfinding أسرعها، لذلك لتقليص مساحة البحث، كان علينا أن ن nghĩ إلى نموذج رياضي دقيق لتقدير سرعة برنامج معين على جهاز معين، وهو أحد الابتكارات الأساسية التي تجعل ما نقوم به ممكناً اليوم.
يبرز مدونة الشركة حول الابتكارات حول تحسين المترجمات وتنسيق متعددة السحابة. هل يمكنك أن توضح كيف يختلف نهج SF Tensor عن الإطارات الحالية مثل PyTorch أو JAX؟
لم نكتب بعد مقالاً تقنياً حول هذا الموضوع، ولكننا ندعم في الواقع إطارات مثل PyTorch وJAX، مما يسمح للبرامج المكتوبة بهذه الإطارات بالتحسين بواسطة حزمتنا. هناك بعض القرارات الهندسية التي اتخذتها JAX وPyTorch تختلف عن نهجنا، وأهمها أننا نعتبر النموذج كله كحساب واحد يجب حله، بدلاً من وحدات منفصلة يجب تحسينها بشكل فردي ثم مشترك. لذلك، بدلاً من تطبيق تقنيات تحسين المترجمات التقليدية ومحاولة تطبيق كل تحسين فردي، نقوم بإنشاء مساحة بحث من ملايين إلى مليارات من النوى المحتملة، ونزعم أنه لا يمكن لأي إنسان أن ي nghĩ إلى مجموعة من القواعد لتحويل أي كود إلى أسرع كود، لذلك يجب علينا إنشاء كل组ات ممکنة ثم تحديد أسرعها.
许多 الشركات الناشئة تركز على كفاءة التدريب، ولكنك شددت على “ضريبة البنية التحتية” – الوقت الذي يفقده الباحثون في إدارة الحواسيب بدلاً من الابتكار. كيف تتناول شركة SF Tensor هذا الخلل؟
نعتقد أن كلا المشكلتين يجب معالجتهما، ويتضمن الكثير من عملنا معالجة كفاءة التدريب، ولكن أكثر المشاكل الحادة التي يمكننا حلها الآن دون أن نعتمد على أي ابتكارات مستقبلية هي “ضريبة البنية التحتية” لأنها مشكلة حلناها بالفعل لنفسنا.
لقد ذكرت تحقيق تخفيضات تصل إلى 80% في تكاليف التدريب. ما هي التحسينات أو الابتكارات المعمارية التي تجعل ذلك ممكناً؟
تم بناء كل برنامجنا على فكرة أن مترجم البحث دائمًا يغلب القواعد المصممة من قبل الإنسان. حتى الآن، كان أكبر تقييد على هذه المترجمات هو حقيقة أن من غير الممكن اختبار وترتيب ملايين أو حتى مليارات النوى. لذلك، كان علينا إنشاء نموذج رياضي للحوسبة يمكنه تقدير دقة الوقت الذي سيستغرقه حساب معين أو مجموعة حسابات على جهاز معين. من خلال القيام بذلك، يمكننا توسيع مساحة البحث ثم تقليصها، وهو أمر ضروري إذا كنت تريد العثور على أسرع النوى بشكل متسق.
كيف يؤثر خلفك في بناء لغة برمجة Emma على هيكل ونهج شركة SF Tensor تجاه الأداء والاستبعاد؟
لا تخبر مستثمري، ولكن في جوهر الأمر، أنا لا أزال مهندس مترجم. لقد كنت دائمًا مهتمًا بالعثور على طرق مختلفة لجعل الأشياء أسرع حتى لو كان ذلك بمقدار صغير. في تطوير Emma، قمنا بإلغاء المترجم بأكمله 4 أو 5 مرات؛ بدأنا من الصفر، كل مرة لأننا واجهنا تحسينًا لا يمكننا تنفيذه مع القيود الحالية، مما أجبَرنا على إعادة هندسة النظام ليكون أكثر عمومية، مع السماح لنا بالوصول إلى أدنى مستوى من التحسين عند الحاجة، غالبًا ما يتعارض مع المبادئ الشائعة لتصميم المترجمات واللغات. تلك المعرفة والهيكل الناتج اكتسبوا ما يقرب من عامين من التحسينات الصغيرة والمراكز الخاطئة التي تجمعت في نظام يسمح لنا الآن بالتكرار بشكل أسرع وتحسين الأداء بشكل أفضل من أي نظام اتبع المبادئ الشائعة لأن تلك المبادئ مصممة بشكل أساسي للأجهزة، وليس لنمذجة الذكاء الاصطناعي.
لقد عملت على تشغيلات تدريب كبيرة على أكثر من 4000 جهاز رسومات — ما هي أكبر الدروس المستفادة من إدارة الحواسيب على هذا النطاق؟
دروس كبيرة هي أن فشل الأجهزة أكثر شيوعًا ومشكلة أكثر مما قد يُفترض. بعد قضاء الكثير من الوقت في العمل مع البرامج التقليدية والمترجمات، يفعل الحاسوب عادة ما يُقال له، وإذا حدث خطأ، فإنه عادة ما يكون خطأ الشخص الذي كتب الكود. ومع ذلك، فشل الأجهزة هو حدث شائع، خاصة في تدريبات موزعة على مجموعات كبيرة. يأتي مع ذلك حقيقة أن الأجهزة لا تتصرف دائمًا بطريقة محددة ومتنبئة، و đôi مرة تقلل من سرعة الساعة بدون سبب واضح، مما يبطئ عملية التدريب بسبب بطء شريحة واحدة.
دعمت Y Combinator بعض الشركات التأسيسية الأكثر تحولاً في مجال البنية التحتية للتكنولوجيا. كيف غيرت هذه التجربة نهجك لتوسيع منتج وتصور شركة SF Tensor؟
عندما دخلت Y Combinator، كنت أفكر أن الرهان الذي نريد أن نراه كان طموحًا. بعد بضعة أسابيع، تغير تعريفنا للطموح بشكل كبير، وزدنا الرهان على رهان أكبر. بالإضافة إلى ذلك، فإن الشعور بال社区 والتعلم الذي يمكنني من خلاله الاتصال بأي شركة أو شخص هناك و الحصول على استجابة و نصيحة في غضون ساعات أو أيام، قد غير الطريقة التي نفكر بها في حل المشاكل واعتماد نهج أكثر تعاونًا.
في المستقبل، لقد أعربت عن اهتمامك بالموديلات غير LLM، والروبوتات، والبيانات الاصطناعية. كيف تتناسب هذه المجالات مع رؤيتك الطويلة الأجل للشركة؟
النموذج LLM هو تكنولوجيا مثيرة للاهتمام وسيكون لها دور أساسي في كيفية شكل العالم في المستقبل، ولكن السبب في أن هذه التكنولوجيا متقدمة أكثر من أي مجال آخر في الذكاء الاصطناعي يعود إلى حقيقة أن هناك الكثير من الأموال التي تستثمر في تطويرها، وهناك الكثير من الأشخاص الذين يتعاونون على حل هذه المشكلة، لذلك أصبحوا محسّنًا بشكل جيد. إذا استطعنا خفض حواجز الدخول، وسمحنا للباحثين في جميع أنحاء البلاد والكوكب، حتى أولئك الذين لديهم موارد محدودة وقليلة أو لا يعرفون الكثير عن التحسينات، بإجراء أبحاثهم بأقل تكلفة وفعالية ممكنة، أعتقد أننا سوف نرى جيلًا جديدًا من النماذج التي ستظهر والتي ستتناول مشاكل لا تصلحها النماذج LLM، سواء لأنها تتفاعل مع العالم الفعلي أو لأنها مشاكل لا يمكن التعبير عنها بشكل صحيح باللغة.
ما رأيك فيما ستبدو عليه بنية تحتية للذكاء الاصطناعي بعد خمس سنوات – وأين ترى دور شركة SF Tensor فيها؟
خمس سنوات من الآن، آمل أن تكون العديد من الشركات قد طورت وطرحت شرائحها المخصصة، وأن الباحثين سوف يستطيعون استغلال هذه الشرائح و استخدامها دون الحاجة إلى كتابة كود خاص بهم، ويفضل أن لا يحتاجوا حتى إلى معرفة وجودهم. هذا هو المستقبل الذي نعمل نحوه، وأعتقد أننا سوف نلعب دورًا هامًا في تشكيله.
شكراً على المقابلة الرائعة، القراء الذين يرغبون في معرفة المزيد يمكنهم زيارة SF Tensor.


