
نماذج ومنصات الذكاء الاصطناعي
ASUS تكشف عن الخادم XA P2N-E2 المزود بمعالجي NVIDIA Vera في OCP

 أضف Unite.AI إلى مصادرك المفضلة على Google
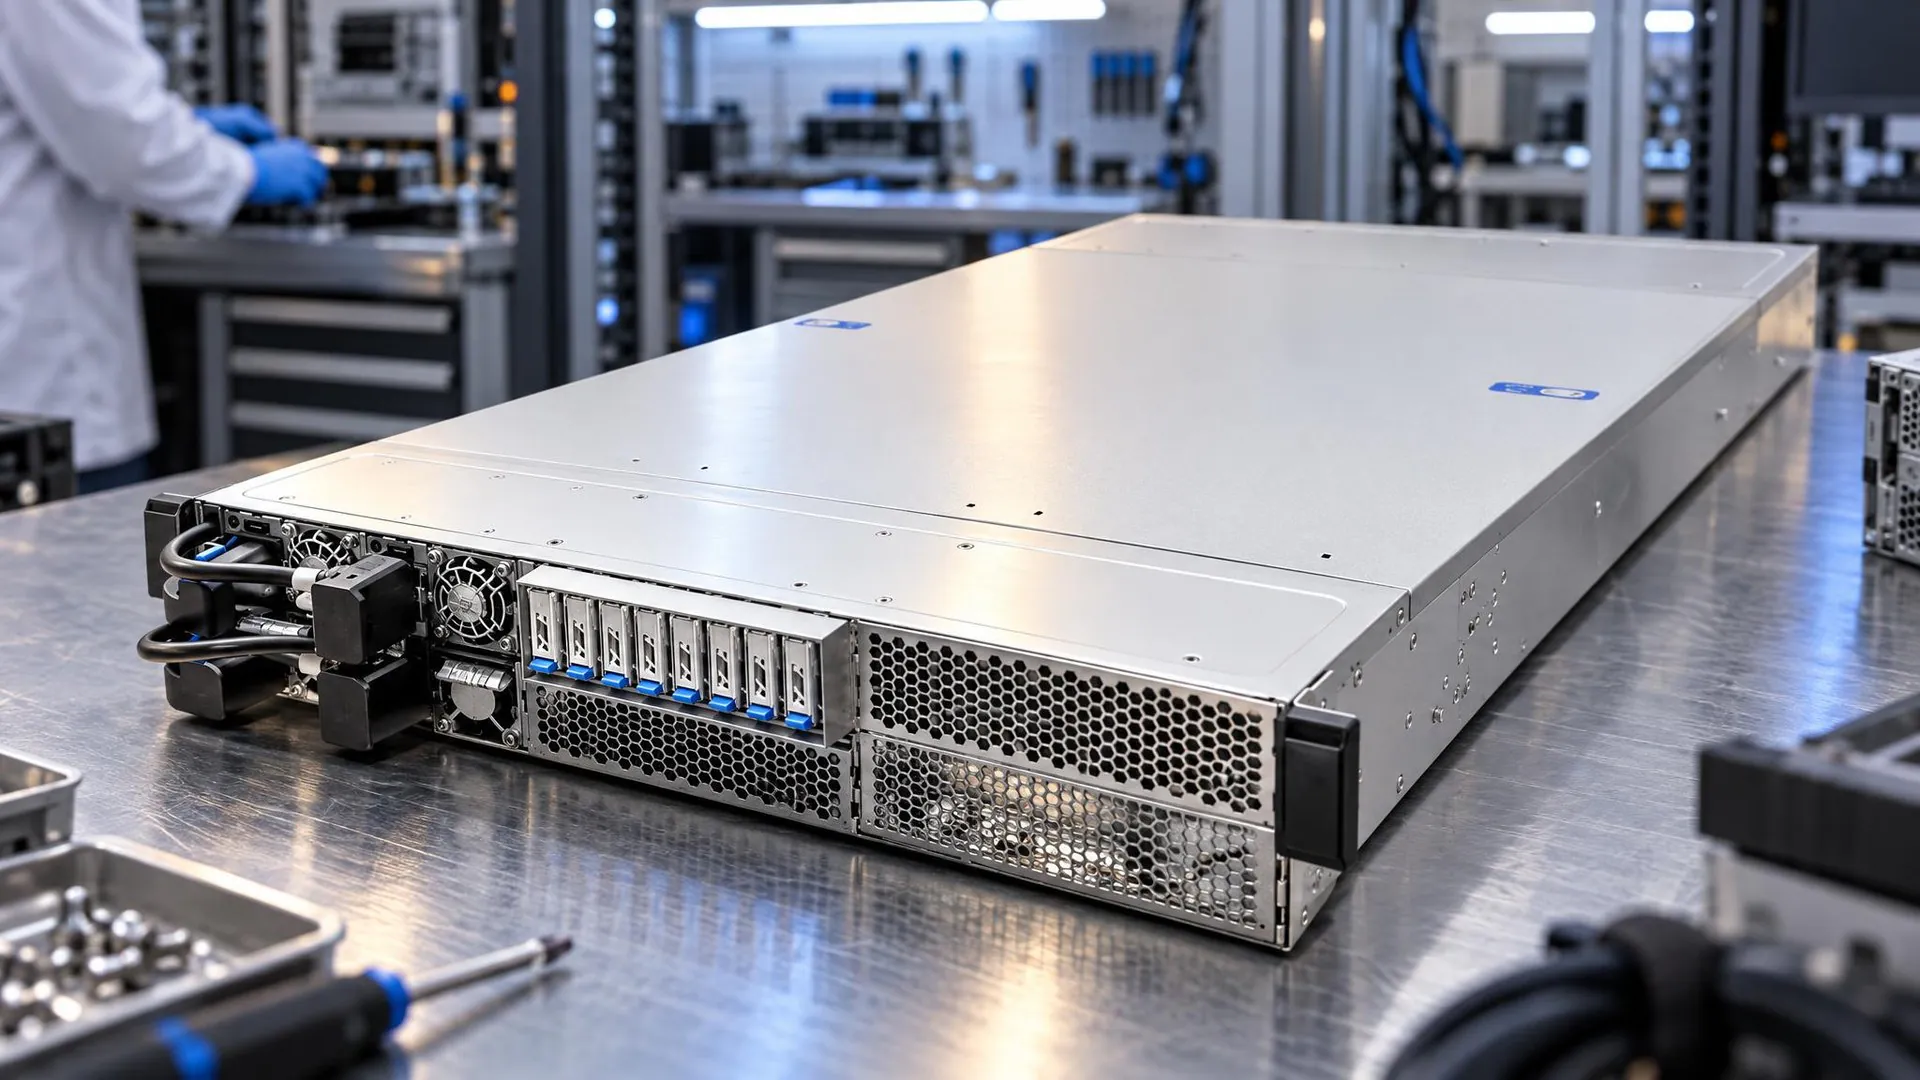
كشفت ASUS عن XA P2N-E2، وهو خادم بارتفاع 2U مبني على بنية NVIDIA MGX ويعمل بمعالجي NVIDIA Vera، خلال قمة OCP العالمية 2026 في سان خوسيه، كاليفورنيا، في 12 أكتوبر 2026. وقالت الشركة في بيان صحفي إن النظام مصمم لأعباء عمل الذكاء الاصطناعي الوكيل والتعلم المعزز.
وفقًا للبيان، يستهدف الخادم طبقة التنفيذ في تطبيقات الذكاء الاصطناعي، ويتولى تنفيذ التعليمات البرمجية واستخدام الأدوات والعزل في بيئات محمية ومعالجة البيانات والتنسيق؛ وهي مهام تتجاوز نطاق نموذج الذكاء الاصطناعي نفسه. ويدعم XA P2N-E2 ما يصل إلى وحدتي معالجة رسوميات NVIDIA RTX PRO 6000 Blackwell Server Edition، تشغل كل منهما شقين، ليجمع بين الحوسبة باستخدام وحدة المعالجة المركزية وتسريع وحدة معالجة الرسوميات ضمن منصة بارتفاع 2U. وقالت ASUS إن أداء النظام في معالجة خيط واحد، إلى جانب ذاكرته ذات النطاق الترددي العالي والموفرة للطاقة، يهدف إلى إبقاء وكلاء الذكاء الاصطناعي سريعي الاستجابة أثناء مهام التنفيذ والتقييم الشاقة.
معالجا Vera في هيكل بارتفاع 2U ومبرّد بالهواء
تسرد صفحة المنتج XA P2N-E2، التي تحمل وسم «جديد»، معالجي NVIDIA Vera، يضم كل منهما 88 نواة Olympus مخصصة، مع تعدد الخيوط المكاني، لتوفير 176 خيطًا، وبقدرة تصميم حراري تصل إلى 480 واط لكل مقبس. وتصف ASUS معالج Vera بأنه أول وحدة معالجة مركزية مصممة خصيصًا لوكلاء الذكاء الاصطناعي: فوفق سير العمل الذي تحدده ASUS، تتولى وحدة المعالجة المركزية تنفيذ التعليمات البرمجية في بيئة معزولة، واستخدام الأدوات، والتنسيق، ومعالجة البيانات، بينما تُخصص وحدات معالجة الرسوميات للتدريب والاستدلال.
يوفر الجيل الثاني من NVIDIA NVLink-C2C اتصالًا متماسكًا بين وحدات المعالجة المركزية يصل نطاقه الترددي إلى 1.8 تيرابايت/ثانية، فيما يصل نطاق التردد بين النوى إلى 3.4 تيرابايت/ثانية، وفقًا لصفحة المنتج. وتتألف الذاكرة من 16 وحدة SOCAMM2 تستخدم LPDDR5X بسرعة 9600 ميغاترود/ثانية، بسعة تصل إلى 1.5 تيرابايت. وتقول ASUS إن هذا التكوين يوفر كفاءة في استهلاك الطاقة تصل إلى ضعفي كفاءة ذاكرة RDIMM التقليدية، ويخفض استهلاك الذاكرة للطاقة بنسبة 50%.
يتضمن التخزين ثمانية مواضع لمحركات E1.S قابلة للاستبدال أثناء التشغيل، كما يضم التوسّع شقين PCIe Gen6 x16، بالإضافة إلى شق مخصص مزدوج لوحدة معالجة بيانات/بطاقة واجهة شبكة (DPU/NIC). ويعتمد الهيكل، المبرد بالكامل بالهواء، تدفقًا للهواء من الأمام إلى الخلف عبر مناطق المعالج والذاكرة ووحدة معالجة الرسوميات، مع مزودَي طاقة احتياطيين بقدرة 2000 واط لكل منهما، بتكوين 2+2 وتصنيف 80 PLUS Titanium، ولا يتطلب بنية تحتية للتبريد السائل. ووفق التصميم المعياري MGX، يمكن صيانة وحدة المعالج المضيف وحجرة وحدة معالجة الرسوميات، التي تستوعب ما يصل إلى وحدتي RTX PRO 6000 Blackwell Server Edition تشغل كل منهما شقين وبقدرة تصل إلى 600 واط لكل وحدة، كلٌّ على حدة.
أربعة اختناقات عتادية تحددها ASUS في الذكاء الاصطناعي الوكيل
في رؤية نُشرت في 10 أغسطس 2026، حددت ASUS أربعة اختناقات عتادية قالت إنها تحد من نشر الذكاء الاصطناعي الوكيل: قصور أداء الخيط الواحد عند التوسع، وعدم كفاية نطاق التردد للذاكرة لكل نواة، وزمن استجابة الوصول إلى البيانات عبر القوالب، وغياب العزل على مستوى العتاد للبيئات المحمية. وقالت الشركة إن XA P2N-E2 يعالج المشكلة الأخيرة من خلال عزل عتادي للبيئة المحمية عند تنفيذ وكلاء الذكاء الاصطناعي للتعليمات البرمجية، وعزت إلى معالج Vera أداءً للخيط الواحد يصل إلى 1.8 مرة أداء معالجات x86 التقليدية، وتنفيذًا للتعليمات البرمجية في بيئة معزولة بسرعة تبلغ 1.8 مرة سرعة البنية التحتية التقليدية القائمة على x86، وسير عمل للبرمجة أسرع بما يصل إلى 1.5 مرة. وربطت ASUS هذه الأرقام بتصميم معالج Vera ذي 88 نواة، ونطاق تردد ذاكرة LPDDR5X يصل إلى 1.2 تيرابايت/ثانية، ونطاق تردد للربط الداخلي يبلغ 3.4 تيرابايت/ثانية.
وكانت ASUS قد وصفت XA P2N-E2 في رؤية أغسطس تلك بأنه أُطلق إلى جانب خوادمها القائمة على معالجات AMD EPYC 9006، وهي سلاسل RS700A-E14B وRS720A-E14B وXA P8A-E14A. وبالنسبة إلى هذه الأنظمة، أشارت ASUS إلى ما يصل إلى 256 نواة لكل مقبس، وأداء إجمالي أعلى بنحو 70% مقارنة بالجيل السابق، مع ذاكرة DDR5 ذات 16 قناة توفر نطاق تردد يقارب 1.6 تيرابايت/ثانية.
أنظمة على مستوى الرف وتقنيات منصات NVIDIA
إلى جانب الخادم بارتفاع 2U، تعرض ASUS أيضًا أنظمة على مستوى الرف في OCP. ويجمع نظام XA VR721-E3 ASUS AI POD بين 36 معالج NVIDIA Vera و72 وحدة معالجة رسوميات NVIDIA Rubin عبر منصة NVIDIA Vera Rubin NVL72، ضمن بنية مبردة بالكامل بالسائل ومخصصة لتدريب الذكاء الاصطناعي على نطاق واسع، والتدريب اللاحق، والاستدلال. أما XR R1I12B-M1BHFS فيجمع بين NVIDIA HGX Rubin NVL8 والتبريد السائل المباشر لشريحة قاعدة وحدة معالجة الرسوميات، والتبريد بالهواء لمعالجات Intel Xeon 6.
وأشارت ASUS أيضًا إلى التصميم المرجعي NVIDIA DSX ومخطط NVIDIA Omniverse DSX، وقالت إنهما يجمعان بين بنية معتمدة ومحاكاة عالية الدقة لإنشاء توائم رقمية دقيقة ماديًا، بهدف تحسين تصميم مصانع الذكاء الاصطناعي وعملياتها قبل نشرها. وتعرض ASUS في جناحها أربع تقنيات من NVIDIA: الحوسبة المسرّعة HGX Rubin NVL8، ومبدلات Ethernet من Spectrum-X القائمة على Spectrum-6، ومنصة تخزين الذاكرة السياقية CMX، ومسرّع الاستدلال Groq 3 LPX لمنصة Vera Rubin NVL72، الذي يصفه البيان بأنه يوسع منصة NVL72 بإتاحة توليد فائق السرعة للرموز، بما يوفر استدلالًا عالي الاستجابة.
أنظمة تستعرضها Intel وAMD
يشمل عرض Intel الطرازين RS700-E12-RS4U وRS720-E12-RS12U، وهما خادمان بارتفاع 1U و2U، لكل منهما مقبسان، ويعملان بمعالجات Intel Xeon 6، مع تصميمات DC-MHS وإمكانية صيانة دون أدوات، ويستهدفان الذكاء الاصطناعي الوكيل والمحاكاة الافتراضية وأعباء العمل كثيفة البيانات. أما عرض AMD فيقدم RS700A-E14B-R16U، وهو نظام بارتفاع 1U ومقبسين، مبني على معالجات الجيل السادس من سلسلة AMD EPYC 9006، التي تحمل الاسم الرمزي «Venice». ويجمع النظام بين بنية DC-MHS واتصال PCIe 6.0 ودعم ما يصل إلى 16 محرك E3.S، فيما توفر ASUS Thermal Radar 3.0 مراقبة درجات الحرارة وإدارتها.
لدعم تطبيقات الذكاء الاصطناعي المُسرَّعة، يدعم ESC8000A-E13P مسرّعات AMD Instinct MI350P PCIe، بينما يدمج XA AM3A-E13 ثمانية مسرّعات AMD Instinct MI355X في تصميم مُبرّد بالهواء بارتفاع 10U، وقالت ASUS إن ذلك يتيح نشر أنظمة عالية الكثافة من دون بنية تحتية مخصصة للمياه المبردة. وتُعرض المجموعة الكاملة في جناح ASUS رقم #B9 خلال قمة OCP العالمية لعام 2026، وقالت ASUS إن خوادمها متاحة في جميع أنحاء العالم، مع اختلاف مدى توافر المنتجات والتكوينات الفردية حسب المنطقة.


