
Nền tảng AI
Cross-Validation là gì? Cách ước tính hiệu suất mô hình một cách đáng tin cậy
Cross-validation liên tục xoay vòng các phần dữ liệu giữ lại để các nhóm có thể ước lượng hiệu suất và độ biến thiên khi một lần chia xác thực sẽ không ổn định. Hướng dẫn này giải thích cơ chế, các đánh đổi, cách đánh giá và các kiểm soát quan trọng trong thực tiễn.

 Thêm Unite.AI vào các nguồn ưu tiên của bạn trên Google
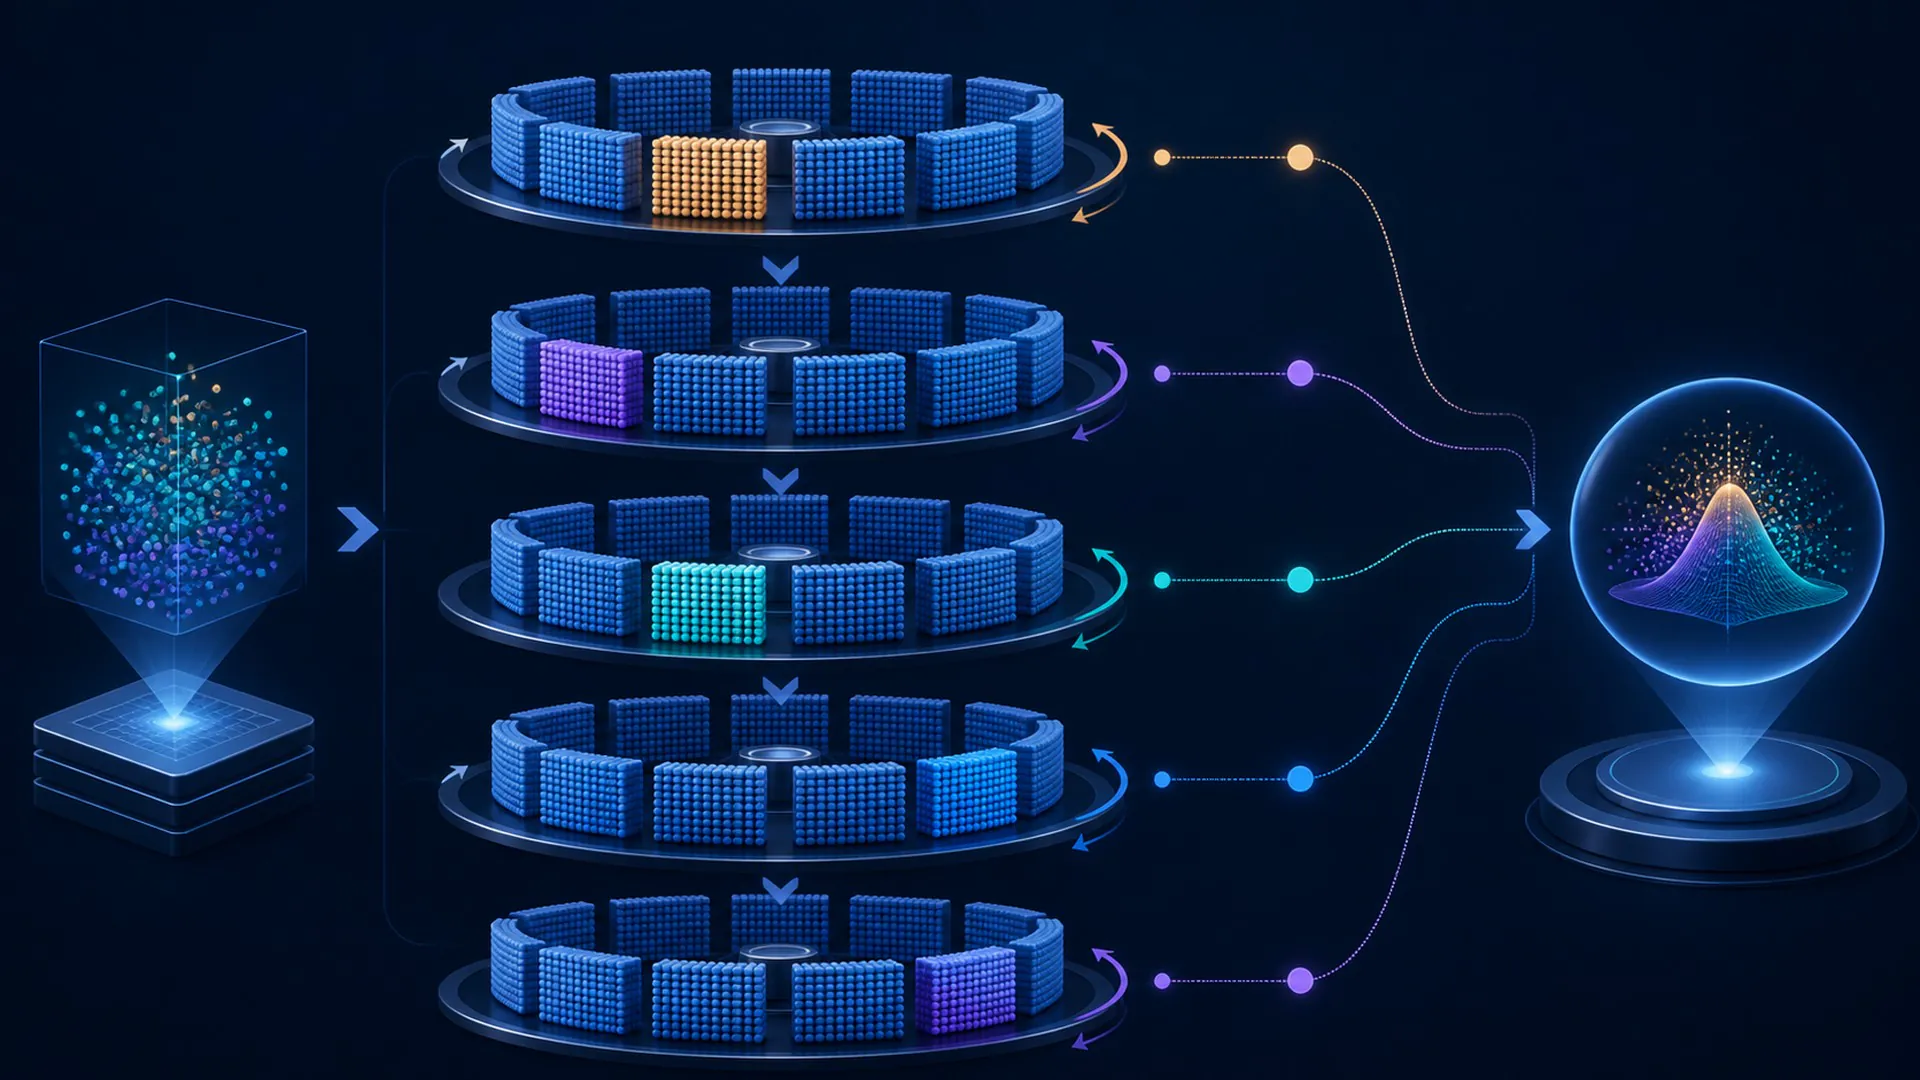
Cross-validation lặp đi lặp lại việc xoay vòng các nếp gấp được giữ lại để các nhóm có thể ước lượng hiệu suất và độ biến động khi một lần chia validation duy nhất sẽ không ổn định.
Cross-validation xứng đáng được giải thích một cách chính xác vì tên gọi của nó chỉ ra một luồng thông tin, lựa chọn đào tạo, cơ chế thời gian chạy hoặc ranh giới quản trị cụ thể. Việc coi nó như một đồng nghĩa với “AI tiên tiến” khiến các tuyên bố không thể kiểm chứng. Hướng dẫn này theo dõi khái niệm từ đầu vào và giả định của nó tới kết quả có thể quan sát được, sau đó kiểm tra lối tắt có khả năng bị nhầm lẫn nhất với nó.
Cross-Validation: Định nghĩa, Ranh giới và Mục đích
Cross-validation lặp đi lặp lại việc xoay vòng các nếp gấp được giữ lại để các nhóm có thể ước lượng hiệu suất và độ biến động khi một lần chia validation duy nhất sẽ không ổn định. Định nghĩa bao gồm ba cam kết thực tiễn: có một đầu vào có thể xác định, một phép biến đổi hoặc quyết định đặc trưng của Cross-validation, và một kết quả có thể được đánh giá dựa trên mục tiêu đã nêu. Nếu một trong những yếu tố này thiếu, nhãn này có thể mô tả một khát vọng hơn là một cơ chế đã được triển khai.
Học thống kê chuyển các mẫu hữu hạn thành các khẳng định về dữ liệu tương lai. Do đó, việc chia tách, tối ưu hoá, chuẩn hoá, các chỉ số và giám sát đều là các phần của một vấn đề tổng quát hoá chứ không phải các kỹ thuật sách giáo khoa riêng lẻ. Đối với Cross-validation, quan điểm hệ thống này quan trọng vì hiệu suất có thể bị ảnh hưởng bởi dữ liệu xung quanh, giao diện, phần cứng, quyền truy cập và con người ngay cả khi mô hình nền tảng không thay đổi. Vì vậy, một lời giải thích hữu ích sẽ tách hành vi đã học của mô hình ra khỏi sản phẩm quyết định khi nào, ở đâu và với thẩm quyền nào hành vi đó được sử dụng.
Lối tắt gây hiểu lầm gần nhất là kiểm tra nhiều mô hình trên tập kiểm tra cuối cùng. Nó có thể chia sẻ một đặc điểm hiển thị với Cross-validation, nhưng lại thay đổi câu chuyện nguyên nhân: bằng chứng khác sẽ chứng minh thành công, nguồn lực khác sẽ chi phối chi phí, và các kiểm soát khác sẽ ngăn ngừa hại. Do đó, ranh giới ở đây là về mặt vận hành hơn là về thuật ngữ.
Bản đồ hoạt động năm giai đoạn của Cross-Validation
Sơ đồ là một bản đồ nguyên nhân ngắn gọn cho Cross-validation, không phải là khẳng định rằng mọi triển khai đều sử dụng năm thành phần phần mềm. Một số hệ thống kết hợp các giai đoạn và một số khác lặp lại chúng trong vòng lặp. Bản đồ vẫn hữu ích vì nó buộc mỗi thay đổi về thông tin hoặc thẩm quyền phải có người chịu trách nhiệm, một đầu vào, một đầu ra và một kiểm tra.
1. Phân chia dữ liệu thành các nếp gấp phù hợp: Đầu vào và Giả định trong Cross-Validation
Ở giai đoạn này của Cross-validation, hệ thống phải phân chia dữ liệu thành các nếp gấp phù hợp. Câu hỏi hữu ích không chỉ là liệu thao tác đó có xảy ra hay không, mà còn là thông tin nào nó tiêu thụ, trạng thái nào nó thay đổi, và bằng bằng chứng nào chứng minh sự thay đổi là hợp lệ. Người đánh giá nên có khả năng phân biệt thao tác này với việc kiểm tra nhiều mô hình trên tập kiểm tra cuối cùng và tái tạo kết quả của nó dưới cùng các điều kiện đã nêu.
Sự chuyển giao vào giai đoạn Cross-validation này bắt đầu bằng mục tiêu đã nêu và nên kết thúc bằng một kết quả có thể hỗ trợ việc huấn luyện trên tất cả trừ một nếp gấp. Ghi lại sự không chắc chắn, các lựa chọn bị loại bỏ, việc sử dụng tài nguyên, và bất kỳ kiểm soát nào của con người hoặc phần mềm được áp dụng tại ranh giới. Dấu vết này là nơi các nhóm có thể phát hiện liệu các nếp gấp ngẫu nhiên thông thường có vô hiệu khi dữ liệu có phụ thuộc về thời gian, nhóm hoặc không gian trước khi cùng một điểm yếu ảnh hưởng đến đầu ra quan trọng.
2. Huấn luyện trên tất cả trừ một nếp gấp: Đại diện hoặc Quyết định trong Cross-Validation
Ở giai đoạn này của Cross-validation, hệ thống phải huấn luyện trên tất cả trừ một nếp gấp. Câu hỏi hữu ích không chỉ là liệu thao tác đó có xảy ra hay không, mà còn là thông tin nào nó tiêu thụ, trạng thái nào nó thay đổi, và bằng bằng chứng nào chứng minh sự thay đổi là hợp lệ. Người đánh giá nên có khả năng phân biệt thao tác này với việc kiểm tra nhiều mô hình trên tập kiểm tra cuối cùng và tái tạo kết quả của nó dưới cùng các điều kiện đã nêu.
Sự chuyển giao vào giai đoạn Cross-validation này bắt đầu bằng việc phân chia dữ liệu thành các nếp gấp phù hợp và nên kết thúc bằng một kết quả có thể hỗ trợ việc đánh giá trên nếp gấp được giữ lại. Ghi lại sự không chắc chắn, các lựa chọn bị loại bỏ, việc sử dụng tài nguyên, và bất kỳ kiểm soát nào của con người hoặc phần mềm được áp dụng tại ranh giới. Dấu vết này là nơi các nhóm có thể phát hiện liệu các nếp gấp ngẫu nhiên thông thường có vô hiệu khi dữ liệu có phụ thuộc về thời gian, nhóm hoặc không gian trước khi cùng một điểm yếu ảnh hưởng đến đầu ra quan trọng.
3. Đánh giá trên tập dữ liệu giữ lại: Biến đổi đặc trưng trong Cross-Validation
Ở giai đoạn này của Cross-validation, hệ thống phải đánh giá trên tập dữ liệu giữ lại. Câu hỏi hữu ích không chỉ là liệu thao tác đó có xảy ra hay không, mà còn là nó tiêu thụ thông tin nào, thay đổi trạng thái nào, và bằng bằng chứng nào chứng minh sự thay đổi là hợp lệ. Người đánh giá cần có khả năng phân biệt thao tác này với việc thử nghiệm nhiều mô hình trên bộ kiểm tra cuối cùng và tái tạo kết quả của nó dưới cùng các điều kiện đã nêu.
Việc chuyển giao vào giai đoạn Cross-validation này bắt đầu bằng việc huấn luyện trên tất cả các fold ngoại trừ một và nên kết thúc bằng một kết quả có thể hỗ trợ việc quay vòng cho đến khi mọi fold đều đã được dùng làm validation. Ghi lại sự không chắc chắn, các lựa chọn bị loại bỏ, việc sử dụng tài nguyên, và bất kỳ kiểm soát nào của con người hoặc phần mềm được áp dụng tại ranh giới. Dấu vết đó là nơi các nhóm có thể phát hiện liệu các fold ngẫu nhiên thông thường có không hợp lệ khi dữ liệu có phụ thuộc về thời gian, nhóm hoặc không gian trước khi cùng một điểm yếu ảnh hưởng đến đầu ra quan trọng.
4. Quay vòng cho đến khi mọi Fold Được Sử Dụng làm Validation: Ràng buộc và Ranh giới Xác minh trong Cross-Validation
Ở giai đoạn này của Cross-validation, hệ thống phải quay vòng cho đến khi mọi fold đều đã được dùng làm validation. Câu hỏi hữu ích không chỉ là liệu thao tác đó có diễn ra hay không, mà còn là nó tiêu thụ thông tin nào, thay đổi trạng thái nào, và bằng bằng chứng nào chứng minh sự thay đổi là hợp lệ. Người đánh giá cần có khả năng phân biệt thao tác này với việc thử nghiệm nhiều mô hình trên bộ kiểm tra cuối cùng và tái tạo kết quả của nó dưới cùng các điều kiện đã nêu.
Việc chuyển giao vào giai đoạn Cross-validation này bắt đầu bằng việc đánh giá trên tập dữ liệu giữ lại và nên kết thúc bằng một kết quả có thể hỗ trợ tổng hợp điểm số và biến thể. Ghi lại sự không chắc chắn, các lựa chọn bị loại bỏ, việc sử dụng tài nguyên, và bất kỳ kiểm soát nào của con người hoặc phần mềm được áp dụng tại ranh giới. Dấu vết đó là nơi các nhóm có thể phát hiện liệu các fold ngẫu nhiên thông thường có không hợp lệ khi dữ liệu có phụ thuộc về thời gian, nhóm hoặc không gian trước khi cùng một điểm yếu ảnh hưởng đến đầu ra quan trọng.
5. Tổng hợp Điểm số và Biến thể: Đầu ra, Phản hồi và Quy tắc Dừng trong Cross-Validation
Ở giai đoạn này của Cross-validation, hệ thống phải tổng hợp điểm số và biến thể. Câu hỏi hữu ích không chỉ là liệu thao tác đó có diễn ra hay không, mà còn là nó tiêu thụ thông tin nào, thay đổi trạng thái nào, và bằng bằng chứng nào chứng minh sự thay đổi là hợp lệ. Người đánh giá cần có khả năng phân biệt thao tác này với việc thử nghiệm nhiều mô hình trên bộ kiểm tra cuối cùng và tái tạo kết quả của nó dưới cùng các điều kiện đã nêu.
Việc chuyển giao vào giai đoạn Cross-validation này bắt đầu bằng việc quay vòng cho đến khi mọi fold đều đã được dùng làm validation và nên kết thúc bằng một kết quả có thể hỗ trợ việc giám sát hoặc quyết định cuối cùng. Ghi lại sự không chắc chắn, các lựa chọn bị loại bỏ, việc sử dụng tài nguyên, và bất kỳ kiểm soát nào của con người hoặc phần mềm được áp dụng tại ranh giới. Dấu vết đó là nơi các nhóm có thể phát hiện liệu các fold ngẫu nhiên thông thường có không hợp lệ khi dữ liệu có phụ thuộc về thời gian, nhóm hoặc không gian trước khi cùng một điểm yếu ảnh hưởng đến đầu ra quan trọng.
Đọc bản đồ Cross-validation theo hướng tiến để hiểu quy trình sản xuất và theo hướng lùi để chẩn đoán lỗi. Phân tích tiến hỏi mỗi giai đoạn cung cấp gì cho giai đoạn tiếp theo. Phân tích lùi bắt đầu từ một kết quả sai, chậm, tốn kém hoặc không an toàn và truy vết giả định nào ở giai đoạn trước đã cho phép điều đó xảy ra. Đường ngược thường là nơi một nhóm phát hiện ra lỗi quyết định đã xảy ra trước khi mô hình tạo ra bất kỳ kết quả nào.
Một Ví dụ Thực tế về Cross-Validation
Một bộ dữ liệu y tế nhỏ có thể sử dụng các fold nhóm để mọi hồ sơ của bệnh nhân được giữ cùng nhau.
Ví dụ này mang tính thông tin vì Cross-validation có thể gắn liền với các đầu vào có thể quan sát, các trạng thái trung gian và một kết quả thay vì chỉ được đánh giá qua một buổi trình diễn hoàn hảo. Một bài kiểm tra nghiêm ngặt sẽ xây dựng các trường hợp bình thường, khó khăn và cố ý gây hiểu lầm xung quanh kịch bản, duy trì một chuẩn cơ bản không có kỹ thuật này, và ghi lại cả hiệu suất trung bình lẫn mức độ nghiêm trọng của các lỗi cá nhân.
Thay đổi một giả định trong ví dụ Cross-validation và lặp lại phân tích. Loại bỏ một đầu vào bắt buộc, đưa vào tín hiệu mâu thuẫn, giới hạn tính toán, thay đổi nhóm người dùng, hoặc buộc hệ thống từ chối. Một cơ chế chỉ thành công trong một buổi trình diễn được sắp xếp cẩn thận chưa chứng minh được rằng nó có thể tổng quát hoá sang môi trường vận hành.
Cross-Validation so với Phương pháp Rút gọn Phổ biến Nhất
Cross-validation thường bị rút gọn thành việc thử nghiệm nhiều mô hình trên bộ kiểm tra cuối cùng. Sự rút gọn này loại bỏ ranh giới chính xác định khái niệm. Nó có thể khiến người mua so sánh các sản phẩm không cùng loại, các nhà nghiên cứu phóng đại những gì một thí nghiệm chứng minh, và các nhà vận hành giám sát tín hiệu sai sau khi triển khai.
| Góc nhìn | Câu trả lời thực tiễn |
|---|---|
| Định nghĩa | Cross-validation liên tục xoay vòng các phần dữ liệu giữ lại để các nhóm có thể ước tính hiệu năng và tính biến đổi khi một lần chia validation sẽ không ổn định. |
| Nhầm lẫn | kiểm tra nhiều mô hình trên bộ kiểm tra cuối cùng. |
| Rủi ro | các gập ngẫu nhiên thông thường không hợp lệ khi dữ liệu có phụ thuộc về thời gian, nhóm hoặc không gian. |
So sánh cũng nên xác định đơn vị phân tích. Một bài báo về Cross-validation có thể cô lập một mô hình hoặc thuật toán, trong khi một dịch vụ đã triển khai còn bổ sung truy xuất, định tuyến, bộ nhớ đệm, chính sách, danh tính, giao diện người dùng và giám sát. Hai sản phẩm có thể sử dụng cùng một thuật ngữ tiêu đề nhưng thực hiện các phần khác nhau của ngăn xếp đó. Hãy hỏi thành phần nào thực hiện phép biến đổi định nghĩa và những thành phần nào khác cần thiết cho kết quả được báo cáo.
Tại sao Cross-Validation quan trọng trong các hệ thống AI hiện nay
Cross-validation hiện nay quan trọng vì các hệ thống AI đang được cung cấp ngữ cảnh lớn hơn, đa dạng hơn, tính toán thời gian chạy mạnh hơn, quyền truy cập công cụ rộng hơn và kết nối sâu hơn với các quyết định tổ chức. Trong những điều kiện đó, những gì từng chỉ là chi tiết nghiên cứu có thể quyết định độ trễ, bảo mật, khả năng tiếp cận, chi phí môi trường, chất lượng sản phẩm hoặc trách nhiệm pháp lý.
Thước đo liên quan không phải là liệu Cross-validation có tạo ra một kết quả ấn tượng hay không. Mà là liệu kỹ thuật này có cải thiện một kết quả quan trọng trên các điều kiện đại diện và thực hiện tốt hơn một chuẩn cơ bản đơn giản. Hãy báo cáo các phân phối, danh mục lỗi, độ trễ phía đuôi, tiêu thụ tài nguyên và các nhóm phụ hưởng thay vì nén mọi kết quả thành một giá trị trung bình.
Lựa chọn quy trình dựa trên cấu trúc dữ liệu và chi phí quyết định. Bảo tồn các nhóm và thời gian, định lượng độ không chắc, kiểm tra các lát cắt, khóa các kiểm tra cuối cùng và xác minh rằng những lợi ích offline vẫn tồn tại khi triển khai. Khi áp dụng cụ thể cho Cross-validation, kỷ luật này làm cho bằng chứng có thể chuyển giao: một nhóm khác có thể đánh giá liệu lợi nhuận được khẳng định có khả năng tồn tại trên mô hình, ngôn ngữ, nền tảng phần cứng, bộ dữ liệu, người dùng hoặc mức chấp nhận rủi ro khác hay không.
Lợi ích mà Cross-Validation có thể mang lại
Lý do mạnh mẽ nhất để sử dụng Cross-validation là nó có thể giải quyết trực tiếp nút thắt mục tiêu. Tùy vào cách triển khai, lợi ích có thể xuất hiện dưới dạng nền tảng vững chắc hơn, biểu diễn trung thực hơn, khả năng tổng quát cải thiện, độ trễ thấp hơn, giảm di chuyển bộ nhớ, trách nhiệm rõ ràng hơn, hoặc ranh giới an toàn hơn giữa đề xuất mô hình và hành động thực tế.
Lợi ích cần được diễn đạt dưới dạng quyết định và đo lường. “Thông minh hơn” không phải là tiêu chí chấp nhận cho Cross-validation. Một mục tiêu hữu ích có thể chỉ định tỷ lệ lỗi trong các trường hợp khó, khả năng phục hồi sau bằng chứng mâu thuẫn, chi phí ở một phần trăm lưu lượng, thời gian kiểm tra của con người, hiệu chuẩn, hoặc phần trăm hành động được giữ trong giới hạn quyền hạn đã định.
Chế độ thất bại định nghĩa Cross-Validation
Hạn chế cốt lõi là các gập ngẫu nhiên thông thường không hợp lệ khi dữ liệu có phụ thuộc về thời gian, nhóm hoặc không gian. Lỗi này không phải là một suy nghĩ sau cùng để liệt kê khi phát triển đã hoàn tất. Nó nên định hình việc thu thập dữ liệu, kiến trúc, quyền truy cập, đánh giá, cổng phát hành và giám sát cho Cross-validation ngay từ đầu.
Một kiểm soát cho Cross-validation chỉ hữu ích nếu nó hoạt động trước một hậu quả tốn kém hoặc không thể đảo ngược. Xác định dấu hiệu quan sát sớm nhất của lỗi, đặt ngưỡng hoặc quy tắc, chỉ định người chịu trách nhiệm và kiểm tra khả năng phục hồi. Tùy vào trường hợp sử dụng, phục hồi có thể có nghĩa là từ chối, quay lại hệ thống đơn giản hơn, yêu cầu thêm bằng chứng, nâng cấp lên người, quay lại mô hình, hoặc dừng hoàn toàn hành động.
Kế hoạch Đánh giá cho Cross-Validation
Bắt đầu đánh giá Cross-validation bằng cách viết ra quyết định mà bằng chứng phải hỗ trợ. Xác định dân số hoạt động, hậu quả của kết quả sai, thông tin thực tế có sẵn tại thời điểm quyết định, và lựa chọn thay thế đáng tin cậy và đơn giản nhất. Điều này ngăn một tiêu chuẩn trở thành mục tiêu chỉ vì nó dễ thực hiện.
Sử dụng bộ dữ liệu kiểm tra chưa được chạm tới để so sánh có kiểm soát, sau đó xác thực Cross-validation trong môi trường vận hành theo giai đoạn. Đánh giá ngoại tuyến giúp các biến thể có thể so sánh; chế độ bóng, canary, giới hạn tốc độ, hoặc cổng phê duyệt tiết lộ cách lưu lượng thực, vòng phản hồi và con người thay đổi hành vi. Giai đoạn triển khai nên có điều kiện dừng rõ ràng thay vì cho rằng mọi cải tiến đều xứng đáng được triển khai toàn bộ.
Phiên bản hoá các đầu vào cần thiết để tái tạo Cross-validation: dữ liệu gốc, tiền xử lý, bộ tokenizer hoặc encoder, trọng số mô hình, cấu hình, prompt hoặc chính sách, chỉ mục truy xuất, tập đánh giá, giả định phần cứng, và mã phục vụ nếu áp dụng. Nếu không có nguồn gốc, nhóm không thể xác định kết quả thay đổi xuất phát từ kỹ thuật, môi trường, hay một sửa đổi ẩn trong quy trình.
Cuối cùng, hãy hỏi kết quả nào sẽ bác bỏ khẳng định rằng Cross-validation có ích. Nếu không có kết quả nào có thể đảo ngược quyết định áp dụng, việc đánh giá chỉ là hoạt động marketing. Ngưỡng chấp nhận đã được cam kết trước và bộ xác nhận được bảo lưu biến bài tập thành bằng chứng.
Các Câu Hỏi Cần Đặt Ra Trước Khi Áp Dụng Cross-Validation
- Mục tiêu: Điểm nghẽn đo lường nào mà Cross-validation dự định giải quyết?
- Cơ chế: Giai đoạn nào trong năm giai đoạn chứa sự biến đổi đặc trưng?
- Đường cơ sở: Nó so sánh như thế nào với việc thử nghiệm nhiều mô hình trên bộ kiểm tra cuối cùng hoặc một lựa chọn đơn giản hơn?
- Bằng chứng: Những trường hợp bình thường, khó khăn, đối kháng và các nhóm phụ nào đã được thử nghiệm?
- Vận hành: Chi phí độ trễ, bộ nhớ, tính toán, năng lượng, bảo trì và đánh giá nào xuất hiện khi mở rộng quy mô?
- Rủi ro: Nhóm sẽ phát hiện như thế nào rằng các phân đoạn ngẫu nhiên bình thường không hợp lệ khi dữ liệu có phụ thuộc về thời gian, nhóm hoặc không gian?
- Phục hồi: Hệ thống có thể từ chối, quay lại, hoàn nguyên, hoặc nâng cấp trước khi gây hại không?
Nguồn Chính Để Nghiên Cứu Cross-Validation
Các điểm khởi đầu có thẩm quyền cho phần của ngăn xếp AI bao quanh Cross-validation bao gồm hướng dẫn lựa chọn mô hình scikit-learn, Quy tắc ML của Google, NIST AI RMF. Đọc chúng cùng với tài liệu cho mô hình, bộ dữ liệu, phần cứng và khu vực pháp lý cụ thể liên quan. Một nguồn chung có thể định nghĩa cơ chế, nhưng chỉ bằng chứng cụ thể cho triển khai mới có thể khẳng định một triển khai nào đó là phù hợp.
Những Điều Cần Nhớ Về Cross-Validation
Cross-validation là một cơ chế được định nghĩa trong một hệ thống xã hội-kỹ thuật lớn hơn. Giá trị của nó đến từ việc cải thiện một kết quả cụ thể dưới các điều kiện rõ ràng, chứ không phải từ nhãn gọi. Bản đồ năm giai đoạn làm cho luồng thông tin của nó trở nên hiện hữu, so sánh xác định những gì nó không phải, và đường kiểm soát cho thấy nơi mà người vận hành có trách nhiệm có thể can thiệp.
Quy tắc thực tiễn cho Cross-validation là xác định mục tiêu, so sánh với một đường cơ sở đáng tin cậy, kiểm tra lỗi quan trọng nhất, và giữ lại bằng chứng cần thiết để giám sát sự thay đổi. Khi các yếu tố này có mặt, khái niệm trở thành một lựa chọn về kỹ thuật và quản trị có thể được đánh giá. Nếu không, nó chỉ là một tên gọi đầy hứa hẹn gắn liền với rủi ro vận hành chưa được biết.


