
AGI và AI tương lai
Sức mạnh của Rerankers và Truy xuất hai giai đoạn cho Truy xuất Tăng cường Tạo

 Thêm Unite.AI vào các nguồn ưu tiên của bạn trên Google

Điểm chínhTruy xuất hai giai đoạn với bộ xếp hạng lại cải thiện đáng kể độ chính xác của RAG bằng…
Xem thêm
- Truy xuất hai giai đoạn với bộ xếp hạng lại cải thiện đáng kể độ chính xác của RAG bằng cách đầu tiên lấy nhiều tài liệu sau đó sắp xếp lại chúng bằng một mô hình thông minh hơn.
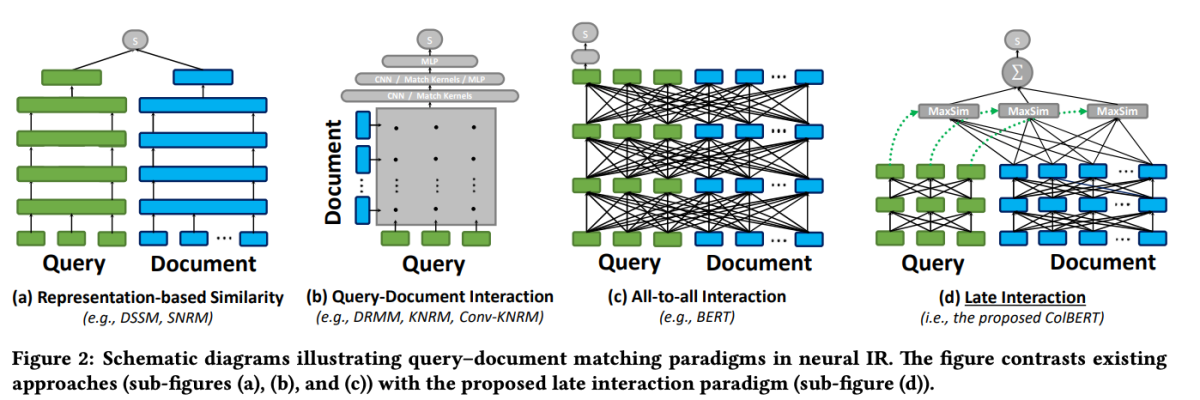
- Cơ chế tương tác muộn của ColBERT cho phép tìm kiếm ngữ nghĩa hiệu quả bằng cách xử lý truy vấn và tài liệu riêng biệt cho đến khi so sánh cuối cùng.
- Các mô hình xếp hạng lại có thể được đào tạo trên dữ liệu chuyên ngành để giải quyết các vấn đề ngoài miền phổ biến trong các mô hình embedding tổng quát.

Mã code này minh họa cách cấu hình và sử dụng mô hình jina-colbert-v1 cho việc lập chỉ mục một bộ sưu tập tài liệu, tận dụng khả năng xử lý ngữ cảnh dài hiệu quả.
Triển khai Truy xuất hai giai đoạn với Rerankers
Bây giờ chúng ta đã hiểu về các nguyên tắc đằng sau truy xuất hai giai đoạn và rerankers, hãy khám phá việc triển khai chúng trong bối cảnh của một hệ thống RAG. Chúng tôi sẽ tận dụng các thư viện và khuôn khổ phổ biến để minh họa việc tích hợp các kỹ thuật này.
Thiết lập Môi trường
Trước khi chúng ta bắt đầu với mã code, hãy thiết lập môi trường phát triển của chúng ta. Chúng tôi sẽ sử dụng Python và một số thư viện NLP phổ biến, bao gồm Hugging Face Transformers, Sentence Transformers và LanceDB.
# Cài đặt các thư viện cần thiết
!pip install datasets huggingface_hub sentence_transformers lancedb
Chuẩn bị Dữ liệu
Để minh họa, chúng tôi sẽ sử dụng tập dữ liệu “ai-arxiv-chunked” từ Hugging Face Datasets, chứa hơn 400 bài báo ArXiv về học máy, xử lý ngôn ngữ tự nhiên và mô hình ngôn ngữ lớn.
from datasets import load_dataset <p>dataset = load_dataset("jamescalam/ai-arxiv-chunked", split="train")</p> &lt;pre&gt;
Tiếp theo, chúng tôi sẽ tiền xử lý dữ liệu và chia nó thành các phần nhỏ hơn để thuận tiện cho việc truy xuất và xử lý.
from transformers import AutoTokenizer <p>tokenizer = AutoTokenizer.from_pretrained("bert-base-uncased")</p> <p>def chunk_text(text, chunk_size=512, overlap=64): tokens = tokenizer.encode(text, return_tensors="pt", truncation=True) chunks = tokens.split(chunk_size - overlap) texts = [tokenizer.decode(chunk) for chunk in chunks] return texts</p> <p>chunked_data = [] for doc in dataset: text = doc["chunk"] chunked_texts = chunk_text(text) chunked_data.extend(chunked_texts)</p>
Để giai đoạn truy xuất ban đầu, chúng tôi sẽ sử dụng một mô hình Sentence Transformer để mã hóa tài liệu và truy vấn thành các biểu diễn vector dày đặc, sau đó thực hiện tìm kiếm gần nhất bằng một cơ sở dữ liệu vector như LanceDB.
from sentence_transformers import SentenceTransformer from lancedb import lancedb <p># Tải mô hình Sentence Transformer model = SentenceTransformer('all-MiniLM-L6-v2')</p> <p># Tạo cơ sở dữ liệu vector LanceDB db = lancedb.lancedb('/path/to/store') db.create_collection('docs', vector_dimension=model.get_sentence_embedding_dimension())</p> <p># Lập chỉ mục tài liệu for text in chunked_data: vector = model.encode(text).tolist() db.insert_document('docs', vector, text)</p> <p>from sentence_transformers import SentenceTransformer from lancedb import lancedb</p> <p># Tải mô hình Sentence Transformer model = SentenceTransformer('all-MiniLM-L6-v2')</p> <p># Tạo cơ sở dữ liệu vector LanceDB db = lancedb.lancedb('/path/to/store') db.create_collection('docs', vector_dimension=model.get_sentence_embedding_dimension())</p> <p># Lập chỉ mục tài liệu for text in chunked_data: vector = model.encode(text).tolist() db.insert_document('docs', vector, text)
Với tài liệu đã được lập chỉ mục, chúng ta có thể thực hiện giai đoạn truy xuất ban đầu bằng cách tìm các láng giềng gần nhất của một vector truy vấn nhất định.
from transformers import AutoTokenizer <p>tokenizer = AutoTokenizer.from_pretrained("bert-base-uncased")</p> <p>def chunk_text(text, chunk_size=512, overlap=64): tokens = tokenizer.encode(text, return_tensors="pt", truncation=True) chunks = tokens.split(chunk_size - overlap) texts = [tokenizer.decode(chunk) for chunk in chunks] return texts</p> <p>chunked_data = [] for doc in dataset: text = doc["chunk"] chunked_texts = chunk_text(text) chunked_data.extend(chunked_texts)
Reranking
Sau giai đoạn truy xuất ban đầu, chúng tôi sẽ sử dụng một mô hình reranking để sắp xếp lại các tài liệu đã truy xuất dựa trên sự liên quan của chúng đến truy vấn. Trong ví dụ này, chúng tôi sẽ sử dụng mô hình reranking ColBERT, một mô hình transformer dựa trên chuyển đổi nhanh và chính xác được thiết kế đặc biệt cho việc xếp hạng tài liệu.
from lancedb.rerankers import ColbertReranker

reranker = ColbertReranker()

<p># Rerank tài liệu ban đầu
reranked_docs = reranker.rerank(query, initial_docs)
Danh sách reranked_docs bây giờ chứa các tài liệu được sắp xếp lại dựa trên sự liên quan của chúng đến truy vấn, như được xác định bởi mô hình reranking ColBERT.
Tăng cường và Tạo
Với các tài liệu đã được xếp hạng lại và liên quan, chúng ta có thể tiếp tục đến giai đoạn tăng cường và tạo của đường ống RAG. Chúng tôi sẽ sử dụng một mô hình ngôn ngữ từ thư viện Hugging Face Transformers để tạo ra phản hồi cuối cùng.
from transformers import AutoTokenizer, AutoModelForSeq2SeqLM <p>tokenizer = AutoTokenizer.from_pretrained("t5-base") model = AutoModelForSeq2SeqLM.from_pretrained("t5-base")</p> <p># Tăng cường truy vấn với tài liệu đã xếp hạng lại augmented_query = query + " " + " ".join(reranked_docs[:3])</p> <p># Tạo phản hồi từ mô hình ngôn ngữ input_ids = tokenizer.encode(augmented_query, return_tensors="pt") output_ids = model.generate(input_ids, max_length=500) response = tokenizer.decode(output_ids[0], skip_special_tokens=True)</p> print(response)


