
Nền tảng AI
Phân Loại Văn Bản Hoạt Động Như Thế Nào?

 Thêm Unite.AI vào các nguồn ưu tiên của bạn trên Google
Phân loại văn bản gán một hoặc nhiều nhãn cho tài liệu, tin nhắn hoặc đoạn văn bản. Các ví dụ bao gồm phát hiện spam, định tuyến ý định, phân tích cảm xúc, gắn thẻ chủ đề, kiểm duyệt và ưu tiên vé hỗ trợ.
Một bộ phân loại trong môi trường sản xuất không chỉ là một mô hình. Nó phụ thuộc vào một hệ thống phân loại nhãn chính xác, các chú thích đại diện, các phân chia dữ liệu tránh rò rỉ, quy tắc quyết định được hiệu chỉnh và việc giám sát sự thay đổi của ngôn ngữ và tần suất các lớp.
Những điểm chính
- Xác định nhãn và các trường hợp mơ hồ trước khi chọn kiến trúc.
- Các mô hình cơ bản dựa trên bag-of-words vẫn còn giá trị; các bộ mã hoá đã được huấn luyện trước cung cấp ngữ cảnh và học chuyển giao.
- Độ chính xác có thể che giấu hiệu năng kém của các lớp thiểu số, vì vậy hãy sử dụng các chỉ số có quan tâm đến lớp và phân tích lỗi.
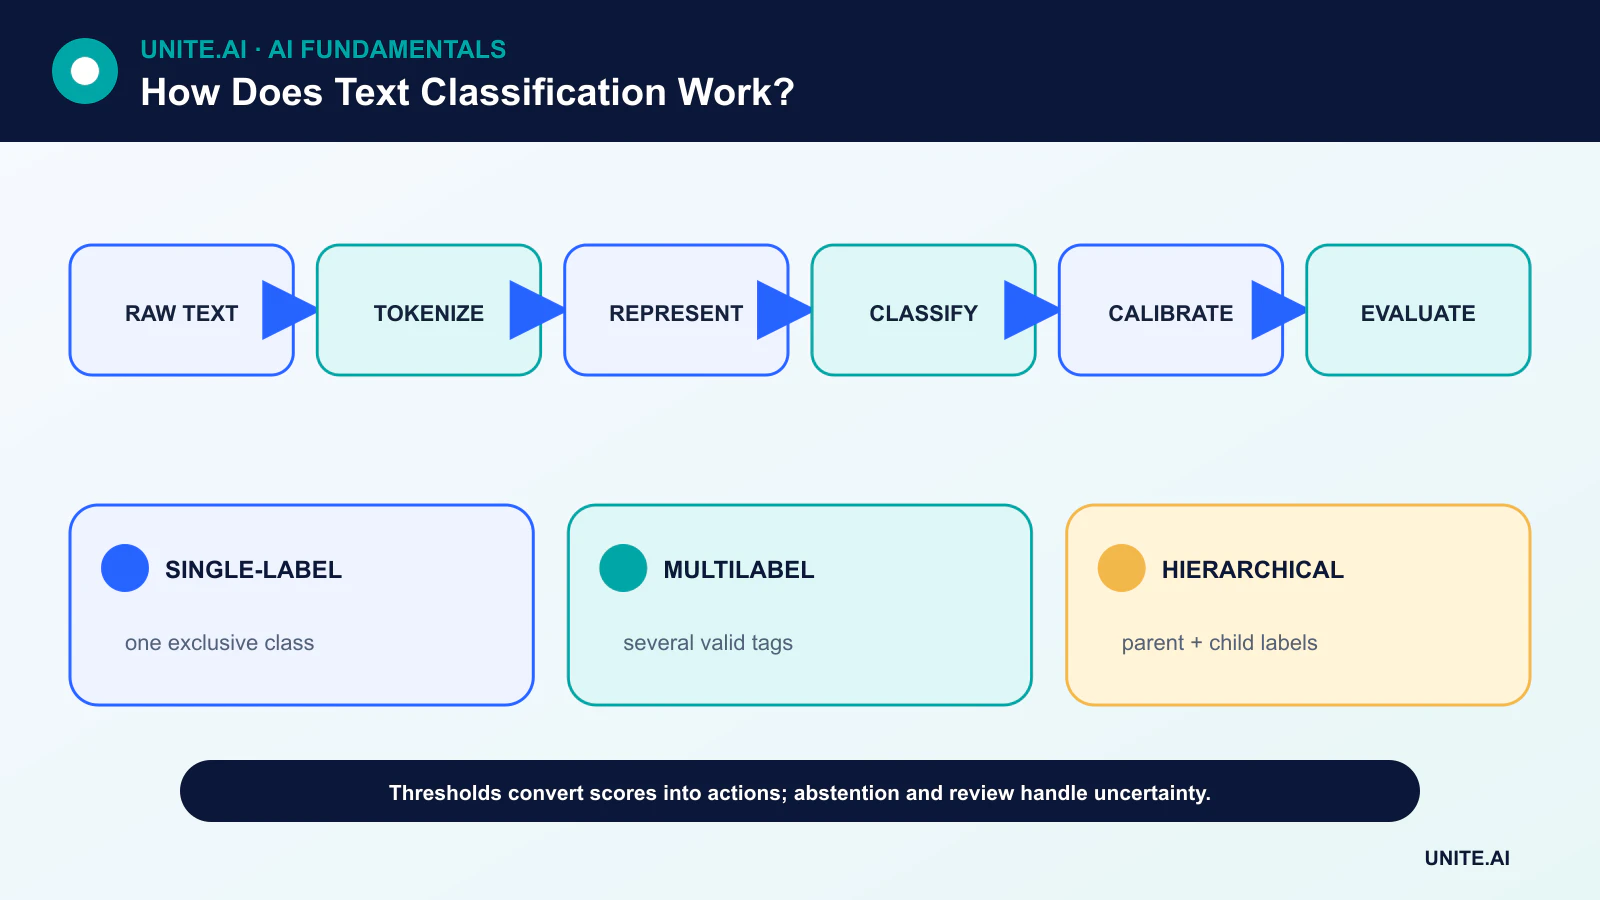
- Hiệu chỉnh xác suất, từ chối và đánh giá của con người biến điểm số thành các quyết định an toàn hơn.
Xác định hệ thống phân loại và chính sách chú thích
Một nhiệm vụ nhãn đơn chọn một lớp loại trừ lẫn nhau. Một nhiệm vụ đa nhãn có thể gán nhiều thẻ độc lập. Các hệ thống phân loại phân cấp chứa các nhãn cha và con. Đây là những vấn đề học khác nhau và đòi hỏi các đầu ra và chỉ số khác nhau.
Người chú thích cần có định nghĩa, các ví dụ dương và âm, quy tắc cho trường hợp thiếu ngữ cảnh và quy trình leo thang. Thống kê đồng thuận có thể bật mí một nhiệm vụ chưa rõ ràng, nhưng sự bất đồng cũng có thể phản ánh tính mơ hồ thực sự mà hệ thống nên bảo toàn.
Biểu diễn văn bản
Các quy trình truyền thống sử dụng đếm token, n-gram và TF‑IDF kết hợp với các bộ phân loại tuyến tính hoặc máy vector hỗ trợ. Chúng huấn luyện nhanh, hiển thị các từ có ảnh hưởng và cung cấp một nền tảng mạnh mẽ.
Các hệ thống thần kinh ánh xạ token thành vector nhúng. Các bộ mã hoá transformer đã được huấn luyện trước dùng cơ chế attention để tạo ra các biểu diễn ngữ cảnh và có thể được tinh chỉnh bằng các ví dụ có nhãn. Các bộ phân loại dựa trên prompt hoặc zero‑shot có thể giảm nhu cầu gán nhãn ban đầu, nhưng cách diễn đạt nhãn, phiên bản mô hình và việc hiệu chỉnh phải được đánh giá trên miền thực tế.
Huấn luyện không rò rỉ
Bộ dữ liệu được chia thành dữ liệu huấn luyện, xác thực và kiểm thử cuối cùng. Các tài liệu gần trùng lặp, tin nhắn từ cùng một cuộc hội thoại hoặc mẫu từ cùng một nguồn nên nằm trong cùng một phân chia. Đối với các trường hợp phụ thuộc thời gian, việc chia theo thứ tự thời gian sẽ phản ánh môi trường triển khai tốt hơn.
Vấn đề mất cân bằng lớp có thể giải quyết bằng trọng số, lấy mẫu lại, lựa chọn ngưỡng hoặc bổ sung dữ liệu. Các ví dụ tổng hợp không nên thay thế việc xem xét các lỗi thực tế của lớp thiểu số và có thể tạo ra các hiện tượng mà mô hình học quá nhanh.
Chỉ số và quyết định đã được hiệu chỉnh
Một ma trận nhầm lẫn cho thấy những nhãn nào bị nhầm lẫn với nhau. Độ chính xác (precision) đo lường bao nhiêu dự đoán dương tính là đúng; độ thu hồi (recall) đo lường bao nhiêu dương tính thực sự được tìm thấy. Trung bình macro cân nhắc các lớp một cách đồng đều, trong khi trung bình micro cân nhắc từng ví dụ riêng lẻ.
Điểm softmax thô không tự động là một xác suất đáng tin cậy. Hiệu chỉnh so sánh mức độ tin cậy với độ đúng quan sát được. Các nhóm có thể đặt ngưỡng riêng cho từng lớp, từ chối khi mức tin cậy thấp và chuyển các trường hợp nhạy cảm cho người xem xét.
Triển khai, sử dụng đa ngôn ngữ và drift
Văn bản thay đổi theo sản phẩm, sự kiện, tiếng lóng và hành vi đối kháng. Việc giám sát cần theo dõi ngôn ngữ đầu vào, độ dài, các mẫu từ ngoài từ điển, tỷ lệ lớp, mức tin cậy và kết quả trễ. Việc tái huấn luyện đòi hỏi dữ liệu có phiên bản và một bộ kiểm thử hồi quy gồm các ví dụ quan trọng.
Hiệu năng đa ngôn ngữ phải được kiểm tra riêng cho từng ngôn ngữ và phương ngữ. Dịch toàn bộ nội dung sang một ngôn ngữ duy nhất có thể làm thay đổi cảm xúc hoặc thực thể; một bộ mã hoá đa ngôn ngữ vẫn có thể hoạt động không đồng đều vì dữ liệu tiền huấn luyện và các nhãn không đại diện đều.
Biểu diễn và các họ bộ phân loại
Phân loại văn bản ánh xạ một tài liệu, câu hoặc chuỗi token thành một hoặc nhiều nhãn. Xác định nhãn là loại loại trừ lẫn nhau, đa nhãn, phân cấp, có thứ tự hay mở. Các quy trình truyền thống token hoá văn bản, xây dựng các đặc trưng bag-of-words hoặc TF–IDF, và huấn luyện logistic regression, naive Bayes hoặc SVM tuyến tính. Các hệ thống thần kinh học các vector nhúng bằng convolution, recurrence hoặc transformer. Các mô hình ngôn ngữ dựa trên prompt có thể phân loại mà không cần huấn luyện chuyên biệt, nhưng các ràng buộc đầu ra, chi phí, drift và bằng chứng vẫn cần được đánh giá so với các nền tảng đơn giản hơn.
Tiền xử lý phụ thuộc vào cách biểu diễn. Việc chuyển sang chữ thường hoặc loại bỏ dấu câu có thể phá hủy tín hiệu cho tên riêng, cảm xúc, mã code hoặc ngôn ngữ; stemming có thể gộp các nghĩa khác nhau. Các tokenizer của transformer hoạt động trên subword và có giới hạn độ dài, vì vậy chiến lược cắt ngắn rất quan trọng. Các tài liệu dài có thể cần chia thành đoạn và tổng hợp. Giữ nguyên văn bản gốc và phiên bản chuyển đổi, và chia theo tác giả, cuộc hội thoại, nguồn hoặc thời gian để tránh các tài liệu gần trùng lặp và mẫu lặp lại xuyên qua tập huấn và kiểm thử.
Nhãn, chỉ số và phân tích lỗi
Một hướng dẫn chú thích nên xác định phạm vi, ví dụ, các trường hợp mơ hồ và tùy chọn “không biết” hoặc “từ chối”. Đo lường đồng thuận và giải quyết bất đồng thay vì ẩn chúng bằng phiếu đa số. Đối với các lớp mất cân bằng, độ chính xác là không đủ; cần báo cáo precision, recall, F1, ma trận nhầm lẫn, hiệu chỉnh và khối lượng công việc theo ngưỡng cho từng lớp. Nhiệm vụ đa nhãn cần các chỉ số micro, macro và mức nhãn. Đánh giá theo ngôn ngữ, phương ngữ, miền, độ dài tin nhắn và thời gian. Một phép chia ngẫu nhiên có thể làm tăng ảo chất lượng khi từ vựng hoặc mẫu mẫu drift.
Phân tích lỗi nên tách biệt lỗi biểu diễn, thiếu ngữ cảnh, mơ hồ nhãn, từ vựng hiếm, phủ định, châm biếm và các tín hiệu ngẫu nhiên. Sử dụng các kiểm thử phản thực thay đổi tên, dấu hiệu phương ngữ hoặc siêu dữ liệu không liên quan trong khi giữ nguyên ý nghĩa. Kiểm tra các lỗi có độ tin cậy cao và các trường hợp bị từ chối. Một mô hình có thể học rằng kênh khách hàng hoặc chữ ký dự đoán nhãn hơn là hiểu nội dung. Loại bỏ rò rỉ và chỉnh sửa dữ liệu trước khi chỉ tăng khả năng của mô hình.
Thiết kế cho môi trường sản xuất
Triển khai một tokenizer và mô hình cố định với kiểm tra schema, giới hạn độ dài, batch và cơ chế dự phòng cho ngôn ngữ không hỗ trợ hoặc mức tin cậy thấp. Giám sát phân phối đầu vào, tỷ lệ nhãn, hiệu chỉnh, độ trễ, và kết quả đã được xem xét. Bảo vệ văn bản vì nó có thể chứa thông tin cá nhân, bí mật hoặc hướng dẫn đối kháng. Đối với kiểm duyệt tự động, tính đủ điều kiện, hoặc định tuyến, cung cấp cơ chế kháng cáo và đo lường lỗi bất bình đẳng. Phiên bản hoá nhãn và ngưỡng theo chính sách kinh doanh. Phân loại văn bản chỉ đáng tin cậy trong hệ thống nhãn và phân phối dữ liệu đã định; các giải thích mô hình lưu loát không chứng minh rằng một phân loại là đúng.
Ví dụ thực tế: phân loại các yêu cầu hỗ trợ đến
Một đội hỗ trợ định nghĩa các nhãn định tuyến loại trừ lẫn nhau cùng với các cờ ưu tiên, đa ngôn ngữ và không xác định. Các người chú thích gán nhãn cho các tin nhắn đã được ẩn danh với hướng dẫn cho các vấn đề hỗn hợp và đo lường đồng thuận. Một baseline logistic TF–IDF, bộ mã hoá được tinh chỉnh và mô hình dựa trên prompt sử dụng cùng một bộ kiểm thử dựa trên thời gian. Báo cáo đánh giá bao gồm precision và recall theo lớp, các trường hợp ưu tiên bị bỏ sót, hiệu chỉnh, tính hợp lệ schema, độ trễ và chi phí, với các mẫu gần trùng lặp được nhóm lại để tránh rò rỉ.
Bộ phân loại đã triển khai xác thực ngôn ngữ và độ dài, từ chối khi bằng chứng yếu, và cho phép nhân viên chỉnh sửa định tuyến. Các prompt và tin nhắn được coi là không đáng tin cậy; quyền truy cập công cụ không được cấp. Giám sát theo dõi tần suất nhãn, mức tin cậy, các lần sửa, thời gian phản hồi và các chủ đề mới nổi. Một chính sách hoặc thay đổi sản phẩm cập nhật hệ thống phân loại và dữ liệu tái huấn luyện thông qua việc xem xét. Hệ thống cải thiện việc xếp hàng, nhưng không bao giờ suy đoán cảm xúc hay quyền lợi của khách hàng ngoài các nhãn đã được xác thực.
Chứng cứ triển khai và sẵn sàng vận hành
Một quyết định trong môi trường sản xuất cần hơn một buổi demo thành công. Xác định người dùng mục tiêu, môi trường vận hành, đầu vào, đầu ra, phụ thuộc, người chịu trách nhiệm và hậu quả của mỗi lỗi quan trọng. Thiết lập một baseline tái tạo được và một bộ đánh giá có phiên bản trước khi tinh chỉnh. Kiểm thử các trường hợp bình thường, các điều kiện biên, đầu vào sai dạng hoặc thiếu, sự dịch chuyển phân phối, mất kết nối phụ thuộc, lạm dụng và các nhóm hoặc môi trường có khả năng bị bỏ sót. Đo lường chất lượng nhiệm vụ cùng với hiệu chỉnh hoặc độ không chắc, độ trễ, thông lượng, chi phí tài nguyên, khả năng tiếp cận, quyền riêng tư và bảo mật. Ghi lại mọi chuyển đổi và ngưỡng để người đánh giá độc lập có thể tái tạo kết quả và phân biệt bằng chứng với một nguyên mẫu hấp dẫn.
Trước khi ra mắt, chỉ định quyền trách nhiệm cho việc phát hành, ngoại lệ, thay đổi, quay lại và ngừng sử dụng. Sử dụng triển khai theo giai đoạn, duy trì dự phòng an toàn và xác minh giám sát bằng các lỗi được chèn cố ý. Dữ liệu đo lường vận hành nên tiết lộ chất lượng đầu vào, hành vi đầu ra, phiên bản mô hình hoặc quy tắc, tình trạng phụ thuộc, can thiệp của con người và kết quả đã xác nhận mà không thu thập dữ liệu nhạy cảm không cần thiết. Đặt ngưỡng cảnh báo và người chịu trách nhiệm phản hồi, sau đó xem xét bằng chứng thực tế sau khi triển khai thay vì cho rằng hiệu năng offline sẽ kéo dài. Đánh giá lại mỗi khi nguồn dữ liệu, người dùng, mô hình, nhà cung cấp, chính sách, phần cứng hoặc mục tiêu thay đổi. Một hệ thống được duy trì cũng cần có tài liệu phục hồi, học hỏi từ sự cố, quy trình xóa và lưu trữ, và một điểm rõ ràng khi nó nên bị tắt hoặc thay thế.
Các câu hỏi thường gặp
Phân tích cảm xúc có phải là một nhiệm vụ phân loại văn bản không?
Thông thường có, nhưng cảm xúc có thể là đa nhãn, dựa trên khía cạnh hoặc liên tục thay vì chỉ một nhãn tích cực/trung tính/tiêu cực.
Khi nào một bộ phân loại văn bản nên từ chối?
Khi mức tin cậy thấp, văn bản nằm ngoài phạm vi, ngữ cảnh cần thiết thiếu hoặc chi phí của một hành động tự động sai lệch vượt quá chi phí của việc xem xét.
Tài liệu tham khảo chính












