
Tốt nhất
10 công cụ thu thập dữ liệu web bằng AI tốt nhất (Tháng 11 2026)

 Thêm Unite.AI vào các nguồn ưu tiên của bạn trên Google
Unite.AI có thể nhận thù lao khi bạn dùng liên kết đến sản phẩm chúng tôi đánh giá. Điều này không ảnh hưởng đến đánh giá biên tập của chúng tôi. Đọc công bố liên kết của chúng tôi.
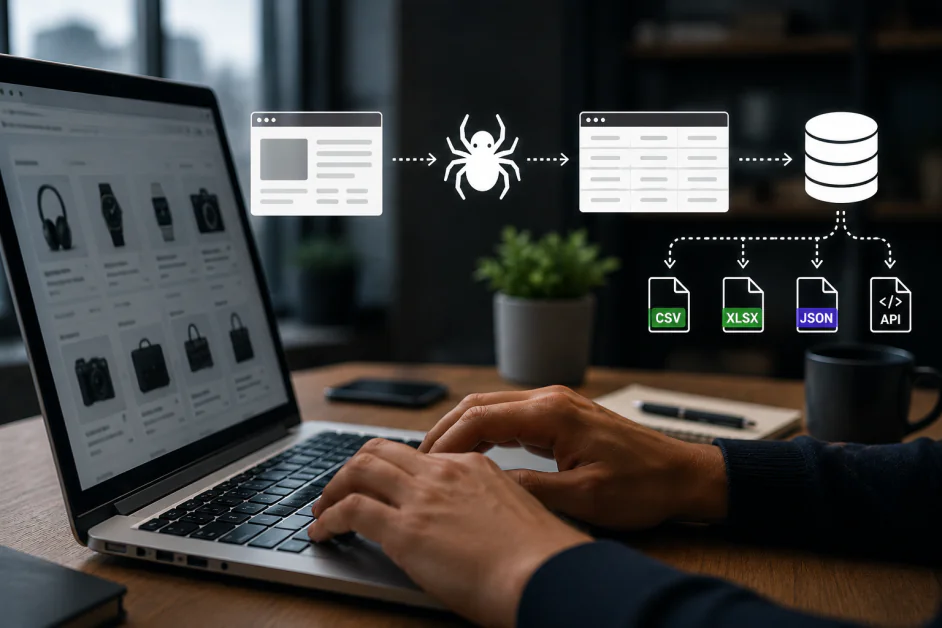
Điểm chínhHãy chọn công cụ thu thập dữ liệu phù hợp với công việc sau khi tải trang, thay vì coi…
Xem thêm
- Hãy chọn công cụ thu thập dữ liệu phù hợp với công việc sau khi tải trang, thay vì coi mọi hoạt động thu thập là một vấn đề duy nhất.
- Hãy giao quyền sở hữu quy trình làm việc cho những người hiểu rõ cả trang nguồn lẫn kết quả đầu ra yêu cầu.
- Hãy lập ngân sách dựa trên số bản ghi dùng được thay vì số lượng yêu cầu được nêu trong tiêu đề, vì việc kết xuất và proxy làm phồng tổng số.
Công cụ thu thập dữ liệu web bằng AI tốt nhất tùy thuộc vào việc bạn muốn làm gì sau khi trang tải xong. Trợ lý nghiên cứu cần nội dung dễ đọc và liên kết đến nguồn. Hệ thống phân tích thị trường cần các bản ghi nhất quán ở quy mô lớn. Tác nhân tương tác có thể cần một trình duyệt có thể thực hiện nhiều bước nhấp và duy trì phiên hoạt động.
Hướng dẫn này giới thiệu mười công cụ phục vụ những nhu cầu đó, bao gồm nền tảng thu thập dữ liệu dành cho doanh nghiệp, API nội dung, công cụ thu thập dữ liệu không cần viết mã, dịch vụ dữ liệu tìm kiếm và trình duyệt được quản lý. Chúng tôi đánh giá cách mỗi sản phẩm thu thập thông tin, ai có thể duy trì quy trình làm việc và những điểm cần cân nhắc khi một bản mẫu trở thành quy trình định kỳ.
Đội ngũ của chúng tôi đã đánh giá độc lập từng giải pháp trong hướng dẫn này, xem xét khả năng, ưu điểm thực tiễn, hạn chế và mức độ phù hợp với các trường hợp sử dụng được phản ánh trong bảng xếp hạng.
So sánh các công cụ thu thập dữ liệu web bằng AI tốt nhất
| Công cụ AI | Phù hợp nhất với | Điểm mạnh chính |
|---|---|---|
| Bright Data | Thu thập dữ liệu cho doanh nghiệp và các quy trình dữ liệu đa dạng | Scraper APIs, Browser API, Scraper Studio, bộ dữ liệu, proxy |
| Firecrawl | Nội dung web cho ứng dụng AI | Tìm kiếm, thu thập dữ liệu, lập bản đồ, thu thập dữ liệu trên toàn trang, Markdown, JSON, tương tác, MCP |
| Apify | Tác vụ thu thập dữ liệu có thể tái sử dụng và điều phối trên nền tảng đám mây | Actors, Crawlee, lịch chạy, lưu trữ, proxy, API, MCP |
| Browse AI | Thu thập dữ liệu không cần viết mã và theo dõi thay đổi | Thiết lập có AI hỗ trợ, robot, cảnh báo, lịch chạy, tích hợp |
| SearchAPI | Kết quả tìm kiếm có cấu trúc và nghiên cứu theo khu vực | Google, Maps, mua sắm, video, giao diện tìm kiếm AI, JSON |
| Octoparse | Thu thập dữ liệu trực quan với khả năng thực thi lặp lại trên nền tảng đám mây | Mẫu, Trợ lý AI, tự động phát hiện, tác vụ trên nền tảng đám mây, xuất dữ liệu |
| Browserless | Trình duyệt được quản lý dành cho Puppeteer và Playwright | Trình duyệt lưu trữ trên máy chủ, phiên duy trì liên tục, API REST, MCP |
| ScrapingBee | Trích xuất dữ liệu được quản lý thông qua API ứng dụng | Trích xuất bằng AI, CSS/XPath, Markdown, kịch bản JS, MCP |
| Oxylabs | Truy xuất dữ liệu được quản lý từ các trang web công khai khó xử lý | Web API /Scrape, kết xuất, đầu ra có cấu trúc, MCP |
| Diffbot | Trích xuất tự động và phân tích thực thể | Trích xuất, lược đồ tiêu chuẩn, thu thập dữ liệu trên toàn trang, Knowledge Graph |
Cách chọn công cụ thu thập dữ liệu web bằng AI
Chọn công cụ phù hợp với công việc
Với cơ sở tri thức AI, hãy ưu tiên văn bản dễ đọc, đầu ra có cấu trúc và khả năng lưu lại URL nguồn. Với hoạt động nghiên cứu kinh doanh cần lặp lại, robot trực quan và cảnh báo thay đổi có thể quan trọng hơn giao diện lập trình. Với tác nhân tương tác, hãy xem xét khả năng duy trì phiên và điều khiển trình duyệt. API kết quả tìm kiếm giải quyết một vấn đề khác: chúng cung cấp dữ liệu tìm kiếm, còn việc thu thập các trang được liên kết là một bước riêng.
Xác định ai chịu trách nhiệm về quy trình làm việc
Nền tảng không cần viết mã cho phép chuyên viên phân tích trực tiếp điều chỉnh các bước trích xuất. API cung cấp cho nhà phát triển một giao diện rõ ràng để tích hợp việc thu thập dữ liệu vào ứng dụng. Nền tảng tác vụ trên đám mây bổ sung tính năng lên lịch và lưu trữ, trong khi trình duyệt được quản lý để đội ngũ của bạn tự đảm nhiệm nhiều hơn phần logic tự động hóa. Lựa chọn phù hợp sẽ giao việc bảo trì cho những người hiểu rõ cả các trang web nguồn lẫn đầu ra cần thiết.
Dự trù ngân sách cho bản ghi hữu ích, không chỉ cho số lượt yêu cầu nổi bật
Hãy so sánh chi phí cho một tác vụ hoàn tất với các trường dữ liệu bạn cần. Việc kết xuất, proxy cao cấp, thời lượng sử dụng trình duyệt, trích xuất bằng AI, lưu trữ và các lần thử lại có thể làm thay đổi tổng chi phí. Tín dụng miễn phí, đơn vị sử dụng trình duyệt và yêu cầu tìm kiếm là những thước đo khác nhau. Với công việc định kỳ, bên cạnh số phản hồi thành công, hãy theo dõi mức độ đầy đủ, bản ghi trùng lặp, độ mới của dữ liệu và chi phí cho mỗi bản ghi có thể sử dụng.
10 công cụ thu thập dữ liệu web bằng AI tốt nhất
1. Bright Data
Bright Data là lựa chọn hàng đầu của chúng tôi dành cho các tổ chức cần nhiều phương thức thu thập dữ liệu web trên cùng một nền tảng. Danh mục của nền tảng này bao gồm Scraper APIs dựng sẵn, bộ dữ liệu được thu thập trước, Scraper Studio, Web Unlocker và dịch vụ proxy. Chẳng hạn, một nhóm phân tích thương mại điện tử có thể dùng các nguồn cấp dữ liệu có cấu trúc cho những nhà bán lẻ quen thuộc, đồng thời xây dựng quy trình thu thập tùy chỉnh cho một sàn giao dịch chuyên biệt. Danh mục đa dạng đó đặc biệt hữu ích khi chương trình dữ liệu mở rộng ra ngoài phạm vi một trang web hoặc một phòng ban.
Đối với các trang có tính tương tác, Browser API cung cấp trình duyệt để nhà phát triển điều khiển bằng Puppeteer, Playwright hoặc Selenium. Dịch vụ này kết hợp khả năng vận hành trình duyệt với quản lý proxy và xử lý CAPTCHA, đồng thời hỗ trợ Chrome DevTools để kỹ sư kiểm tra các phiên gặp sự cố. Tính năng này hữu ích khi quy trình cần điều hướng hoặc tương tác với trang trước khi có thể truy xuất thông tin mong muốn, thay vì chỉ tải xuống một bộ dữ liệu có sẵn.
Điểm đánh đổi chính là việc lựa chọn sản phẩm và quản lý chi phí. Lưu lượng trình duyệt, kết quả thu thập dữ liệu và việc mua bộ dữ liệu là những khối lượng công việc khác nhau, nên không thể dùng một mức giá tổng quát duy nhất để mô tả toàn bộ nền tảng. Bright Data phù hợp với các nhóm có người chịu trách nhiệm về chất lượng thu thập, phạm vi mục tiêu và ngân sách. Một dự án có phạm vi hẹp có thể triển khai vào môi trường thực tế nhanh hơn với một API trích xuất đơn giản hơn.
Ưu và nhược điểm
- Nhiều tùy chọn thu thập trên cùng một nền tảng
- Trình duyệt được lưu trữ hỗ trợ các thư viện tự động hóa phổ biến
- API và bộ dữ liệu có sẵn giúp rút ngắn thời gian thiết lập
- Các sản phẩm khác nhau cần được lập kế hoạch chi phí riêng
- Các quy trình thu thập tùy chỉnh vẫn cần có đội ngũ kỹ thuật phụ trách
2. Firecrawl
Firecrawl là lựa chọn hàng đầu của chúng tôi dành cho các nhà phát triển muốn biến nội dung web thành ngữ cảnh hữu ích cho ứng dụng AI. Các công cụ tìm kiếm, trích xuất, lập bản đồ và thu thập dữ liệu bao quát toàn bộ quy trình, từ tìm một trang đến thu thập dữ liệu của cả website; Markdown và JSON có cấu trúc giúp giảm công đoạn xử lý sau khi truy xuất. Nhờ đó, sản phẩm trợ lý nghiên cứu hoặc cơ sở tri thức có thể tập trung nhiều hơn vào việc trả lời câu hỏi và ít tốn công hơn để loại bỏ các menu điều hướng khỏi HTML thô.
Tính năng Interact hiện nay mở rộng nền tảng sang các tác vụ trực tiếp trên trình duyệt. Các tác nhân có thể mô tả hành động bằng ngôn ngữ tự nhiên hoặc thực thi mã trình duyệt, duy trì trạng thái giữa các lần gọi và sử dụng lại các hồ sơ đã xác thực. Đây là một bổ sung đáng kể đối với những trang cần nhấp chuột, dùng bộ lọc hoặc đăng nhập trước khi trích xuất dữ liệu. Khả năng truy cập MCP và dòng lệnh cũng giúp Firecrawl phù hợp với quy trình phát triển tác nhân, thay vì chỉ hoạt động như một API ứng dụng thông thường.
Firecrawl phát huy hiệu quả nhất khi vấn đề trước mắt là thu thập nội dung và ứng dụng đã có sẵn hệ thống lưu trữ, truy xuất. Các nhóm vẫn cần xác định ranh giới thu thập, lưu lại URL nguồn và phân biệt trường dữ liệu bị thiếu với trường dữ liệu để trống. Mã nguồn mở của công cụ cung cấp thêm một phương án triển khai, nhưng các nhóm nên đánh giá những tính năng cụ thể và yêu cầu vận hành của phương án đã chọn, thay vì mặc định rằng phiên bản lưu trữ và phiên bản tự quản lý giống hệt nhau.
Ưu và nhược điểm
- Markdown và JSON phù hợp với các quy trình AI
- Interact hỗ trợ các tác vụ trình duyệt có trạng thái
- Truy cập qua API, MCP và CLI
- Nội dung truy xuất vẫn cần được xác thực
- Việc tự quản lý triển khai đòi hỏi công sức vận hành
3. Apify
Apify là lựa chọn nổi bật nhất ở đây dành cho các nhóm muốn có những công cụ thu thập dữ liệu web có thể tái sử dụng cùng một nền tảng để vận hành chúng. Chợ ứng dụng của Apify phân phối Actors: các chương trình đóng gói sẵn, nhận đầu vào, chạy trên đám mây và trả về kết quả. Các Actors hiện có có thể đẩy nhanh những tác vụ thu thập dữ liệu phổ biến, trong khi Actors tùy chỉnh giúp nhà phát triển duy trì logic trích xuất của riêng mình. Nhờ đó, Apify trở thành cầu nối hữu ích giữa một thử nghiệm và một tác vụ sản xuất có thể lặp lại.
Nền tảng đi kèm xử lý những khâu vận hành quan trọng, bao gồm lập lịch, lưu trữ kết quả, truy cập proxy, giám sát và tích hợp. Nhà phát triển cũng có thể xây dựng bằng Crawlee, thư viện mã nguồn mở của Apify dành cho thu thập dữ liệu và tự động hóa trình duyệt. Máy chủ MCP của Apify cung cấp Actors cho các tác nhân AI, nhờ đó cùng một công cụ đóng gói sẵn có thể phục vụ một ứng dụng, một quy trình chạy theo lịch hoặc một trợ lý mà không cần xây dựng trình thu thập dữ liệu riêng cho từng giao diện.
Việc lựa chọn Actor cũng cần được cân nhắc kỹ như việc chọn nền tảng. Các nhà phát hành khác nhau có thể đưa ra mức giá, chế độ bảo trì, tùy chọn đầu vào và chất lượng đầu ra khác nhau. Một lần chạy thành công cũng không chứng minh rằng mọi bản ghi dự kiến đều đã được thu thập. Apify hấp dẫn nhất khi có người chịu trách nhiệm về lược đồ dữ liệu của tác vụ, theo dõi các thay đổi và lập ngân sách cho Actor được chọn cũng như mức sử dụng hạ tầng; một lần trích xuất thủ công từ một trang hiếm khi cần đến mức độ điều phối này.
Ưu và nhược điểm
- Actor có sẵn và Actor tùy chỉnh cùng hoạt động trên một nền tảng
- Lập lịch, lưu trữ và giám sát hỗ trợ các tác vụ có thể chạy lặp lại
- MCP đưa các Actor vào quy trình làm việc của tác nhân
- Công tác bảo trì và chất lượng của Actor khác nhau
- Cần dự trù ngân sách cho mức sử dụng và phí Actor
4. Browse AI
Browse AI là lựa chọn chúng tôi đề xuất cho người dùng doanh nghiệp cần thu thập dữ liệu web định kỳ mà không phải xây dựng cả một dự án phần mềm. Với thiết lập hiện tại, công cụ có thể đọc trang do người dùng cung cấp, đề xuất cấu trúc dữ liệu rồi để người dùng xem xét hoặc điều chỉnh các trường. Việc huấn luyện robot vẫn là yếu tố cốt lõi để trích xuất dữ liệu một cách nhất quán. Đây là cách làm thiết thực cho các nhóm vận hành và tiếp thị cần thu thập danh sách sản phẩm, thông tin trong danh bạ hoặc dữ liệu đối thủ cạnh tranh vào những bảng quen thuộc.
Giám sát là một thế mạnh nổi bật. Robot có thể kiểm tra các trang theo lịch, phát hiện nội dung mới hoặc thay đổi, đồng thời gửi cảnh báo cho biết nội dung nào đã biến động. Quy trình làm việc có thể kết nối việc thu thập dữ liệu trên nhiều trang, còn các tích hợp API, webhook và bảng tính giúp đưa kết quả vào những công cụ nhóm đang sử dụng. Nhờ đó, quy trình theo dõi giá có thể trở thành hoạt động kinh doanh liên tục thay vì một chuỗi lần kiểm tra thủ công bằng trình duyệt.
Dù dễ tiếp cận, công cụ vẫn đòi hỏi phải xác định rõ dữ liệu cần thu thập. Người dùng nên quyết định những thay đổi nào cần được cảnh báo, đồng thời xác nhận rằng việc phân trang, các bước đăng nhập và trường hợp không có kết quả đều hoạt động chính xác. Những đợt thiết kế lại lớn vẫn có thể cần đến sự can thiệp. Browse AI phù hợp nhất khi nhóm kinh doanh có thể xem xét các hàng dữ liệu đã trích xuất và duy trì robot; các nhà phát triển cần logic trình duyệt được quản lý phiên bản chặt chẽ có thể sẽ thích dịch vụ dựa trên mã hơn.
Ưu và nhược điểm
- Thiết lập trường dữ liệu có AI hỗ trợ giúp giảm rào cản ban đầu
- Giám sát theo lịch giúp làm nổi bật những thay đổi đáng chú ý
- Kết nối với bảng tính, API và webhook
- Những thay đổi lớn trên trang web có thể đòi hỏi huấn luyện lại
- Logic phức tạp cần được thiết kế quy trình làm việc cẩn thận
5. SearchAPI
SearchAPI là lựa chọn chuyên biệt chúng tôi đề xuất để thu thập kết quả tìm kiếm dưới dạng dữ liệu có cấu trúc. API Google của công cụ có thể trả về liên kết kết quả và các tính năng tìm kiếm dưới dạng JSON, nhờ đó không cần duy trì bộ phân tích cú pháp cho một trang kết quả thường xuyên thay đổi. Danh mục rộng hơn bao gồm các nguồn như Maps, mua sắm, tin tức, video và những trải nghiệm tìm kiếm bằng AI được hỗ trợ. Công cụ đặc biệt hữu ích khi dữ liệu cần thu thập chính là thông tin khám phá và khả năng hiển thị trên công cụ tìm kiếm, chứ không chỉ là bước đệm để thu thập dữ liệu từ một trang web khác.
Khả năng bản địa hóa là một yếu tố quan trọng khiến công cụ phù hợp với nhu cầu này. Các tham số về vị trí, quốc gia, ngôn ngữ và thiết bị cho phép nhóm nghiên cứu một thị trường trong bối cảnh tìm kiếm xác định. Ứng dụng SEO có thể theo dõi một truy vấn tại một thành phố, trong khi trợ lý nghiên cứu có thể tìm các nguồn liên quan và lưu lại những liên kết được trả về để truy xuất sau này. Tài liệu dành riêng cho từng công cụ tìm kiếm rất quan trọng vì các tham số và trường kết quả hiện có khác nhau giữa các sản phẩm tìm kiếm.
Nên chọn SearchAPI dựa trên các công cụ tìm kiếm và trường dữ liệu mà quy trình thực sự cần. Kết quả tìm kiếm không bao gồm toàn bộ nội dung của trang được liên kết, và các giao diện kết quả phong phú hơn cũng không dùng chung một lược đồ. Các nhóm nên dự trù khối lượng yêu cầu, xác nhận yêu cầu về thông lượng và xử lý linh hoạt các phần kết quả bị thiếu. Nếu cần trích xuất dữ liệu từ một trang web bất kỳ hoặc thao tác trong một phiên trình duyệt tương tác, một công cụ khác trong hướng dẫn này sẽ phù hợp hơn để bắt đầu.
Ưu và nhược điểm
- Kết quả có cấu trúc giúp loại bỏ việc phải duy trì bộ phân tích cú pháp SERP
- Danh mục phong phú gồm các công cụ tìm kiếm và dịch vụ liên quan
- Các tùy chọn bản địa hóa chi tiết
- Kết quả tìm kiếm không thay thế việc trích xuất dữ liệu từ trang đích
- Các trường dữ liệu và tham số khác nhau tùy theo công cụ tìm kiếm
6. Octoparse
Octoparse minh họa cách AI Copilot kết hợp với tự động hóa có sự tham gia của con người. Video: Octoparse.
Octoparse phù hợp với các nhà phân tích muốn thiết kế trình thu thập dữ liệu bằng giao diện trực quan rồi chạy lặp lại. Nền tảng hiện tại cung cấp các mẫu dựng sẵn, thiết lập bằng AI Assistant và tính năng tự động phát hiện trang trong ứng dụng máy tính. Người dùng có thể tinh chỉnh tác vụ được tạo ra thay vì phải bắt đầu bằng mã trình duyệt. Tính linh hoạt này hữu ích khi thu thập danh mục sản phẩm, danh bạ hoặc danh sách, trong đó trình tự các trang cũng quan trọng không kém các trường dữ liệu trên từng trang.
Thực thi trên đám mây biến tác vụ đã chuẩn bị thành quy trình thu thập định kỳ mà không cần duy trì một máy tính cá nhân luôn bật. Lên lịch, xử lý song song, xoay vòng địa chỉ IP và kết nối xuất dữ liệu giúp các tác vụ lớn vượt khỏi giới hạn của bản thử nghiệm trên máy tính. Cách tiếp cận trực quan đặc biệt hấp dẫn với những nhóm am hiểu các trang web nguồn và yêu cầu dữ liệu nhưng không muốn duy trì dịch vụ tự động hóa trình duyệt tùy chỉnh.
Tuy vậy, Octoparse đòi hỏi phải thiết kế tác vụ cẩn thận. Phân trang, cuộn vô hạn, các bước điền biểu mẫu và bản ghi trùng lặp có thể làm thay đổi ý nghĩa của một lần chạy tưởng như thành công. Hạn mức sử dụng trên đám mây và các tính năng trong gói cần đáp ứng lịch chạy và khối lượng dự kiến. Chúng tôi đề xuất công cụ này cho những nhóm muốn kiểm soát các bước trích xuất nhiều hơn so với công cụ thao tác nhanh chỉ bằng một cú nhấp, đồng thời có một người phụ trách được chỉ định để điều chỉnh tác vụ khi các trang nguồn thay đổi.
Ưu và nhược điểm
- Các mẫu và tính năng hỗ trợ bằng AI giúp đơn giản hóa khâu thiết lập
- Chỉnh sửa trực quan hỗ trợ các tác vụ trích xuất dữ liệu chi tiết
- Tác vụ chạy trên đám mây hỗ trợ thu thập dữ liệu theo lịch
- Các trang web phức tạp cần tinh chỉnh tác vụ
- Các tính năng đám mây tùy thuộc vào gói đã chọn
7. Browserless
Chúng tôi đề xuất Browserless cho các nhà phát triển muốn kiểm soát trình duyệt nhưng giao việc lưu trữ và mở rộng quy mô cho một dịch vụ được quản lý. Các tập lệnh Puppeteer hoặc Playwright hiện có có thể kết nối với trình duyệt từ xa, nhờ đó dịch vụ này phù hợp với những dự án đã có mã tự động hóa hoạt động hiệu quả. Đây là lựa chọn đặc biệt hữu ích khi quá trình thu thập đòi hỏi nhiều tương tác, giao diện sử dụng nhiều JavaScript hoặc phiên làm việc cần duy trì lâu hơn một yêu cầu đơn giản.
Dịch vụ này cũng cung cấp API REST để thu thập dữ liệu, chụp ảnh màn hình, tạo tệp PDF và thực hiện các chức năng trình duyệt tùy chỉnh. Máy chủ MCP được lưu trữ của dịch vụ cung cấp các công cụ trình duyệt cho tác nhân AI, trong khi các tính năng phiên làm việc và hồ sơ đã xác thực hỗ trợ những quy trình cần duy trì tính liên tục. Vì vậy, Browserless phù hợp cả với nhà phát triển xây dựng công cụ thu thập dữ liệu tùy chỉnh lẫn tác nhân cần duyệt web và thu thập thông tin thông qua trình duyệt thực.
Điều quan trọng cần cân nhắc khi mua là cách tính mức sử dụng trình duyệt. Gói miễn phí hiện bao gồm 1.000 đơn vị mỗi tháng và hai trình duyệt chạy đồng thời, chứ không đảm bảo 1.000 lượt thu thập dữ liệu. Thời gian sử dụng trình duyệt tiêu tốn đơn vị; lưu lượng proxy và các lần giải CAPTCHA thành công sẽ phát sinh thêm phí. Giới hạn phiên làm việc tùy thuộc vào gói. Các nhóm vẫn chịu trách nhiệm về logic trích xuất và kiểm tra đầu ra, vì vậy Browserless hấp dẫn nhất khi việc kiểm soát trình duyệt quan trọng hơn một công cụ tạo robot trực quan.
Ưu và nhược điểm
- Duy trì quy trình làm việc quen thuộc với Puppeteer và Playwright
- API REST hỗ trợ thu thập dữ liệu và xuất nội dung trang
- Các tính năng phiên làm việc và MCP phù hợp với tác nhân tương tác
- Thời gian sử dụng trình duyệt và các tiện ích bổ sung ảnh hưởng đến mức tiêu thụ đơn vị
- Việc trích xuất tùy chỉnh vẫn cần logic ứng dụng
8. ScrapingBee
ScrapingBee là lựa chọn phù hợp cho các nhà phát triển muốn gửi yêu cầu thu thập dữ liệu thông qua dịch vụ được quản lý thay vì trực tiếp kiểm soát một trình duyệt chạy trong thời gian dài. API của dịch vụ kết hợp việc tải trang và kết xuất JavaScript với quản lý proxy; dữ liệu có thể được trích xuất bằng quy tắc CSS hoặc XPath, hoặc bằng chỉ dẫn AI. Sự kết hợp này hữu ích khi dự án cần dữ liệu có cấu trúc từ nhiều trang web nhưng không muốn tự vận hành một cụm trình duyệt.
Các kịch bản JavaScript có thể nhấp, cuộn, nhập văn bản hoặc chờ trước khi thu thập dữ liệu. Đầu ra Markdown hỗ trợ quy trình làm việc với nội dung AI, còn ảnh chụp màn hình giúp ghi lại trang đã kết xuất. Sản phẩm hiện cũng cung cấp các API chuyên biệt cho một số mục tiêu nhất định, cùng quyền truy cập qua CLI và MCP. Nhà phát triển có thể dùng các quy tắc trích xuất cụ thể cho những trường dữ liệu ổn định, và dùng trích xuất bằng ngôn ngữ tự nhiên khi cấu trúc trang hoặc câu hỏi khó dự đoán hơn.
Điểm khác biệt thực tế so với một nền tảng trình duyệt được lưu trữ nằm ở chỗ ScrapingBee tập trung vào yêu cầu và kết quả trả về, còn ứng dụng tùy chỉnh đảm nhiệm phần việc rộng hơn. Việc phối hợp giữa nhiều trang, loại bỏ dữ liệu trùng lặp, lên lịch làm mới và xác thực bản ghi vẫn cần được xử lý ở một nơi khác. Mức tiêu thụ tín dụng cũng thay đổi theo các tính năng được sử dụng, bao gồm kết xuất và tùy chọn proxy. Chúng tôi đề xuất công cụ này cho các nhóm phát triển ứng dụng coi trọng giao diện HTTP đơn giản và muốn tự điều phối quy trình dữ liệu bằng mã của mình.
Ưu và nhược điểm
- Quy tắc bộ chọn và tính năng trích xuất bằng AI mang lại sự linh hoạt
- Tính năng kết xuất và các kịch bản xử lý được những trang có tính tương tác
- Markdown, CLI và MCP hỗ trợ quy trình làm việc với AI
- Các tùy chọn yêu cầu nâng cao làm tăng mức sử dụng tín dụng
- Các tác vụ trên nhiều trang vẫn cần được điều phối
9. Oxylabs
Oxylabs là lựa chọn phù hợp cho các nhóm muốn được quản lý quyền truy cập vào những trang web công khai khó thu thập dữ liệu và cần khả năng mở rộng quy mô thu thập. Web API hiện tại của dịch vụ có /Scrape để truy xuất và cấu trúc dữ liệu web, tích hợp sẵn tính năng kết xuất JavaScript và xử lý quyền truy cập. Danh mục sản phẩm còn có /Search và hạ tầng trình duyệt, cung cấp cho các nhóm nhiều cách tiếp cận tùy theo tác vụ bắt đầu từ tìm kiếm, trích xuất hay tương tác.
Các tùy chọn dành riêng cho từng mục tiêu giúp những nguồn tìm kiếm và thương mại điện tử phổ biến trả về các trường dữ liệu hữu ích, còn khả năng kết nối với tác nhân thông qua MCP và Agent Skills đưa hoạt động thu thập dữ liệu vào quy trình làm việc với AI. Oxylabs cũng tiếp tục cung cấp tài liệu riêng cho Classic Web Scraper API. Điều này quan trọng với các tích hợp hiện có: nhóm đang duy trì Classic API nên sử dụng tài liệu tương ứng, thay vì cho rằng ví dụ về Web API mới hơn có thể thay thế cho phiên bản đó.
Oxylabs phù hợp nhất khi mức độ khó của mục tiêu, thông lượng hoặc chi phí duy trì hạ tầng truy cập đủ để biện minh cho việc sử dụng một nền tảng được quản lý. Ứng dụng vẫn cần xác định lược đồ mong muốn, khoảng thời gian dữ liệu còn được xem là mới và cách xử lý các bản ghi chưa đầy đủ. Trước khi triển khai, hãy bảo đảm thế hệ API, tùy chọn mục tiêu và mô hình sử dụng đã chọn phù hợp với tác vụ thực tế. Với một tác vụ trích xuất thủ công quy mô nhỏ, công cụ thu thập dữ liệu trực quan có thể phù hợp hơn.
Ưu và nhược điểm
- Hạ tầng quản lý quá trình tải trang và quyền truy cập
- Các tùy chọn trích xuất dữ liệu có cấu trúc theo từng mục tiêu
- Web API hiện tại hỗ trợ tích hợp với các tác tử
- API cổ điển và API hiện tại cần được thiết lập riêng
- Chất lượng đầu ra vẫn cần được kiểm tra ở cấp ứng dụng
10. Diffbot
Diffbot là lựa chọn của chúng tôi khi việc hiểu thông tin trên một trang quan trọng hơn việc tái tạo bố cục của trang đó. Extract sử dụng thị giác máy tính và xử lý ngôn ngữ tự nhiên để phân loại trang, rồi tạo dữ liệu JSON có cấu trúc theo các lược đồ tiêu chuẩn. Với nhóm thu thập bài viết hoặc sản phẩm từ nhiều nguồn, công cụ này có thể giảm lượng mã phân tích riêng cho từng trang web cần thiết để chuyển các trang thành những bản ghi có thể so sánh.
Knowledge Graph của Diffbot đáp ứng một nhu cầu liên quan nhưng riêng biệt: làm việc với các thực thể như tổ chức, cá nhân và bài viết đã được tập hợp từ web công khai. Các bản ghi có thể kết hợp thông tin từ nhiều nguồn và liên kết các thực thể thông qua những mối quan hệ có ý nghĩa. Nhờ vậy, Diffbot hữu ích cho việc bổ sung dữ liệu, nghiên cứu doanh nghiệp và các ứng dụng tình báo cần ngữ cảnh vượt ra ngoài những trường thông tin hiển thị trên một trang.
Điểm đánh đổi là mức độ phù hợp với mô hình dữ liệu của Diffbot. Trích xuất theo chuẩn hóa có giá trị khi các loại trang và trường dữ liệu của công cụ phù hợp với yêu cầu, nhưng nếu cần một trường thông tin khác thường hoặc một tương tác chuyên biệt, vẫn có thể phải dùng cách tiếp cận khác. Các nhóm nên phân biệt việc trích xuất từ những URL đã chọn với việc truy vấn đồ thị tri thức hiện có, sau đó đánh giá mức độ bao phủ và độ mới của nguồn dữ liệu cho phù hợp. Diffbot phù hợp với các nhóm kỹ thuật xây dựng sản phẩm thông tin đã được chuẩn hóa hơn là người dùng chỉ cần sao chép một vài hàng vào bảng tính.
Ưu và nhược điểm
- Tự động phân loại giúp giảm công sức viết bộ phân tích
- Các lược đồ tiêu chuẩn giúp chuẩn hóa những trang tương tự nhau
- Knowledge Graph bổ sung ngữ cảnh về thực thể
- Các trường tiêu chuẩn có thể không đáp ứng yêu cầu chuyên biệt
- Trích xuất dữ liệu và truy cập đồ thị phục vụ các quy trình làm việc khác nhau
Câu hỏi thường gặp
Điều gì khiến một công cụ quét dữ liệu web được hỗ trợ bởi AI?
AI có thể giúp xác định các trường dữ liệu, diễn giải nội dung trang, tạo các bước trích xuất hoặc điều khiển thao tác trên trình duyệt. Một số công cụ sử dụng AI trong quá trình thiết lập; những công cụ khác dùng AI cho mỗi lần trích xuất. Dịch vụ cũng có thể hỗ trợ các ứng dụng AI bằng cách cung cấp nội dung sạch mà không cần dùng mô hình ngôn ngữ cho mọi yêu cầu. Hãy chọn năng lực giải quyết vấn đề thu thập dữ liệu của bạn, thay vì chỉ dựa vào nhãn gọi.
Quét dữ liệu và tự động hóa trình duyệt khác nhau như thế nào?
Quét dữ liệu là thu thập thông tin. Tự động hóa trình duyệt thực hiện các thao tác trên trang, chẳng hạn như mở menu, nhập nội dung tìm kiếm hoặc làm theo quy trình nhiều bước. Hai cách này thường được dùng kết hợp: trình duyệt tự động truy cập đến trạng thái trang cần thiết, sau đó một bước trích xuất sẽ thu thập các trường dữ liệu. Khi không cần những thao tác tương tác đó, yêu cầu trực tiếp qua API thường đơn giản hơn.
Công cụ nào phù hợp nhất với nhóm không chuyên về kỹ thuật?
Browse AI là đề xuất hàng đầu của chúng tôi cho việc thu thập dữ liệu định kỳ đơn giản và theo dõi thay đổi. Octoparse là lựa chọn thay thế tốt nếu nhóm muốn kiểm soát trực quan hơn các bước thực hiện tác vụ. Cả hai hoạt động hiệu quả nhất khi có người rà soát các bản ghi thu được và nhận biết được lúc trang web nguồn thay đổi.
Một quy trình xử lý AI hoặc RAG nên lưu giữ những gì từ dữ liệu đã quét?
Hãy lưu URL nguồn, thời điểm thu thập, tiêu đề trang và văn bản hoặc các trường dữ liệu có cấu trúc mà ứng dụng cần. Markdown có thể giữ nguyên cấu trúc tài liệu dễ đọc, còn JSON hỗ trợ các bản ghi được xác định rõ. Hãy loại bỏ nội dung trùng lặp và tránh trộn lẫn văn bản điều hướng với nội dung chính. Lưu giữ thông tin về nguồn gốc giúp dễ dàng truy vết và cập nhật các câu trả lời sau này.
Khi nào nên sử dụng trình duyệt được quản lý?
Trình duyệt được quản lý hữu ích khi việc thu thập dữ liệu cần chạy JavaScript, thực hiện nhiều thao tác tương tác hoặc duy trì phiên làm việc, đồng thời nhóm của bạn muốn tránh phải tự lưu trữ các tiến trình trình duyệt. Browserless là lựa chọn chuyên biệt dành cho mã Puppeteer hoặc Playwright hiện có. Với một trang tĩnh duy nhất, API lấy dữ liệu hoặc trích xuất đơn giản hơn có thể tiêu tốn ít tài nguyên hơn.
1.000 đơn vị miễn phí có tương đương với 1.000 lần quét dữ liệu không?
Không. Mỗi nhà cung cấp có quy định riêng về đơn vị và tín dụng. Browserless tính phí kết nối trình duyệt theo từng khoảng tối đa 30 giây, đồng thời tiêu thụ thêm đơn vị cho lưu lượng proxy và việc giải CAPTCHA. Các dịch vụ khác tính phí dựa trên tùy chọn yêu cầu, số lượng bản ghi hoặc mức sử dụng tài nguyên tính toán. Hãy ước tính toàn bộ quy trình thay vì coi các hạn mức miễn phí khác nhau là tương đương.
Có thể tin cậy kết quả trích xuất bằng AI mà không cần rà soát không?
Một phản hồi JSON hợp lệ vẫn có thể bỏ sót bản ghi hoặc diễn giải sai một trường dữ liệu. Hãy xác định các trường bắt buộc, kiểm tra kiểu dữ liệu và phạm vi giá trị, lấy mẫu các trang nguồn và theo dõi những thay đổi về số lượng bản ghi. Với các tác vụ định kỳ, việc xác định rõ trạng thái lỗi và kết quả rỗng sẽ hữu ích hơn là coi mọi phản hồi đều là một tập dữ liệu hoàn chỉnh.
Lời kết về các công cụ quét dữ liệu web bằng AI
Bright Data là lựa chọn hàng đầu của chúng tôi cho các chương trình dữ liệu web trên diện rộng, trong khi Firecrawl là điểm khởi đầu tốt nhất để chuyển đổi trang web thành nội dung sẵn sàng cho AI. Hãy chọn Apify khi các công cụ có thể tái sử dụng, tác vụ được lên lịch và hoạt động trên đám mây là những yếu tố trọng tâm của dự án.
Đối với các nhóm doanh nghiệp, Browse AI giúp việc giám sát định kỳ trở nên dễ tiếp cận, còn Octoparse cung cấp cho người dùng cách trực quan để tinh chỉnh các tác vụ trích xuất phức tạp hơn. SearchAPI là lựa chọn chuyên biệt khi đầu ra cần có là dữ liệu tìm kiếm có cấu trúc.
Browserless xứng đáng có mặt trong danh sách này nhờ khả năng thực thi trình duyệt được quản lý, dành cho các nhà phát triển muốn sử dụng những thư viện tự động hóa quen thuộc. ScrapingBee là một lựa chọn thay thế đáng cân nhắc khi yêu cầu trích xuất dữ liệu được quản lý phù hợp với ứng dụng hơn. Oxylabs phù hợp với nhu cầu truy xuất dữ liệu web công khai ở quy mô lớn, còn Diffbot nổi bật nhờ khả năng trích xuất theo chuẩn hóa và phân tích thông tin về thực thể.
Lựa chọn tốt nhất về lâu dài là công cụ cung cấp thông tin cần thiết thông qua quy trình mà nhóm của bạn có thể duy trì. Hãy chọn phương thức thu thập phù hợp với nhiệm vụ, giữ lại ngữ cảnh của nguồn và đánh giá giá trị dựa trên đầu ra hữu ích, thay vì số lượng trang được yêu cầu.




