
Tốt nhất
10 Công cụ AI Web Scraping Tốt Nhất (Tháng 9 2026)

 Thêm Unite.AI vào các nguồn ưu tiên của bạn trên Google
Unite.AI có thể nhận thù lao khi bạn dùng liên kết đến sản phẩm chúng tôi đánh giá. Điều này không ảnh hưởng đến đánh giá biên tập của chúng tôi. Đọc công bố liên kết của chúng tôi.
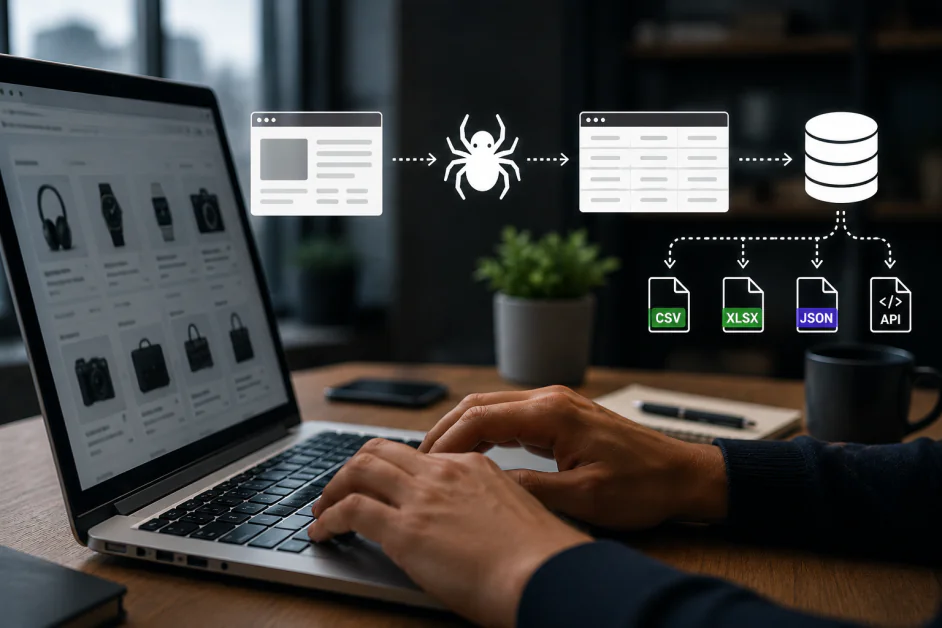
Các công cụ AI thu thập dữ liệu web không còn chỉ là các bộ phân tích trang nữa. Các nền tảng hàng đầu hiện giúp các đội ngũ thu thập dữ liệu công cộng trên web, chuyển các trang hỗn độn thành bộ dữ liệu có cấu trúc, cung cấp dữ liệu cho các hệ thống tạo sinh tăng cường truy xuất, giám sát thị trường và cung cấp ngữ cảnh web đáng tin cậy cho các tác nhân AI.
Sự chuyển đổi này quan trọng vì việc scraping đã trở nên có giá trị hơn và khó thực hiện tốt hơn. Các website hiện đại mang tính động, cá nhân hoá, có nhiều script và thường được bảo vệ bởi các hệ thống chống lạm dụng. Một công cụ scraping hữu ích phải làm được nhiều hơn việc chỉ lấy HTML. Nó cần xử lý việc render, logic trích xuất, lập lịch, chất lượng dữ liệu, tuân thủ và việc chuyển giao dữ liệu vào các hệ thống thực tế sử dụng.
Lựa chọn phù hợp phụ thuộc vào công việc. Một số đội cần hạ tầng cấp doanh nghiệp cho các chương trình dữ liệu công cộng quy mô lớn. Những đội khác cần Markdown sẵn sàng cho LLM, robot không-code cho nghiên cứu định kỳ, nền tảng dành cho nhà phát triển để tự động hoá trình duyệt, hoặc API kết quả tìm kiếm chuyên biệt. Các công cụ dưới đây bao quát các cách tiếp cận khác nhau.
Nhóm chúng tôi đã tự đánh giá độc lập từng giải pháp trong hướng dẫn này, xem xét khả năng, điểm mạnh thực tiễn, hạn chế và mức độ phù hợp với các trường hợp sử dụng được phản ánh trong bảng xếp hạng.
Các công cụ AI Web Scraping tốt nhất được so sánh
| Công cụ AI | Phù hợp nhất cho | Điểm mạnh chính |
|---|---|---|
| Bright Data | Thu thập dữ liệu web doanh nghiệp, hạ tầng proxy và các quy trình dữ liệu AI | API Scraper, API Trình duyệt, Scraper Studio, Web Unlocker, hạ tầng proxy, bộ dữ liệu, quy trình RAG |
| Firecrawl | Biến các trang web thành nội dung sạch, sẵn sàng cho LLM cho các ứng dụng AI | Thu thập, thu thập sâu, tìm kiếm, lập bản đồ, giám sát, Markdown, JSON có cấu trúc, tương tác trình duyệt, API, MCP, mã nguồn mở |
| Apify | Các nhà phát triển xây dựng scraper quy mô lớn, tự động hoá trình duyệt và các tác nhân dữ liệu | Chợ Actor, Crawlee, Playwright, Puppeteer, Selenium, lên lịch, proxy, bộ dữ liệu, API, tích hợp MCP |
| Browse AI | Thu thập dữ liệu web không cần mã, giám sát website và thu thập dữ liệu kinh doanh định kỳ | Robot AI, đào tạo bằng kéo và nhấp, giám sát website, trích xuất theo lịch, robot đã xây dựng sẵn, tích hợp |
| SearchAPI | Dữ liệu SERP và công cụ tìm kiếm thời gian thực cho AI, SEO và quy trình nghiên cứu | Google, Google Maps, Bing, YouTube, dữ liệu mua sắm và tin tức, JSON có cấu trúc, định vị địa lý, xoay proxy, thử lại, MCP |
| ScrapingBee | API scraping thân thiện với nhà phát triển, có khả năng trích xuất AI và render JavaScript | Trích xuất ngôn ngữ tự nhiên, JSON có cấu trúc, Markdown, kịch bản JavaScript, xoay proxy, ảnh chụp màn hình, API chuyên dụng, CLI, MCP |
| Octoparse | Thu thập dữ liệu không mã trực quan cho các website động và công việc đám mây định kỳ | Trình xây dựng quy trình trực quan, phát hiện tự động AI, trích xuất đám mây, mẫu, xoay IP, lên lịch, xuất dữ liệu, API |
| Oxylabs | API scraping doanh nghiệp, nền tảng AI grounding và các website công cộng khó | API Web Scraper, AI Studio, Trình duyệt không giao diện, Web Unblocker, Fast Search API, dữ liệu có cấu trúc, định vị địa lý |
| Diffbot | Phân loại trang tự động, trích xuất thực thể và truy cập Knowledge Graph | API Extract, API Crawl, Knowledge Graph, làm giàu thực thể, xử lý ngôn ngữ tự nhiên, thị giác máy tính, bộ dữ liệu có cấu trúc |
| ScrapeGraphAI | Trích xuất ngôn ngữ tự nhiên với JSON có cấu trúc và tích hợp khung AI | Trích xuất dựa trên prompt, schema JSON, thu thập, giám sát, render JavaScript, SDK, CLI, MCP, tích hợp LangChain và CrewAI |
Cách chọn công cụ AI Web Scraping
Bắt đầu bằng việc xác định loại vấn đề dữ liệu web mà bạn thực sự đang gặp. Nếu mục tiêu là cung cấp cho sản phẩm AI ngữ cảnh web sạch, ưu tiên Markdown, JSON có cấu trúc, các điều khiển thu thập và đầu ra thân thiện với truy xuất. Nếu mục tiêu là nghiên cứu kinh doanh định kỳ, một robot không-code hoặc trình xây dựng quy trình trực quan có thể nhanh hơn. Nếu mục tiêu là thu thập dữ liệu công cộng quy mô lớn, hãy tìm kiếm độ sâu hạ tầng: render, hàng đợi, kiểm soát proxy, mở khóa, giám sát và giao hàng đáng tin cậy.
Câu hỏi thứ hai là ai sẽ duy trì quy trình. Một đội marketing theo dõi các trang đối thủ cần một sản phẩm rất khác so với đội kỹ thuật xây dựng pipeline dữ liệu. Các hệ thống scraping tốt làm cho việc trích xuất có thể lặp lại, nhưng chúng không loại bỏ nhu cầu xác thực. Các website thay đổi, các trường dữ liệu trôi dạt, và việc trích xuất hỗ trợ AI có thể tự tin ngay cả khi trang không rõ ràng. Cấu hình tốt nhất là cấu hình phù hợp với kỹ năng kỹ thuật, quy trình kiểm duyệt và nghĩa vụ tuân thủ của đội bạn.
10 Công cụ AI Web Scraping tốt nhất
1. Bright Data
Bright Data là lựa chọn mạnh mẽ nhất khi việc thu thập dữ liệu web là một hệ thống kinh doanh cốt lõi thay vì một dự án phụ. Nó kết hợp API scraper, hạ tầng trình duyệt, quản lý proxy, công nghệ mở khóa và các bộ dữ liệu có sẵn, cho phép các đội thu thập dữ liệu công cộng trên web ở quy mô lớn mà không phải tự lắp ráp mọi lớp.
Nền tảng này đặc biệt hữu ích cho các công ty xây dựng trí tuệ thị trường, giám sát thương mại điện tử, trí tuệ tìm kiếm, bộ dữ liệu đào tạo AI, quy trình tạo sinh tăng cường truy xuất, hoặc các sản phẩm dữ liệu cạnh tranh. Bright Data cung cấp cho các đội kỹ thuật đủ quyền kiểm soát để xây dựng quy trình phức tạp, đồng thời cung cấp các đường dẫn quản lý cho những đội muốn dữ liệu có cấu trúc mà không phải duy trì một stack scraping mong manh.
Phạm vi rộng này cũng là yếu tố quyết định mua hàng. Bright Data trở nên hợp lý nhất khi một tổ chức có thể giao trách nhiệm kỹ thuật hoặc vận hành dữ liệu, xác định các mục tiêu được phê duyệt và giám sát chất lượng, chi phí theo thời gian. Các đội nhỏ với danh sách trang dễ dàng có thể được phục vụ tốt hơn bởi một API nhẹ hơn hoặc dịch vụ không-code, trong khi các chương trình có quy định cần đồng bộ chính sách thu thập với kiểm tra pháp lý và quyền riêng tư.
Ưu và Nhược điểm
- Phạm vi hạ tầng rộng nhất trong bảng xếp hạng này
- Phù hợp mạnh mẽ cho các website công cộng có khối lượng lớn và khó khăn
- Các scraper và bộ dữ liệu có sẵn giảm thời gian xây dựng
- Hữu ích cho các quy trình dữ liệu AI, trí tuệ tìm kiếm và giám sát thương mại điện tử
- Cần nhiều hạ tầng hơn so với các dự án nhỏ, không thường xuyên
- Các đội vẫn cần quy trình quản trị dữ liệu rõ ràng và quy tắc cho các trang mục tiêu
- Các trường hợp sử dụng nâng cao đòi hỏi thiết lập kỹ thuật và giám sát
2. Firecrawl
Firecrawl được xây dựng cho thời đại AI của web scraping. Thay vì buộc các nhà phát triển phải làm sạch HTML thô, quản lý render trang và chuẩn hoá nội dung hỗn độn bằng tay, nó biến các trang web thành Markdown sạch hoặc dữ liệu có cấu trúc có thể cung cấp cho các tác nhân, hệ thống truy xuất, công cụ nghiên cứu và quy trình sản phẩm.
Điểm hấp dẫn là sự đơn giản ở lớp ứng dụng. Các nhà phát triển có thể scrape một trang, crawl một site, tìm kiếm trên web, lập bản đồ URL, giám sát thay đổi, hoặc yêu cầu đầu ra có cấu trúc với ít công việc hạ tầng hơn so với một stack scraper truyền thống. Firecrawl đặc biệt phù hợp khi sản phẩm cuối là trợ lý AI, cơ sở tri thức, quy trình nghiên cứu hoặc hệ thống tạo sinh tăng cường truy xuất.
Các đội nên xem Firecrawl như lớp thu thập nội dung chứ không phải toàn bộ nền tảng dữ liệu. Việc sử dụng trong sản xuất vẫn cần xác định phạm vi nguồn, loại bỏ trùng lặp, quy tắc tươi mới, xác thực schema và khả năng quan sát khi các site thay đổi. Giá trị của nó cao nhất khi các nhà phát triển muốn một API ngắn gọn và tùy chọn tự host, nhưng không cần các kiểm soát proxy rộng hay bộ dữ liệu quản lý mà các nhà cung cấp hạ tầng doanh nghiệp cung cấp.
Ưu và Nhược điểm
- Phù hợp tuyệt vời cho các ứng dụng AI cần ngữ cảnh web sạch
- Markdown và đầu ra có cấu trúc giảm công việc dọn dẹp sau này
- Giao diện API hữu ích cho các quy trình scrape, crawl, search, map và monitor
- Lựa chọn mã nguồn mở mang lại cho các đội kỹ thuật tính linh hoạt triển khai cao hơn
- Không phải là nền tảng proxy đầy đủ hay hạ tầng dữ liệu doanh nghiệp
- Việc trích xuất phức tạp vẫn cần thiết kế và xác thực schema
- Các đội có yêu cầu tuân thủ nghiêm ngặt nên xem xét cẩn thận các lựa chọn triển khai và lưu trữ
3. Apify
Apify là lựa chọn mạnh mẽ cho các đội muốn cả nền tảng dành cho nhà phát triển và một chợ lớn các công cụ tự động hoá web có sẵn. Mô hình Actor của nó cho phép đóng gói scraper, tự động hoá trình duyệt và quy trình dữ liệu thành các job đám mây có thể tái sử dụng, có thể lên lịch, gọi qua API, kết nối với lưu trữ và chia sẻ trong toàn đội.
Nhà phát triển có một lộ trình thực tiễn từ nguyên mẫu tới sản xuất. Họ có thể xây dựng với Crawlee, Playwright, Puppeteer, Selenium hoặc các Actor hiện có, sau đó dùng Apify để thực thi, quản lý hàng đợi, proxy, bộ dữ liệu, webhook và tích hợp. Điều này làm cho nó đặc biệt hữu ích cho các đội cần các job dữ liệu lặp lại thay vì việc trích xuất một lần.
Tính linh hoạt của Apify là một điểm mạnh và cũng là trách nhiệm. Các đội cần chọn các Actor đáng tin cậy, kiểm soát phiên bản, giám sát chạy và dự trù chi phí cho tính toán, proxy và lưu trữ khi khối lượng công việc tăng. Nó phù hợp nhất cho các nhà phát triển muốn các khối xây dựng tái sử dụng và vận hành đám mây trong một nơi; người dùng không thường xuyên có thể thấy một scraper chuyên dụng nhanh hơn để học.
Ưu và Nhược điểm
- Chợ lớn các Actor có sẵn cho các mục tiêu phổ biến
- Công cụ mạnh mẽ cho nhà phát triển để tùy chỉnh scraping và tự động hoá trình duyệt
- Phù hợp cho các quy trình thu thập dữ liệu định kỳ, có lịch trình
- Hỗ trợ Crawlee cung cấp cho các đội kỹ thuật nền tảng mã nguồn mở linh hoạt
- Chất lượng chợ thay đổi tùy theo Actor và trường hợp sử dụng
- Các công việc tùy chỉnh vẫn cần bảo trì khi website thay đổi
- Người dùng không kỹ thuật có thể thích một công cụ scraper trực quan đơn giản hơn
4. Browse AI
Browse AI là lựa chọn tốt nhất cho các đội kinh doanh cần dữ liệu web nhưng không muốn tự xây dựng scraper. Người dùng đào tạo robot bằng cách chỉ cho nó những gì cần thu thập, sau đó chạy robot theo yêu cầu hoặc theo lịch. Điều này làm cho nó hữu ích cho việc theo dõi đối thủ, giám sát danh sách, thu thập tiềm năng, theo dõi tồn kho, hoặc biến nghiên cứu lặp đi lặp lại thành quy trình định kỳ.
Điểm mạnh của nó là khả năng tiếp cận. Browse AI cung cấp cho các bộ phận vận hành, marketing, tuyển dụng, thương mại điện tử và nghiên cứu một cách thực tế để thu thập dữ liệu có cấu trúc từ website mà không cần kỹ thuật viên duy trì mọi selector. Nó không cố gắng trở thành nền tảng dành cho nhà phát triển sâu nhất; nó cố gắng làm cho việc thu thập dữ liệu web lặp lại trở nên dễ tiếp cận.
Browse AI hoạt động tốt nhất khi quy trình mục tiêu có thể được minh họa rõ ràng và được con người kiểm tra. Người dùng nên kiểm tra phân trang, bước đăng nhập, trạng thái trống và thay đổi bố cục trước khi dựa vào tự động hoá để đưa ra quyết định. Nó là lựa chọn mạnh cho các dự án phòng ban, nhưng các chương trình do kỹ thuật lãnh đạo có thể cần kiểm soát chi tiết hơn về retry, hợp đồng dữ liệu và triển khai.
Ưu và Nhược điểm
- Trải nghiệm không-code mạnh mẽ cho người dùng doanh nghiệp
- Phù hợp cho giám sát định kỳ và quy trình kiểu bảng tính
- Đào tạo robot bằng kéo và nhấp dễ hơn so với thiết lập dựa trên selector
- Hữu ích cho các đội cần dữ liệu web mà không cần hỗ trợ kỹ thuật
- Ít linh hoạt hơn so với các nền tảng dành cho nhà phát triển khi xử lý logic phức tạp
- Robot có thể cần điều chỉnh khi các trang mục tiêu thay đổi đáng kể
- Các chương trình lớn hoặc tùy chỉnh cao có thể vượt quá khả năng của cách tiếp cận không-code
5. SearchAPI
SearchAPI là dịch vụ scraping chuyên biệt cho các đội cần kết quả công cụ tìm kiếm hiện tại dưới dạng dữ liệu có cấu trúc thay vì các trang kết quả thô. Một giao diện API duy nhất có thể trả về liên kết tự nhiên, quảng cáo, tin tức, danh sách bản đồ, kết quả mua sắm, bảng thông tin kiến thức, câu hỏi People Also Ask, tính năng tìm kiếm do AI tạo và các loại kết quả khác ở dạng JSON, tùy thuộc vào engine được chọn.
Nền tảng này đặc biệt hữu ích cho việc giám sát SEO, phân tích tìm kiếm địa phương, nghiên cứu thị trường, trí tuệ sản phẩm và các tác nhân AI cần ngữ cảnh tìm kiếm thời gian thực. SearchAPI quản lý render trình duyệt, xoay proxy, retry và xử lý CAPTCHA phía sau yêu cầu, trong khi các tham số địa phương hoá hỗ trợ truy vấn theo quốc gia, ngôn ngữ, vị trí và thiết bị. Các engine được tài liệu hoá mở rộng vượt ra ngoài kết quả Google tiêu chuẩn sang các nguồn như Google Maps, Bing, YouTube, tin tức và trải nghiệm tìm kiếm thương mại.
SearchAPI cũng cung cấp một máy chủ MCP để kết nối các trợ lý AI được hỗ trợ và môi trường phát triển với công cụ tìm kiếm của mình. Sự đánh đổi là tính chuyên môn: đây là lớp dữ liệu tìm kiếm mạnh, không phải là trình crawl tổng quát để trích xuất các trường tùy ý từ bất kỳ website nào. Người mua cũng nên mô hình hóa việc sử dụng cẩn thận vì các gói dựa trên tín dụng, thông lượng thay đổi theo tier, và các bề mặt tìm kiếm phong phú vẫn cần kiểm tra schema khi bố cục phía trên thay đổi.
Ưu và Nhược điểm
- Trả về dữ liệu SERP thời gian thực có cấu trúc mà không cần duy trì scraper tìm kiếm hay hạ tầng proxy
- Hỗ trợ các công cụ tìm kiếm chính, bản đồ, video, tin tức, mua sắm và các engine kết quả chuyên biệt khác
- Kiểm soát vị trí, ngôn ngữ, quốc gia và thiết bị phù hợp cho theo dõi xếp hạng và nghiên cứu thị trường
- Truy cập API và MCP làm cho dữ liệu tìm kiếm thực tiễn cho các ứng dụng và tác nhân AI
- Tập trung vào dữ liệu kết quả công cụ tìm kiếm thay vì thu thập website bất kỳ
- Các gói dựa trên tín dụng và giới hạn thông lượng đòi hỏi dự báo cho khối lượng công việc lớn
- Các ứng dụng nên xác thực các trường khi công cụ tìm kiếm thay đổi bố cục kết quả
6. ScrapingBee
ScrapingBee là API thân thiện với nhà phát triển cho các đội muốn thu thập và cấu trúc dữ liệu web mà không phải duy trì trình duyệt không giao diện hoặc hạ tầng proxy. Nó kết hợp render JavaScript, xoay proxy, ảnh chụp màn hình, trích xuất CSS/XPath và một lớp trích xuất AI biến các yêu cầu ngôn ngữ tự nhiên và quy tắc trường thành JSON có cấu trúc.
Nền tảng này đặc biệt hữu ích khi các nhà phát triển muốn một endpoint cho cả các trang đơn giản và các site tương tác. Các kịch bản JavaScript có thể click, scroll, type hoặc chờ trước khi trích xuất, trong khi đầu ra Markdown, API chuyên dụng, CLI và tích hợp MCP giúp nội dung đã scrape di chuyển vào phân tích, tự động hoá và quy trình AI. ScrapingBee đơn giản hơn để áp dụng so với một stack scraping đầy đủ, dù việc tiêu thụ tín dụng có thể thay đổi tùy vào proxy cao cấp, render và tính năng AI.
ScrapingBee phù hợp nhất khi kỹ sư muốn một lớp yêu cầu được quản lý trong khi vẫn giữ việc điều phối và chất lượng dữ liệu trong ứng dụng của mình. Các đội nên xác định quy tắc retry, schema, giới hạn crawl và xác thực cho các job đa trang thay vì coi mỗi phản hồi HTTP thành dữ liệu đáng tin cậy. Một scraper desktop trực quan sẽ dễ hơn cho người dùng không kỹ thuật, nhưng các đội API sẽ có kiểm soát trực tiếp hơn trong tích hợp và triển khai.
Ưu và Nhược điểm
- Trích xuất AI ngôn ngữ tự nhiên có thể trả về JSON có cấu trúc mà không cần selector tự tạo
- Render JavaScript và các hành động script xử lý nhiều quy trình trang động
- Xoay proxy, ảnh chụp màn hình, đầu ra Markdown và API chuyên dụng đều có sẵn qua một dịch vụ
- CLI, MCP và tích hợp tự động phù hợp cho quy trình nhà phát triển và tác nhân
- Sử dụng tín dụng tăng khi yêu cầu có thêm trích xuất AI, proxy cao cấp hoặc render JavaScript
- Đây là sản phẩm ưu tiên API hơn là công cụ scraper trực quan trên máy tính để bàn
- Việc thu thập đa trang phức tạp vẫn cần sự điều phối và kiểm tra chất lượng
7. Octoparse
Octoparse là một scraper không-code trưởng thành cho người dùng muốn một quy trình làm việc trực quan thay vì một framework dành cho nhà phát triển. Nó có thể phát hiện dữ liệu trang, hướng dẫn người dùng qua các bước trích xuất và chạy các job scraping trên đám mây, làm cho nó hữu ích cho việc thu thập định kỳ từ các site thương mại điện tử, danh bạ, danh sách, trang tìm kiếm và các nguồn web có cấu trúc khác.
Nền tảng này mạnh nhất khi một đội cần kiểm soát quy trình nhiều hơn so với một scrape nhanh bằng extension trình duyệt nhưng vẫn muốn tránh viết code. Các mẫu, lên lịch, trích xuất đám mây, xuất tự động và hỗ trợ các trang động làm cho Octoparse là một lựa chọn trung gian thực tế giữa các công cụ không-code đơn giản và các nền tảng scraping do kỹ thuật lãnh đạo.
Model trực quan vẫn đòi hỏi thiết kế quy trình cẩn thận. Các đội nên kiểm tra phân trang, cuộn vô hạn, trạng thái đăng nhập, bản ghi trùng lặp và nhánh lỗi trước khi dựa vào các job đã lên lịch. Octoparse phù hợp với các nhà phân tích và người vận hành có thể chịu trách nhiệm những kiểm tra này, trong khi các nhà phát triển xây dựng pipeline phiên bản chặt chẽ có thể thích một API hoặc framework code-first với kiểm soát nguồn và kiểm thử tự động mạnh hơn.
Ưu và Nhược điểm
- Trình xây dựng quy trình trực quan cung cấp cho người dùng nhiều kiểm soát hơn so với công cụ một-click đơn giản
- Trích xuất đám mây giúp các job định kỳ chạy mà không cần máy cục bộ
- Mẫu giảm thời gian thiết lập cho các trang và loại dữ liệu phổ biến
- Phù hợp cho các đội vận hành cần các bộ dữ liệu có cấu trúc có thể lặp lại
- Thiết kế quy trình có thể tốn thời gian trên các website phức tạp
- Ít tự nhiên cho các đội phát triển thích pipeline dựa trên mã
- Cần giám sát liên tục khi các trang mục tiêu thay đổi
8. Oxylabs
Oxylabs là lựa chọn mạnh mẽ cho các đội cần truy cập dữ liệu web công cộng đáng tin cậy ở quy mô lớn và không muốn tự quản lý xoay proxy, render và các lớp chống chặn. API Web Scraper của họ được thiết kế để thu thập dữ liệu công cộng có cấu trúc từ nhiều mục tiêu khác nhau trong khi xử lý hầu hết hạ tầng scraping phía sau.
Công ty cũng đã đẩy sâu hơn vào các quy trình dữ liệu AI với AI Studio, Fast Search API, tự động hoá trình duyệt và các trường hợp sử dụng hướng grounding. Điều này làm cho Oxylabs phù hợp với các tổ chức xây dựng hệ thống trí tuệ thị trường, giám sát tìm kiếm, pipeline grounding mô hình, bộ dữ liệu thương mại điện tử và quy trình tác nhân cần ngữ cảnh web mới.
Oxylabs trở nên hấp dẫn nhất khi độ tin cậy, độ khó của mục tiêu hoặc phạm vi địa lý biện minh cho một dịch vụ hướng doanh nghiệp. Người mua nên lập bản đồ các site mục tiêu, yêu cầu đầu ra, thời gian phản hồi và trách nhiệm tuân thủ trước khi chọn cấu hình sản phẩm. Các dự án nhỏ có thể không sử dụng hết độ sâu hạ tầng của nền tảng, trong khi các chương trình lớn vẫn cần giám sát chất lượng độc lập vì việc thu thập thành công không đồng nghĩa với việc chuẩn hoá chính xác.
Ưu và Nhược điểm
- Hạ tầng scraping và proxy cấp doanh nghiệp mạnh mẽ
- Hữu ích cho các pipeline dữ liệu web công cộng cần quy mô và độ tin cậy
- AI Studio và Fast Search API hỗ trợ các quy trình tác nhân và grounding
- Phù hợp cho các website động khó và thu thập dựa trên vị trí địa lý
- Phù hợp nhất cho các đội có yêu cầu kỹ thuật và tuân thủ rõ ràng
- Có thể nhiều hạ tầng hơn so với các dự án không-code nhỏ
- Các quy trình nâng cao cần lựa chọn mục tiêu và xác thực cẩn thận
9. Diffbot
Diffbot khác với hầu hết các công cụ web scraping vì nó tập trung vào việc hiểu trang và thực thể, không chỉ thu thập các trường. Công nghệ trích xuất của nó phân loại trang, xác định các thực thể có cấu trúc và kết nối dữ liệu web với Knowledge Graph rộng hơn, điều này hữu ích khi mục tiêu là thông tin đã làm giàu, chuẩn hoá thay vì các hàng dữ liệu thô.
Điều này làm cho Diffbot đặc biệt phù hợp cho các đội làm việc về trí tuệ thực thể, dữ liệu công ty và con người, nghiên cứu thị trường, Knowledge Graph, giám sát truyền thông và các hệ thống AI cần các sự kiện có cấu trúc từ web mở. Nó ít phải là một scraper click-and-point nhanh và hơn là một lớp trích xuất và kiến thức quy mô web.
Câu hỏi mua hàng chính là liệu mô hình dữ liệu của Diffbot có phù hợp với các thực thể và mối quan hệ mà dự án cần không. Khi phù hợp, các đội có thể tránh xây dựng các parser trang cụ thể và pipeline làm giàu từ đầu. Khi không phù hợp, một scraper thông thường có thể cung cấp kiểm soát trực tiếp hơn. Đánh giá nên bao gồm các trang đại diện, độ phủ trường, tần suất cập nhật, giải quyết thực thể và cách duy trì nguồn gốc dữ liệu downstream.
Ưu và Nhược điểm
- Khả năng trích xuất tự động mạnh mẽ và hiểu thực thể
- Truy cập Knowledge Graph cung cấp ngữ cảnh vượt ra ngoài một trang duy nhất
- Hữu ích cho việc làm giàu dữ liệu, nghiên cứu và quy trình trí tuệ có cấu trúc
- Phù hợp khi các thực thể đã chuẩn hoá quan trọng hơn so với bảng dữ liệu thô
- Ít trực quan cho việc scraping kiểu bảng tính đơn giản
- Kết quả tốt nhất phụ thuộc vào việc mô hình Diffbot có phù hợp với loại nội dung mục tiêu hay không
- Các đội cần hiểu Knowledge Graph và mô hình API để khai thác giá trị đầy đủ
10. ScrapeGraphAI
ScrapeGraphAI được thiết kế cho người dùng muốn mô tả dữ liệu họ cần bằng ngôn ngữ tự nhiên và nhận đầu ra có cấu trúc. Thay vì viết selector cho mỗi trường, các đội có thể cung cấp URL, định nghĩa thông tin mong muốn và sử dụng trích xuất hỗ trợ AI để trả về JSON sạch cho các ứng dụng, quy trình nghiên cứu hoặc tác nhân.
Đây là lựa chọn tốt cho các nhà phát triển xây dựng quy trình AI quanh dữ liệu web, đặc biệt khi nhiệm vụ trích xuất thay đổi thường xuyên hoặc cần kết nối với các framework như LangChain, CrewAI, SDK, công cụ dòng lệnh hoặc môi trường hỗ trợ MCP. Ưu điểm chính là tính linh hoạt: logic trích xuất có thể dựa trên prompt thay vì bị ràng buộc hoàn toàn vào các selector dễ vỡ.
Sự linh hoạt này làm cho việc xác thực trở nên quan trọng. Các đội nên xác định schema, hành vi retry, trường bằng chứng và quy tắc xem xét mẫu trước khi đưa vào sản xuất, vì một câu trả lời có vẻ hợp lý không nhất thiết là một trích xuất hoàn chỉnh. ScrapeGraphAI hấp dẫn cho các thí nghiệm và quy trình thích ứng, trong khi các job ổn định, khối lượng lớn vẫn có thể hưởng lợi từ selector quyết định hoặc một cách tiếp cận lai sử dụng AI chỉ khi cấu trúc trang thay đổi.
Ưu và Nhược điểm
- Trích xuất ngôn ngữ tự nhiên hữu ích cho các nhiệm vụ thay đổi hoặc khám phá
- Đầu ra JSON có cấu trúc phù hợp với các ứng dụng AI và quy trình tự động
- Tích hợp cho nhà phát triển hỗ trợ các trường hợp sử dụng tác nhân và điều phối
- Hữu ích khi việc bảo trì selector sẽ làm chậm quá trình thử nghiệm
- Việc trích xuất AI cần được xác thực trước khi sử dụng trong môi trường sản xuất
- Thiết kế prompt và schema ảnh hưởng đến tính nhất quán của đầu ra
- Ít phù hợp cho các đội cần quy trình làm việc hoàn toàn trực quan không-code
Câu hỏi thường gặp
Điều gì làm cho công cụ web scraping có trí tuệ nhân tạo?
Các scraper có AI thường hỗ trợ một hoặc nhiều trong bốn công việc: xác định các trường trên trang, biến nội dung trang thành dữ liệu có cấu trúc, điều khiển trình duyệt bằng các lệnh ngôn ngữ tự nhiên, hoặc chuẩn bị nội dung đã scrape cho các hệ thống AI. Các công cụ tốt nhất vẫn cần prompt rõ ràng, schema, xác thực và các quy tắc về dữ liệu cần thu thập.
Sự khác biệt giữa scraping và tự động hoá trình duyệt là gì?
Scraping tập trung vào việc trích xuất dữ liệu từ các trang. Tự động hoá trình duyệt điều khiển trình duyệt để click, scroll, đăng nhập, điền form, chờ nội dung động hoặc di chuyển qua một quy trình đa bước. Nhiều công cụ hiện đại kết hợp cả hai, nhưng sự khác biệt vẫn quan trọng: một danh sách sản phẩm tĩnh là công việc scraping, trong khi một quy trình cần điều hướng và tương tác có thể cần tự động hoá trình duyệt.
Định dạng đầu ra nào là tốt nhất cho hệ thống RAG?
Các hệ thống Retrieval‑Augmented Generation thường hoạt động tốt nhất với văn bản sạch, Markdown, JSON có cấu trúc, siêu dữ liệu và URL nguồn ổn định. Mục tiêu không chỉ là thu thập nội dung mà còn giữ đủ cấu trúc để phân đoạn, truy xuất, trích dẫn và kiểm tra chất lượng. HTML thô có thể hữu ích, nhưng thường tạo ra công việc dọn dẹp thêm trước khi dữ liệu có thể sử dụng trong một ứng dụng AI.
Các scraper AI có thể xử lý các website JavaScript không?
Nhiều công cụ có thể, nhưng chất lượng phụ thuộc vào sản phẩm. Một số công cụ render trang trong trình duyệt, một số sử dụng hạ tầng trình duyệt không giao diện, và một số khác trích xuất sau khi trang đã tải. Hỗ trợ JavaScript quan trọng đối với thương mại điện tử, chợ, nền tảng xã hội, bảng điều khiển và các ứng dụng web hiện đại nơi dữ liệu hữu ích xuất hiện sau phản hồi trang ban đầu.
Các scraper không-code có phù hợp cho các dự án lớn không?
Các scraper không-code có thể tuyệt vời cho các quy trình kinh doanh định kỳ, giám sát đối thủ, nghiên cứu tiềm năng và nhiệm vụ vận hành. Các chương trình lớn hơn cuối cùng có thể cần API, hàng đợi, giám sát, hạ tầng proxy, kiểm soát phiên bản, xác thực dữ liệu và sở hữu kỹ thuật. Các công cụ không-code mạnh nhất khi quy trình rõ ràng và đội muốn tốc độ mà không phải xây dựng scraper tùy chỉnh.
Việc web scraping có hợp pháp không?
Luật web scraping phụ thuộc vào khu vực pháp lý, website mục tiêu, loại dữ liệu, phương thức truy cập và cách sử dụng dữ liệu. Thu thập dữ liệu công cộng trên web vẫn có thể gây ra các vấn đề hợp đồng, quyền riêng tư, sở hữu trí tuệ, an ninh mạng và chính sách nền tảng. Các đội nên xem xét luật áp dụng, robots.txt và các điều khoản khi có liên quan, chính sách tuân thủ nội bộ và độ nhạy cảm của dữ liệu trước khi triển khai chương trình scraping.
Có nên xác thực kết quả trích xuất do AI tạo ra không?
Có. AI có thể làm cho scraping linh hoạt hơn, nhưng cũng có thể đọc sai trang, gộp trường, bỏ qua ngữ cảnh ẩn hoặc trả về cấu trúc không nhất quán khi bố cục thay đổi. Các quy trình sản xuất nên bao gồm kiểm tra schema, xem xét mẫu, cảnh báo thay đổi, xử lý lỗi và kiểm duyệt con người cho các quyết định nhạy cảm.
Suy nghĩ cuối cùng về các công cụ AI Web Scraping
Bright Data là lựa chọn mạnh mẽ nhất tổng thể cho các đội cần hạ tầng nghiêm trọng và các chương trình dữ liệu công cộng quy mô lớn. Firecrawl là lựa chọn sạch nhất cho các ứng dụng AI cần ngữ cảnh web sẵn sàng cho LLM, trong khi Apify cung cấp cho các nhà phát triển một nền tảng linh hoạt cho các scraper tùy chỉnh, Actor và tự động hoá trình duyệt.
Đối với các đội kinh doanh, Browse AI và Octoparse làm cho việc thu thập dữ liệu định kỳ trở nên dễ tiếp cận mà không yêu cầu mỗi quy trình trở thành dự án kỹ thuật. ScrapingBee là một API thân thiện với nhà phát triển mạnh mẽ cho trích xuất ngôn ngữ tự nhiên, render JavaScript và đầu ra có cấu trúc mà không cần duy trì trình duyệt và hạ tầng proxy.
SearchAPI nổi bật khi yêu cầu là dữ liệu công cụ tìm kiếm thời gian thực, có cấu trúc cho SEO, nghiên cứu hoặc các tác nhân AI thay vì crawl website bất kỳ. Oxylabs là lựa chọn tốt nhất cho API scraping doanh nghiệp và các website công cộng khó, Diffbot hấp dẫn khi việc trích xuất thực thể và ngữ cảnh Knowledge Graph quan trọng, và ScrapeGraphAI là một tùy chọn trích xuất dựa trên prompt linh hoạt cho các quy trình AI.




