
Anderson’un Açısı
Stable Diffusion’ın önündeki üç zorluk

 Unite.AI sitesini Google'daki tercih ettiğiniz kaynaklara ekleyin
Öne çıkan noktalarStable Diffusion, yetersiz derecede ayrıntılı eğitim verisi açıklamaları nedeniyle…
Daha fazla göster
- Stable Diffusion, yetersiz derecede ayrıntılı eğitim verisi açıklamaları nedeniyle insan uzuvlarını oluşturmakta zorlanır.
- Döşeme tabanlı yüksek çözünürlüğe çıkarma yöntemleri, daha geniş bağlamsal farkındalık olmaksızın birbirinden kopuk görüntüler üretme riski taşır.
- Modelin 512x512 yerel çözünürlüğü, çıktı kalitesini sınırlar ve karmaşık geçici çözümler gerektirir.
stability.ai’nin Stable Diffusion görüntü sentez modelinin birkaç hafta önce yayımlanması, latent diffusion alanında, 1999’daki DeCSS yayınından bu yana en önemli teknolojik açıklamalardan biri olabilir; AI tarafından oluşturulan görüntülerde 2017 deepfakes kodunun GitHub’a kopyalanıp DeepFaceLab ve FaceSwap olarak fork edilmesi ve DeepFaceLive gibi gerçek zamanlı akış deepfake yazılımlarıyla birlikte en büyük olaydır.
Kullanıcıların hayal kırıklığı, DALL-E 2’nin görüntü sentez API’sindeki içerik kısıtlamaları nedeniyle oluşmuşken, Stable Diffusion’un NSFW filtresinin tek bir kod satırı değiştirilerek devre dışı bırakılabileceği ortaya çıkınca bir anda ortadan kalktı. Pornografi odaklı Stable Diffusion Reddit toplulukları hemen ortaya çıktı ve kısa sürede kapatıldı, geliştirici ve kullanıcı kampı Discord’da resmi ve NSFW topluluklara bölündü ve Twitter, fantastik Stable Diffusion yaratımlarıyla doldu.
Şu anda, her gün bazı geliştiricilerin sistemi benimsemesiyle birlikte bazı harika yenilikler getiriyor, Krita, Photoshop, Cinema4D, Blender ve diğer uygulama platformları için hızlıca yazılmış eklentiler ve üçüncü taraf eklentiler geliştiriliyor.
Bu arada, promptcraft – şimdi profesyonel bir sanat olan ‘AI whispering’, muhtemelen ‘Filofax binder’dan bu yana en kısa kariyer seçeneği olacak – zaten ticarileştiriliyor, Stable Diffusion’un erken para kazanması Patreon düzeyinde gerçekleşiyor, daha sofistike teklifler gelmesi kesin, özellikle Conda tabanlı kaynak kodunun kurulumlarını veya web tabanlı uygulamaların kısıtlayıcı NSFW filtreleriyle uğraşmak istemeyenler için.
Geliştirme ve kullanıcıların keşif hızı o kadar hızlı ilerliyor ki, çok uzaklara bakmak zor. Aslında, neyle uğraştığımızı veya sınırlamaların ya da olanakların neler olabileceğini tam olarak bilmiyoruz.
Bununla birlikte, Stable Diffusion topluluğunun hızla oluştuğu ve büyüdüğü üç ilginç ve zorlu engelle karşı karşıya kalma olasılığına bir göz atalım.
1: Görüntü parçalarına dayalı işleme süreçlerini iyileştirme
Sınırlı donanım kaynakları ve eğitim görüntülerinin çözünürlüğü üzerindeki sert sınırlarla karşı karşıya kalan geliştiricilerin, Stable Diffusion çıkışının hem kalitesini hem de çözünürlüğünü iyileştirmek için alternatif çözümler bulmaları muhtemeldir. Bu projelerin çoğu, sistemin sınırlarını, örneğin 512×512 piksel gibi bir doğal çözünürlüğü sömürebilecek.
Her zaman olduğu gibi, bilgisayar vizyonu ve görüntü sentez girişimleri gibi Stable Diffusion, kare oranlı görüntülere eğitim verildi, bu durumda 512×512’ye yeniden örneklenerek kaynak görüntülerin düzenlenip GPU’ların eğitimi için sınırlarına uydurulabileceği şekilde.
Stable Diffusion bu nedenle 512×512 terimlerinde “düşünür” (eğer düşünebilirse) ve kesinlikle kare terimlerinde. Şu anda sistemin sınırlarını araştıran birçok kullanıcı, Stable Diffusion’un bu oldukça kısıtlayıcı en boy oranında (aşağıdaki ‘uzuvları ele alma’ bölümüne bakınız) en güvenilir ve en az hatalı sonuçları ürettiğini rapor ediyor.
Bazı uygulamalar RealESRGAN aracılığıyla büyütme sunarken (ve GFPGAN aracılığıyla kötü oluşturulmuş yüzleri düzeltebilir) birkaç kullanıcı, görüntüleri 512x512px bölümlere ayırma ve daha büyük kompozit eserler oluşturmak için görüntüleri birleştirmeye yönelik yöntemler geliştiriyor.

Bu 1024×576 render, genellikle tek bir Stable Diffusion renderında imkansız bir çözünürlük, Stable Diffusion’ın parça tabanlı büyütmeyi uygulayan DoggettX dalındaki attention.py Python dosyasını başka bir dala kopyalayarak oluşturuldu. Kaynak: https://old.reddit.com/r/StableDiffusion/comments/x6yeam/1024x576_with_6gb_nice/
Bu tür girişimlerin bazıları orijinal kodu veya diğer kütüphaneleri kullanırken, txt2imghd portu GOBIG’i (çok VRAM tüketen ProgRockDiffusion’daki bir mod) bu işlevselliği yakında ana dala getirmeyi hedefliyor. txt2imghd, GOBIG’in bir portu iken, topluluk geliştiricileri GOBIG’in farklı uygulamalarını içeriyor.

Bu örneğe uygun soyut bir görüntünün ilk 512×512 piksellik çıktısı (solda ve soldan ikinci); artık hemen hemen tüm Stable Diffusion dağıtımlarında yerleşik olan ESGRAN ile büyütülmüş hâli ve GOBIG uygulamasıyla “özel ilgi” verilmiş hâli. Sonuncusunda ayrıntılar, en azından görüntü parçası içinde, daha iyi büyütülmüş görünür. Kaynak: https://old.reddit.com/r/StableDiffusion/comments/x72460/stable_diffusion_gobig_txt2imghd_easy_mode_colab/
Bu tür soyut örnekler, bu yaklaşımın uygun olduğu birçok ‘küçük krallık’ ayrıntı içerir, ancak tekrarlamayan, tutarlı bir büyütme oluşturmak ve sonucun çok sayıda parçadan birleştirilmiş gibi görünmemesini sağlamak için daha zorlu, kod tabanlı çözümler gerektirebilir. Özellikle yüzlerde, burada anormalara veya rahatsız edici görüntü kusurlarına karşı olağanüstü duyarlıyız. Bu nedenle, yüzler sonunda özel bir çözüm gerektirebilir.
Stable Diffusion, bir render sırasında yüzü odak noktasına alma mekanizmasına sahip değildir, bu da insanların yüz bilgilerini önceliklendirmesi gibi bir şeydir. Şu anda, bazı geliştiriciler Discord topluluklarında bu tür ‘geliştirilmiş dikkat’ yöntemlerini düşünüyor, ancak ilk render gerçekleştiğinde yüzü manuel olarak (ve sonunda otomatik olarak) geliştirmek çok daha kolay.
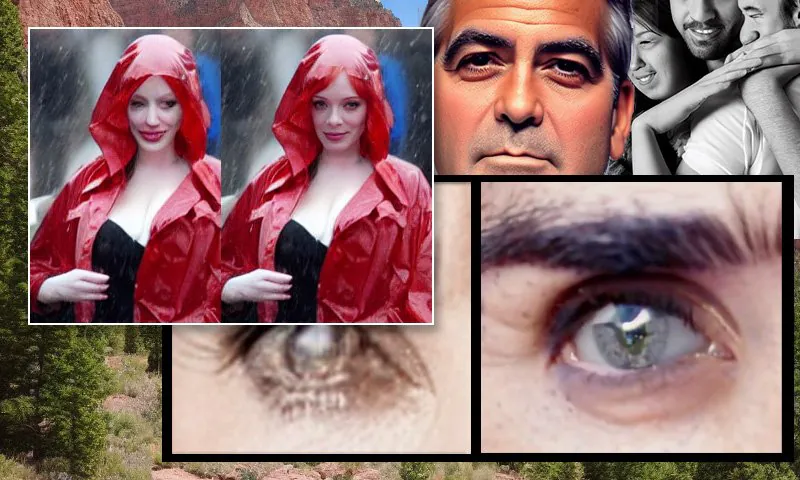
İnsan yüzü, bir binanın alt köşesi gibi bir “fayans”ın içinde bulunmayan, iç ve tam bir semantik mantığa sahiptir ve bu nedenle, Stable Diffusion çıkışında kabataslak çizilmiş bir yüzü çok etkili bir şekilde “yakınlaştırmak” ve yeniden oluşturmak mümkün.

Solda, Stable Diffusion’un ilk girişimi ‘Full-length color photo of Christina Hendricks entering a crowded place, wearing a raincoat; Canon50, eye contact, high detail, high facial detail’ promptıyla. Sağda, ilk renderden bulanık ve karışık yüzü Stable Diffusion’un tam dikkatine Img2Img kullanılarak geliştirilmiş yüz (aşağıdaki hareketli görüntülere bakınız).
Özel bir Textual Inversion çözümü olmadan (aşağıya bakınız), bu yöntem yalnızca Stable Diffusion’ı eğiten LAION alt kümelerinde zaten iyi temsil edilen ünlülerin görüntülerinde çalışır. Dolayısıyla Tom Cruise, Brad Pitt, Jennifer Lawrence gibi kaynak verilerde çok sayıda fotoğrafı bulunan sınırlı bir gerçek medya ünlüsü grubunda işe yarar.
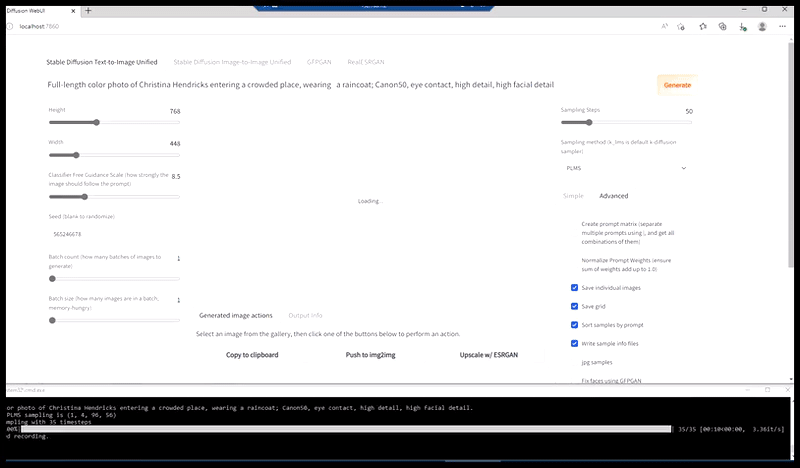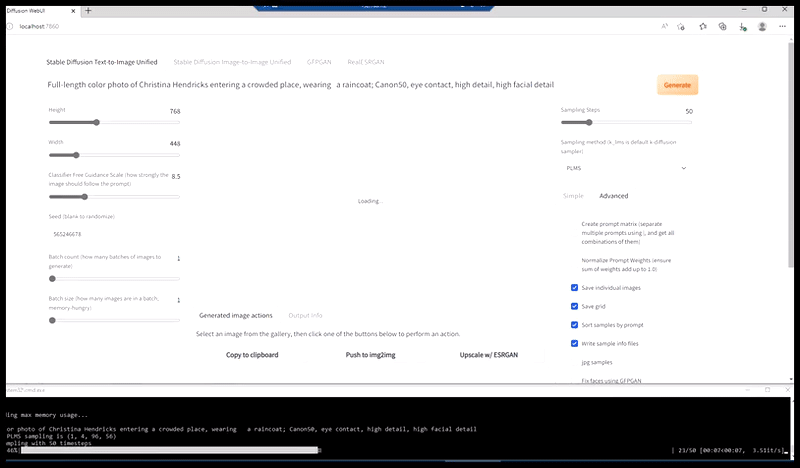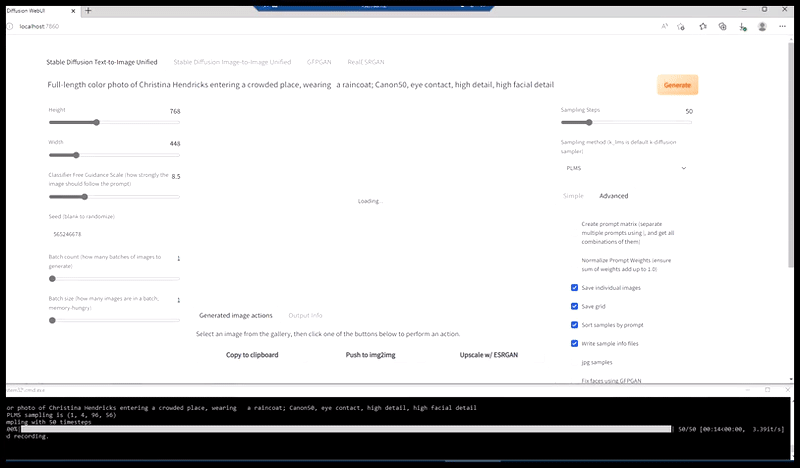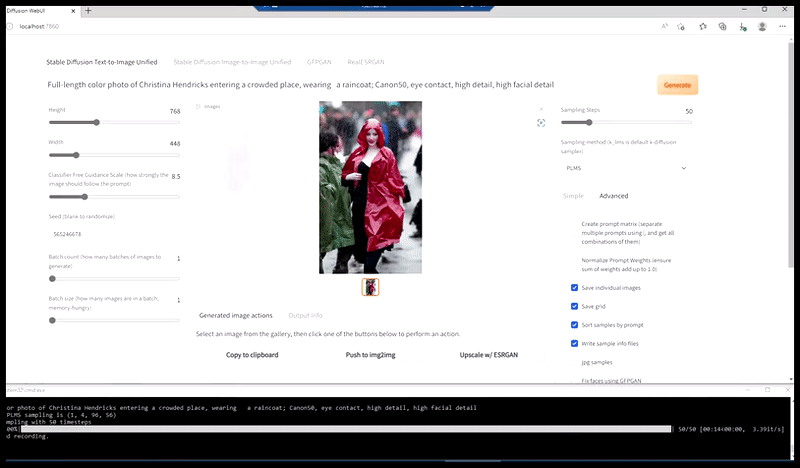
İnanılmaz bir basın fotoğrafı oluşturmak için ‘Full-length color photo of Christina Hendricks entering a crowded place, wearing a raincoat; Canon50, eye contact, high detail, high facial detail’ promptı.
Uzun ve süreğen kariyeri olan ünlüler için, Stable Diffusion genellikle kişinin daha yakın (yani daha yaşlı) yaşta bir resmini oluşturur ve daha genç görünen resimler oluşturmak için ‘young’ veya ‘in the year [YEAR]’ gibi prompt ekleri eklenmesi gerekir.

Jennifer Connelly, yaklaşık 40 yıllık süren ve tutarlı bir kariyeri olan ve LAION’da çeşitli yaşlarda temsil edilen birkaç ünlüden biridir. Kaynak: prepack Stable Diffusion, yerel, v1.4 kontrol noktası; yaşa bağlı promptlar.
Bu, büyük ölçüde 2000’lerin ortalarından itibaren dijital (emülsiyon tabanlı değil) basın fotoğrafçılığının yayılması ve daha sonra artan bant genişliği nedeniyle görüntüdeki artıştan kaynaklanmaktadır.
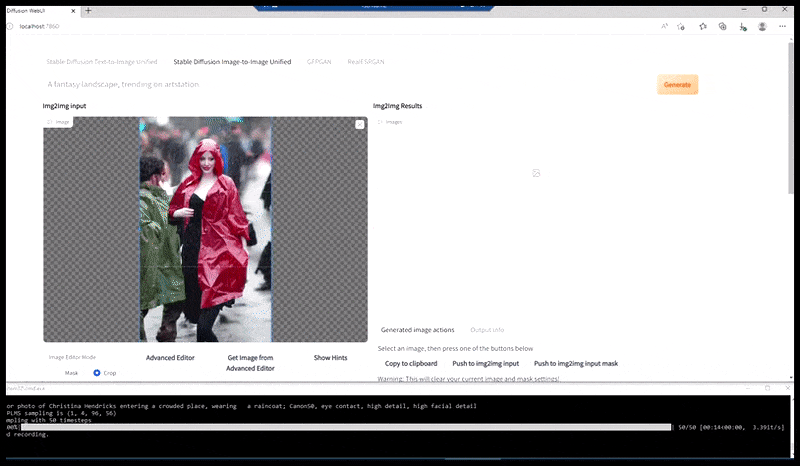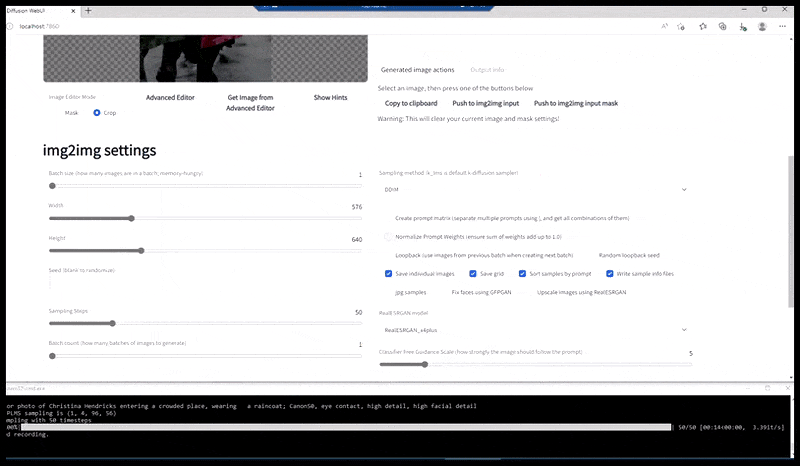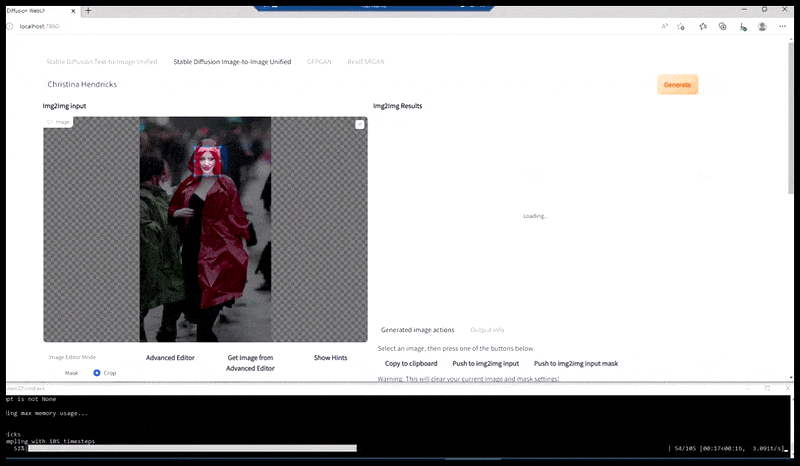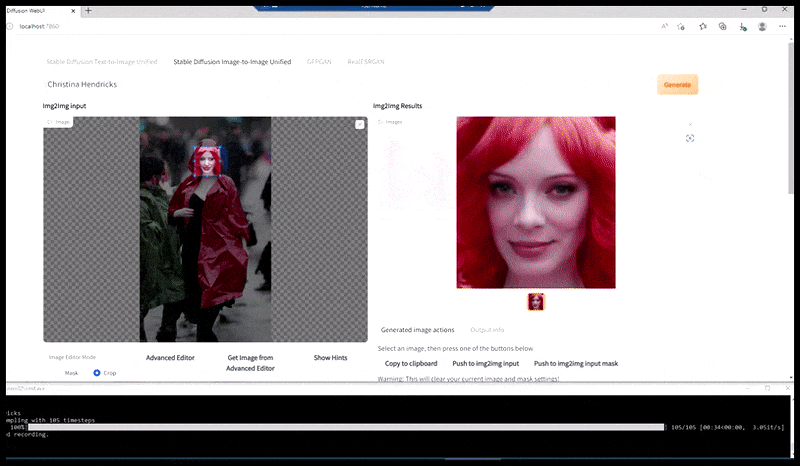
Render edilen görüntü, Stable Diffusion’daki Img2Img’ye geçirilir, burada bir ‘odak alanı’ seçilir ve yalnızca bu alan için yeni, maksimum boyutlu bir render oluşturulur, böylece Stable Diffusion tüm mevcut kaynaklarını yüzü yeniden oluşturmak için kullanabilir.
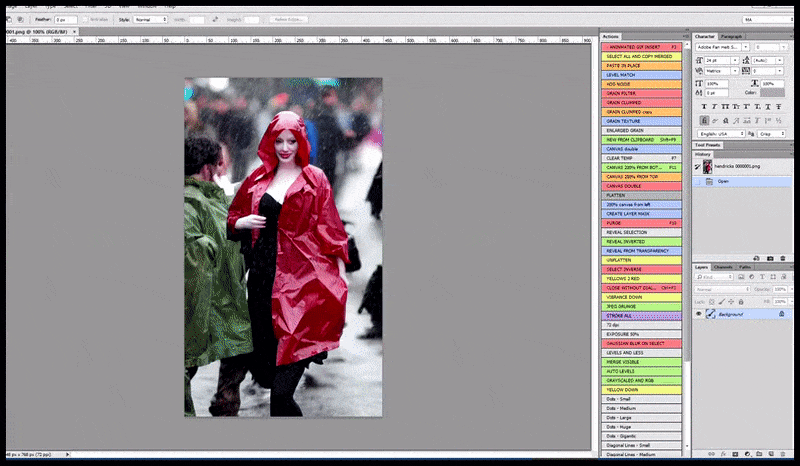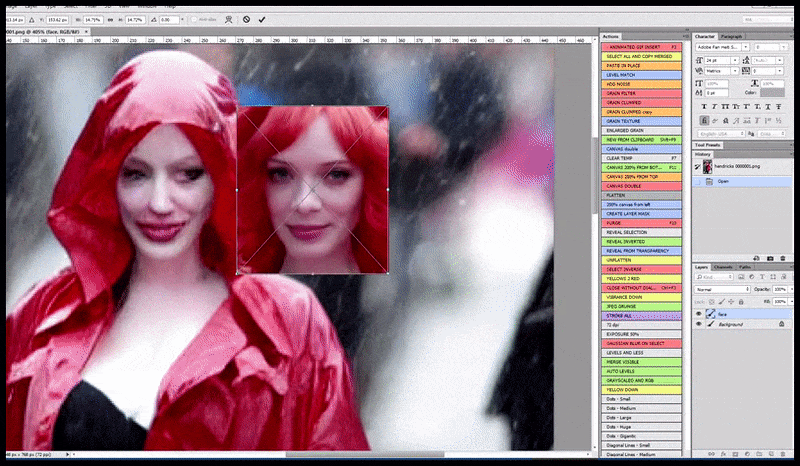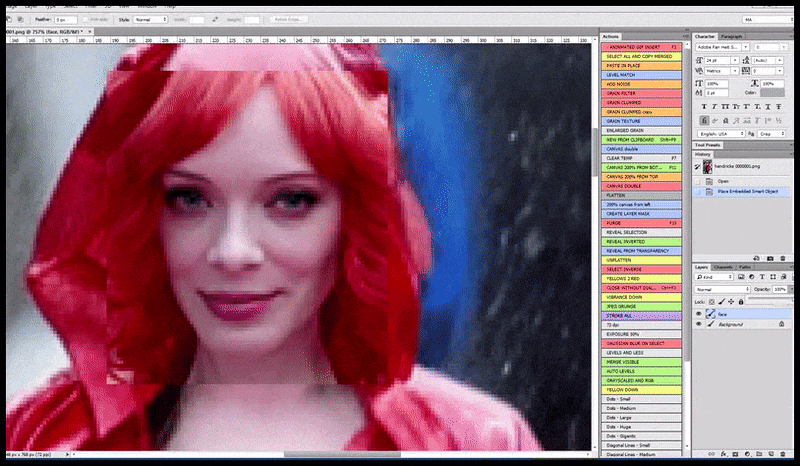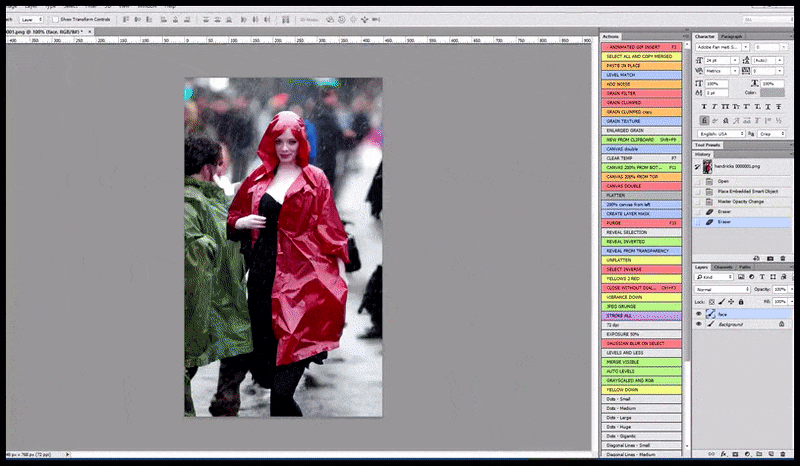
Yüksek dikkat yüzünü orijinal render’e kompozit etmek. Yüzlerin yanı sıra, bu işlem yalnızca orijinal fotoğrafın belirli bir nesnesi olan, bir saat veya bir araba gibi, potansiyel olarak tutarlı ve bütünlüklü bir görünümü olan varlıklarla çalışır. Örneğin bir duvarın bir bölümünü büyütmek, render edilen ‘puzzle parçaları’nın daha geniş bir bağlamı olmadığı için çok garip görünen bir duvarın yeniden montajına yol açacaktır.
Bazı ünlüler veritabanında zaman içinde ‘donmuş’ olarak kalır, ya çünkü erken öldüler (örneğin Marilyn Monroe) veya yalnızca kısa süreli ana akım popülerlik elde ettiler, bu da sınırlı bir süre içinde yüksek hacimli görüntüler oluşturdu. Stable Diffusion’a sorgu yöneltmek, modern ve eski yıldızlar için bir tür ‘mevcut’ popülerlik endeksi sunabilir. Bazı eski ve güncel ünlüler için, benzerlik elde etmek için yeterli görüntü bulunmayabilir, ancak bazı uzun süredir ölmüş veya solmuş yıldızların popülerliği, makul bir benzerlik elde edilmesini sağlar.

Stable Diffusion renderları, ünlü yüzlerin veritabanında nasıl temsil edildiğini hızla ortaya koyar. Yazıldığı sırada büyük popülerliğe sahip ileri ergenlik çağındaki biri olarak Millie Bobby Brown, LAION kaynak veri setlerinin web’den kazındığı sırada daha genç ve daha az bilinen biriydi, bu nedenle Stable Diffusion ile yüksek kaliteli bir benzerlik elde etmek şu anda sorunlu.
Veriler mevcut olduğunda, Stable Diffusion’daki tile-based up-res çözümleri, yalnızca yüzü hedeflemekten daha fazlasını yapabilir: yüz özelliklerini ayrıntılandırarak ve bunları bireysel olarak yeniden oluşturmak için tüm yerel GPU kaynaklarını kullanabilir, daha sonra bunları yeniden montajlayabilir – bu işlem şu anda manuel.

Bu, yüzlerden daha fazlasını içerir, ancak en azından nesnelerin daha geniş bağlamında tutarlı bir şekilde yerleştirilmiş ve çok büyük ölçekli veri kümelerinde bulunması beklenebilecek üst düzey vektör temsillerine uyan olan nesne parçalarına da uygulanabilir.
Gerçek sınır, veritabanındaki mevcut referans verisi miktarıdır, çünkü sonunda, derinlemesine iterasyon detayları tamamen ‘hayal ürünü’ (yani uydurma) ve daha az otantik hale gelecektir.
Bu tür yüksek düzeyli granül büyütmeler, Jennifer Connelly’nin LAION-aesthetics içinde (Stable Diffusion’ın kullandığı LAION 5B birincil alt kümesi) ve LAION genelinde çeşitli yaşlarda iyi temsil edildiği için çalışır; birçok diğer durumda, doğruluk veri eksikliğinden dolayı zarar görecektir, bu da fine-tuning (ek eğitim, ‘Özelleştirme’ bölümüne bakınız) veya Textual Inversion (aşağıya bakınız) gerektirecektir.
Tiles, Stable Diffusion’un yüksek çözünürlüklü çıktı üretmesine olanak tanıyan güçlü ve nispeten ucuz bir yoldur, ancak bu tür algoritmik fayans büyütmesi, daha geniş, daha yüksek düzeyde bir dikkat mekanizması olmadan, çeşitli içerik türleri için umulan standartlara ulaşamayabilir.
2: İnsan Uzuvları ile İlgili Sorunları Giderme
Stable Diffusion, insan uzuvlarının karmaşıklığını temsil etme konusunda adını hak etmiyor. Eller rastgele çoğalabilir, parmaklar birleşebilir, üçüncü bacaklar ortaya çıkabilir ve mevcut uzuvlar iz bırakmadan kaybolabilir. Savunması olarak, Stable Diffusion bu sorunu paylaştığı diğer modellerle ve özellikle DALL-E 2 ile benzerlik gösteriyor.

2022 Ağustos sonunda DALL-E 2 ve Stable Diffusion (1.4) tarafından oluşturulan, uzuvlarla ilgili sorunları gösteren düzenlenmemiş sonuçlar. Prompt: ‘A woman embracing a man’
Yaklaşan 1.5 kontrol noktasının (daha yoğun eğitilmiş, geliştirilmiş parametrelere sahip bir sürüm) uzuv karışıklığını çözeceğini uman Stable Diffusion hayranları muhtemelen hayal kırıklığına uğrayacak. Yaklaşık iki hafta sonra yayımlanacak yeni model, şu anda stability.ai’nin ticari portalı DreamStudio üzerinde ön gösterimde. Varsayılan olarak 1.5 kullanan bu hizmette kullanıcılar yeni çıktıları yerel veya diğer 1.4 sistemlerin çıktılarıyla karşılaştırabilir:

Kaynak: Yerel 1.4 prepack ve https://beta.dreamstudio.ai/

Kaynak: Yerel 1.4 prepack ve https://beta.dreamstudio.ai/

Kaynak: Yerel 1.4 prepack ve https://beta.dreamstudio.ai/
Bunun nedeni muhtemelen veri kalitesinden kaynaklanmaktadır.
Görüntü sentez sistemlerini besleyen açık kaynaklı veritabanları, bireysel insanlara ve insanlararası eylemlere birçok etiket sağlayabilir. Bu etiketler, ilgili görüntülerle veya görüntülerin parçalarıyla birlikte eğitilir.

Stable Diffusion kullanıcıları, LAION-aesthetics veri setini sorgulayarak modelin kavramlarını öğrenebilir, bu veri seti sistem tarafından güçlendirilir. Görüntüler alfabetik etiketlere göre değil, ‘estetik puan’larına göre sıralanır. Kaynak: https://rom1504.github.io/clip-retrieval/
İnsan kolunu tasvir eden tekil etiket ve sınıfların iyi bir hiyerarşisi, body>arm>hand>fingers>[sub digits + thumb]> [digit segments]>Fingernails gibi bir şey olabilir.

Elin parçalarının granül semantik segmentasyonu. Bu olağanüstü ayrıntılı dekonstrüksiyon, her bir parmağın üç bölümü ve başparmağın iki bölümünü hesaba katmaz. Kaynak: https://athitsos.utasites.cloud/publications/rezaei_petra2021.pdf
Gerçekte, kaynak görüntüler muhtemelen tüm veri seti boyunca tutarlı bir şekilde etiketlenmeyecektir ve denetimsiz etiketleme algoritmaları, örneğin ‘el’ gibi daha yüksek düzeyde duracak ve iç pikselleri (teknik olarak ‘parmak’ bilgilerini içeren) etiketsiz bir piksel kümesi olarak bırakacaktır. Buradan özellikler keyfî olarak türetilecek ve daha sonraki renderlerde rahatsız edici bir unsur olarak belirebilecektir.

İnsan elinin nasıl olması gerektiği (üst sağ) ve nasıl olduğu (alt sağ), etiketleme için sınırlı kaynaklardan veya bu etiketlerin varlığından dolayı mimari sömürü nedeniyle.
Bu nedenle, bir latent diffusion modeli bir kolu render etmeye kadar ilerlerse, muhtemelen koldaki bir el render etmeye çalışacaktır, çünkü arm>hand minimal gereken hiyerarşi, mimarinin ‘insan anatomisi’ hakkında bildiği yüksek düzeydedir.
Bundan sonra, ‘parmaklar’ en küçük grup olabilir, ancak parmak ve başparmak için 14 daha fazla parça vardır.
Eğer bu teori doğruysa, gerçek bir çözüm yoktur, çünkü sektör genelinde etiketleme için bütçe yoktur ve düşük hata oranlarına sahip olabilecek otomatik etiketleme algoritmaları yoktur. Aslında, model şu anda veri setinin eksikliklerini kapatmak için insan anatomisinin tutarlılığına güveniyor olabilir.
Modelin buna güvenememesinin olası bir nedeni, yakın zamanda Stable Diffusion Discord’unda öne sürüldü: Modelin beslendiği LAION kökenli veritabanında daha az parmağa sahip çizgi film karakterleri olduğu için gerçek bir insan elinde bulunması gereken parmak sayısı karışabilir (bu da başlı başına emek tasarrufu sağlayan bir kestirmedir).

Stable Diffusion ve benzeri modellerdeki ‘kaybolan parmak’ sendromunun olası suçluları. Aşağıda, LAION-aesthetics veri setinden Stable Diffusion’u güçlendiren çizgi elleri örnekleri. Kaynak: https://www.youtube.com/watch?v=0QZFQ3gbd6I
Eğer bu doğruysa, tek açık çözüm, gerçekçi olmayan insan tabanlı içeriği hariç tutarak modeli yeniden eğitmek ve gerçek eksikliklerin, örneğin ampütasyon geçirmiş kişilerin, uygun biçimde istisna olarak etiketlenmesini sağlamaktır. Bu da veri toplama açısından oldukça bir zorluk oluşturacaktır, özellikle kaynakları kısıtlı topluluk çabaları için.
İkinci yaklaşım, böyle bir içeriğin render zamanında ortaya çıkmasını önleyen filtreleri uygulamaktır (örneğin, ‘üç veya beş parmaklı el’), OpenAI’nin GPT-3 ve DALL-E 2 için yaptığı gibi, böylece kaynak modeller yeniden eğitilmeden çıktıları düzenlenebilir.

Stable Diffusion için, parmaklar ve hatta uzuvlar arasındaki semantik ayrım, David Cronenberg gibi sanatçıların 1980’lerin ‘vücut korkusu’ türünden korku filmlerini anımsatıyor. Kaynak: https://old.reddit.com/r/StableDiffusion/comments/x6htf6/a_study_of_stable_diffusions_strange_relationship/
Bununla birlikte, yine de, bu etiketlerin tüm etkilenen görüntülerde mevcut olmaması nedeniyle, aynı lojistik ve bütçe zorluğuyla karşı karşıya kalınacaktır.
İleri gitmek için iki yol olabilir: problema daha fazla veri atmak ve render zamanında ortaya çıkan fiziksel hataları önlemek için üçüncü taraf yorumlayıcı sistemleri uygulamak (en azından ikinci yaklaşım, şirket bunu yapmaya istekli olursa OpenAI’ye ‘vücut korkusu’ renderleri için geri ödeme yöntemi sağlayacaktır).
3: Özelleştirme
Stable Diffusion’un geleceği için en heyecan verici olasılıklardan biri, kullanıcıların veya organizasyonların revize sistemler geliştirebilmeleridir; LAION önceden eğitilmiş küresinin dışındaki içeriği sisteme entegre etmelerine olanak tanıyan değişiklikler – ideal olarak tüm modeli yeniden eğitmek için gerekli olan muazzam maliyet veya risk olmadan, veya büyük miktarda yeni görüntüleri mevcut, olgun ve yetenekli bir modele öğretme riski olmadan.
Benzerlik: Eğer iki yeteneksiz öğrenci bir ileri sınıfın 30 öğrencisine katılırsa, ya asimile olacaklar ve takip edecekler ya da dışlanacaklar; her durumda, sınıfın ortalama performansı muhtemelen etkilenmeyecektir. Eğer 15 yeteneksiz öğrenci katılırsa, sınıfın not eğrisi muhtemelen düşecektir.
Aynen öyle, model eğitimi boyunca oluşturulan ilişkiler ve kavramlar ağı, yeni verilerin aşırı miktarı nedeniyle tehlikeye girebilir veya hatta etkili bir şekilde yok olabilir, bu da modelin genel çıktı kalitesini düşürür.
Bunun nedeni, modelin kavramsal anlayışını tamamen ele geçirerek, yalnızca eklenen ek materyale benzer içeriğin üretimi için kullanmak istemektir.
Örneğin, 500.000 Simpsons karelerini mevcut bir Stable Diffusion kontrol noktasına eğitmek, sonunda orijinal yapıdan daha iyi bir Simpsons simülatörü elde edebilir, şu varsayımla: yeterli geniş semantik ilişkiler süreci sırasında hayatta kalır (örneğin, Homer Simpson bir hot dog yiyordu, bu, ek materyalde olmasa da önceden kontrol noktasında zaten mevcut olan hot doglar hakkında malzeme gerektirebilir) ve Simpsons içeriğinden fabulous landscape by Greg Rutkowski gibi şeyler oluşturmak için kullanmak istemezsiniz – çünkü post-eğitim modeli, dikkati büyük ölçüde başka yere kaydırılmış ve daha önce olduğu gibi bu tür şeyleri yapmak için iyi olmayacaktır.
Bu tür bir örneğin dikkat çekici bir örneği, waifu-diffusion, 56.000 anime görüntüsünü başarılı bir şekilde bir tamamlanmış ve eğitilmiş Stable Diffusion kontrol noktasına post-eğitim yapmıştır. Ancak, bu bir hobi için zor bir perspektiftir, çünkü model minimum 30GB VRAM gerektirir, bu da tüketici düzeyinde NVIDIA’nın gelecek 40XX serisi yayınlarında muhtemelen mevcut olmayacaktır.

waifu-diffusion aracılığıyla Stable Diffusion’a özel içerik eğitimi: model, bu düzeyde illüstrasyonu oluşturmak için iki hafta süren post-eğitim yaptı. Soldaki altı görüntü, modelin yeni eğitim verilerine dayalı olarak konuyla ilgili çıktı oluşturma ilerlemesini gösterir. Kaynak: https://gigazine.net/gsc_news/en/20220121-how-waifu-labs-create/
Bu tür ‘fork’lar için büyük çaba harcanabilir, ancak teknik borç nedeniyle engellenir. Resmi Discord’daki geliştiriciler, daha sonraki kontrol noktası yayınlarının, önceki bir sürümden çalışan prompt mantığıyla bile geriye dönük olarak uyumlu olmayabileceğini zaten belirttiler, çünkü öncelikli amaçları, mümkün olan en iyi modeli elde etmek, değil, miras uygulamaları ve süreçleri desteklemek.
Bu nedenle, bir şirket veya birey, bir kontrol noktasını bir ticari ürüne ayırarak, o modelin bir ‘hard fork’una sahip olur ve stability.ai’nin daha sonraki yayınlarından gelen akış yukarı faydalarını alamaz – bu oldukça bir taahhüt.
Stable Diffusion’un özelleştirilmesi için güncel ve daha büyük umut, Textual Inversion, burada kullanıcı, birkaç CLIP hizalı görüntü eğitir.

Tel Aviv Üniversitesi ve NVIDIA arasındaki bir işbirliği, Textual Inversion, yeni ve tekil varlıkları eğiterek, kaynak modelin yeteneklerini bozmadan, modelin yeteneklerini bozmaz. Kaynak: https://textual-inversion.github.io/
Textual Inversion’ın temel sınırlaması, çok az sayıda görüntünün önerilmesi – beş kadar az sayıda. Bu, daha çok stil transferi görevleri için yararlı olabilecek, ancak fotogerçekçi nesnelerin eklenmesinde daha az etkili olabilecek sınırlı bir varlık oluşturur.
Bununla birlikte, Stable Diffusion Discord’undaki çeşitli deneyler, daha fazla eğitim görüntüsü kullanıyor ve bu yöntemin ne kadar verimli olabileceği henüz görülmedi. Yine de, bu teknik, büyük miktarda VRAM, zaman ve sabır gerektiriyor.
Bu sınırlayıcı faktörler nedeniyle, Stable Diffusion entusiastlarının daha sofistike Textual Inversion deneylerini görmeye biraz daha zaman ayıracağız – ve bu yaklaşımın, bir Photoshop kesme ve yapıştırmadan daha iyi görünen bir şekilde ‘resme koyabilme’ yeteneğine sahip olup olmadığını, resmi kontrol noktalarının şaşırtıcı işlevselliğini korurken.
İlk olarak 6 Eylül 2022’de yayınlandı.


