
Anderson’un Açısı
Küçük Deepfakes Daha Büyük Tehdit Olabilir

 Unite.AI sitesini Google'daki tercih ettiğiniz kaynaklara ekleyin
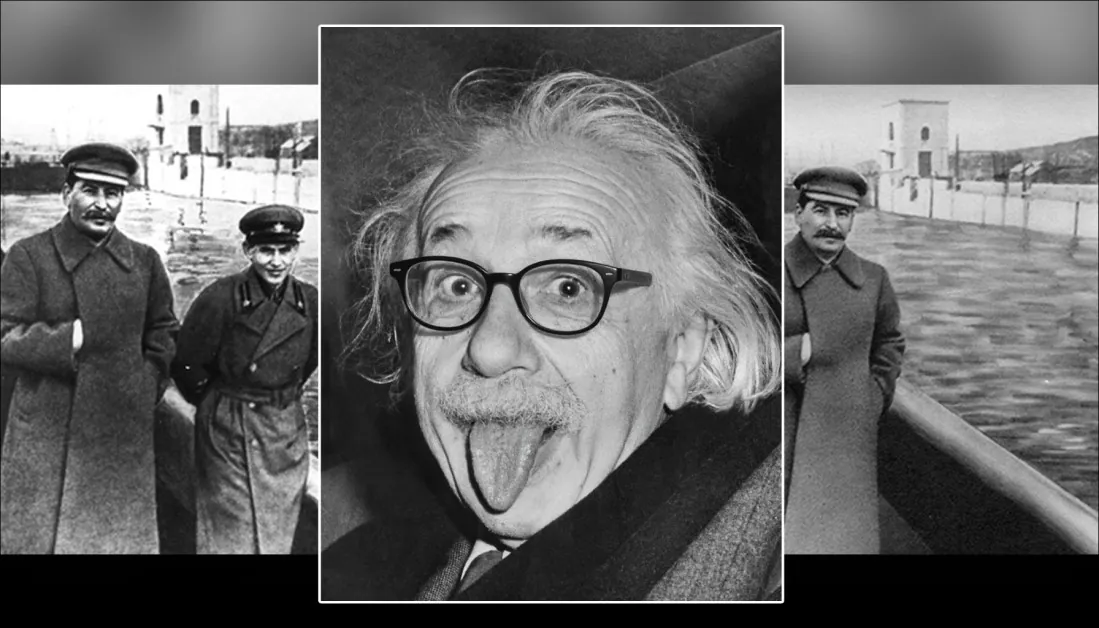
ChatGPT ve Google Gemini gibi konuşma AI araçları, yüz değiştirme yerine daha ince yollarla bir görüntünün içindeki hikayeyi yeniden yazmak için kullanılmaktadır. Jestler, nesneler ve arka planlar değiştirilerek, bu düzenlemeler hem AI dedektörlerini hem de insanları kandırmaktadır ve gerçek olanı online olarak tespit etme riskini artırmaktadır.
Mevcut iklimde, özellikle önemli yasalar gibi TAKE IT DOWN yasasının ardından, birçok kişi deepfakes ve AI ile kimlik sentezini, özellikle AI pornografisi ve siyasi manipülasyon gibi konularla ilişkilendirmektedir – genel olarak çirkin gerçeklik bozulmaları.
Bu, bizi AI-manipüle edilmiş görüntülerin her zaman yüksek riskli içerik için tasarlandığı beklentisine alıştırmaktadır, burada rendering kalitesi ve bağlam manipülasyonu, en azından kısa vadede, bir güvenilirlik darbesi elde edebilir.
Tarihsel olarak ise, çok daha ince değişiklikler genellikle daha kötü ve kalıcı bir etkiye sahip olmuştur – Örneğin, Stalin’in fotoğrafik hileler kullanarak, gözden düşmüş kişileri fotoğrafik kayıtlardan çıkarması, George Orwell’in Bin Dokuz Yüz Seksen Dört romanında alaycı bir şekilde betimlenmiştir, burada protagonist Winston Smith, günlerini tarih yeniden yazarak ve fotoğrafların oluşturulmasını, yok edilmesini ve “düzeltilmesini” geçirir.
Aşağıdaki örnekte, ikinci resimdeki sorun, bizim bilmediğimiz şeyin farkında olmamızdır – yani Stalin’in eski gizli polis şefi Nikolai Yezhov’un, şimdi yalnızca bir güvenlik bariyeri bulunan alanda bulunması:

Şimdi görüyorsun, şimdi yok… Stalin dönemi fotoğrafik manipülasyonu, bir parti üyesini tarihten siler. Kaynak: Kamu malı, https://www.rferl.org/a/soviet-airbrushing-the-censors-who-scratched-out-history/29361426.html
Bu tür akımlar, tekrar tekrar, birçok şekilde devam etmektedir; yalnızca kültürel olarak değil, bilgisayar vizyonunda da, bu, eğitim veri setlerindeki istatistiksel olarak baskın temalar ve motiflerden trendler çıkarır. Bir örnek olarak, akıllı telefonların girişteki engeli düşürmesi ve çok fotoğraf çekme maliyetini düşürmesi, onların ikonografisinin birçok soyut kavramla bağlantılı hale gelmesini sağlamıştır, bunun uygun olmadığı durumlarda bile.
Eğer geleneksel deepfake’ler bir “saldırı” olarak algılanabilirse, ses-görüntü medyasında pernisyoner ve sürekli küçük değişiklikler, “gaslighting”e daha çok benzemektedir. Ayrıca, bu tür deepfaking’in tespit edilmemesi, devlet-of-the-art deepfake tespit sistemlerinin (gross değişiklikler için tasarlanmış) bunları tespit etmekte zorlanmasına neden olmaktadır. Bu yaklaşım, bir kayaya suyun aşındırması gibi, yavaş ve sürekli bir süreçtir.
MultiFakeVerse
Avustralya’dan araştırmacılar, literatürdeki “ince” deepfaking’e dikkat eksikliğine çözüm olarak, bir kişinin kimliğini değiştirmeden, bağlam, duygu ve hikayeyi değiştiren kişi-merkezli görüntü manipülasyonlarından oluşan önemli bir yeni veri setini oluşturdular:

Yeni koleksiyondan örnekler, bazı değişikliklerin diğerlerinden daha ince olduğu gerçek/yanlış çiftleri. Örneğin, alt sağdaki Asya kadınının doktor stetoskobunun AI tarafından çıkarılmasıyla yetki kaybı ve doktor defterinin klipboarde dönüştürülmesinin açık bir semantik açısı yoktur. Kaynak: https://huggingface.co/datasets/parulgupta/MultiFakeVerse_preview
MultiFakeVerse olarak adlandırılan koleksiyon, 845,826 görüntü içermektedir ve çevrimiçi olarak erişilebilir ve izniyle indirilebilir.
Araştırmacılar şunları belirtiyorlar:
‘Bu VLM-temelli yaklaşım, sentetik veya düşük seviyeli kimlik değişiklikleri ve bölgeye özgü düzenlemeler yerine, eylemleri, sahneleri ve insan-nesne etkileşimlerini değiştiren anlamsal, bağlamsal değişiklikler yapılmasını sağlar.’
‘Deneyimlerimiz, mevcut state-of-the-art deepfake tespit modellerinin ve insan gözlemcilerin bu ince ancak anlamlı manipülasyonları tespit etmekte zorlandığını göstermektedir.’
Araştırmacılar, hem insanları hem de önde gelen deepfake tespit sistemlerini yeni veri setleri üzerinde test ettiler. İnsan katılımcılar, resimleri gerçek veya sahte olarak sadece yaklaşık %62 oranında doğru şekilde sınıflandırabildiler ve hangi parçaların değiştirildiğini belirlemede daha da fazla zorluk yaşadılar.
Mevcut deepfake dedektörleri, çoğunlukla yüz değiştirme veya dolgu veri setlerine dayalı olarak eğitilmiş olan, genellikle herhangi bir manipülasyonun meydana geldiğini kaydedemedi. MultiFakeVerse’de fine-tuning sonrasında bile, tespit oranları düşük kaldı, bu da mevcut sistemlerin bu tür ince, hikaye-odaklı düzenlemeleri işleyişinin ne kadar zayıf olduğunu ortaya koydu.
Yeni makale Multiverse Through Deepfakes: The MultiFakeVerse Dataset of Person-Centric Visual and Conceptual Manipulations olarak adlandırılmış ve Melbourne’deki Monash Üniversitesi ve Perth’teki Curtin Üniversitesi’nden beş araştırmacı tarafından yazılmıştır. Kod ve ilgili veri GitHub‘da yayınlanmıştır.
Yöntem
MultiFakeVerse veri seti, dört gerçek dünya görüntü setinden oluşturulmuştur: EMOTIC; PISC, PIPA ve PIC 2.0. 86,952 orijinal görüntüden başlayarak, araştırmacılar 758,041 manipüle edilmiş sürüm üretti.
Gemini-2.0-Flash ve ChatGPT-4o çerçeveleri, her görüntü için altı minimal düzenleme önermek için kullanıldı – bu düzenlemeler, görüntüdeki en nổi bật kişi hakkında algıyı değiştirmek üzere tasarlandı.
Modeller, konu hakkında masum, gururlu, pişman, deneyimsiz veya ilgisiz görünmesini sağlamak için değişiklikler üretmek üzere yönlendirildi veya sahnedeki bazı gerçek unsurları ayarlamak için. Her düzenlemeyle birlikte, modeller ayrıca değişikliğin hedefini açıkça tanımlamak için bir referans ifadesi üretti, böylece sonraki düzenleme süreci, her görüntüdeki ilgili kişi veya nesneye değişiklikleri uygulayabilirdi.
Araştırmacılar şunları açıkladı:
‘Referans ifadesi, geniş bir şekilde araştırılan bir alandır ve bir görüntüdeki hedefi açıklığa kavuşturabilecek bir ifadedir, örneğin, iki adamın bir masada oturduğu bir görüntüde, konuşan adamın ifadesi sol taraftaki adam olabilir.’
Düzenlemeler tanımladıktan sonra, gerçek görüntü manipülasyonu, görüntüdeki geri kalanı değiştirmeden belirtilen değişiklikleri uygulamak için görüntü-dil modellerini yönlendirmek suretiyle gerçekleştirildi. Araştırmacılar bu görev için üç sistemi test etti: GPT-Image-1; Gemini-2.0-Flash-Image-Generation; ve ICEdit.
Yirmi iki bin örnek görüntüyü ürettikten sonra, Gemini-2.0-Flash, sahneye doğal olarak karışan düzenlemeler üreterek en tutarlı yöntem olarak ortaya çıktı; ICEdit genellikle daha açık sahtecilikler üretti ve değiştirilen bölgelerde belirgin hatalar gösterdi; GPT-Image-1 ise bazen görüntünün istenmeyen kısımlarını etkiledi, kısmen de sabit çıktı oranlarına uyması nedeniyle.
Görüntü Analizi
Her manipüle edilmiş görüntü, orijinal görüntüye kıyasla ne kadar değiştiğini belirlemek için incelendi. İki sürüm arasındaki piksel düzeyindeki farklılıklar hesaplandı ve küçük rastgele gürültüleri filtrelemek için anlamlı düzenlemelere odaklanıldı. Bazı görüntülerde yalnızca küçük alanlar etkilenirken, diğerlerinde sahnenin %80’i değiştirildi.
Görüntülerin anlamlarının bu değişikliklerle nasıl değiştiğini değerlendirmek için, orijinal ve manipüle edilmiş görüntüler için ShareGPT-4V görüntü-dil modeli kullanılarak açıklamalar üretildi.
Bu açıklamalar daha sonra Long-CLIP kullanılarak gömme olarak dönüştürülerek, içeriklerin ne kadar farklılaştığının karşılaştırılması sağlandı. En güçlü anlamsal değişiklikler, nesnelerin veya insanla doğrudan ilgili nesnelerin değiştirildiği durumlarda görüldü, çünkü bu küçük ayarlamalar görüntünün yorumlanmasını önemli ölçüde değiştirebilirdi.
Gemini-2.0-Flash, her görüntüdeki tip manipülasyonun uygulanma şekline göre sınıflandırmak için kullanıldı. Manipülasyonlar üç kategoriye ayrıldı: kişi düzeyinde düzenlemeler, konu kişinin yüz ifadesi, duruşu, bakışları, kıyafeti veya diğer kişisel özelliklerinde değişiklikler içeriyordu; nesne düzeyinde düzenlemeler, ön plandaki nesneleri veya insanla etkileşimde bulunanları etkileyordu; ve sahte düzeydeki düzenlemeler, kişinin doğrudan dahil olmadığı arka plan öğelerini veya daha geniş çevre unsurlarını içeriyordu.

MultiFakeVerse veri seti oluşturma pipeline’ı, gerçek görüntülerle başlar, burada görüntü-dil modelleri, insanları, nesneleri veya sahneleri hedefleyen anlatısal düzenlemeleri önerir. Bu talimatlar daha sonra görüntü düzenleme modelleri tarafından uygulanır. Sağ panel, veri seti boyunca kişi düzeyinde, nesne düzeyinde ve sahne düzeyinde manipülasyonların dağılımını gösterir. Kaynak: https://arxiv.org/pdf/2506.00868
Çünkü bireysel görüntüler aynı anda birden fazla düzenleme türünü içerebiliyordu, bu kategorilerin dağılımı veri seti boyunca haritalandı. Yaklaşık olarak düzenlemenin üçte biri yalnızca kişiye yönelikti, yaklaşık beşte biri yalnızca sahneyi etkileyordu ve yaklaşık altıda biri yalnızca nesnelere özgüydü.
Algısal Etki Değerlendirmesi
Gemini-2.0-Flash, altı alanda nasıl manipülasyonların bir görüntüdeki algıyı değiştirebileceğini değerlendirmek için kullanıldı: duygu, kişisel kimlik, güç dinamikleri, sahte anlatı, manipülasyon amacı ve etik kaygılar.
duygu için, düzenlemeler genellikle neşeli, ilgi çekici veya yaklaşılabilir gibi terimlerle tanımlanıyordu, bu da konuların duygusal olarak nasıl çerçeveleştirildiğinde değişiklikler olduğunu gösteriyordu. Anlatısal olarak, profesyonel veya farklı gibi kelimeler, ima edilen hikaye veya ortamda değişiklikler olduğunu gösteriyordu:

Gemini-2.0-Flash, her manipülasyonun altı algı boyutunu nasıl etkileyebileceğini değerlendirmek için yönlendirildi. Sol: modelin değerlendirmesine rehberlik eden örnek bir.prompt yapısı. Sağ: veri seti boyunca duygu, kimlik, sahne anlatısı, amaç, güç dinamikleri ve etik kaygılar açısından değişikliklerin özetini gösteren kelime bulutları.
Kimlik değişikliklerinin tanımları, genç, oyuncu ve zayıf gibi terimleri içeriyordu, bu da küçük değişikliklerin bireylerin nasıl algılandığını nasıl etkileyebileceğini gösteriyordu. Çoğu düzenlemenin amacı ikna edici, aldatıcı veya estetik olarak etiketlenmiştir. Çoğu düzenleme yalnızca hafif etik kaygılara neden olurken, küçük bir kısmı moderate veya ciddi etik etkileri olarak görülmüştür.

MultiFakeVerse’den örnekler, küçük düzenlemelerin nasıl algıyı değiştirebileceğini gösteriyor. Sarı kutular değiştirilen bölgeleri vurguluyor ve duygular, kimlik, anlatı ve etik kaygılar açısından değişikliklerin analizi eşliğinde.
Metrikler
MultiFakeVerse koleksiyonunun görsel kalitesi, üç standart metrik kullanılarak değerlendirildi: Peak Signal-to-Noise Ratio (PSNR); Structural Similarity Index (SSIM); ve Fréchet Inception Distance (FID):

MultiFakeVerse için PSNR, SSIM ve FID ile ölçülen görüntü kalitesi puanları.
SSIM puanı 0.5774, görüntülerin büyük kısmının korunmasını amaçlayan orta düzeyde benzerliği yansıtmaktadır; FID puanı 3.30, üretilen görüntülerin yüksek kalite ve çeşitlilikte olduğunu gösterir; ve 66.30 desibellik PSNR değeri, manipülasyon sonrası görüntülerin iyi görsel bütünlüğe sahip olduğunu gösterir.
Kullanıcı Çalışması
Kullanıcı çalışması, insanların MultiFakeVerse’deki ince sahtecilikleri ne kadar iyi tespit edebileceğini görmek için gerçekleştirildi. On sekiz katılımcı, gerçek ve manipüle edilmiş örneklerin dengeli bir karışımını içeren elli görüntüyü gördü. Her kişi, görüntünün gerçek veya sahte olduğunu sınıflandırmak ve sahte ise, uygulanmış manipülasyon türünü belirlemekle görevlendirildi.
Gerçek veya sahte olarak sınıflandırma için genel doğruluk %61.67 olarak bulundu, bu da katılımcıların görüntüleri üçte birinden fazlasını yanlış sınıflandırdığını gösterdi.
Araştırmacılar şunları belirttiler:
‘Sahte görüntüler için manipülasyon seviyeleri hakkında insan tahminlerini analiz ederken, tahmin edilen ve gerçek manipülasyon seviyeleri arasındaki ortalama kesişim birliği %24.96 olarak bulundu.
‘Bu, bizim veri setimizde insan gözlemcilerin manipülasyon bölgelerini tespit etmesinin zor olduğunu göstermektedir.’
MultiFakeVerse veri setini oluşturmak için kapsamlı hesaplama kaynaklarına ihtiyaç duyuldu: düzenleme talimatları oluşturmak için Gemini ve GPT modellerine yaklaşık 845.000 API çağrısı yapıldı, bu görevler yaklaşık 1000 dolar maliyetindeydi; Gemini tabanlı görüntüler oluşturmak yaklaşık 2867 dolar maliyetindeydi; ve GPT-Image-1 kullanarak görüntü oluşturmak yaklaşık 200 dolar maliyetindeydi. ICEdit görüntüleri, yerel olarak bir NVIDIA A6000 GPU’da oluşturuldu ve görevi yaklaşık yirmi dört saat içinde tamamladı.
Testler
Testlerden önce, veri seti bölündü ve gerçek görüntülerin %70’i eğitim için, %10’u doğrulama için ve %20’si test için seçildi. Her gerçek görüntüden üretilen manipüle edilmiş görüntüler, orijinal görüntüleriyle aynı küme içinde kaldı.

Veri setinden daha fazla örnek, gerçek (sol) ve değiştirilmiş (sağ) içerik.
Deepfake tespitinin performansı, görüntü düzeyinde doğruluk ve F1 puanı ile ölçüldü. Manipüle edilmiş bölgelerin belirlenmesi için, Eğri Altında Kalan Alan (AUC), F1 puanı ve kesişim üzerinden birleşme (IoU) kullanıldı.
MultiFakeVerse veri seti, test kümesindeki tüm görüntülerde önde gelen deepfake tespit sistemlerine karşı test edildi, rakip çerçeveler CnnSpot; AntifakePrompt; TruFor; ve görüntü-dil tabanlı SIDA idi. Her model, orijinal ön-eğitim ağırlıklarıyla zero-shot modda değerlendirildi.
İki model, CnnSpot ve SIDA, MultiFakeVerse eğitim verisi üzerinde fine-tune edildi ve bu, performansın iyileşip iyileşmediğini değerlendirmek için kullanıldı.

MultiFakeVerse’de zero-shot ve fine-tune koşullarında deepfake tespit sonuçları. Parantez içindeki sayılar, fine-tuning之后ki değişiklikleri gösterir.
Bu sonuçlardan, araştırmacılar şunları belirttiler:
‘[Bu] modeller, daha önceki inpainting tabanlı sahteciliklere dayalı olarak eğitilmiş ve bizim VLM-Düzenleme tabanlı sahteciliklerimizde özellikle zorlanmaktadır, özellikle CNNSpot neredeyse tüm görüntüleri gerçek olarak sınıflandırma eğilimindedir. AntifakePrompt, zero-shot performansı ile %66.87 ortalama sınıf-açık doğruluk ve %55.55 F1 puanı ile en iyi performansı gösterir.
‘Eğitim setimizde fine-tune ettikten sonra, hem CNNSpot hem de SIDA-13B’de performans iyileşmesi gözlemledik, CNNSpot, ortalama sınıf-açık doğrulukta SIDA-13B’yi %1.92 ve F1 puanında %1.97 ile geçerek, fine-tuning之后ki performansı iyileştirdi.’
SIDA-13B, her görüntüdeki manipüle edilmiş bölgelerin konumlarını belirleme yeteneğini ölçmek için MultiFakeVerse’de değerlendirildi. Model, hem orijinal hem de fine-tune edilmiş haliyle test edildi.
Orijinal durumunda, kesişim üzerinden birleşme puanı 13.10, F1 puanı 19.92 ve Eğri Altında Kalan Alan 14.06 olarak bulundu, bu da zayıf konumlandırma performansı olduğunu gösterdi.
Fine-tuning之后, puanlar 24.74 (kesişim üzerinden birleşme), 39.40 (F1 puanı) ve 37.53 (Eğri Altında Kalan Alan) olarak iyileşti. Ancak, ek eğitim之后 bile, model hala değişikliklerin nerede yapıldığını belirlemede zorluk çekti, bu da bu tür küçük, hedeflenmiş değişikliklerin ne kadar zor tespit edilebileceğini vurguladı.
SONUÇ
Yeni çalışma, hem insan hem de makine algısında bir kör nokta ortaya koyuyor: deepfakes etrafındaki kamuoyu tartışmasının büyük kısmının kimlik değişikliklerine odaklanması जबक, bu daha “sessiz” “anlatı düzenleme” daha zor tespit edilebilir ve uzun vadede daha fazla aşındırıcı olabilir.
ChatGPT ve Gemini gibi sistemlerin bu tür içeriği üretmede daha aktif bir rol üstlenmesiyle ve bizim de kendi fotoğraf akışlarımızın gerçekliğini değiştirmeye daha fazla katılımla, yalnızca kaba manipülasyonları tespit eden tespit modelleri yetersiz bir savunma sunabilir.
MultiFakeVerse, tespitin başarısız olmadığı, ancak sorun’un bir kısmının daha zor, daha yavaş ilerleyen bir forma dönüşebileceğini göstermektedir: küçük görsel yalanların fark edilmeden biriktiği bir forma.
İlk olarak 5 Haziran 2025 Perşembe günü yayınlandı


