
Röportajlar
Dr. Mathilde Pavis, OpenOrigins’un Hukuk Başkanı – Röportaj Serisi

 Unite.AI sitesini Google'daki tercih ettiğiniz kaynaklara ekleyin
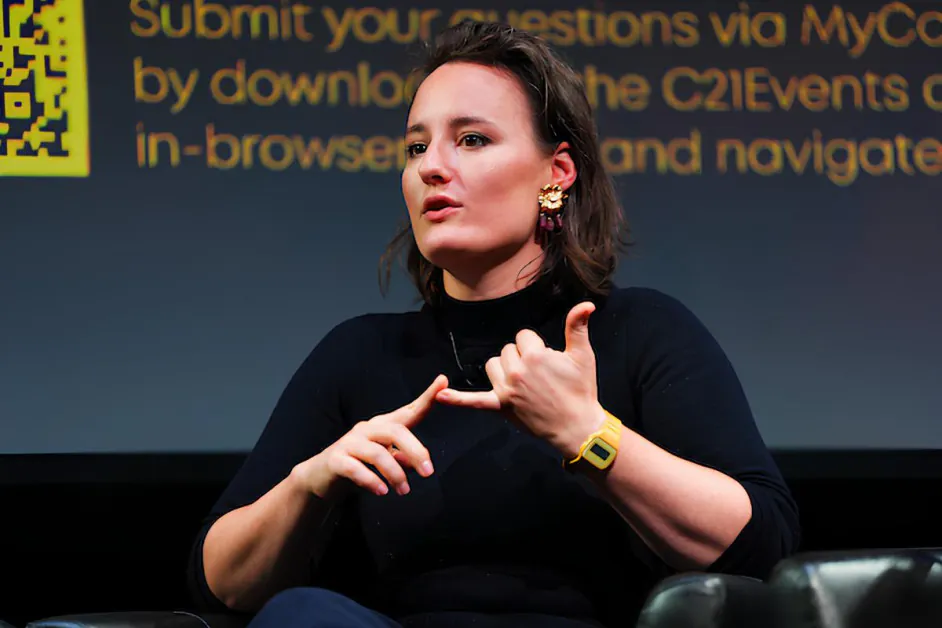
Dr. Mathilde Pavis, OpenOrigins’un Hukuk Başkanı, AI düzenleme ve dijital medya yönetiminde önde gelen bir uzman olup, derin sahtecilik, sentetik medya ve içerik kökeni konularında uzmanlaşmıştır. Şirketlere, hükümetlere ve ticaret birliklerine generatif AI’de uyumluluk, lisanslama ve risk konusunda danışmanlık yapmakta ve Microsoft (MSFT ) ve ElevenLabs ile AI politikası ve stratejisi konularında çalışmıştır. Ayrıca UNESCO’ya AI ve fikri mülkiyet konusunda danışmanlık yapmış ve düzenli olarak UK politika yapıcılarına uzman kanıtları sunmaktadır.
OpenOrigins yanlış bilgiden ve derin sahtecilikten korumak için dijital içerik için doğrulanabilir, değiştirilemez kayıtlar oluşturan teknoloji geliştirmektedir. Platformu, medya, yaratıcılar ve platformlar tarafından içerik oluşturulma, düzenlenme ve dağıtılma zamanını kanıtlamak için açık bir köken oluşturmayı odaklamaktadır – sentetik medya daha gelişmiş ve tespit edilmesi daha zor hale geldikçe giderek daha kritik bir yetenek haline gelmektedir.
Hükümetler, küresel kurumlar gibi UNESCO ve Microsoft ve ElevenLabs gibi şirketlere AI düzenleme konusunda danışmanlık yaptınız. Derin sahtecilik, dijital kopyalama ve sentetik medya konularına odaklanmanıza ne yol açtı ve bu yolculuk Replique’i kurma kararınızı nasıl etkiledi?
Derin sahtecilik konusundaki çalışmalarım teknolojiyle başlamadı – çok daha eski bir yasal bilmeceden başladı. 2013’te fikri mülkiyet konusunda doktora araştırmamı başlattığımda, sanatçıların, bestecilerin veya film yapımcılarına kıyasla performansçıların çok daha az koruma altına alındığını fark ettim. Uygulamada bu, sözünüzün, müziğinizin veya yüzünüzün, sesinizin ve bedeninize kıyasla daha iyi korunması anlamına gelir. Bu dengesizlik tuhaf görünüyordu ve bana daha derin bir soru sormaya itti: yüzü, sesi ve ekran üzerindeki bedeniyle katkıda bulunan birinin çalışmasını nasıl kültürel ve yasal olarak değerlendirebiliriz?
Bu soru beni performans hakları ve verilere yöneltti. O zamanlar, bu alan ticari olarak pouco ilgili ve dar bir alan olarak görülüyordu. Bana daha “kârlı” alanlara, Örneğin patent veya geleneksel telif haklarına geçmem tavsiye edildi. Varsayım, bir kişinin benzeti veya sesi ile ilgili konuların büyük ölçüde endüstri normları veya “Hollywood’da centilmen anlaşmaları” aracılığıyla yönetildiğiydi. Ancak bana göre, bu resmi korumaların eksikliği bir boşluk değil, bir araştırma son değil anlamına geliyordu, bu nedenle devam ettim.
Değişen şey, bugün neredeyse herkesin bir performansçı olmasıdır. Hayatlarımız kameralar aracılığıyla – telefonlarda, dizüstü bilgisayarlarda, video görüşmelerinde ve sosyal platformlarda aracılık edilmektedir. İş veya kişisel kullanım için olsun, insanlar sürekli olarak kendilerinin sürümlerini kaydediyor ve paylaşıyor. Bir zamanlar yalnızca aktörlere veya müzisyenlere uygulanan yasal sorular artık bir akıllı telefonu olan herkes için geçerli.
Derin sahtecilik bu sorunları yaratmadı – onları ortaya çıkardı ve hızlandırdı. 2013’ten itibaren yaptığım araştırmalar aniden acil hale geldi. 2017 ve 2018’de, özellikle MIT ve UC Berkeley gibi yerlerden gelen nöral ağ gelişmeleri, bir kişinin yüzünün, sesinin ve bedenin nasıl dijital olarak manipüle edilebileceğini göstermeye başladı. Bir yıl içinde, bu yetenek geniş çapta “derin sahtecilik” olarak tanındı ve ilk olarak özellikle kadınları ve çocukları hedef alan zararlı yollarda dikkat çekti.
Sadece daha sonra ticari etkileri ortaya çıktı, yaratıcı endüstriler sentetik medya benimsemeye başladığında. O zaman, çalışmakta olduğum sözleşmesel ve ekonomik sorular ön plana çıktı. Gece gündüz, teorik veya doktriner bir hukuk alanı olarak görülen şey, çok pratik, ticari olarak önemli ve sosyal olarak acil bir alan haline geldi.
Temelde, yasal zorluk değişmedi: insanlar kendilerinin bazı yönlerini paylaşmak istiyor, ancak aynı zamanda anlamlı bir kontrolü elinde tutmak istiyor. Mevcut çerçeveler bu nüansı başa çıkma konusunda mücadele ediyor. Bireyleri ya tamamen özel ya da tamamen kamu olarak tedavi etme eğilimindeler – ya korunan ya da adil oyun. Ancak çoğu insan bu ikisi arasında bir yerde var. Bu gerilim artık yalnızca profesyonel performansçılar için değil, dijital hayatta yer alan herkes için merkezi bir vấnadır.
Bu alanda araştırma yapan ve çalışan biri olarak tanındım, bu da hükümetlerin insanların derin sahteciliklere karşı korunmasına ilgi duyan ve dijital klonlama ürünleri güvenli bir şekilde kullanılmasını isteyen şirketlerle çalışmama yol açtı. Replique’de, edindiğim her şeyi dijital klonlama veya dijital kopyalama teknolojilerini sorumlu ve güvenli bir şekilde kullanmak isteyen kişilere ve şirketlere getiriyorum. Temel olarak, “mavi gökyüzü” araştırmamı, yaratıcı endüstrilere uzman hukuk danışmanlığı sunan bir danışmanlık işine çevirdim.
OpenOrigins’un Hukuk Başkanı olarak, içerik kökenini doğrulamak için değiştirilemez bir kayıt oluşturan bir şirket olarak, köken tabanlı sistemlerin geleneksel derin sahtecilik algılama yaklaşımlarıyla nasıl rekabet ettiğini veya onları değiştirdiğini nasıl görüyorsunuz?
Derin sahtecilik algılama araçlarını karşılaştırmak, nhanh chóng bir elma ile armut karşılaştırması haline gelebilir, çünkü onların etkinliği bağlam ve amaçlarına bağlıdır. Politika açısından, bizim ihtiyacımız olan şey, tamamlayıcı araçların bir dizi olması – tek bir “en iyi” çözüm yok ve OpenOrigins daha geniş bir ekosistemin bir parçasıdır. OpenOrigins’un teknolojisini, bir içerik oluşturucu veya bilgi kuruluşunun paylaştığı içeriğin gerçekliğini kanıtlaması gereken durumlarda, bir derin sahtecilik algılama çözümü olarak ayırt ettiği yer, bu.
Oluşturma noktasında doğrulanabilir köken ve “makbuzlar” sağlayarak, içeriğin bir derin sahtecilik olmadığını kanıtlamak için güçlü bir önleme biçimi sunar. Ancak bu yaklaşım, internet kullanıcılarının çevrimiçi karşılaştıkları içeriği hızlı bir şekilde değerlendirmeleri gereken durumlarda daha az kullanışlıdır. Bu durumlarda, algılama, köken tabanlı doğrulamaya değil, olasılıksal ve içerik analizi yöntemlerine daha fazla dayanır. Farklı ihtiyaçlar için farklı araçlara ihtiyacımız var ve derin sahteciliklere karşı hiçbir gümüş kurşun olmadığını kabul etmeliyiz.
AI tarafından oluşturulan veya çoğaltılan içerikte rıza ve mülkiyet konusunda yargı bölgelerinin nasıl ele aldığında şu anda en büyük boşluk nedir?
Oh, ne kadar süreniz var? Cevap, AI tarafından oluşturulan veya çoğaltılan içeriğin ne olduğu anlamına gelir. Sorunlar, bir AI tarafından oluşturulan bir ev resmi veya bir kedi resmi ile bir kişinin yüzünün veya sesinin dijital olarak yeniden yaratılması arasında farklılık gösterir. “Dijital klonlama” konusuna bağlı kalalım ve soruyu bu bağlamda cevaplayalım.
Rızaya gelince, temel sorun, most sözleşmelerin – istihdam anlaşmaları veya platform şartları – geniş, belirsiz hükümler içermesi ve kullanıcı içeriği üzerinde geniş haklar vermesidir. Bu, “arka kapı rızası” olarak yorumlanabilir, yani şartlara uymak, klonlama gibi kullanımlara rıza göstermek anlamına gelebilir, ancak çoğu insan bu yorumu güçlü bir şekilde reddedecektir. Bu, yasal yorum ile kullanıcı beklentisi arasında önemli bir boşluk yaratır, bu da şirketlere yarar sağlar, ancak düzenleme geride kalır.
Mülkiyete gelince, dijital bir klonun kime ait olduğu konusunda net bir yasal cevap yoktur, çünkü mevcut çerçeveler – veri koruma, telif hakkı ve kişilik hakları – bu teknoloji için tasarlanmamıştır. Bugün, çoğu insan işyerinde, bir işveren veya müşterinin talebi ve finansmanıyla tarama ve klonlama yapılır. Ve bu varlıklar genellikle yüksek bir kontrol düzeyine sahip olmayı bekler, bu anlaşılabilir ancak sorunludur, çünkü bu varlık, yüzünüzün veya sesinizin dijital bir taklidi olabilir ve sizin hiç söylemediğiniz veya yapmadığınız şeyleri söyleyebilir veya yapabilir.
“Klonunuzun kime ait?” sorusu çok önemlidir, ancak yasada henüz cevaplanmamıştır.
Ses klonlama teknolojileri üzerinde yakın çalıştınız. Sentetik sesler konusunda şirketler ve bireyler için en yanlış anlaşılan yasal riskler nelerdir?
Yasal uyum konusundaki en yanlış anlaşılan sorun, bir şirketin dijital bir klonu finanse etme ve sömürme ticari çıkarı ile bireyin gizlilik ve dijital onur hakkı arasındaki dengeyi bulmaktır. Bu gerilim, öncelikle fikri mülkiyet, veri koruma ve gizlilik olmak üzere birden fazla yasal rejim boyunca yer alır ve klonlama fundamental olarak farklı şekillerde yorumlar. Sonuç olarak, bunu iş dostu uygulamalara çevirmek karmaşıktır ve souvent belirsizdir. Şirketler ya anahtar riskleri göz ardı eder ya da bunları düzgün bir şekilde gezinmek için önemli maliyetlere katlanır. Bu, sorumlu uyumu daha zor ve daha pahalı bir yol haline getirir, değilse de varsayılan yol haline getirir.
AI sistemlerinde, özellikle benzerlik, kimlik ve eğitim verisi ile ilgili olarak, işletmelerin rıza mimarisini nasıl düşünmeleri gerekir?
Şirketler, üç temel yetenek etrafında sistemlerini tasarlamalıdır. İlk olarak, kaydında bilgilendirilmiş, bağlamsal rızayı güvence altına almalıdırlar. İkincisi, kullanıcıların bu rızayı geri çekmelerine ve bazı veya tüm verilerini silmelerine olanak tanımalıdırlar, bu teknik olarak zor ve souvent göz ardı edilir, ancak GDPR gibi yasalarla uyumluluk için gereklidir. Rızayı zaman içinde korumanın anlamı, iş modeliyle uyumlu ve sorunsuz bir şekilde geri çekilmesini sağlayan sistemler oluşturmaktır.
Rıza granüler olmalıdır. Ve üçüncüsü, kullanıcıların bireysel dosyaları, benzeti verilerini güncellemeleri ve nasıl kullanıldığını anlamaları için izinleri yönetmelerine olanak tanımalıdır. Bu, şeffaflık ve kontrol gerektirir – kullanıcıların dijital klonlarının nasıl kullanıldığını izlemelerine, gözden geçirmelerine ve düzenlenmesine olanak tanıyan araçlar. Bu düzeyde esneklik hala nadirdir, ancak rekabet avantajı giderek burada yatmaktadır.
Startup’lar ve hükümetlere danışmanlık yaptığınız deneyiminizde, AI’nin nasıl inşa edildiği ile nasıl düzenlendiği arasında en büyük kopukluk nerede?
AI’nin nasıl inşa edildiği ile nasıl düzenlendiği arasındaki kopukluk, temel olarak farklı misyonlardan kaynaklanmaktadır. Hükümetler, kamu çıkarına göre düzenler, mientras AI şirketleri (sık sık risk sermayesi tarafından desteklenir) öncelikle büyüme, gelir ve kar tarafından yönlendirilir. Bu öncelikler her zaman çatışmaz, ancak sık sık farklı yönlerde çekilir, düzenleme bir kısıtlama olarak değil, bir destek olarak görülür.
Bu, bir yapısal gerilim yaratır: düzenleyiciler ve inovatörler farklı teşvikler, değerler ve hatta dillerle çalışmaktadır. Bu, uygulamada uyumu zorlaştırır, imkansız olmasa da. Kamu çıkarına yönelik hedeflerle daha yakından hizalanmış yeni bir dizi teknoloji şirketini görmeye başlıyoruz, ancak bunlar henüz kural değil, özellikle ölçeklenenler arasında.
OpenOrigins, kriptografik köken kullanarak oluşturma noktasında içeriği doğrulamaya odaklanıyor. Köken-öncelikli bu yaklaşımın, dağıtımdan sonra güvenlik önlemlerine kıyasla ne kadar kritik olduğu?
Bu, önceki cevabıma geri dönmektedir. İçeriği oluşturma noktasında doğrulamak, “yukarı akış” olarak, dağıtım veya tüketim noktasında doğrulamaya çalışmaktan çok daha etkilitir, yani “aşağı akış”. İçeriği oluşturma noktasında doğrulamak, gıdayı çiftlikte yetiştirildiği andan itibaren izlemek gibidir, değilse de tabağınızdaki yemeği analiz etmeye çalışmak gibi. Çiftlikte nasıl yetiştirildiğini, nasıl işlendiğini ve tedarik zincirinde nasıl hareket ettiğini biliyorsanız, yediğiniz şeyi güvenle yiyebilirsiniz. Eğer ngược, yemeğinizi analiz etmeye çalışıyorsanız, sadece tahminlere güveniyorsunuz. Aynı şey, insan tarafından oluşturulan ve AI tarafından oluşturulan içerik arasındaki farkı ayırt etmeye çalışan çevrimiçi içerik için geçerlidir: köken noktasında verilen kanıt, aşağı akışta algılama daha belirsiz ve tepkiseldir.
C2PA gibi standartların gelecekte medyada nasıl bir rol oynayacağını görüyorsunuz ve bunlar alone yeterli mi?
C2PA hoş bir girişimdir ve birçok yönden OpenOrigins ile aynı içerik kimlik hareketini desteklemektedir. İçerik güvenliği ve kimlik ekosisteminin önemli bir parçasıdır. Herhangi bir siber güvenlik aracı gibi, tek bir gümüş kurşun yoktur.
Sinema, müzik ve oyun gibi endüstrilerdeki yaratıcılar ve yetenekler için, kendilerini yetkisiz dijital kopyalamadan korumak için bugün hangi pratik adımları atmalılar?
Sanatçılar bugün iki ayrı riskle karşı karşıyadır: çalışmalarının kopyalanması (örneğin müzik, resim veya yazı) ve benzetiğinin kopyalanması, yani yüzleri, sesleri ve bedenleri. AI sistemleri, minimum girdi ile, bu iki tür içeriği de yüksek bir doğruluk payı ile yeniden üretebilir. Pratik olarak, koruma, online olarak ne paylaştığınıza dikkat etmekle başlar, herhangi bir içerik paylaştığınızda, bu içeriklerin eğitim veri kümelerinde kullanılmak üzere kazılabileceği ve görünür olmadan kullanılabileceği gerçeğinin farkında olmanız anlamına gelir.
Bu risk, artık online olarak faaliyet gösteren bir gerçekliktir. Ancak daha doğrudan ve kontrol edilebilir risk, genellikle sözleşmelerdedir. Sanatçıların işbirlikçileri, dağıtıcıları veya platformlarıyla yaptığı anlaşmalar, AI kullanımına, yeniden kullanımına veya eğitim amaçlı kullanımına izin veren hükümler içerebilir – genellikle anlamlı bir katılım olmadan. Bu, yaratıcılar için sözleşme incelemesinin kritik hale geldiği anlamına gelir. Çalışmalarının ve benzetiğinin nasıl kullanılabileceğini, lisanslanabileceğini veya yeniden satılabileceğini anlamak, yaratıcı süreç kendisi kadar önemlidir.
İki önemli tavsiye: online olarak ne paylaştığınıza dikkat edin ve AI hükümlerini arayarak sözleşmenizi imzalamadan önce okuyun.
Üç ila beş yıl sonrasına bakıldığında, her dijital içeriğin doğrulanabilir bir köken taşıması gerektiği bir noktaya ulaşacağımızı düşünüyor musunuz, yoksa güven platformlar ve yargı bölgeleri arasında parçalanmış kalacak mı?
Eğer deseydim, evet, ama gerçekçi olarak, hayır – beş yıl içinde değil. Teknoloji alanında beş yıl uzun bir süre gibi görünüyor; kullanıcı davranışları ve alışkanlıklarını değiştirmek için ise çok kısa. Çoğu tüketici, içeriğin doğrulanabilir bir köken taşıması nedeniyle karar vermez. Platformlar, kullanıcı talebini takip eder ve katılımı optimize eder, değilse de köken.
Bu, düzenleme müdahalesi ile değişebilir. already California gibi yerlerde, etiketleme ve moderasyon gereksinimleri ortaya çıkmaya başlıyor, ancak bunu küresel olarak ölçeklendirme on yıl kadar sürebilir.
Değişimin başka bir alanı, sektöre özgüdür: gazetecilik, finans, sigorta ve sağlık gibi endüstriler, operasyonlarının temelinde güven olduğu için, köken ve kimlik doğrulama gerektirmeye başlayabilir.
Son olarak, tüketiciler kısa vadede köken bilgilerine dikkat etmeyebilir, ancak içerik ve bilgi kalitesine dikkat edeceklerdir. AI tarafından oluşturulan içerik çok homojen veya “renksiz” hale gelirse, izleyiciler insan tarafından oluşturulan içeriği daha açık bir şekilde değerlendirmeye başlayabilir. Bu, bazı platformların ölçek ve AI tarafından oluşturulan içeriğe öncelik vererek, diğerlerinin ise kimlik, köken ve yüksek güven, insan tarafından yönetilen materyale odaklanarak pazarın segmentasyonuna yol açabilir – ancak bu değişim bilinmezliğini koruyor.
Harika cevaplarınız için teşekkür ederiz, daha fazla bilgi öğrenmek isteyen okuyucular OpenOrigins ziyaret edebilir.


