
AGI och framtidens AI
Rollen för vektordatabaser i moderna generativa AI-applikationer

 Lägg till Unite.AI bland dina föredragna källor på Google

För att storskaliga generativa AI-applikationer ska fungera effektivt behöver de ett bra system för att hantera stora mängder data. Ett sådant viktigt system är vektordatabasen. Det som särskiljer denna databas är dess förmåga att hantera många typer av data, som text, ljud, bilder och videor, i form av vektorer/nummer.
Vad är vektordatabaser?
Vektordatabasen är ett specialiserat lagringssystem som är utformat för att hantera högdimensionella vektorer effektivt. Dessa vektorer, som kan ses som punkter i ett multi-dimensionellt rum, representerar ofta inbäddningar eller komprimerade representationer av mer komplexa data, som bilder, text eller ljud.
Vektordatabaser möjliggör snabba likhetsökningar mellan dessa vektorer, vilket möjliggör snabb återvinning av de mest liknande objekten från en stor datamängd.
Traditionella databaser vs. vektordatabaser
Vektordatabaser:
- Hantering av högdimensionell data: Vektordatabaser är utformade för att hantera och lagra data i högdimensionella rum. Detta är särskilt användbart för applikationer som maskinlärning, där datapunkter (såsom bilder eller text) kan representeras som vektorer i multi-dimensionella rum.
- Optimerad för likhetsökning: En av de främsta funktionerna i vektordatabaser är deras förmåga att utföra likhetsökningar. Istället för att fråga data baserat på exakta träffar, tillåter dessa databaser användare att hämta data som är “liknande” en given fråga, vilket gör dem ovärderliga för uppgifter som bild- eller textåtervinning.
- Skalbarhet för stora datamängder: När AI- och maskinlärningsapplikationer fortsätter att växa, ökar också mängden data de bearbetar. Vektordatabaser är byggda för att skalas, vilket säkerställer att de kan hantera stora mängder data utan att kompromissa med prestandan.
Traditionella databaser:
- Strukturerad data lagring: Traditionella databaser, som relationsdatabaser, är utformade för att lagra strukturerad data. Detta innebär att data är organiserad i fördefinierade tabeller, rader och kolumner, vilket säkerställer dataintegritet och konsekvens.
- Optimerad för CRUD-operationer: Traditionella databaser är primärt optimerade för CRUD-operationer. Detta innebär att de är utformade för att effektivt skapa, läsa, uppdatera och ta bort dataposter, vilket gör dem lämpliga för en mängd olika applikationer, från webbtjänster till företagsprogram.
- Fast schema: En av de definierande egenskaperna hos många traditionella databaser är deras fasta schema. När databasstrukturen är definierad kan det vara komplext och tidskrävande att göra ändringar. Denna rigiditet säkerställer datakonsekvens, men kan vara mindre flexibel än det schema-lösa eller dynamiska schemat i vissa moderna databaser.
Traditionella databaser kämpar ofta med komplexiteten i inbäddningar, en utmaning som vektordatabaser hanterar lätt.
Vecktorrepresentationer
Centalt för vektordatabasers funktion är det grundläggande begreppet att representera olika former av data med hjälp av numeriska vektorer. Låt oss ta en bild som exempel. När du ser en bild av en katt, kan den för en maskin omvandlas till en unik 512-dimensionell vektor, såsom:
[0.23, 0.54, 0.32, …, 0.12, 0.45, 0.90]
Med vektordatabaser kan generativa AI-applikationer göra mer. Den kan hitta information baserat på mening och komma ihåg saker under lång tid. Intressant nog är denna metod inte begränsad till bilder ensam. Textdata fylld med kontextuella och semantiska betydelser kan också omvandlas till vektorformer.
Generativ AI och behovet av vektordatabaser
Generativ AI innehåller ofta inbäddningar. Ta till exempel ordinbäddningar i naturligt språkbehandling (NLP). Ord eller meningar omvandlas till vektorer som fångar semantisk betydelse. När genererande text skapas behöver modellerna snabbt jämföra och hämta relevanta inbäddningar, vilket säkerställer att den genererade texten behåller kontextuella betydelser.
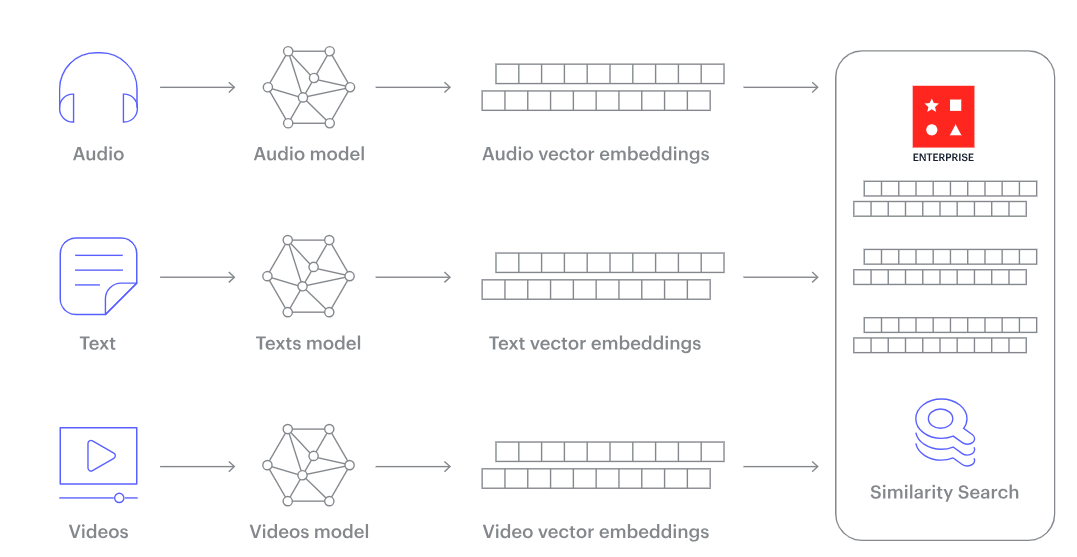
Likaså i bild- eller ljudgenerering spelar inbäddningar en avgörande roll för att koda mönster och funktioner. För att dessa modeller ska fungera optimalt kräver de en databas som tillåter omedelbar återvinning av liknande vektorer, vilket gör vektordatabaser till en avgörande komponent i den generativa AI-pusslet.
Skapandet av inbäddningar för naturligt språk vanligtvis med hjälp av förtränade modeller, såsom:
- GPT-3 och GPT-4: OpenAI’s GPT-3 (Generative Pre-trained Transformer 3) har varit en monumental modell i NLP-gemenskapen med 175 miljarder parametrar. Följande GPT-4, med ännu fler parametrar, fortsätter att pressa gränserna för att skapa högkvalitativa inbäddningar. Dessa modeller är tränade på diversifierade dataset, vilket möjliggör att de skapar inbäddningar som fångar en stor mängd lingvistiska nyanser.
- BERT och dess varianter: BERT (Bidirectional Encoder Representations from Transformers) från Google är en annan betydande modell som har sett olika uppdateringar och iterationer, som RoBERTa och DistillBERT. BERT:s bidirektionella träningsmetod, som läser text i båda riktningarna, är särskilt lämplig för att förstå kontexten kring ett ord.
- ELECTRA: En mer nylig modell som är effektiv och presterar lika bra som större modeller som GPT-3 och BERT, samtidigt som den kräver färre beräkningsresurser. ELECTRA diskriminerar mellan riktiga och falska data under förträning, vilket hjälper till att generera mer raffinerade inbäddningar.

Förståelse av ovanstående process:
Initialt används en inbäddningsmodell för att omvandla önskad innehåll till vektorinbäddningar. När dessa inbäddningar har genererats lagras de i en vektordatabas. För enkel spårbarhet och relevans behåller dessa lagrade inbäddningar en länk eller referens till det ursprungliga innehåll de hämtades från.
Senare, när en användare eller system ställer en fråga till applikationen, hoppar samma inbäddningsmodell in i handling. Den omvandlar denna fråga till motsvarande inbäddningar. Dessa nybildade inbäddningar söker sedan i vektordatabasen efter liknande vektorrepresentationer. De inbäddningar som identifieras som matchningar har en direkt association med sitt ursprungliga innehåll, vilket säkerställer att användarens fråga besvaras med relevanta och precisa resultat.
Ökande investeringar i vektordatabas-nykomlingar
Med AI:s ökande popularitet satsar många företag mer pengar på vektordatabaser för att förbättra sina algoritmer och göra dem snabbare. Detta kan ses med de senaste investeringarna i vektordatabas-startups som Pinecone, Chroma DB och Weviate.

Stora företag som Microsoft (MSFT ) har också sina egna verktyg. Till exempel tillåter Azure Cognitive Search företag att skapa AI-verktyg med hjälp av vektordatabaser.
Oracle (ORCL ) har nyligen meddelat nya funktioner för sin Database 23c, som introducerar en integrerad vektordatabas. Den kallas “AI Vector Search” och kommer att ha en ny datatyp, index och sökverktyg för att lagra och söka data som dokument och bilder med hjälp av vektorer. Den stöder Retrieval Augmented Generation (RAG), som kombinerar stora språkmodeller med företagsdata för bättre svar på språkfrågor utan att dela privata data.
Primära överväganden för vektordatabaser
Avståndsmått
Effektiviteten i en likhetsökning beror på det valda avståndsmåttet. Vanliga mått inkluderar Euclideiskt avstånd och kosinlikhet, som vardera passar för olika typer av vektordistributioner.
Indexering
Med tanke på vektorernas höga dimensioner fungerar traditionella indexmetoder inte. Vektordatabaser använder tekniker som Hierarkiska Navigerbara Små Världar (HNSW) eller Annoy-träd, vilket möjliggör effektiv partitionering av vektorrummet och snabba närmaste-grannsökningar.

Annoy-träd (Källa)
Annoy är en metod som använder binära sökträd. Den delar upp vårt dataspace många gånger och tittar bara på en del av det för att hitta nära grannar.
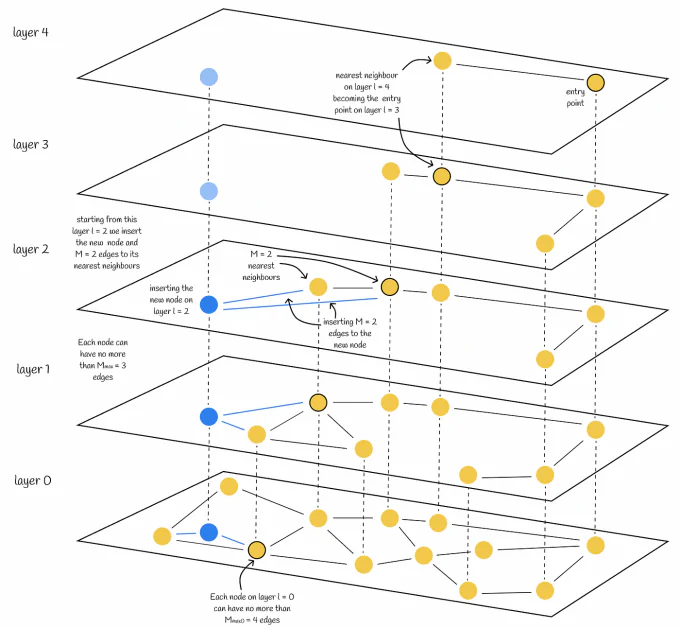
Hierarkiska Navigerbara Små Världar (HNSW) (Källa)
HNSW-grafer, å andra sidan, är som nätverk. De kopplar samman datapunkter på ett särskilt sätt för att göra sökningen snabbare. Dessa grafer hjälper till att snabbt hitta nära punkter i datat.
Skalbarhet
När datamängder växer, ökar också utmaningen att upprätthålla snabba återvinningstider. Distribuerade system, GPU-acceleration och optimerad minneshantering är några sätt vektordatabaser hanterar skalbarhet.
Rollen för vektordatabaser: Implikationer och möjligheter
1. Träningsdata för avancerade generativa AI-modeller: Generativa AI-modeller, som DALL-E och GPT-3, tränas med hjälp av stora mängder data. Denna data består ofta av vektorer som extraherats från en mängd olika källor, inklusive bilder, text, kod och andra domäner. Vektordatabaser hanterar och kuraterar noggrant dessa datamängder, vilket möjliggör för AI-modellerna att assimilera och analysera världens kunskap genom att identifiera mönster och relationer inom dessa vektorer.
2. Förbättring av few-shot learning: Few-shot learning är en AI-träningsmetod där modeller tränas med begränsad data. Vektordatabaser förstärker denna metod genom att upprätthålla en robust vektorindex. När en modell exponeras för bara ett fåtal vektorer – till exempel ett par bilder av fåglar – kan den snabbt extrapolera det breda begreppet om fåglar genom att känna igen likheter och relationer mellan dessa vektorer.
3. Förbättring av rekommendationssystem: Rekommendationssystem använder vektordatabaser för att föreslå innehåll som är nära anslutet till en användares preferenser. Genom att analysera en användares beteende, profil och frågor extraheras vektorer som indikerar deras intressen. Systemet söker sedan i vektordatabasen efter innehållsvektor som liknar dessa intressevektor, vilket säkerställer precisa rekommendationer.
4. Semantisk informationsåtervinning: Traditionella sökmetoder förlitar sig på exakta nyckelordsmatchningar. Vektordatabaser möjliggör dock för system att förstå och hämta innehåll baserat på semantisk likhet. Detta innebär att sökningar blir mer intuitiva, fokuserade på den underliggande meningen i frågan snarare än bara matchande ord.
5. Multimodal sökning: Multimodal sökning är en ny teknik som integrerar data från flera källor, som text, bilder, ljud och video. Vektordatabaser fungerar som ryggraden i denna metod genom att möjliggöra kombinerad analys av vektorer från olika modaliteter. Detta resulterar i en holistisk sökupplevelse, där användare kan hämta information från en mängd olika källor baserat på en enda fråga, vilket leder till rikare insikter och mer omfattande resultat.
Slutsats
AI-världen förändras snabbt. Den berör många branscher, medför både positiva och negativa konsekvenser. De snabba framstegen inom generativ AI understryker den viktiga rollen som vektordatabaser spelar i hantering och analys av multi-dimensionell data.
Dessa specialiserade lagringssystem, som är utformade för att hantera högdimensionella vektorer från varierande dataformer, står som en hörnsten i den effektiva funktionen av moderna AI-applikationer, särskilt i området likhetsökningar.


