
Andersons vinkel
Att ta bort objekt från video mer effektivt med maskinlärande

 Lägg till Unite.AI bland dina föredragna källor på Google
Viktiga punkterE2FGVI förenar tre videoreparationsstadier till ett end-to-end-system för betydande…
Visa mer
- E2FGVI förenar tre videoreparationsstadier till ett end-to-end-system för betydande effektivitetsvinster.
- Systemet körs femton gånger snabbare än tidigare optiska flödesmetoder samtidigt som det uppnår toppmoderna resultat.
- En ny temporal fokaltransformator utökar uppmärksamheten från 2D till 3D för sammanhängande innehållshallucination över bildrutor.
Ny forskning från Kina rapporterar om resultat i forskningsfronten – samt en imponerande förbättring av effektiviteten – för ett nytt system för videoinpainting som skickligt kan ta bort objekt ur videomaterial.
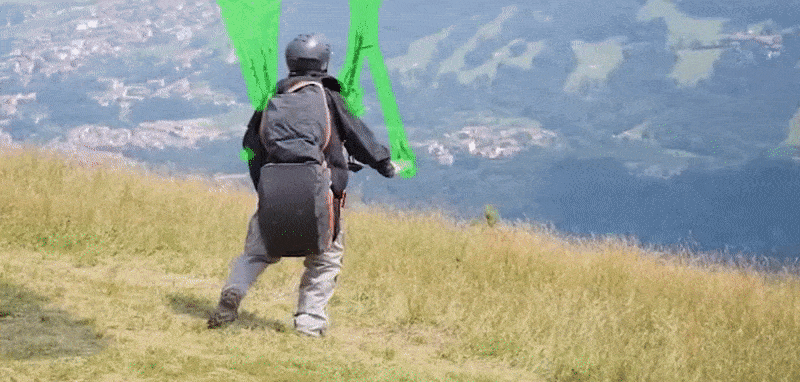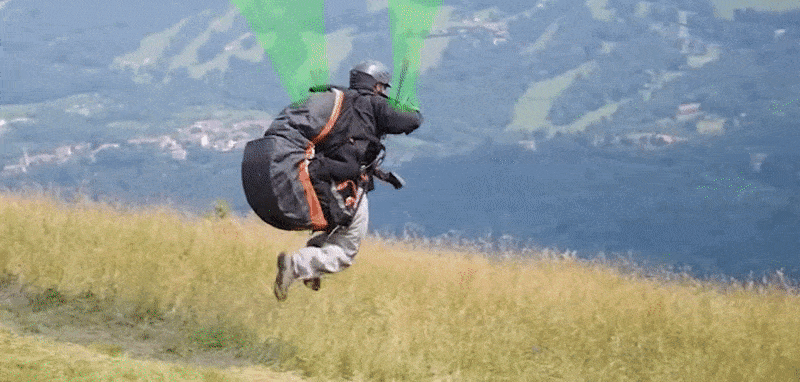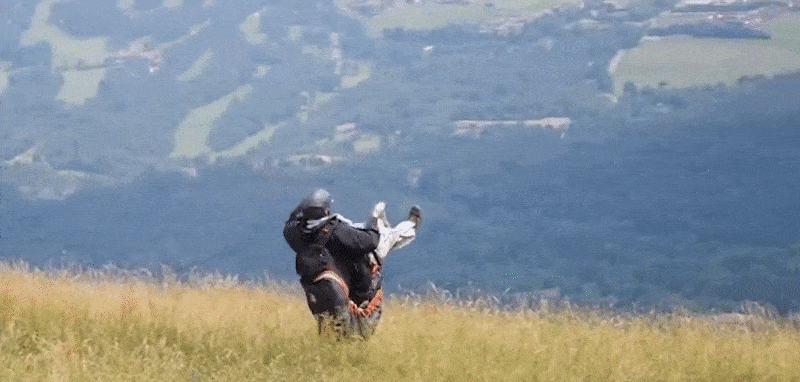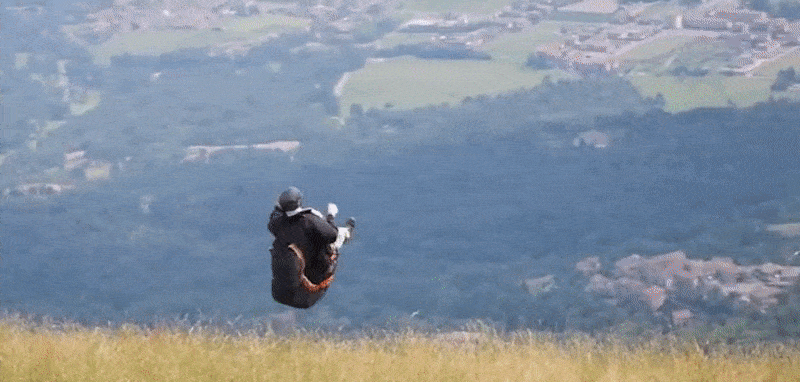
En hängflygares sele målas bort av den nya proceduren. Se källvideon för bättre upplösning och fler exempel. Källa: https://www.youtube.com/watch?v=N–qC3T2wc4
Tekniken, som kallas End-to-End-ramverk för Flow-Guided videoinpainting (E2FGVI), kan också ta bort vattenmärken och andra typer av ocklusioner från videoinnehåll.
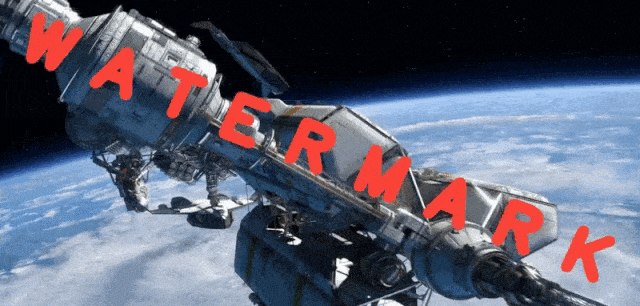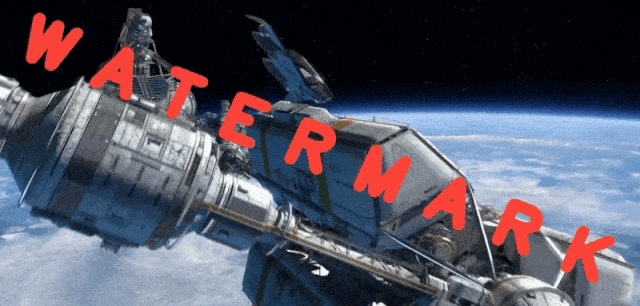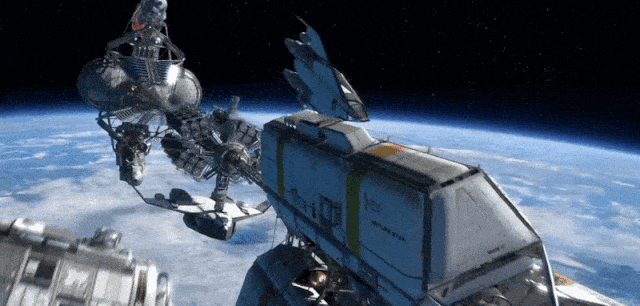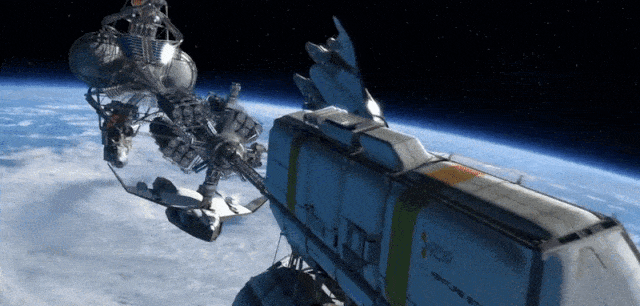
E2FGVI beräknar förutsägelser för innehåll som ligger bakom ocklusioner, vilket möjliggör borttagning av till och med noterbara och svåra vattenmärken. Källa: https://github.com/MCG-NKU/E2FGVI
(För att se fler exempel i bättre upplösning, se videon)
Även om modellen som presenteras i den publicerade artikeln tränades på videor med upplösningen 432px x 240px (vanligtvis låga ingångsstorlekar, begränsade av tillgängligt GPU-utrymme i förhållande till optimala batchstorlekar och andra faktorer), har författarna sedan släppt E2FGVI-HQ, som kan hantera videor i godtycklig upplösning.
Koden för den aktuella versionen finns tillgänglig på GitHub, medan HQ-versionen, som släpptes förra söndagen, kan laddas ner från Google Drive och Baidu Disk.

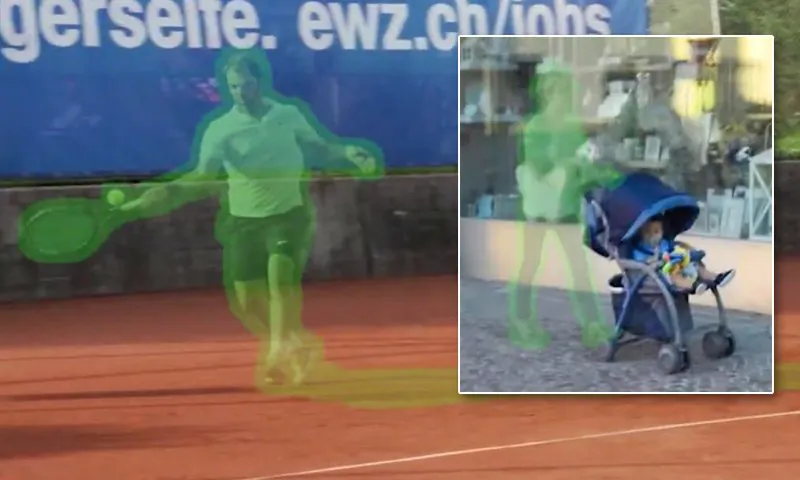
Barnet stannar kvar i bilden.
E2FGVI kan bearbeta 432×240-videor på 0,12 sekunder per bildruta på en Titan XP-GPU (12 GB VRAM), och författarna rapporterar att systemet fungerar femton gånger snabbare än tidigare state-of-the-art-metoder baserade på optiskt flöde.
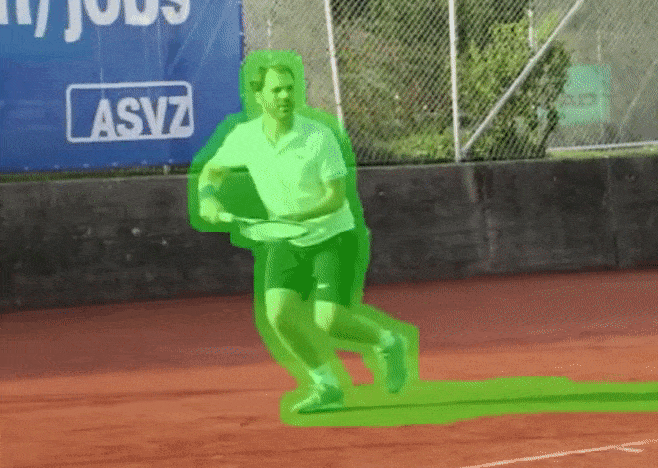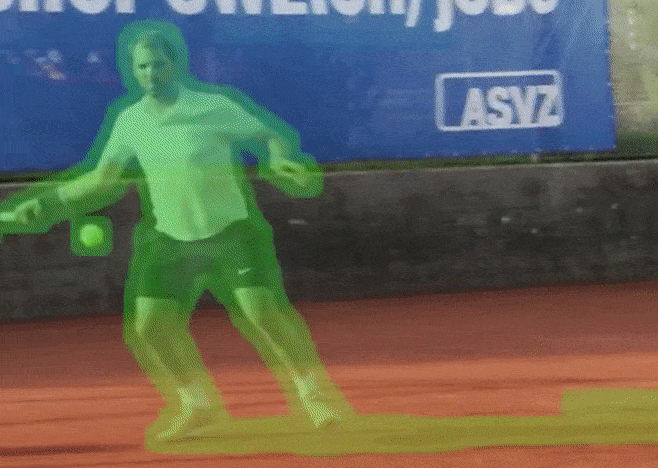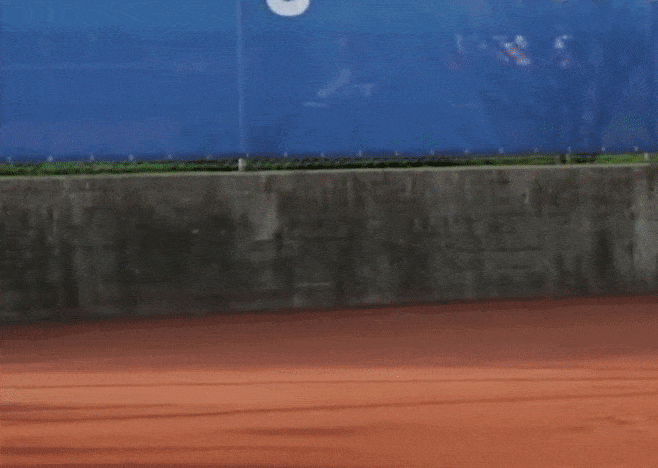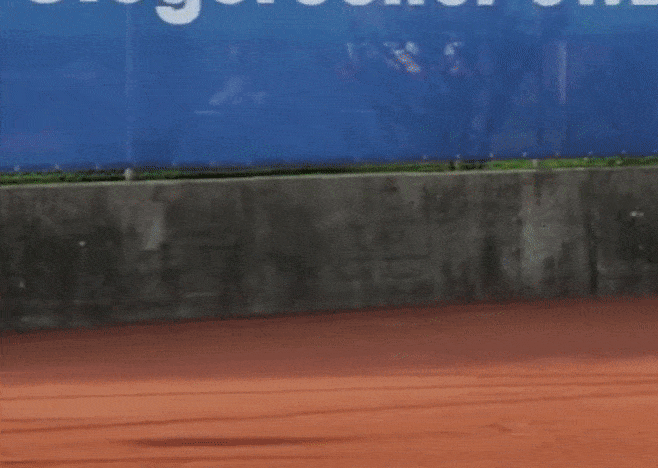
En tennisspelare gör en oväntad sorti.
Testad på standarddataset för denna subsektor av bildsyntesforskning, kunde den nya metoden utklassa rivaler i både kvalitativa och kvantitativa utvärderingsrundor.

Tester mot tidigare tillvägagångssätt. Källa: https://arxiv.org/pdf/2204.02663.pdf
Artikeln heter Towards An End-to-End Framework for Flow-Guided Video Inpainting, och är ett samarbete mellan fyra forskare från Nankai University, tillsammans med en forskare från Hisilicon Technologies.
Vad som saknas i den här bilden
Förutom dess uppenbara tillämpningar för visuella effekter, kommer högkvalitativ videoinpainting att bli en central funktion för nya AI-baserade bildsyntes- och bildförändringstekniker.
Detta är särskilt fallet för kroppsaltererande modeapplikationer, och andra ramverk som söker att ‘göra smalare’ eller på annat sätt ändra scener i bilder och videor. I sådana fall är det nödvändigt att övertygande ‘fylla i’ den extra bakgrunden som exponeras av syntesen.

I en färsk artikel har en algoritm för kroppsformning till uppgift att fylla i den bakgrund som blir synlig när motivets storlek ändras. Här markeras det saknade området av den röda konturen där den verkliga, fylligare personen tidigare befann sig (se bilden till vänster). Baserat på källmaterial från https://arxiv.org/pdf/2203.10496.pdf
Koherent optiskt flöde
Optiskt flöde (OF) har blivit en kärnteknologi i utvecklingen av videoobjektborttagning. Liksom en atlas, tillhandahåller OF en engångskarta över en tidssekvens. OF används ofta för att mäta hastighet i datorseendetillämpningar och kan också möjliggöra tidsmässigt konsekvent inpainting, där hela uppgiften kan behandlas i en enda genomgång, snarare än Disneystilens ‘per-bildruta’-uppmärksamhet, som oundvikligen leder till tidsmässig diskontinuitet.
Videoinpaintingsmetoder hittills har centrerats kring en trestegsprocess: flödeskomplettering, där videon i princip kartläggs till en diskret och utforskbar enhet; pixelpropagering, där hålen i ‘korrupta’ videor fylls i genom bidirektionell propagering av pixlar; och innehållshallucination (pixel ‘uppfinning’ som är bekant för de flesta av oss från deepfakes och text-till-bild-ramverk som DALL-E-serien) där det uppskattade ‘saknade’ innehållet uppfinns och infogas i videon.
Den centrala innovationen i E2FGVI är att kombinera dessa tre steg till ett end-to-end-system, vilket eliminerar behovet av manuella operationer på innehållet eller processen.

Artikeln observerar att behovet av manuell intervention kräver att äldre processer inte utnyttjar en GPU, vilket gör dem ganska tidskrävande. Från artikeln*:
‘Att ta DFVI som exempel, tar det att slutföra en video med storleken 432 × 240 från DAVIS, som innehåller cirka 70 bildrutor, cirka 4 minuter, vilket är oacceptabelt i de flesta verkliga tillämpningar. Utöver dessa nämnda brister, ignorerar endast användning av ett förtränat bildinpaintingsnätverk vid innehållshallucinationssteget de innehållsrelationer som finns mellan tidsmässiga grannar, vilket leder till inkonsekvent genererat innehåll i videor.’
Genom att förena de tre stegen i videoinpainting, kan E2FGVI ersätta det andra steget, pixelpropagering, med spridning av särdrag. I de mer segmenterade processerna i tidigare arbeten är särdrag inte lika lätt tillgängliga, eftersom varje steg är relativt hermetiskt, och arbetsflödet endast semi-automatiserat.
Utöver detta har forskarna utvecklat en temporalfokustransformator för innehållshallucinationssteget, som inte bara beaktar de direkta grannarna till pixlar i den aktuella bildrutan (dvs. vad som händer i den delen av bildrutan i den föregående eller nästa bilden), utan också de avlägsna grannarna som är många bildrutor bort, men som ändå kommer att påverka den sammanhållna effekten av alla operationer som utförs på videon som helhet.

Arkitektur för E2FGVI.
Den nya särdragsbaserade centrala delen av arbetsflödet kan dra nytta av fler processer på särdragsnivå och inlärningsbara samplingsförskjutningar, medan projektets nya fokustransformator, enligt författarna, utökar storleken på fokalfönster ‘från 2D till 3D’.
Tester och data
För att testa E2FGVI, utvärderade forskarna systemet mot två populära videobjektsegmenteringsdataset: YouTube-VOS och DAVIS. YouTube-VOS innehåller 3741 träningsvideoklipp, 474 valideringsklipp och 508 testklipp, medan DAVIS innehåller 60 träningsvideoklipp och 90 testklipp.
E2FGVI tränades på YouTube-VOS och utvärderades på båda dataseten. Under träningsprocessen genererades objektmasker (de gröna områdena i bilderna ovan, och den medföljande YouTube-videon) för att simulera videoinpainting.
Som mått använde forskarna maximalt signal-brusförhållande (PSNR), Strukturell likhet (SSIM), Video-baserad Fréchet Inception Distance (VFID) och Flow Warping Error – den senare för att mäta tidsmässig stabilitet i den påverkade videon.
De tidigare arkitekturerna som systemet testades mot var VINet, DFVI, LGTSM, CAP, FGVC, STTN och FuseFormer.

Från artikelns avsnitt om kvantitativa resultat. Upp- och nedpilar indikerar att högre respektive lägre tal är bättre. E2FGVI uppnår de bästa resultaten över hela linjen. Metoderna utvärderas enligt FuseFormer, men DFVI, VINet och FGVC är inte end-to-end-system, vilket gör det omöjligt att uppskatta deras FLOPs.
Utöver att uppnå de bästa resultaten mot alla konkurrerande system, genomförde forskarna en kvalitativ användarstudie, där videor som transformerats med fem representativa metoder visades individuellt för tjugo volontärer, som ombads att betygsätta dem i termer av visuell kvalitet.

Den vertikala axeln representerar procentandelen deltagare som föredrog E2FGVI-utdata i termer av visuell kvalitet.
Författarna noterar att trots den enhälliga preferensen för deras metod, ett av resultaten, FGVC, inte återspeglar de kvantitativa resultaten, och de föreslår att detta indikerar att E2FGVI kanske på ett missvisande sätt genererar ‘mer visuellt tilltalande resultat’.
I termer av effektivitet noterar författarna att deras system kraftigt minskar flyttalsoperationer per sekund (FLOPs) och inferenstid på en enda Titan-GPU på DAVIS-datasetet, och observerar att resultaten visar att E2FGVI körs x15 snabbare än flödesbaserade metoder.
De kommenterar:
‘[E2FGVI] har lägst FLOPs-tal i jämförelse med alla andra metoder. Detta indikerar att den föreslagna metoden är mycket effektiv för videoinpainting.’
*Min omvandling av författarnas källhänvisningar i löptexten till hyperlänkar.
Publicerad första gången 19 maj 2022.
Ändrad tisdag 28 oktober 2025, för att ta bort felaktig videoinbäddning och ändra hänvisningar till inbäddad video i artikeltexten.


