Grunnleggende AI
Generativ vs. diskriminativ maskinlæringsmodeller

 Legg til Unite.AI blant dine foretrukne kilder på Google
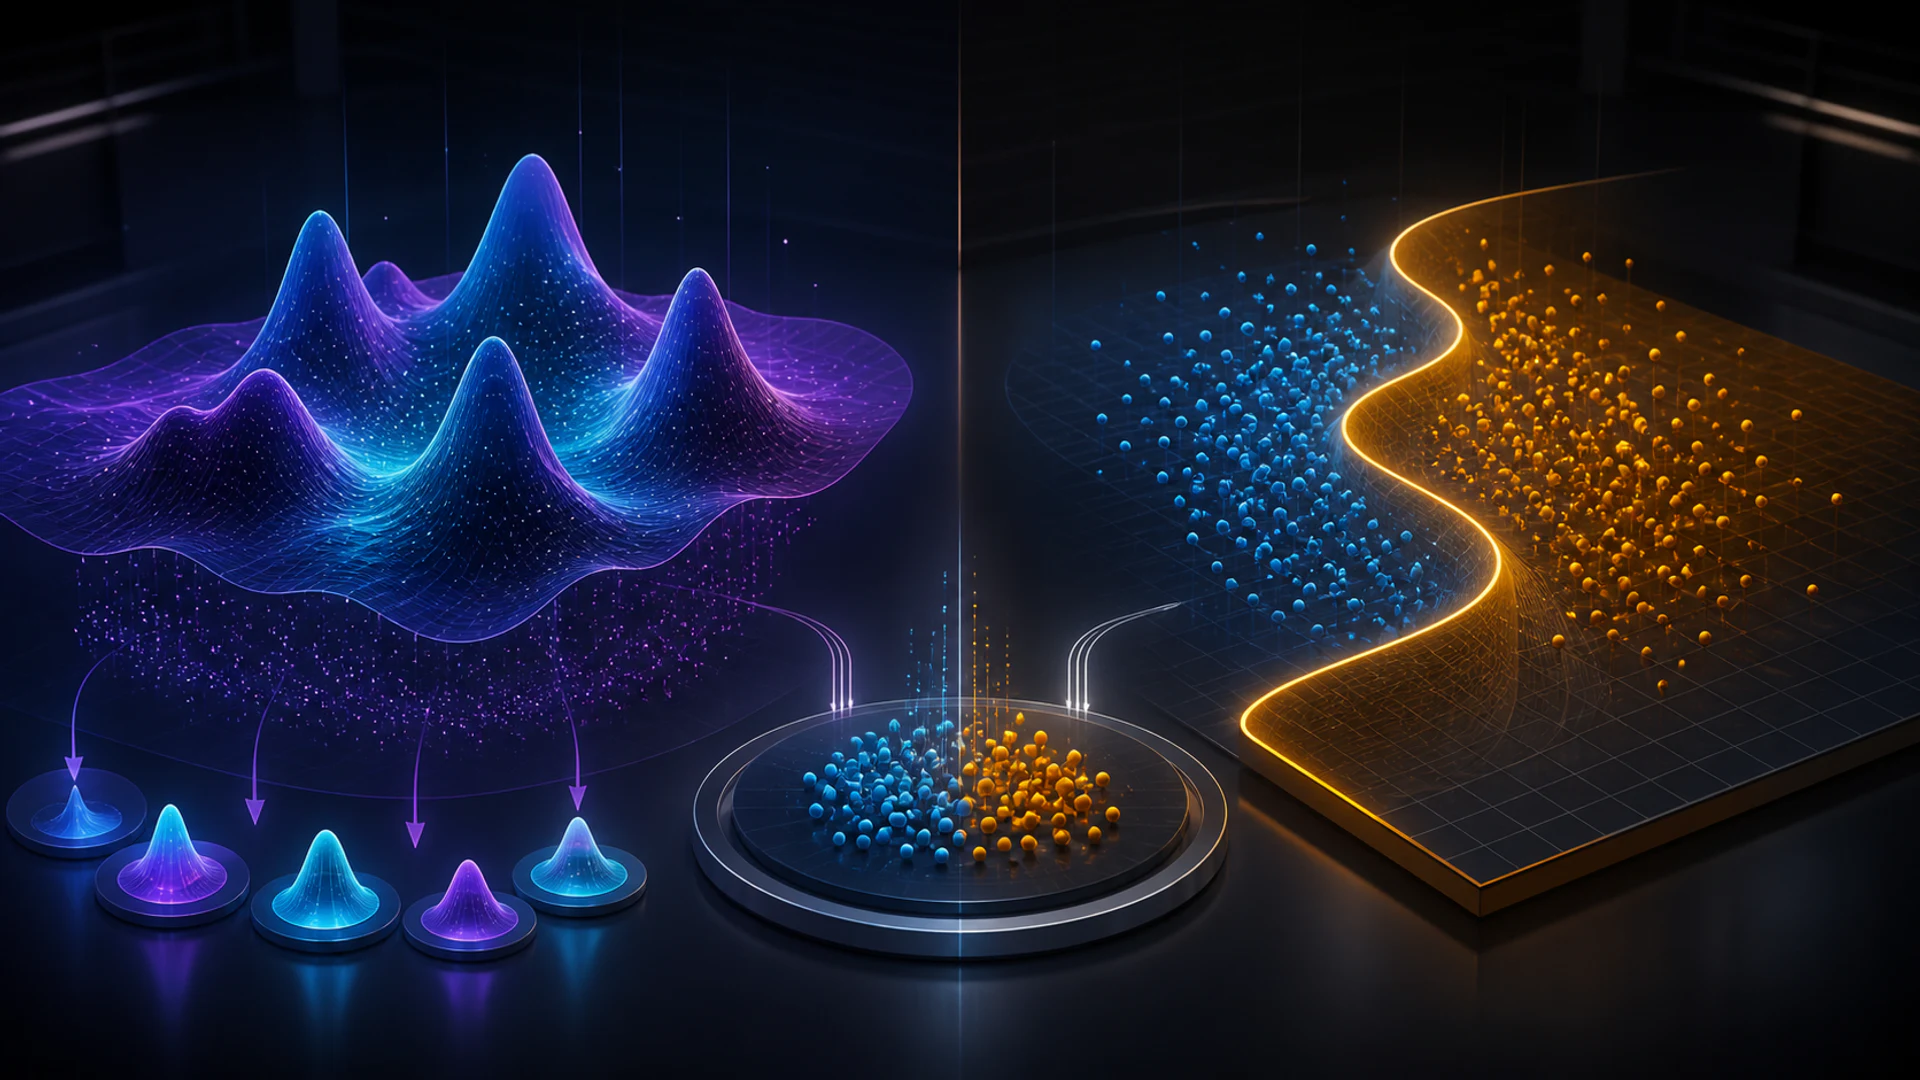
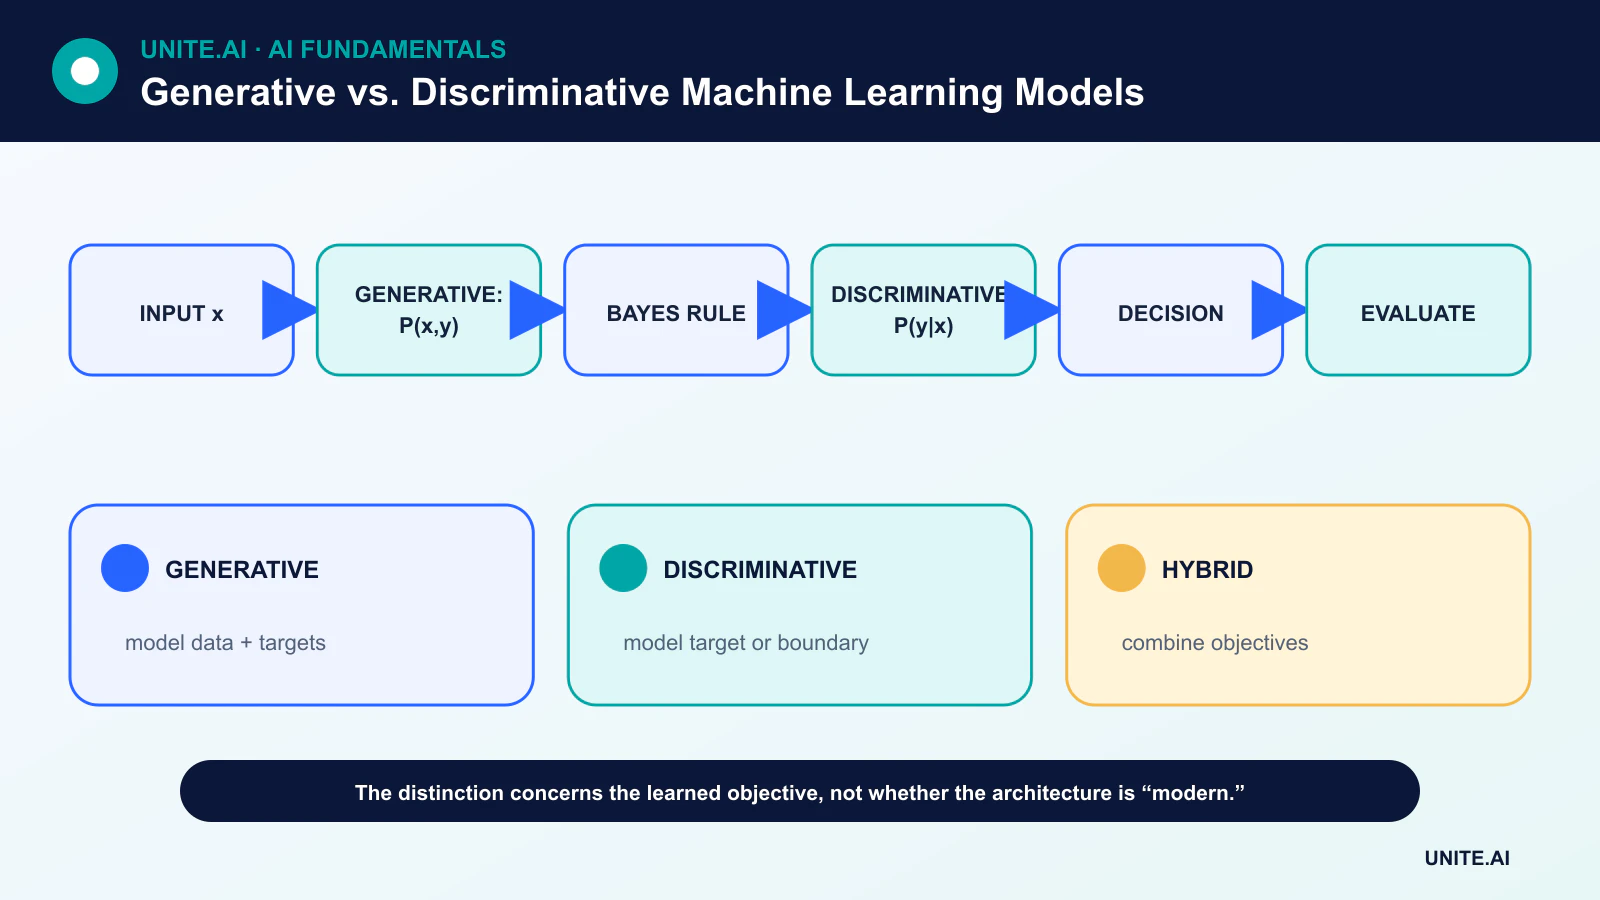
Generativ og diskriminativ beskriver hva en modell lærer om data og målvariabler. I klassisk overvåket klassifisering lærer en generativ modell en felles fordeling som P(x, y) eller en klasse‑betinget fordeling P(x|y), mens en diskriminativ modell lærer P(y|x) eller en direkte beslutningsgrense.
Distinksjonen er nyttig, men moderne systemer kombinerer ofte mål. En modell kan lære generative representasjoner og senere fin‑justeres for diskriminativ prediksjon, eller dele en felles bakgrunn mellom generering og klassifisering.
Viktige punkter
- Generative klassifikatorer modellerer hvordan inn‑ og ut‑data oppstår; diskriminative klassifikatorer modellerer etiketten gitt inn‑data eller en grense.
- Generative antakelser kan hjelpe når merket data er begrenset, men kan også være feilaktige.
- Diskriminative metoder fokuserer ofte kapasiteten på prediksjonsoppgaven og kan oppnå bedre asymptotisk klassifiseringsfeil.
- GAN‑er, VAE‑er og språkmodeller er generative systemer, men «generativ» betyr ikke at hver komponent er en generativ klassifikator.
Sannsynlighetsfaktorisering
En generativ klassifikator kan estimere P(x|y) og P(y), og deretter bruke Bayes’ teorem for å avlede P(y|x). Naïve Bayes er et klassisk eksempel. En diskriminativ klassifikator som logistisk regresjon estimerer P(y|x) direkte; en SVM lærer en separerende grense.
Å modellere P(x,y) er en bredere oppgave enn å forutsi y fra x. Den ekstra strukturen kan støtte sampling eller resonnering med manglende data, men krever også antakelser om inn‑datafordelingen.
Datakraft og asymptotisk oppførsel
Ng og Jordans sammenligning av Naïve Bayes og logistisk regresjon viste en nyttig avveging: under deres antakelser kan den generative modellen nå sin endelige ytelse med færre eksempler, mens den diskriminative modellen kan oppnå en lavere asymptotisk feil.
Dette er ingen universell rangering. Resultatene avhenger av om modellfamilien passer data, dimensjonalitet, regularisering, optimalisering og kvalitet på etiketter. Empirisk sammenligning på et representativt valideringsdesign er fortsatt essensielt.
Representative modellfamilier
Generative modeller inkluderer klasse‑betingede fordelinger, skjulte Markov‑modeller, blandingsmodeller, variationale autoenkodere, autoregressive språkmodeller, diffusjonsmodeller og GAN‑er.
Diskriminative modeller inkluderer logistisk regresjon, beslutningstrær, betingede random‑fields, støtte‑vektormaskiner og nevrale klassifikatorer. Den samme nevrale bakgrunnen kan delta i enten kategori avhengig av treningsmål og output.
Hybride og selv‑superviserte systemer
En forhåndstrent språk‑ eller visuell modell kan lære fra umerkede data med et generativt eller selv‑supervisert mål, og deretter få et diskriminativt hode for en mål‑oppgave. Semi‑superviserte metoder kan optimalisere merket klassifisering og et mål for umerkede data samtidig.
Hybridisering gjør arkitekturlabels mindre informative enn hele trenings‑pipeline. Dokumentasjon bør angi målet, data, output og tiltenkt inferens – ikke kun kalle en modell generativ.
Valg mellom tilnærminger
Bruk oppgaven til å bestemme. Hvis målet er en kalibrert grense med rikelig med merkelapper, er en diskriminativ modell et naturlig utgangspunkt. Hvis sampling, tetthetsestimering, manglende‑data‑struktur eller umerkede data er sentralt, kan en generativ komponent være nyttig.
Sammenlign robusthet, prøve‑effektivitet, beregning, sannsynlighet eller kalibrering etter behov. Et godt generert eksempel beviser ikke en god klassifikator, og en høy‑nøyaktig klassifikator impliserer ikke en realistisk modell av inn‑datafordelingen.
Sannsynlighetsretninger og modelleringsmål
En diskriminativ modell lærer en grense eller betinget fordeling P(y|x): gitt funksjoner x, prediker etikett y. Logistisk regresjon, støtte‑vektormaskiner, betingede random‑fields og mange andre klassifikatorer er diskriminative. En generativ modell lærer en felles fordeling P(x,y), en klasse‑betinget fordeling P(x|y) eller en ubetinget datafordeling, som muliggjør sampling eller sannsynlighets‑baserte oppgaver. Naïve Bayes og lineær diskriminantanalyse er generative klassifikatorer; GAN‑er, variationale autoenkodere, diffusjonsmodeller og autoregressive modeller genererer data gjennom ulike mål.
Distinksjonen gjelder hvilken fordeling eller beslutningsregel som modelleres, ikke om et nevralt nettverk brukes. En generativ språkmodell kan promptes til å klassifisere, mens en diskriminativ re‑rangør kan styre generering. Generative antakelser kan forbedre datakraft eller håndtere manglende variabler, men introduserer risiko for modell‑mis‑spesifikasjon. Diskriminative metoder presterer ofte bedre med rikelig merket data fordi de fokuserer direkte på prediksjonsgrensen. Sammenlign familier under like funksjoner, data, tuning og beregning i stedet for å behandle én kategori som universelt overlegen.
Trening og evaluering etter brukstilfelle
Klassifiserings‑evaluering bruker presisjon, tilbakekalling, kalibrering, robusthet og feilkostnad. Generativ evaluering må ta hensyn til troverdighet, mangfold, dekning, sannsynlighet eller oppgave‑nytte, memorering og sikkerhet. En modell kan produsere attraktive prøver samtidig som den mister moduser, eller oppnå god sannsynlighet med dårlig perseptuell kvalitet. Nytten av syntetisk data bør testes ved å trene og evaluere nedstrøms modeller på uavhengig ekte data, inkludert sjeldne grupper. Hold testdata utenfor generasjons‑prompt og -utvelgelse.
I semi‑supervisert læring kan en generativ modell utnytte umerket struktur; i anomalideteksjon kan sannsynlighet svikte når data utenfor fordelingen får høy tetthet av irrelevante grunner. I gjenfinning‑forsterket generering danner en generativ svar‑modell og en diskriminativ gjenfinder eller om‑rangør et hybrid. Diagnostiser trinnene separat slik at flytende output ikke skjuler gjenfinning‑feil. Velg den dekomponeringen som gjør bevis og kontroll observerbar.
Distribusjon og styring
Generative systemer tilfører innhold‑proveniens, immaterielle‑rett‑, etterlignings‑, prompt‑injeksjons‑ og output‑moderering‑risiko; diskriminative systemer tilfører terskel‑, avslag‑ og ulik‑feil‑risiko. Begge krever data‑rettigheter, sikre artefakter, versjonering, representative tester, overvåkning og menneskelig myndighet proporsjonal med konsekvensene. Spor det eksakte målet og output‑semantikken i dokumentasjonen. Generativ vs. diskriminativ er en nyttig statistisk distinksjon, men virkelige systemer kombinerer dem ofte, og pålitelighet avhenger av hele data‑ og beslutnings‑pipeline.
Arbeidseksempel: klassifisere og generere support‑svar
En support‑plattform bruker en diskriminativ klassifikator til å identifisere sakstype og hastighet, og en generativ modell til å utforme et svar fra godkjente retningslinjer. Klassifikatoren evalueres med klassetilpasset tilbakekalling og kalibrering; gjenfinneren med bevis‑tilbakekalling; generatoren med forankring, korrekthet og avslag. Hvert trinn har en usikker utførelse, og den generative modellen kan ikke endre klassifisering eller kundens berettigelse via overbevisende tekst.
Agenter ser den predikerte ruten, kildene og utkastet, og godkjenner eller korrigerer før sending. Tillatelses‑filtre anvendes før gjenfinning, og prompt‑injeksjon i kundetekst kan ikke autorisere verktøy. Overvåkning adskiller rutings‑feil, gjenfinning‑hull, ugyldige påstander og agent‑redigeringer. En policy‑endring oppdaterer kilder umiddelbart og trigger regresjonstester; tuning holdes for stabil atferd. Det hybride designet utnytter både diskriminative og generative styrker samtidig som det bevarer bevis og menneskelig myndighet.
Implementasjonsbevis og operasjonell beredskap
En produksjonsbeslutning krever mer enn en vellykket demonstrasjon. Definer tiltenkte brukere, driftsmiljø, inn‑ og ut‑data, avhengigheter, eier og konsekvens av hver viktig feil. Etabler en reproduserbar basislinje og et versjonert evalueringssett før tuning. Test vanlige tilfeller, grensetilstander, feil‑ eller manglende inn‑data, distribusjons‑skifte, avhengighets‑nedbrudd, misbruk og de grupper eller miljøer som sannsynligvis blir under‑tjent. Mål oppgave‑kvalitet sammen med kalibrering eller usikkerhet, latens, gjennomstrømning, ressurskostnad, tilgjengelighet, personvern og sikkerhet. Registrer hver transformasjon og terskel slik at en uavhengig revisor kan gjenskape resultatet og skille bevis fra en attraktiv prototype.
Før lansering, tildel myndighet for utgivelse, unntak, endringer, tilbake‑rulling og avvikling. Bruk en trinnvis utrulling, bevar en sikker fallback, og verifiser overvåkning med bevisst injiserte feil. Operasjonell telemetri bør avdekke inn‑datakvalitet, output‑atferd, modell‑ eller regel‑versjon, avhengighets‑helse, menneskelige overstyringer og bekreftede resultater uten å samle unødvendige sensitive data. Definer varslings‑terskler og en respons‑eier, og gjennomgå virkelige bevis etter distribusjon i stedet for å anta at offline‑ytelse vil vedvare. Revurder når datakilder, brukere, modeller, leverandører, policyer, maskinvare eller mål endres. Et vedlikeholdt system trenger også dokumentert gjenoppretting, hendelses‑læring, sletting‑ og oppbevaringsprosedyrer, samt et klart punkt hvor det skal deaktiveres eller erstattes.
Ofte stilte spørsmål
Er en GAN‑s diskriminator en diskriminativ modell?
Den utfører diskriminering under trening, men hele GAN‑en er et generativt rammeverk der output produseres av generatoren.
Er diskriminativ læring alltid overvåket?
Nei. Begrepet beskriver det modellerte forholdet eller grensen, mens «overvåking» beskriver treningssignalet. Moderne mål kan gjøre grensene uklare.
Primære referanser