
AI-modellen en platforms
SandboxAQ voegt tools voor vertrouwen en rendement op investering toe aan AI-agentplatform van Switch

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
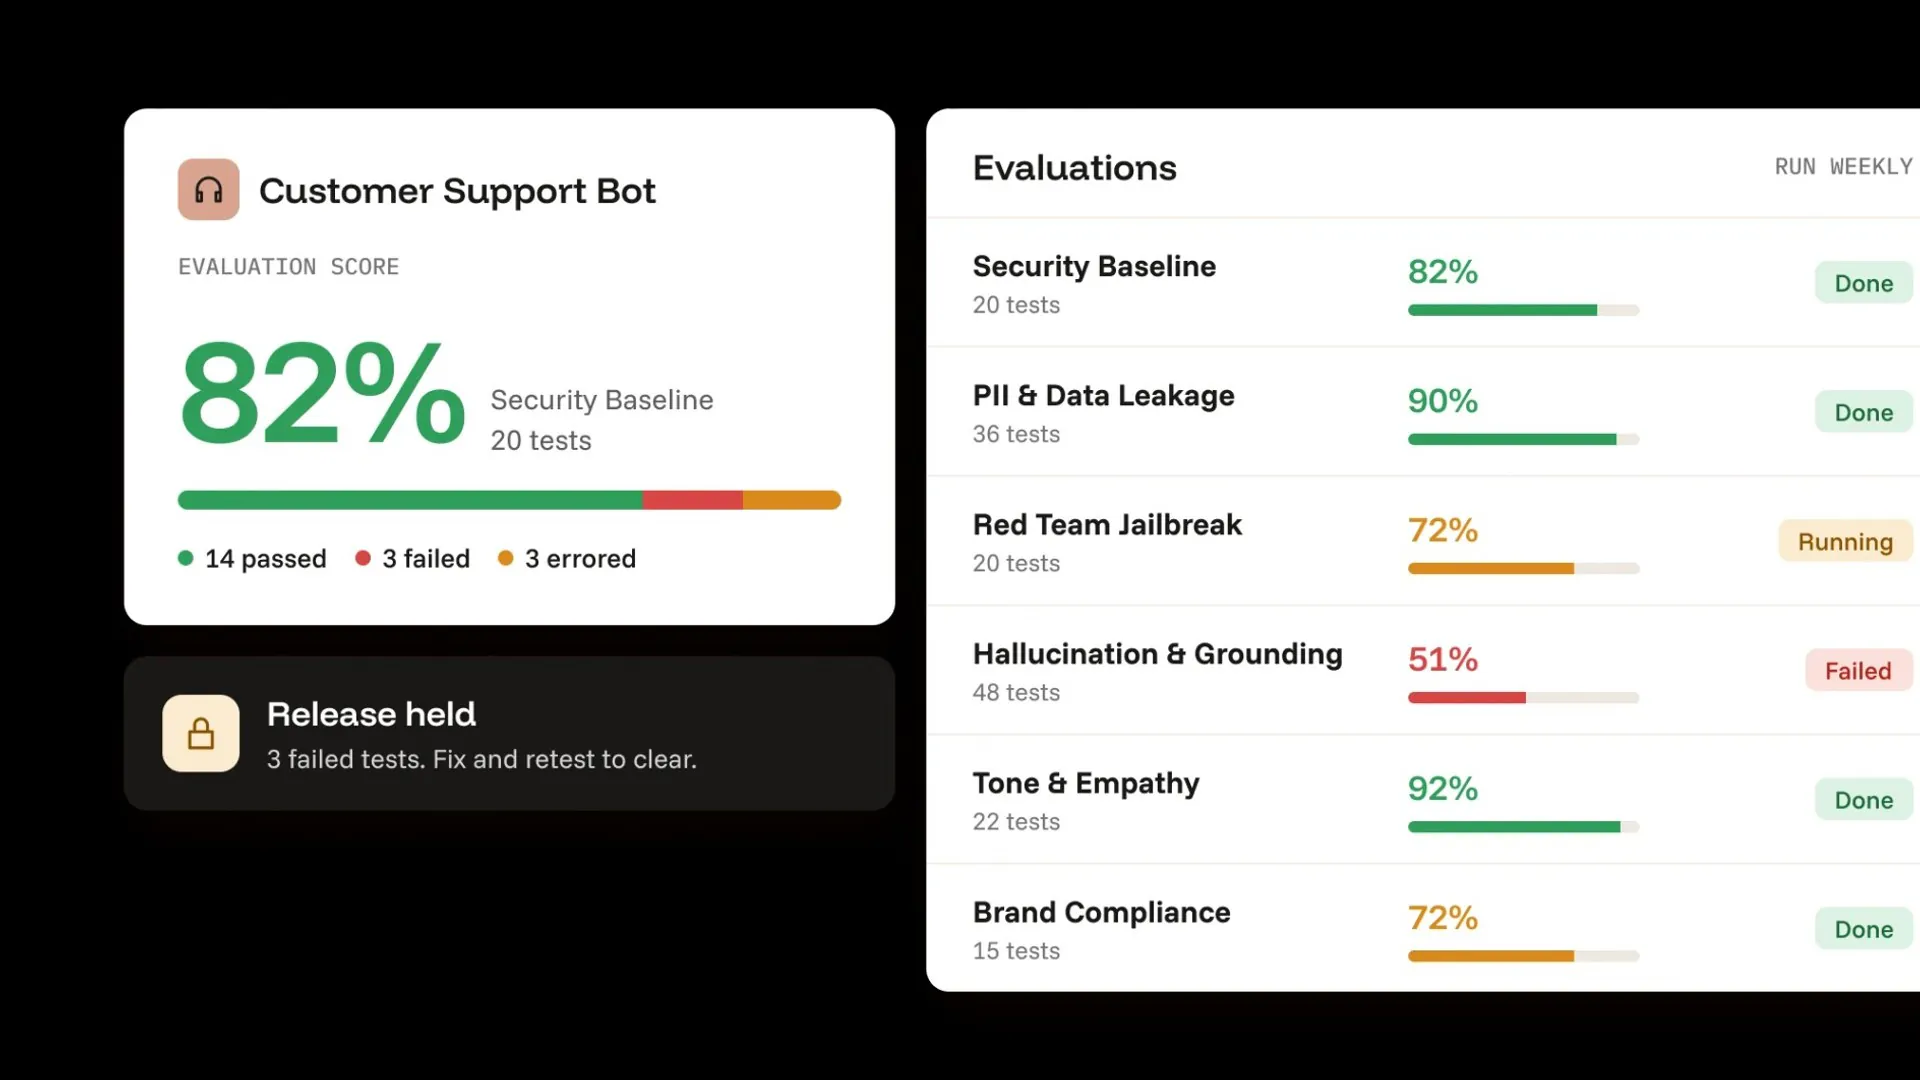
SandboxAQ kondigde op 19 oktober 2026 een uitbreiding aan van zijn Switch AI-platform voor ondernemingen die AI-agenten inzetten. Het introduceerde Switch Trust, voor het opsporen, testen en beveiligen van agenten, en Switch ROI, dat de kosten en waarde van elke agent bijhoudt.
Het bedrijf, gevestigd in Palo Alto, Californië, zei dat de twee producten voortbouwen op het opensource-aanbod Switch Rooms en organisaties een leveranciersneutrale manier bieden om risico’s van agenten te beoordelen, bedrijfswaarde te meten en de prestaties af te stemmen op de agenten, modellen en aanbieders die ze gebruiken. In de aankondiging worden agenten tegenover de eerste generatie bedrijfs-AI geplaatst, die volgens het bedrijf voornamelijk werd beoordeeld op basis van het aantal gebruikerslicenties, het gebruik en het tokenverbruik. Omdat agenten beslissingen kunnen nemen, acties kunnen uitvoeren en met mensen kunnen samenwerken, brengen ze volgens de aankondiging nieuwe verwachtingen met zich mee op het gebied van toezicht en verantwoording.
Switch Rooms brengt medewerkers en AI-agenten samen in Slack, Microsoft Teams, Discord en andere werkplektools. Zo kunnen teams werken met de agenten van hun keuze en tegelijk eigenaar blijven van de gedeelde context, geschiedenis en kennis. SandboxAQ lanceerde Switch in augustus 2026 als een opensource-aanbod onder de Commons Clause bij Apache 2.0, vanuit het uitgangspunt dat bedrijven AI-agenten, modellen en aanbieders moeten kunnen kiezen en vervangen zonder de controle over hun context uit handen te geven.
Switch Trust: agenten opsporen, testen en beveiligen
Volgens de aankondiging biedt Switch Trust beveiliging en governance voor agenten in vier stappen: Discover, Scan, Evaluate en Monitor. Op de productpagina van Switch Trust staat dat het product werkt met elke agent, ongeacht wie die heeft gebouwd.
De stap Discover brengt de agenten, modellen, tools, MCP-servers en afhankelijkheden in kaart die actief zijn in gekoppelde omgevingen en coderepositories, waaronder agenten waarvan beveiligingsteams mogelijk niet weten dat ze bestaan. Van elk onderdeel worden het eigenaarschap, de herkomst, afhankelijkheden, bevindingen en ernst vastgelegd, zodat teams een actueel beeld krijgen van hun agentenbestand.
De stap Scan controleert agenten in code en cloudomgevingen op beveiligingslekken. Daarbij wordt statische analyse gecombineerd met AI-ondersteunde triage om fout-positieve meldingen eruit te filteren. De stap kent ernstscores toe, koppelt ondersteunde bevindingen aan OWASP-categorieën voor agentbeveiliging en beveelt oplossingen aan.
De stap Evaluate maakt rechtstreeks verbinding met een agent en voert aanvallende en functionele tests uit, onder meer op promptinjectie, jailbreak-aanvallen, datalekken en het opvolgen van instructies. Elke aanval krijgt de uitslag geslaagd of mislukt, die meetelt voor een algemene gezondheidsscore. Teams kunnen naast de ingebouwde tests ook hun eigen evaluaties toevoegen. Op de productpagina staat dat een agent niet kan worden uitgebracht zolang een test niet is geslaagd.
De stap Monitor beschermt agenten in productie. Teams nemen een agent in gebruik via een software development kit die de activiteiten ervan vastlegt, waaronder prompts, antwoorden, modelaanroepen, latentie, sessies en beleidsgebeurtenissen. Agenten die in Switch Rooms draaien, krijgen automatisch beschermingsbeleid. Tijdens live-interacties controleren de beleidsregels op promptinjectie, geheimen, persoonlijk identificeerbare informatie, toxische inhoud en jailbreak-aanvallen. Trust kan onveilig gedrag blokkeren, gevoelige informatie onleesbaar maken, er meldingen over versturen of het loggen, en tegelijk bewijsmateriaal van wat er is gebeurd bewaren. Op de productpagina staat dat de beschermingsmaatregelen controleren wat een agent binnenkomt en verlaat, en dat Switch Trust één overzicht bijhoudt van wat elke agent heeft gedaan en wie daarvoor toestemming heeft gegeven.
Switch ROI: kosten en waarde per agent meten
Volgens de aankondiging meet Switch ROI de kosten en de geleverde waarde van elke agent, aangevuld met specifieke aanbevelingen om de kosten te verlagen en de prestaties te verbeteren. Op de productpagina van Switch ROI staat dat het op één plek alle agenten van elke aanbieder omvat en AI-uitgaven bundelt die verspreid zijn over gebruikerslicenties, verbruiksfacturen en aanbieders.
De functie Measure volgt uitgaven en prestaties tot op het niveau van de afzonderlijke agent, sessie en beurt. Budgetten, verbruikstempo’s en waarschuwingen moeten helpen om overschrijdingen vroegtijdig aan het licht te brengen. In plaats van infrastructuurmetingen zoals tokens of API-aanroepen te tellen, koppelt de functie de uitgaven aan resultaten, zoals opgeloste tickets, versnelde pull-aanvragen en geautomatiseerde taken.
De functie Prove weegt de waarde die elke agent oplevert af tegen de kosten: Switch stelt een menselijke nulmeting vast, houdt de uitgaven van agenten automatisch bij en meet kengetallen zoals de kosten per resultaat en het netto rendement op investering.
De functie Optimize spoort weglekkende uitgaven op en bepaalt wat moet worden aangepast, omgeleid of teruggeschroefd. De aanbevelingen voor elke agent worden gerangschikt en bevatten een geschatte maandelijkse besparing, uitgedrukt als een bandbreedte, en een betrouwbaarheidsniveau. In de aankondiging worden de problemen genoemd waarop deze aanbevelingen betrekking hebben: een onjuiste modelkeuze, aangeboden maar ongebruikte tools, context die opnieuw wordt verstuurd in plaats van gecachet, herhalingen en lussen die werk dubbel uitvoeren, en uitvoer die langer is dan voor de taak nodig is. Op de productpagina staat dat de aanbevelingen betrekking hebben op vier soorten kostenbesparingen: modelkeuze, ongebruikte tools, antwoordlengte en caching. Volgens de aankondiging komen prestatieverbeteringen eraan. Ook beschrijft die hoe het werk van een agent kan worden verplaatst naar een goedkoper model wanneer de kwaliteitscontroles slagen, terwijl de agent de context van de ruimte behoudt.
Uitspraken van Mount Sinai West en leidinggevenden
Volgens de aankondiging gebruikt het MSW Lab van Mount Sinai West Switch Trust om G Board te bouwen, een raamwerk waarmee artsen klinische toepassingen met AI-agenten kunnen maken. „In het MSW Lab bouwen artsen met AI-agenten echte zorgsoftware, dus moeten we aantonen dat die agenten veilig werken”, zei dr. Jeffrey Bander, hoofd Cardiologie bij Mount Sinai West en universitair hoofddocent Cardiologie en Kunstmatige Intelligentie aan de Icahn School of Medicine at Mount Sinai, in de aankondiging van SandboxAQ. Bander zei dat Switch AI het lab een manier biedt om dat vertrouwen in het dagelijkse werk te verankeren, zodat artsen zich kunnen richten op klinische problemen in plaats van AI-beveiligingsspecialisten te worden.
In de aankondiging wordt verwezen naar een voorspelling van Gartner dat tegen eind 2027 meer dan 40 procent van de projecten met agentische AI zal worden stopgezet. Op de productpagina van Switch ROI wordt afzonderlijk verwezen naar gegevens uit de KPMG Global AI Pulse-enquête van 24 juni 2026, gebaseerd op 2.145 respondenten. Daaruit blijkt dat 7 procent van de leidinggevenden een gevestigde opbrengst uit AI rapporteert en dat leidinggevenden met duidelijk inzicht in AI-kosten vijf keer zo vaak aangeven dat ze zo’n opbrengst behalen.
Mohammed Aboul-Magd, algemeen directeur van Switch AI bij SandboxAQ, zei dat het bedrijf bij veel gebruikers heeft gezien dat AI-uitgaven die bedoeld waren om een nieuwe aanstelling te voorkomen, al snel hoger uitvielen dan de kosten van het aannemen van een voltijdmedewerker. AI invoeren levert op zichzelf geen rendement op, zei hij: teams moeten weten wat elke agent kost, wat die oplevert en hoe ze de prestaties ervan kunnen verbeteren. Dat is volgens hem het probleem waarvoor Switch ROI is ontwikkeld.
Jack Hidary, CEO van SandboxAQ, zei dat bedrijven honderden, en mogelijk duizenden, AI-agenten naast hun medewerkers zullen inzetten. Bedrijven zouden niet duizend mensen aannemen zonder hun kwalificaties, kosten of resultaten te kennen, zei hij, en voor agenten moet dezelfde discipline gelden. Naarmate de technologie zich verder ontwikkelt, moeten bedrijven volgens hem ook kunnen overstappen op betere agenten en modellen zonder de kennis te verliezen die ze hebben opgebouwd.



