
Interviews
Ron Reiter, CTO en mede-oprichter van Sentra – Interviewreeks

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
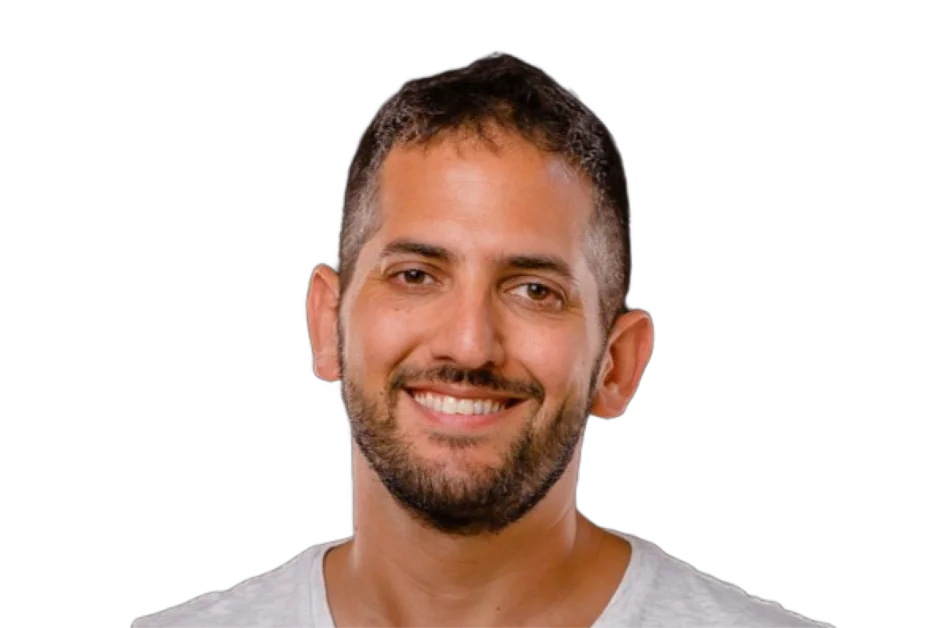
Ron Reiter, CTO en mede-oprichter van Sentra, is een ervaren ondernemer en cybersecurity-expert met diepgaande kennis van de cloud, die innovatieve technologieoplossingen heeft gebouwd gedurende zijn meer dan twee decennia in softwareontwikkeling; hij was mede-oprichter en leidt de technologie bij Sentra, een datacybersecuritybedrijf dat zich richt op het helpen van ondernemingen om hun clouddata te beveiligen, en eerder was hij mede-oprichter van Crosswise (overgenomen door Oracle (ORCL ) voor $50 miljoen), terwijl hij ook meer dan zes jaar als engineeringdirecteur bij Oracle/Crosswise werkte, waar hij toezicht hield op Oracle Data Cloud-producten en -teams.
Sentra is een cloud-native databeveiligingsplatform dat AI-gedreven ontdekking, classificatie en contextuele analyse gebruikt om organisaties volledige zichtbaarheid en controle te geven over gevoelige data in cloud-, hybride en on-premisesomgevingen, waardoor ze risico’s kunnen beoordelen, governance kunnen afdwingen, naleving kunnen garanderen en gegevensblootstelling kunnen voorkomen op grote schaal in moderne multi-cloud- en AI-workflows.
U heeft meerdere bedrijven opgericht in de cybersecurity- en data-infrastructuur. Wat inspireerde u om Sentra te creëren, en hoe heeft uw ervaring bij Crosswise en Oracle de vroege richting van het bedrijf beïnvloed?
Wat me ertoe bracht Sentra op te richten, was een patroon dat ik steeds weer zag herhalen. Bij Crosswise en later bij Oracle stond data altijd centraal. Het was waar de waarde zat, maar ook waar het risico zich ophoopte. Toch behandelden de meeste beveiligingstools data als iets statisch, iets dat je eenmaal ontdekte en vervolgens als onder controle beschouwde.
Naarmate de cloudadoptie versnelde en ondernemingen begonnen te experimenteren met AI, hield die veronderstelling op te gelden. Data bewoog constant, werd gekopieerd, getransformeerd en toegankelijk gemaakt voor systemen die niemand volledig bijhield. Ik wilde een bedrijf opbouwen dat vanaf het begin met data als een levend actief begon, iets dat je continu begrijpt en bestuurt, in plaats van iets dat je eenmaal inventariseert en vervolgens vergeet. Die gedachte vormde Sentra vanaf de eerste dag.
Sentra richt zich op het geven van ondernemingen volledige controle en zichtbaarheid over hun clouddata. Wat was het kernprobleem dat u het meest vastbesloten was om op te lossen toen u het platform begon te ontwerpen?
Het kernprobleem was vals vertrouwen. Veel ondernemingen geloofden dat ze hun datapostuur begrepen, maar dat vertrouwen was gebaseerd op gedeeltelijke zichtbaarheid. Ze wisten waar sommige gevoelige data stond, maar niet allemaal, en ze hadden zelden een duidelijk beeld van hoe die data werd toegankelijk gemaakt of hergebruikt in de loop van de tijd.
We wilden die kloof dichten. Niet alleen door data te ontdekken, maar door een voortdurend begrip te hebben van welke data bestaat, hoe gevoelig het is en wie of wat toegang heeft. Zonder die basis wordt alles in de beveiliging reactief.
U heeft gesproken over het belang van nauwkeurigheid in de moderne dataveiligheid. Wat maakt het bereiken van hoge nauwkeurigheid op grote cloudduur zo moeilijk, en hoe heeft uw team dat probleem anders aangepakt?
Nauwkeurigheid wordt moeilijk op grote schaal omdat context belangrijk is. Naarmate omgevingen groeien, wordt data meer ongestructureerd en specifiek voor hoe een bedrijf daadwerkelijk werkt. Eenvoudig patroonherkenning en algemene modellen werken redelijk goed in kleinere omgevingen, maar ze breken af als gegevensvolumes groeien en use cases complexer worden.
We zagen dit met eigen ogen in enterprise-evaluaties waarbij de nauwkeurigheid afnam als klanten overstapten van tientallen terabytes naar petabytes ongestructureerde data. Onze aanpak was om classificatie rond context te ontwerpen en discipline te betrachten in efficiëntie. Nauwkeurigheid die alleen werkt op kleine schaal of excessieve compute vereist, is niet nuttig in echte enterprise-omgevingen.
Het scannen en beveiligen van data in gedistribueerde cloudduur is berucht moeilijk. Welke architectonische beslissingen stellen Sentra in staat om efficiënt te werken over meerdere clouds en data-opslag?
We gingen ervan uit dat klanten zouden opereren over meerdere clouds, SaaS-platforms en hybride omgevingen. Dat dwong ons om ontwerpen te vermijden die afhankelijk zijn van zware dataverplaatsing of constante volledige herscans, die niet goed presteren als omgevingen groeien.
In plaats daarvan richtten we ons op het behouden van zichtbaarheid als omgevingen veranderen en onnodige overhead te minimaliseren. Die ontwerpkeuze resulteert in betrouwbaarheid en kostenvoorspelbaarheid, vooral in grote, complexe omgevingen.
Naarmate AI-agents, copilots en geautomatiseerde workflows ingebed worden in enterprise-systemen, welke nieuwe categorieën van dataveiligheidsrisico’s denkt u dat ondernemingen nog onderschatten?
Het grootste blinde vlek is niet-menselijke toegang. AI-agents, integraties en geautomatiseerde workflows hebben nu voortdurend toegang tot gevoelige data, vaak buiten de controles die zijn ontworpen voor menselijke gebruikers.
Deze systemen melden zich niet op dezelfde manier aan als mensen, en ze activeren geen traditionele waarschuwingen. Het behandelen van hen als nog een gebruiker is een fout. Ondernemingen moeten begrijpen wat deze systemen kunnen toegankelijk maken en ervoor zorgen dat die machtigingen in overeenstemming blijven met de bedoeling, anders zal het risico sneller toenemen dan teams kunnen reageren.
Sentra gebruikt een modelgedreven aanpak om gevoelige data te classificeren en te beveiligen. Hoe bereikt u een balans tussen modelprestaties, operationele kosten en schaalbaarheid bij de bouw voor enterprise-werklasten?
Balans komt voort uit het doelbewust zijn over hoe modellen worden gebruikt. Niet elk probleem vereist het grootste of meest algemene model. We richten ons op het gebruik van kleine taalmodellen (SLM’s) die goed geschikt zijn voor classificatie taken en efficiënt kunnen werken in grote omgevingen.
Dit stelt ons in staat om sterke nauwkeurigheid te behouden terwijl we de operationele kosten laag en voorspelbaar houden. Voor enterprise-beveiligingsteams zijn consistentie en betrouwbaarheid even belangrijk als brute prestaties.
Wat is de grootste misvatting die u ziet onder CISO’s over het beveiligen van clouddata in de AI-tijdperk, en hoe moeten hun strategieën evolueren?
Een veelvoorkomende misvatting is dat het eenmaal ontdekken van data voldoende is. In werkelijkheid veranderen cloud- en AI-omgevingen constant. Data beweegt, machtigingen verschuiven en nieuwe systemen komen elke week online.
Strategieën moeten verschuiven van periodieke beoordeling naar continue governance. Dat betekent dat dataveiligheid moet worden behandeld als een voortdurende discipline in plaats van een project. Het doel is niet alleen om risico’s te vinden, maar om te voorkomen dat risico’s opnieuw verschijnen naarmate de omgeving evolueert.
Data Security Posture Management (DSPM) is een centrale laag van de moderne cloud-beveiligingsstack geworden. Wat zijn volgens u de kenmerken van een echt volwassen DSPM-platform?
Een volwassen DSPM-platform doet drie dingen goed. Het moet data nauwkeurig begrijpen, het moet betrouwbaar werken op grote schaal en het moet actie ondersteunen in plaats van alleen rapporteren.
Wat we nu zien, is dat veel platforms sterk lijken in POV’s of vroege implementaties, maar worstelen als omgevingen groeien en toegangspatronen dynamischer worden. Scans vertragen, kosten stijgen en nauwkeurigheid erodeert, vooral met ongestructureerde data. Een volwassen DSPM-platform is een dat beveiligingsteams nog vertrouwen als gegevensvolumes de productieschaal bereiken en AI-systemen voortdurend toegang hebben tot data. Vertrouwen op schaal is wat bruikbare platforms van theoretische onderscheidt.
U heeft ook in verschillende cybersecurity-startups geïnvesteerd. Vanuit dat perspectief, wat onderscheidt volgens u de oprichters die slagen in deze industrie van diegenen die worstelen?
De oprichters die slagen, zijn meestal zeer dicht bij echte klantpijn. Ze weerstaan de verleiding om buzzwords na te jagen of overbodige randgevallen op te bouwen en richten zich in plaats daarvan op het oplossen van problemen die herhaaldelijk in productieomgevingen verschijnen.
Ze denken ook aan duurzaamheid vanaf het begin. In beveiliging is het winnen van een proof of concept gemakkelijk. Betrouwbaar werken op schaal voor jaren is veel moeilijker. Oprichters die vanaf het begin ontwerpen voor die realiteit, hebben de neiging om langer te overleven.
In 2026 en daarna, hoe verwacht u dat dataveiligheidsvereisten zullen verschuiven als ondernemingen gedecentraliseerde architectuur, autonome AI-systemen en steeds complexere datastromen adopteren?
Dataveiligheid zal verschuiven van het beschermen van locaties naar het besturen van beweging. Naarmate architectuur gedecentraliseerd wordt en AI-systemen autonoom handelen, zal de vraag niet langer zijn waar data staat, maar hoe het stroomt en wie of wat het kan gebruiken.
Ondernemingen zullen voortdurende zichtbaarheid en beleidsuitvoering nodig hebben die met de data zelf meereist. Diegenen die dat niet kunnen bereiken, zullen hun AI-initiatieven vertragen door risico’s en nalevingszorgen. Diegenen die dat wel kunnen, zullen sneller gaan, met vertrouwen.
Bedankt voor het geweldige interview, lezers die meer willen leren, moeten Sentra bezoeken.


