
Interviews
Nikunj Bajaj, medeoprichter en CEO van TrueFoundry – Interviewreeks

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
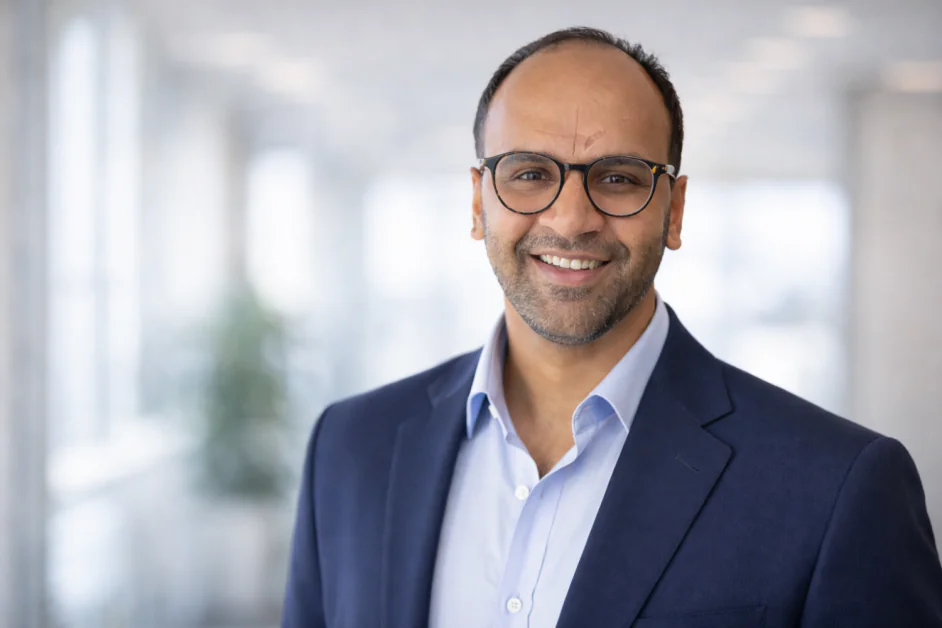
Voordat u TrueFoundry oprichtte, werkte u aan machinelearningonderzoek, AI in productie bij Facebook (META ) en grootschalige aanbevelingssystemen. Welke ervaringen brachten u het meest direct op het idee een bedrijf voor zakelijke AI-infrastructuur te bouwen, en welk probleem werd volgens u destijds niet aangepakt?
Bij Meta zagen we machinelearning als een bijzonder geval van software en generatieve AI als een bijzonder geval van machinelearning. Dat leidde tot een verticale stack met software onderaan, machinelearning in het midden en generatieve AI bovenaan. In die opzet volgen de modellen die ik als machinelearningontwikkelaar bouw hetzelfde uitrolpatroon als de overige software. Daardoor is het heel eenvoudig om systemen op te schalen.
De meeste bedrijven gebruikten echter parallelle stacks: afzonderlijke stacks voor software, machinelearning en generatieve AI. Zodra die stacks parallel naast elkaar staan, wordt opschalen ingewikkelder door de benodigde overdrachten tussen machinelearning en de softwarewereld.
Ons team heeft altijd op het snijvlak gewerkt van het bouwen van machinelearningmodellen en machinelearninginfrastructuur. Daardoor hadden we een eigen perspectief: we konden vergelijkbare verticale stacks naar bedrijven brengen en ze aanpassen aan hun specifieke eisen. Eind 2021 hadden we ook de hypothese dat machinelearning een kantelpunt naderde. Zodra dat kwam, zouden meer bedrijven een verticaal geïntegreerde stack nodig hebben om deze systemen doeltreffend uit te rollen en op te schalen. Dat bracht ons uiteindelijk tot de oprichting van TrueFoundry, en onze hypothese bleek te kloppen. De invoering van AI versnelde na de lancering van ChatGPT eind 2022.
Wat is er veranderd in de manier waarop organisaties over betrouwbaarheid en storingen moeten denken nu AI-systemen van experimenten naar de dagelijkse bedrijfsvoering gaan?
Bij generatieve AI staat aanzienlijk meer op het spel dan bij traditionele machinelearningsystemen. Wanneer deze systemen in productie gaan, krijgen organisaties te maken met veel meer ambiguïteit en niet-determinisme, omdat grote taalmodellen van nature stochastisch zijn. Agentsystemen die daarop worden gebouwd, voegen nog meer ambiguïteit toe.
Bovendien zijn storingen niet langer binair. Systemen werken niet simpelweg wel of niet: veel problemen verschijnen als gedeeltelijke uitval of ongemerkte achteruitgang. Na verloop van tijd kunnen systemen trager reageren, minder goede resultaten geven of onjuist gedrag vertonen. Zulke verslechteringen zijn vaak moeilijker op te merken en soms zelfs schadelijker dan volledige uitval.
Organisaties moeten betrouwbaarheid niet alleen beoordelen op beschikbaarheid, maar ook op verslechtering van de prestaties over tijd.
TrueFailover werd gelanceerd tijdens een golf van opvallende verstoringen van cloud- en AI-diensten. Welke recente gebeurtenissen maakten duidelijk dat betrouwbaarheid van AI was verschoven van een prettige extra naar een kerneis aan de architectuur?
Een van onze klanten in de zorg verwerkt in realtime tijdkritieke patiëntverzoeken rond recepten en werd getroffen door een storing die door een modelfout werd veroorzaakt. De workflows van deze klant genereren duizenden dollars omzet per seconde, en de storing onderbrak enkele van die kritieke workflows. De klant gebruikte TrueFailover al in een vroeg stadium. Daardoor konden we helpen met snel herstel en bleef de impact beperkt.
Zulke incidenten roepen een belangrijke vraag op: nu er bij generatieve AI-systemen steeds meer op het spel staat, waarom zijn herstelprocessen nog grotendeels handmatig? Het incident versterkte het idee dat systemen moeten worden gebouwd vanuit de aanname dat storingen zullen optreden, en ontworpen om zichzelf automatisch te corrigeren. Betrouwbaarheid moet ook in de AI-stack zelf worden ingebouwd met AI Gateways. Die kunnen centrale routering, observeerbaarheid, veiligheidskaders en intelligente modelwisseling tussen leveranciers bieden.
Veel AI-storingen worden nog steeds beschreven als kleine technische haperingen. Waar ziet u de echte economische en menselijke kosten ontstaan wanneer AI-systemen uitvallen?
AI in bedrijven is zo ver ontwikkeld dat deze haperingen niet langer alleen interne workflows raken. Tegenwoordig beïnvloeden storingen en verslechteringen het publieke beeld en de winst direct en onmiddellijk, omdat de toepassingen in productie nu voor klanten werken. De verschuiving van interne tests naar publiek toegankelijke toepassingen waarbij veel op het spel staat, verklaart de toenemende behoefte aan aandacht en toezicht van de bedrijfsleiding.
Nu AI-systemen dieper in operationele workflows zijn verweven, zijn storingen niet langer alleen technische problemen. Ze hebben steeds vaker directe gevolgen voor het bedrijf, de klanten en de reputatie.
Hoe snel kan AI-uitval in bedrijfskritieke omgevingen, zoals apotheken, zorgprocessen of klantenservice, escaleren tot operationele of reputatierisico’s?
In zulke kritieke omgevingen gebeurt die escalatie vrijwel direct, omdat de systemen tijdkritieke workflows in realtime ondersteunen. Zelfs een korte onderbreking kan kritieke processen stilleggen, dienstverlening vertragen of vervolgsystemen onderbreken die van de resultaten afhankelijk zijn. Zo ontstaan operationele kettingreacties door de hele organisatie.
In sectoren zoals de zorg reikt de impact verder dan de verstoring van de bedrijfsvoering, tot de klantervaring en de uitkomsten van de dienstverlening. Als een patiënt zijn voorgeschreven medicijnen niet op tijd kan krijgen, kan dat echte gevolgen hebben. Dat raakt niet alleen de patiënt, maar kan ook de reputatie van de apotheek of zorgverlener schaden. In kritieke omgevingen waar vertrouwen meespeelt, is het essentieel dat systemen beschikbaar blijven. Daarom erkennen organisaties steeds vaker dat AI-systemen moeten worden ontworpen vanuit de aanname dat storingen zullen optreden en dat herstelmechanismen automatisch moeten ingrijpen om het risico te beperken.
U hebt gezegd dat veel teams architectuur ontwerpen voor functionaliteit in plaats van continuïteit. Waarom heeft veerkracht volgens u in het verleden minder prioriteit gekregen bij het ontwerpen van AI-systemen?
Dat heeft vooral te maken met de prikkels binnen organisaties. Nieuwe mogelijkheden zijn zichtbaar en aansprekend. Ze maken demonstraties, functies en productmogelijkheden mogelijk die de leiding meteen kan zien.
Continuïteit is per definitie onzichtbaar als alles goed werkt. Daarom belonen organisaties vaak eerder het uitbrengen van nieuwe functies dan het zorgen dat niets kapotgaat. Het gevolg is dat ze vaak onevenredig veel investeren in nieuwe mogelijkheden vergeleken met de technische ontwikkeling van veerkracht.
Welke nieuwe kwetsbaarheden komen in de AI-stack terecht nu bedrijven steeds meer op externe modellen en API’s vertrouwen, terwijl leidinggevenden die misschien nog niet volledig doorgronden?
Grote taalmodellen zijn in wezen gedeelde middelen. Bedrijven bezitten ze niet zoals ze traditionele infrastructuur bezitten. Bovendien draaien belangrijke bedrijfskritieke systemen op externe systemen die zich nog onvoldoende over langere tijd hebben bewezen. De taalmodellen zelf veranderen snel. Daardoor kan een modelleverancier niet verantwoordelijk worden gehouden voor bijvoorbeeld reactietijd of een lichte daling van de modelprestaties, omdat leveranciers hun onderzoek in hoog tempo blijven bijstellen.
Omdat grote taalmodellen gedeelde middelen zijn, kan de reactietijd plotseling oplopen wanneer een andere gebruiker iets specifieks doet. De fundamentele aard van taalmodellen introduceert veel van zulke mogelijke storingspunten. Bedrijven hebben in deze nieuwe wereld eenvoudigweg geen volledige controle. Het beste wat ze zonder die controle kunnen doen, is voldoende redundantie inbouwen om een veerkrachtig systeem te ontwerpen.
Hoe moeten organisaties hun AI-architectuur, zonder op specifieke producten in te gaan, heroverwegen vanuit de aanname dat storingen optreden, in plaats van uitval als een zeldzaam uitzonderingsgeval te behandelen?
Organisaties moeten terug naar de grondbeginselen van het ontwerp van gedistribueerde systemen. Softwaresystemen werden gebouwd vanuit de aanname dat netwerkcomponenten en machines zouden uitvallen en dat een hele regio onbeschikbaar kon worden.
Voor AI-systemen zou hetzelfde moeten gelden. We moeten aannemen dat modelleveranciers problemen met reactietijden, verslechteringen of uitval zullen ondervinden en redundantie inbouwen, zodat toepassingen in uiteenlopende storingssituaties veerkrachtig blijven.
Verwacht u dat de veerkracht van AI doorslaggevend wordt bij de keuze van een platform en leverancier, zoals beschikbaarheid en redundantie beslissingen over cloudinfrastructuur hebben gevormd?
Naarmate meer AI-systemen in productie gaan, wordt veerkracht een basisvereiste. Als een leverancier geen grafieken en meetwaarden kan tonen voor beschikbaarheid en algemene veerkracht, wordt die niet eens overwogen. Zodra dit een basisverwachting voor alle leveranciers is, verschuift de doorslag naar gebruikerservaring, prestatieoptimalisatie, observeerbaarheid en geavanceerdere productmogelijkheden. Op termijn worden componenten zoals een AI Gateway en automatische overschakeling naar een reservesysteem fundamentele onderdelen van zakelijke AI-infrastructuur.
Wat betekent productieklare AI in de toekomst werkelijk, in een wereld waarin AI voortdurend beschikbaar moet zijn en niet alleen af en toe nuttig?
Productieklare AI-systemen moeten observeerbaar, bestuurbaar en herstelbaar zijn. Aan alle drie de voorwaarden moet worden voldaan.
Voor observeerbare AI in productie hebben teams diepgaand inzicht nodig in modelgedrag, reactietijden, foutpercentages, tokengebruik, geleidelijke verschuivingen en storingspatronen. Zonder goede observeerbaarheid is het zeer moeilijk verslechteringen te ontdekken voordat gebruikers ze opmerken.
Bestuurbaarheid omvat verkeerssturing, begrenzing van het aantal verzoeken per tijdseenheid, veiligheidskaders, het afdwingen van beleid en intelligente routering tussen modellen en leveranciers. Hier vormt een AI Gateway de basis als centrale besturingslaag. Die dwingt veiligheidskaders af, biedt consistente governance en maakt dynamische modelwisseling mogelijk als prestaties of betrouwbaarheid afnemen.
Herstelbaarheid betekent tot slot dat systemen worden gebouwd vanuit de aanname dat componenten gedeeltelijk of volledig kunnen uitvallen. Dat kan komen door leveranciersstoringen, verslechterde modelkwaliteit, verzoeklimieten of onverwachte invoer van kwaadwillenden. Automatische overschakeling naar een reservesysteem en zelfherstellende mechanismen moeten onderdeel van de architectuur zelf zijn, geen handmatige draaiboeken die pas na een probleem worden ingezet.
Dat is de richting waarin we bij TrueFoundry werken. Leveranciers die productiegeschiktheid zo definiëren, door observeerbaarheid, centrale besturing en automatisch herstel te combineren, winnen het langdurige vertrouwen van klanten. Ze kunnen ook nieuwe problemen blijven oplossen zodra die zich voordoen.
Dank voor het boeiende interview. Lezers die meer willen weten, kunnen terecht bij TrueFoundry.


