
Partnerschappen
De eerste NVIDIA Vera Rubin A5X-instanties van Google Cloud zijn operationeel

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
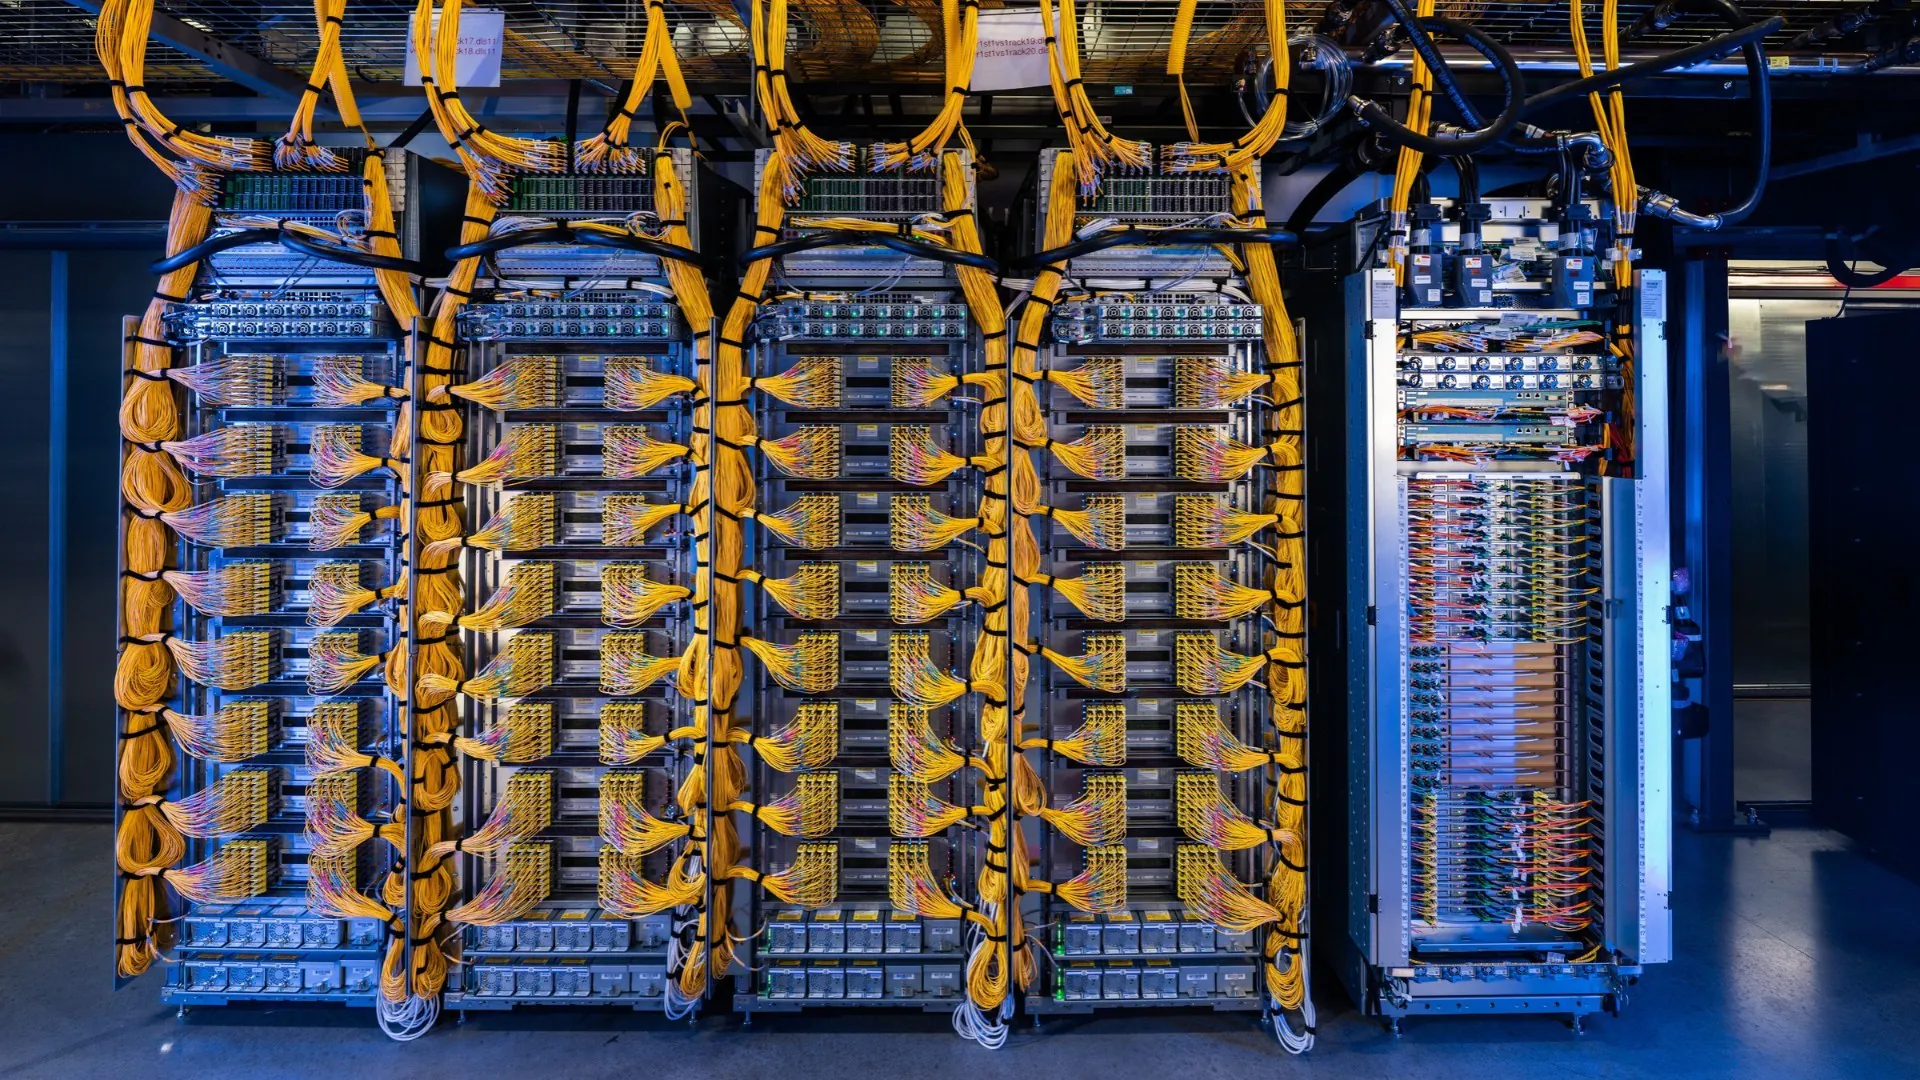
NVIDIA en Google Cloud maakten op 21 oktober 2026 tijdens GTC Berlin bekend dat de eerste actieve A5X-instanties, aangedreven door NVIDIA Vera Rubin NVL72, bij een eerste klant draaien. Algemene beschikbaarheid staat gepland voor november 2026; ook een uitbreiding van de beschikbaarheid in Europa staat op de planning.
A5X-instanties en plannen voor opschaling
De A5X-instanties combineren rack-scale-systemen met NVIDIA Vera Rubin NVL72 en NVIDIA ConnectX-9 SuperNIC’s met het Google Cloud Virgo Network en de geavanceerde vloeistofkoelingstechnologie van de vierde generatie van Google Cloud. Ze zijn ontworpen voor grootschalige workloads voor agentische inferentie en reinforcement learning. Binnen Google Clouds AI Hypercomputer integreert A5X rekenkracht, netwerken en opslag in één systeem dat ervaringsgestuurd leren op grote schaal moet ondersteunen. Google Cloud zei de op Vera Rubin gebaseerde infrastructuur te willen opschalen tot maximaal 960.000 Rubin-GPU’s op meerdere locaties.
Google maakte A5X voor het eerst bekend tijdens Google Cloud Next in april 2026. In een bericht van NVIDIA over dat evenement stond dat de instanties de inferentiekosten per token met maximaal een factor 10 zouden verlagen en de token-doorvoer per megawatt met maximaal een factor 10 zouden verhogen ten opzichte van de vorige generatie. Ook schetste het bericht plannen om op te schalen tot maximaal 80.000 Rubin-GPU’s in een cluster op één locatie en maximaal 960.000 GPU’s in een implementatie op meerdere locaties.
A5X is gebaseerd op het Rubin-platform dat NVIDIA op 5 januari 2026 lanceerde. De Vera Rubin NVL72 bundelt 72 Rubin-GPU’s, 36 Vera-CPU’s, NVLink 6-interconnects, ConnectX-9 SuperNIC’s en BlueField-4-DPU’s in één rack-scale-systeem. NVIDIA zei bij de lancering dat Rubin volledig in productie was en dat partners in de tweede helft van 2026 producten op basis van Rubin beschikbaar zouden stellen. Ook noemde het bedrijf Google Cloud als een van de eerste cloudproviders die in 2026 instanties op basis van Vera Rubin zouden inzetten.
De eerste klanten van A5X
De eerste klant die toegang kreeg tot A5X was Ineffable Intelligence, een in Londen gevestigd technologiebedrijf dat is opgericht door David Silver, de bedenker van AlphaGo. Het bedrijf gebruikt het platform voor grootschalige reinforcement learning en voor de ontwikkeling van systemen voor ‘superleren’ die continu leren van ervaring. In de aankondiging wordt leren door interactie beschreven als een doorlopende cyclus van ervaringen opdoen, resultaten evalueren en modellen bijwerken. De infrastructuur moet deze cyclus op grote schaal kunnen ondersteunen.
‘De combinatie van rekenprestaties en connectiviteit met hoge bandbreedte van Vera Rubin — tussen de Vera-CPU en de Rubin-GPU’s en tussen de Rubin-GPU’s binnen het rack — stelt ons in staat onze ambities en de schaal van ons reinforcement-learningonderzoek verder op te voeren’, zei Silver.
WPP, een in Londen gevestigd marketing- en communicatiebedrijf, heeft ook zijn referentiearchitectuur voor creatieve agents gedemonstreerd op A5X-instanties met NVIDIA Nemotron-modellen en NVIDIA OpenShell, onderdeel van de referentiearchitectuur van NVIDIA OpenShell voor veilige AI-agents. Volgens de aankondiging zetten de agents van WPP verzoeken in natuurlijke taal om in creatieve workflows met meerdere stappen, zoals videoproductie, opschaling en restyling. Voor uitvoering is menselijke goedkeuring vereist. OpenShell biedt beheerde sandboxomgevingen waarin de agents hun werk uitvoeren en regelt de toegang tot gevoelige merkmiddelen en creatieve tools. In de eerste tests voerde WPP workloads uit waarvoor normaal gesproken een cluster met meerdere nodes nodig is, op één A5X-instantie.
Confidential computing en energie-efficiëntie
Volgens de aankondiging behoort Google Cloud tot de eerste cloudproviders die NVIDIA Confidential Computing op rackschaal aanbieden op bare-metalinstanties, waaronder A4X Max-instanties met NVIDIA GB300 NVL72. In een NVIDIA-bericht van dezelfde dag stond dat Google Cloud de ondersteuning voor Confidential Bare Metal uitbreidt naar A4X Max-instanties. Daarbij wordt niet-gevirtualiseerde versnelde computing gecombineerd met cryptografische bescherming van trainingsgegevens en intellectueel eigendom in modellen. Confidential Bare Metal is een nieuwe implementatiemogelijkheid die tegelijk met Confidential Containers en Confidential Virtual Machines is geïntroduceerd. NVIDIA introduceerde ook beveiligingsmaatregelen voor het platform, waaronder gegevensbescherming tijdens verzending, metingen van de platformintegriteit en toegangsbeperkingen op hardwareniveau.
‘Onze A4X-instanties, gebouwd met NVIDIA Confidential Computing, beschermen de privacy van gebruikersgegevens en het intellectuele eigendom in modellen, en leveren toonaangevende inferentieprestaties’, zei Andrés Lagar-Cavilla, vooraanstaand ingenieur en hoofd beveiliging van AI-infrastructuur bij Google Cloud.
Google Cloud maakt Confidential Computing ook algemeen beschikbaar op G4-VM’s met NVIDIA RTX PRO 6000 Blackwell Server Edition-GPU’s, voor vertrouwelijke inferentie en finetuning. NVIDIA meldde dat klanten als Vertebrae, Polaris Cloud en Confidential Core AI Confidential G4 gebruiken voor privacy bij conversaties, verifieerbare uitvoering van agents en bedrijfsintelligentie die aan beleidsregels is gebonden. Confidential G4-VM’s met NVIDIA RTX PRO 6000 Blackwell-GPU’s waren in de previewfase toen de bedrijven hun aankondiging deden in april 2026.
De bedrijven onderzoeken ook de mogelijkheden van NVIDIA DSX MaxLPS voor de op Vera Rubin gebaseerde infrastructuur. Die zijn gericht op het optimaliseren van de prestaties per watt en het uitbreiden van de capaciteit binnen de beschikbare stroomvoorziening van datacenters, aldus NVIDIA.



