
Interviews
Gil Elbaz, medeoprichter en CTO van Datagen – Interviewreeks

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
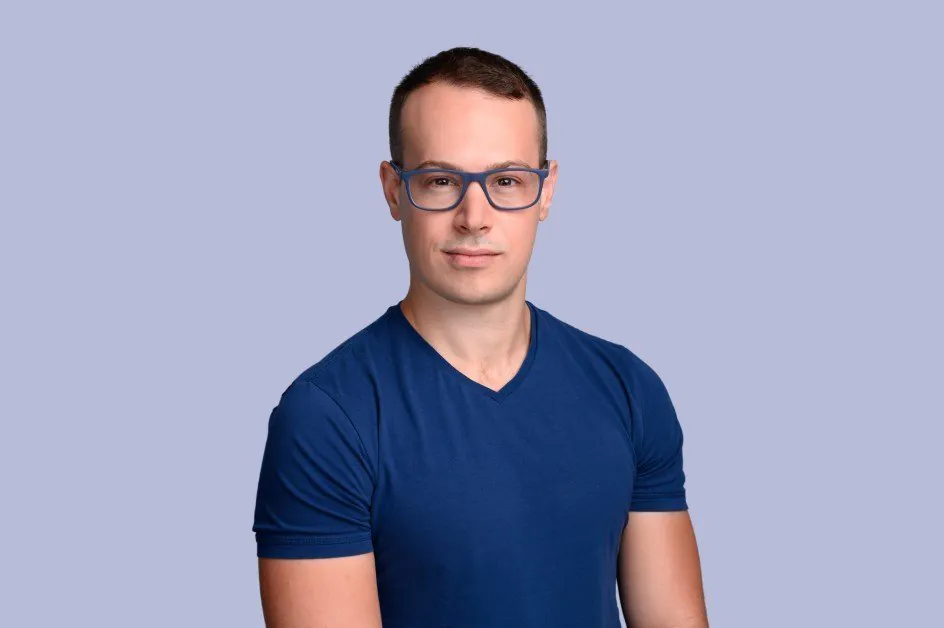
Gil Elbaz is de CTO en medeoprichter van Datagen, gevestigd in Tel Aviv. Hij behaalde zijn B.Sc en M.Sc aan de Technion. Het proefschrift van Gil was gericht op 3D-computervisie en is gepubliceerd op CVPR, de belangrijkste computervisieonderzoeksconferentie ter wereld. Datagen is een pionier op het gebied van gesimuleerde gegevens, een subset van synthetische gegevens, die zich richt op het fotorealistisch nabootsen van de wereld om ons heen. Het bedrijf lanceerde uit stealth met meer dan $18M aan financiering in maart 2021 en werkt nu samen met een aantal Fortune 100-bedrijven op het gebied van augmented/virtuele realiteit, robotica en automotive, waaronder de meeste van de grootste Amerikaanse technologiebedrijven.
Wat trok je aanvankelijk aan naar robotica en machine learning?
Sci-Fi-boeken, zoals Isaac Asimov’s Foundation Series en iRobot, lieten me altijd nadenken over een toekomst waarin robots een integraal onderdeel van ons dagelijks leven zouden zijn. Er zijn zo veel saaie, repetitieve taken die mensen doen; ik wist dat ik ze niet wilde doen, en ik kon me niet voorstellen dat iemand anders ze wilde doen. Aangezien robotica een technologische onvermijdelijkheid is, dacht ik dat het een slimme, “toekomstbestendige” carrièrebeslissing zou zijn.
Ik ben dus het veld ingereden met een focus op de fysieke aspecten van het onderwerp en heb mijn diploma in werktuigbouwkunde behaald aan de Technion in Haifa, Israël. Aan het einde van mijn studie begon ik me te verdiepen in de wereld van CAD-hulpmiddelen en -mogelijkheden. Dit zijn de hulpmiddelen die het mechanische ingenieurs mogelijk maken om structuren en mechanische apparaten te ontwerpen (alles van een brug tot een auto). Ik zag een enorme kans om een grote impact te maken zonder te maken te hebben met de trage iteraties van de fysieke wereld. In de praktijk hadden deze programma’s heel weinig, zo niet helemaal geen, machine learning-/computervisiecapaciteiten geïntegreerd, die ingenieurs hielpen om eenvoudigere, goedkopere en stabielere mechanische systemen te creëren (dit was in 2015). Ik ben de richting ingeslagen van computervisie op 3D-gegevens met diepe leerprocessen (heel nieuw op dat moment) met als doel slimme CAD-programma’s te maken. Werken in de vroege dagen van modern diep leerprocessen voelde als het onderdeel zijn van iets dat echt groot kon worden — vergelijkbaar met het internet.
In de praktijk was mijn onderzoek het eerste dat de revolutie van diepe leerprocessen naar onze faculteit aan de Technion bracht. Dit resulteerde later in een paper dat werd aanvaard op de belangrijkste computervisieconferentie ter wereld, CVPR, en ik vloog naar Hawaï voor CVPR 2017. Mijn paper presenteren en de mensen ontmoeten opende mijn ogen voor de omvang van de computervisiegemeenschap (die vandaag ten minste 10 keer groter is), duizenden deelnemers die allemaal met passie onderzoek doen in het veld. Die gebeurtenis zette mijn richting definitief vast, liet me de kracht van computervisie zien en het potentieel dat nog moet worden ontsloten.
Kun je het verhaal achter Datagen delen?
Datagen is in 2018 opgericht met de missie om te transformeren hoe teams hun gegevens voor computervisienetwerktraining krijgen. Het jaar ervoor zagen we een demo van de Oculus Rift, die bestond uit een VR-bril en een handheld bedieningsapparaat. Na de demo vroegen we ons af: “Met geavanceerde camera’s ingebouwd in de bril, waarom was een handheld apparaat nodig om de virtuele ruimte met de fysieke ruimte te verbinden (d.w.z. handbeweging volgen)?” De neurale netwerken waren al zo geavanceerd dat ze het konden aan, dus wat was het probleem?” En toen ging het lichtje branden — Gegevens! We zagen meteen de enorme kans om 3D-ruimtelijke aanwezigheidsuitdagingen op te lossen met geavanceerde computervisie en 3D-metadata. In plaats van ons alleen te richten op VR/AR, namen we een meer holistische aanpak, waarbij we ons concentreerden op het ogenschijnlijk onoplosbare probleem van het genereren van voldoende (en nauwkeurige) trainingsgegevens om echte 3D-AI-toepassingen mogelijk te maken.
Met een focus op mensen en mens-omgevingsinteractie is Datagen een pionier op het gebied van gesimuleerde gegevens, een subset van synthetische gegevens, die zich richt op het fotorealistisch nabootsen van de wereld om ons heen. Vandaag werken we samen met de meest innovatieve bedrijven ter wereld om hun computervisieontwikkeling te versnellen en te stimuleren en worden we gesteund door enkele van de meest gerespecteerde investeerders in de branche.
Voor lezers die onbekend zijn met het onderwerp, kun je uitleggen wat synthetische gegevens precies zijn?
Synthetische gegevens zijn alle trainingsgegevens die — in plaats van verzameld te worden via directe meting of observatie van de echte wereld — gegenereerd worden via algoritmen of simulatie. In de context van computervisie zijn synthetische gegevens computer gegenereerde afbeeldingen met bijbehorende metadata die nodig zijn voor het trainen van kunstmatige intelligentie. Vanwege privacyproblemen en zeer reële fysieke en economische beperkingen van echte wereldgegevens, is het moeilijk om de betekenis van synthetische gegevens voor machine learning en AI te overschatten. In een recent rapport voorspelde Gartner dat, tegen 2024, de meeste gegevens die in het veld van AI worden gebruikt, kunstmatig gegenereerd zullen zijn om die redenen.
Wat zijn enkele voordelen van synthetische gegevens in vergelijking met handmatige gegevensverzameling?
Het korte antwoord is, denk aan elk aspect van handmatige gegevensverzameling dat ongewenst is en verwijder die uit het proces — dat zijn de voordelen van synthetische gegevens.
Het genereren van diverse datasets in grote hoeveelheden voor computervisietraining is een kostbaar en tijdrovend proces, en de variatie is zeer beperkt door het feit dat het plaatsen van mensen op specifieke locaties en het fotograferen van hen een ingewikkeld proces is — veel ingewikkelder en duurder dan het doen in een gesimuleerde omgeving. Een ander groot voordeel is het effectief elimineren van de behoefte aan handmatige annotatie, die saai, tijdrovend en vatbaar is voor menselijke fouten is.
Datagen verwijst naar gesimuleerde gegevens als een subset van synthetische gegevens. Kun je uitleggen wat gesimuleerde gegevens zijn?
Gesimuleerde gegevens zijn synthetische gegevens die gegenereerd worden via simulatie. We gebruiken GANs (evenals enkele andere geavanceerde machine learningmethoden) om 3D-objecten te genereren en ze binnen hoogwaardige 3D-simulaties van de echte wereld te plaatsen. Wat dat betekent is een eerstepersoons “virtuele foto”-proces, maar opererend binnen een fotorealistisch, fysica-gebaseerd systeem. Deze simulaties produceren visuele gegevens (alsof ze in de echte wereld waren verzameld), samen met een volledig bereik van annotaties (fysica, licht, enz.). Dus, gesimuleerde gegevens zijn synthetische gegevens die fotorealistisch, contextueel gegenereerd, 3D-beelden zijn, verzameld in een gesimuleerde omgeving.
Hoe genereert Datagen aangepaste gesimuleerde gegevens?
De technologie van Datagen genereert gesimuleerde gegevens die zowel schaalbaar als op maat gemaakt zijn om te voldoen aan de unieke behoeften van elke klantenspecifieke toepassing. We doen dit door rekening te houden met elk aspect van elk project — van het computervisiesysteem dat wordt gebruikt tot de demografische samenstelling van de regio waarin het zal worden gebruikt. Of we nu direct samenwerken met onze klanten of hun eigen ingenieurs in staat stellen, het proces van Datagen begint met het vaststellen van sleutelparameters voor elke specifieke use case, zoals lensspecificaties, licht, omgeving, demografische verdeling, enz. Datagen gebruikt GANs en andere geavanceerde hulpmiddelen en -technieken om een enorme variëteit aan assets te genereren, waaronder alles van menselijke hoofden met dynamische gezichtsuitdrukkingen om AI te trainen in emotieanalyse, tot voertuiginterieurs voor in-cabine passagiersbewaking, en huiskamers voor videoconferentie-toepassingen, om er maar een paar te noemen. Voor elk type asset introduceert Datagen variatie over ontelbare discrete assen (van huidskleur en wenkbrauwhoogte tot de grootte, kleur en vorm van huismeubilair), met parameters die fijn afgesteld zijn om de specifieke toepassing te weerspiegelen.
Door deze mogelijkheden zijn de datasets van Datagen niet alleen groot en zeer gevarieerd, maar ook geoptimaliseerd voor het trainen van een uniek systeem om een unieke taak (of een set taken) uit te voeren in de unieke omgeving of setting waarin het zal worden gebruikt — alles zonder de capaciteit om te schalen te compromitteren. We houden ook rekening met de specifieke annotatie/metadata-eisen van elke toepassing.
Wat zijn enkele voorbeelden van oplossingen in robotica waar synthetische en/of gesimuleerde gegevens worden gebruikt?
Een van de grootste voordelen van het gebruik van gesimuleerde gegevens in robotica is de mogelijkheid om afbeeldingen van hardware te genereren die nog in ontwikkeling is. Op deze manier kunnen de hersenen van de robot (AI) en het lichaam (hardware) tegelijkertijd worden ontwikkeld. Nu kan de training evolueren naarmate de specificaties evolueren, in plaats van te wachten tot het eindproduct volledig is geprototypeerd voordat foto’s kunnen worden gemaakt en de AI kan beginnen met ontwikkelen.
Ook kan gesimuleerde gegevens gemakkelijker rekening houden met de interactie tussen de robot en zijn omgeving. Stel je een robot voor die defecte producten van een productieband verwijdert, gesimuleerde gegevens zouden het mogelijk maken om niet alleen gegevens te genereren voor elk fysiek defect dat in het product kan voorkomen, maar ook vanuit het perspectief van de robot om de volledige bewegingsvrijheid van de robotarm te capteren, de interactie met het object dat het grijpt. Bovendien betekent 3D-metadata dat er geen behoefte is om elke afbeelding zorgvuldig te annoteren om ervoor te zorgen dat de robot het product, de defecten, zijn arm of iets anders in zijn gezichtsveld correct kan identificeren.
Wat zijn enkele use cases voor het gebruik van gesimuleerde gegevens in slimme auto’s?
Gesimuleerde gegevens in de ontwikkeling van slimme auto’s maken het oneindig veel gemakkelijker om datasets te ontwikkelen voor specifieke automodellen terwijl ze worden ontworpen, itererend in concert met de auto zelf terwijl het door de verschillende fasen van ontwerp en productie gaat. Met gesimuleerde beeldgegevens kunnen ingenieurs ook in-cabine visie effectiever gebruiken om slaperige of afgeleide bestuurders te identificeren, of als een bestuurder zijn hand van het stuur heeft genomen, of een van de vele randgevallen om bestuurdersveiligheid te waarborgen. Het stelt ingenieurs ook in staat om rekening te houden met een grotere diversiteit aan bestuurders en passagiers en variatie in te voeren in de vorm van beeldhoek en licht — alles zonder in te breken op de privacy van echte mensen.
Onlangs heeft Datagen een groot aantal opwindende nieuwe aanwervingen aangekondigd, wat betekent dit voor de toekomst van het bedrijf?
De recente toevoegingen aan ons adviesraad en leiderschapsteam omvatten enkele van de meest briljante en ervaren professionals in het veld van AI en computervisie. Hun kennis, inzicht en ervaring zullen helpen om de groei van Datagen te oriënteren en te versnellen terwijl we een industrie navigeren die nog jong is en vol mogelijkheden zit. In een veld met zoveel onzekere factoren is niets waardevoller dan kennis.
Is er nog iets dat je over Datagen wilt delen?
Gevestigd in Tel Aviv, maakt Datagen deel uit van een veel grotere economische en culturele verschuiving die in Israël heeft plaatsgevonden, en we zijn trots om daar deel van uit te maken. In korte tijd is Israël (Tel Aviv in het bijzonder) uitgegroeid tot een belangrijk wereldwijd technologiehub, met een bloeiende startup-ecosysteem en een energiek investeringsgemeenschap. Hoewel Israël vaak wordt beschouwd als een technologiehub met een focus op cybersecurity, is AI- en data-georiënteerde technologie in de afgelopen jaren exponentieel gegroeid. Vandaag zijn er meer dan 680 kunstmatige intelligentiebedrijven in Israël, die collectief $4,5 miljard hebben opgehaald. Deze explosieve groei in de afgelopen jaren is grotendeels te wijten aan de hoge concentratie van ingenieurs en de wereldberoemde universiteiten van Israël. Deze academische instellingen bieden toegang tot talent en cutting-edge nieuwe technologieontwikkeling in de branche. In de afgelopen twee maanden heeft Datagen meer dan 20 medewerkers aangenomen en zijn er plannen om extra teamleden aan te nemen in de verkoop- en marketing-, software- en DevOps- en productafdelingen.
Bedankt voor het geweldige interview, lezers die meer willen leren, kunnen een bezoek brengen aan Datagen.


