
Interviews
Fabiana Clemente, medeoprichter en Chief Data Officer bij YData – Interviewreeks

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
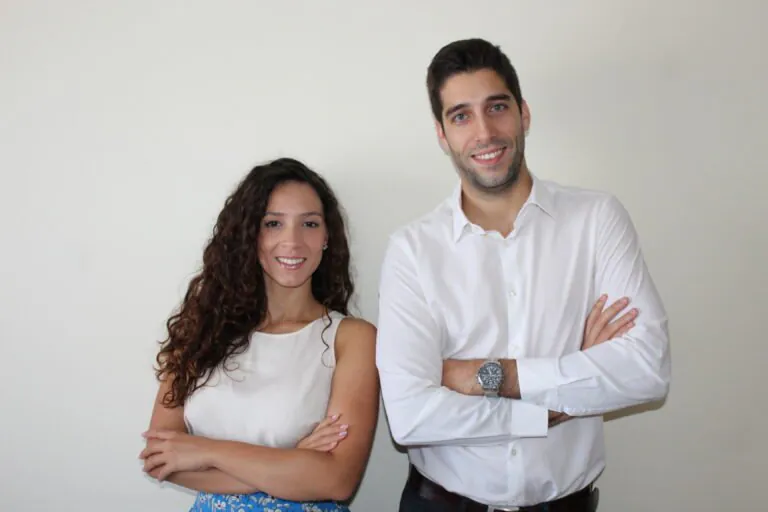
Fabiana Clemente is de medeoprichter en Chief Data Officer bij YData. YData is een AI-startup die de eerste data-centrische ontwikkeloplossing heeft gecreëerd om data-ontdekking, -verbetering en -schaalbaarheid te combineren in één enkel platform.
Wat trok je aanvankelijk aan naar AI en machine learning?
Mijn achtergrond ligt in toegepaste wiskunde, waar ik de kans had om te leren en te begrijpen hoe we informatie uit data kunnen halen, evenals hoe we dat kunnen doen met behulp van code. Toen was het niet zo sexy als machine learning, maar het was zeker wat mijn passie voor het gebied aanwakkerde.
Kunt u het verhaal achter Ydata delen?
Als datawetenschapper die heeft gewerkt voor zowel startups als ondernemingen, had ik mijn fair share aan uitdagingen – soms was de toegang tot data geblokkeerd onder het voorwendsel van veiligheid of privacy, andere keren was de toegang gemakkelijk, maar de kwaliteit van de data was niet eens in de buurt van wat nodig was om AI-gebaseerde oplossingen te bouwen. Het feit dat deze uitdagingen zeer frequent voorkomen in de meeste organisaties, inspireerde ons om het bedrijf op te richten met als doel om deze teams te helpen bij het overwinnen van deze obstakels, door hun AI-ontwikkeling te versnellen met verbeterde data.
Kunt u ons uitleggen wat synthetische data is?
Synthetische data wordt beschouwd als alle data die niet in de echte wereld is gegenereerd, dus alle data die kunstmatig is gecreëerd. Er zijn methoden die de generatie van synthetische data mogelijk maken – van regelgebaseerde strategieën tot het gebruik van machine- of diepe leermodellen om die “regels” voor ons te leren. Bij YData hebben we een diepe leerstrategie geadopteerd en gespecialiseerd om nieuwe data te genereren die het gedrag van echte gebeurtenissen behoudt, zonder zorgen over privacy.
Wat maakt synthetische data zo belangrijk?
Naarmate organisaties de belangrijkheid van data voor het stimuleren van hun bedrijven beter begrijpen, zal de belangrijkheid en rol van synthetische data beter worden begrepen. Het verzamelen van echte data is niet alleen tijdrovend en duur, maar soms ook onmogelijk. Om AI-toepassingen te bouwen, is data een harde vereiste – hier komt synthetische data te hulp. De mogelijkheid om ongeziene scenario’s te genereren of om simpelweg de toegang tot data te ontgrendelen, is sleutel tot het evolueren in een wereld waar pioniers zoals Andrew Ng stellen dat het worden van data-centrisch de sleutel is tot een succesvolle AI-adoptie.
In zelfrijdende auto’s of andere automatiseringsactiviteiten kunnen we al de belangrijkheid van synthetische data waarnemen, dus ik zou zeggen dat het alleen maar natuurlijk is dat dit begrip zich verspreidt over alle industrieverticale sectoren.
Hoe genereert Ydata synthetische data?
YData maakt voornamelijk gebruik van diepe generatieve modellen om de statistische kenmerken en correlaties tussen variabelen van de oorspronkelijke data te leren. Dit stelt het model in staat om een statistisch relevante dataset te genereren die dezelfde businesswaarde heeft als de oorspronkelijke, zonder dat het mogelijk is om de oorspronkelijke records te traceren.
YData zet deze technologie verder en is het bedrijf achter de Synthetic Data Community – een groep van datawetenschappers die zich hebben verbonden om deze technologie te evangeliseren en te helpen bij iedereen die deze technologie wil leren en gebruiken.
Hoe helpt het Ydata-platform bij het ontdekken en ontgrendelen van nieuwe datasources?
YData’s platform bevat ingebouwde connectors voor elk type database, datawarehouse of datalake, waardoor gebruikers gemakkelijk toegang kunnen krijgen tot relevante metadata en begrijpen of de bestaande data nuttig is om de businessvraag te beantwoorden die ze hebben – zonder zelfs maar naar de echte records te kijken.
Kunt u enkele details delen over de Synthetic Data Open Source community?
Synthetische data is nog maar in de kinderschoenen en daarom is het bewustzijn over hoe het wordt gegenereerd, de voordelen en de beperkingen nog niet algemeen bekend bij een groter publiek. Daarom hebben we bij YData besloten om een meer educatieve route te volgen door de Synthetic Data community te creëren – naast een plek om ideeën uit te wisselen of hulp te krijgen van experts op het gebied van synthetische data, is het ook een plek waar datawetenschappers en andere technische profielen hun reis naar synthetische data kunnen beginnen, met enkele van de meest interessante algoritmen uit de literatuur.
Verder bieden we ook een perspectief op datakwaliteit, zodat datawetenschappers eerst kunnen begrijpen met welke data ze werken, voordat ze synthetische data genereren of verbeteren. We zijn echt toegewijd om datateams te helpen meer en meer data-centrisch te worden.
YData heeft onlangs 2,7 miljoen dollar aan financiering ontvangen om de internationale expansie te versnellen. Kunt u enkele details delen over wat dit betekent voor de toekomst van het bedrijf en de expansiestrategie?
YData is internationaal geboren – we wisten dat deze technologie vroegere aanhangers nodig heeft die meestal in de meest geavanceerde landen te vinden zijn. Daarom waren onze eerste klanten al buiten Portugal, overal in Europa, en we zijn nu een aanwezigheid aan het vestigen in Noord-Amerika. Deze financiering zal ons in staat stellen om onze aanwezigheid in beide continenten te versterken, niet alleen commercieel, maar ook om het team te laten groeien: we zijn een volledig gedistribueerd team, wat ons in staat stelt om de beste talenten te werven, waar ze ook zijn.
Is er nog iets anders dat u over YData wilt delen?
YData duwt de grens van data-centrische AI en creëert een nieuwe categorie: DataPrepOps – hoewel het een lelijke naam is, is het een pijn die de meeste bedrijven tegenwoordig ervaren bij datawetenschappelijke ontwikkeling. De Data Quality trend blijft groeien en na Data Pipelines en Data Observability is Data Quality voor Data Science teams nog in de kinderschoenen en YData is een gedachteleider in data-voorbereiding.
Bedankt voor het geweldige interview, lezers die meer willen leren, moeten YData bezoeken.


