
Interviews
Dr. Mathilde Pavis, Head of Legal, OpenOrigins – Interviewreeks

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
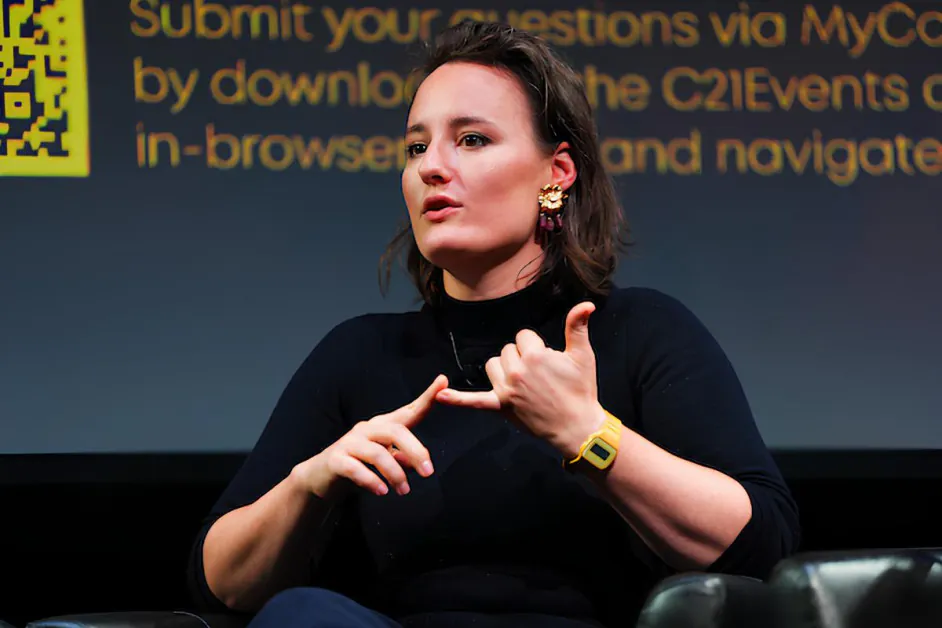
Dr. Mathilde Pavis, Head of Legal bij OpenOrigins, is een toonaangevende expert in AI-regulering en digitale media-governance, gespecialiseerd in deepfakes, synthetische media en content-provenance. Ze adviseert bedrijven, overheden en vakbonden over compliance, licenties en risico’s in generatieve AI en heeft samengewerkt met Microsoft (MSFT ) en ElevenLabs aan AI-beleid en -strategie. Ze heeft ook UNESCO geadviseerd over AI en intellectueel eigendom en levert regelmatig deskundige bewijs aan Britse beleidsmakers.
OpenOrigins ontwikkelt technologie om desinformatie en deepfakes te bestrijden door verifieerbare, onveranderlijke records van digitale content te creëren. Het platform richt zich op het vaststellen van duidelijke provenance, waardoor media, makers en platforms kunnen aantonen wanneer en hoe content is gemaakt, bewerkt en gedistribueerd – een steeds kritieker capaciteit naarmate synthetische media geavanceerder en moeilijker te detecteren wordt.
U hebt overheden, mondiale instellingen zoals UNESCO en bedrijven zoals Microsoft en ElevenLabs geadviseerd over AI-regulering. Wat heeft u ertoe geleid om u specifiek te richten op deepfakes, digitale replica’s en synthetische media, en hoe heeft die reis uw beslissing beïnvloed om Replique op te richten?
Mijn werk aan deepfakes begon niet met de technologie – het begon met een veel oudere juridische puzzel. Toen ik in 2013 begon met onderzoek naar intellectueel eigendom voor mijn PhD, werd ik getroffen door hoeveel minder bescherming uitvoerders krijgen in vergelijking met auteurs, componisten of filmmakers. In de praktijk betekent dit dat uw woorden of uw muziek beter beschermd zijn in de wet dan uw stem, uw gezicht en uw lichaam. Die onevenwichtigheid voelde vreemd aan, en het zette me ertoe aan om een diepere vraag te stellen: hoe waarderen we cultureel en juridisch het werk van iemand wiens bijdrage zijn gezicht, stem en lichaam op het scherm is?
Die vraag leidde me naar de rechten van uitvoerders en gegevens. Op dat moment werd het beschouwd als een niche-gebied met weinig commerciële relevantie. Ik kreeg actief het advies om me te verplaatsen naar meer “lucrative” gebieden zoals octrooien of traditioneel auteursrecht. De veronderstelling was dat kwesties rond iemands gelijkenis of stem grotendeels informeel werden beheerd – door middel van industrienormen of “gentlemen’s agreements in Hollywood”. Maar voor mij gaf die gebrek aan formele bescherming aan dat er een lacune was, geen doodlopende weg voor mijn onderzoek, dus ik bleef ermee doorgaan.
Wat veranderd is, is dat tegenwoordig bijna iedereen een uitvoerder is. Ons leven wordt bemiddeld door camera’s – op telefoons, laptops, videoconferencing en sociale platforms. Of het nu voor werk of persoonlijk gebruik is, mensen nemen constant versies van zichzelf op en delen ze. De juridische vragen die eerst voornamelijk van toepassing waren op acteurs of muzikanten, zijn nu van toepassing op iedereen met een smartphone.
Deepfakes hebben deze kwesties niet gecreëerd – ze hebben ze blootgelegd en versneld. Het onderzoek dat ik vanaf 2013 deed, werd plotseling dringend. Rond 2017 en 2018 begonnen ontwikkelingen in neurale netwerken – met name uit plaatsen als MIT en UC Berkeley – te demonstreren hoe overtuigend een persoon zijn gezicht, stem en lichaam digitaal gemanipuleerd kon worden. Binnen een jaar werd die capaciteit algemeen bekend als “deepfakes” en kreeg het voor het eerst tractie op diep schadelijke manieren, vooral via niet-toegestane seksuele inhoud gericht op vrouwen en kinderen.
Pas later kwamen de commerciële implicaties naar voren, toen de creatieve industrie synthetische media begon te omarmen. Dat is wanneer de contractuele en economische vragen die ik had onderzocht, naar voren kwamen. Bijna overeenkomstig wat eerder werd beschouwd als een grotendeels theoretisch of leerstuk-gebied van de wet, werd het een zeer praktisch, commercieel significant en sociaal urgent veld.
In wezen is de juridische uitdaging niet veranderd: mensen willen aspecten van zichzelf delen, maar willen nog steeds zinvolle controle behouden. Bestaande kaders worstelen met die nuances. Ze hebben de neiging om individuen te behandelen als volledig privé of volledig openbaar – ofwel beschermd ofwel eerlijk spel. Maar de meeste mensen bestaan ergens daartussenin. Die spanning is nu centraal, niet alleen voor professionele uitvoerders, maar voor iedereen die deelneemt aan het digitale leven.
Ik werd bekend als iemand die in dit gebied onderzoek deed en werkte, wat me ertoe leidde om te werken met overheden die geïnteresseerd waren in het beschermen van mensen tegen deepfakes, en bedrijven die digitale kloonproducten veilig wilden maken voor gebruik, zoals ElevenLabs. Bij Replique breng ik alles wat ik heb geleerd bij mensen en bedrijven die digitale kloon- of digitale replica-technologie verantwoordelijk en veilig willen gebruiken. Ik heb mijn ‘blue sky’-onderzoek eigenlijk omgezet in een adviesbedrijf dat gespecialiseerde juridische adviezen biedt aan de creatieve industrie.
Als Head of Legal bij OpenOrigins, een bedrijf dat zich richt op het vaststellen van een onveranderlijke record van content-provenance om deepfakes te bestrijden, hoe ziet u provenance-gebaseerde systemen concurreren met of vervangen van traditionele deepfake-detectiebenaderingen?
Het vergelijken van deepfake-detectietools kan snel een appels-en-peren-oefening worden, omdat hun effectiviteit afhankelijk is van context en doel. Vanuit een beleidsperspectief hebben we een reeks complementaire tools nodig – er is geen enkele “beste” oplossing, en Open Origins is slechts een onderdeel van dat bredere ecosysteem. Waar OpenOrigins’ technologie uitblinkt als deepfake-detectieoplossing, is in situaties waarin een content-maker of informatie-organisatie de authenticiteit van de content die ze delen met partners, publiek of het grote publiek, moet aantonen.
Door verifieerbare provenance en “ontvangingen” te bieden op het moment van creatie, biedt het een sterke vorm van preventie door aan te tonen dat content geen deepfake is. Deze aanpak is echter minder nuttig voor alledaagse internetgebruikers die snel content willen beoordelen die ze online tegenkomen. In die gevallen is detectie meer afhankelijk van probabilistische en content-analysemethode dan van provenance-gebaseerde verificatie. We hebben verschillende tools nodig voor verschillende behoeften, en we moeten accepteren dat er geen zilveren kogel tegen deepfakes is.
Vanuit een juridisch oogpunt, wat is momenteel de grootste lacune in de manier waarop rechtsgebieden omgaan met toestemming en eigendom in AI-gegenereerde of AI-gekopieerde content?
Oef, hoeveel tijd hebt u? De antwoorden hangen af van wat we bedoelen met AI-gegenereerde of gekopieerde content. De kwesties variëren of u naar een AI-gegenereerd beeld van een huis of een kat kijkt. Of een digitale reproductie van iemands gezicht of stem. Laten we ons tot het onderwerp van deepfakes en digitale replica’s beperken en uw vraag beantwoorden in de context van ‘digitale kloning’.
Wat toestemming betreft, is het kernprobleem dat de meeste contracten – of het nu arbeidsovereenkomsten of platformvoorwaarden zijn – brede, vage clausules bevatten die uitgebreide rechten over gebruikerscontent verlenen. Deze kunnen worden geïnterpreteerd als een vorm van “achterdeur-toestemming” waarbij het akkoord met de voorwaarden kan worden opgevat als toestemming voor het gebruik van dergelijke toepassingen, zelfs als de meeste mensen dat sterk zouden betwisten. Dit creëert een aanzienlijke lacune tussen juridische interpretatie en gebruikersverwachting, een die momenteel bedrijven bevoordeelt, terwijl de regulering achterblijft.
Wat eigendom betreft, is er geen duidelijk juridisch antwoord op de vraag wie een digitale kloon bezit, omdat bestaande kaders zoals gegevensbescherming, auteursrecht en persoonlijke rechten niet zijn ontworpen voor deze technologie. Vandaag de dag worden de meeste mensen gescand en gekloond op het werk, op verzoek en met de financiering van een werkgever of cliënt. En die entiteiten verwachten meestal een hoge mate van controle over dat actief, wat begrijpelijk is, maar vaak problematisch is, omdat dat actief een digitale imitatie is van uw gezicht of uw stem en u dingen kan laten zeggen die u nooit hebt gezegd, of dingen kan laten doen die u nooit hebt gedaan.
De vraag “wie bezit uw kloon?” is heel belangrijk, maar onbeantwoord in de wet van vandaag.
U hebt nauw samengewerkt met stemkloon-technologie. Wat zijn de meest misverstane juridische risico’s als het gaat om synthetische stemmen, zowel voor bedrijven als voor individuen?
Het meest misverstane probleem in juridische compliance is de balans tussen het commerciële belang van een bedrijf om een digitale kloon te financieren en te exploiteren, en het recht van een individu op privacy en digitale waardigheid. Deze spanning zit over meerdere juridische regimes (voornamelijk intellectueel eigendom, gegevensbescherming en privacy) die nooit zijn ontworpen om samen te werken en interpreteren kloning op fundamenteel verschillende manieren. Als gevolg daarvan is het vertalen van dit in werkbaar, bedrijfsvriendelijk beleid complex en vaak onduidelijk. Bedrijven negeren daarom ofwel belangrijke risico’s, ofwel incasseren ze aanzienlijke kosten om ze correct te navigeren. Dat leidt tot een pervers resultaat waarbij verantwoorde compliance de moeilijkere, duurdere route is, in plaats van de standaard.
Hoe moeten bedrijven denken over toestemmingsarchitectuur in AI-systemen, vooral bij het omgaan met gelijkenis, identiteit en trainingsgegevens?
Bedrijven moeten hun systemen ontwerpen rond drie kerncapaciteiten. Ten eerste moeten ze geïnformeerde, contextuele toestemming verkrijgen bij onboarding. Ten tweede moeten ze het voor gebruikers gemakkelijk maken om die toestemming in te trekken en sommige of alle van hun gegevens te verwijderen, iets wat technisch moeilijk is en vaak over het hoofd wordt gezien, maar essentieel is voor compliance met wetten zoals de UK en EU GDPR en soortgelijke regimes in de VS. Het behouden van toestemming in de loop van de tijd betekent het opbouwen van systemen waarbij intrekking operationeel soepel en afgestemd is op het bedrijfsmodel.
Toestemming moet granulair zijn. En ten derde moeten gebruikers in staat zijn om toestemmingen te beheren op het niveau van individuele bestanden, hun gelijkenisgegevens bijwerken en begrijpen hoe deze worden gebruikt. Dat vereist transparantie en controle – tools die gebruikers in staat stellen om te controleren, te bekijken en te modereren hoe hun digitale klonen worden ingezet. Deze mate van flexibiliteit is nog zeldzaam, maar het ligt waar de concurrentievoordeel steeds meer ligt.
Uit uw ervaring met het adviseren van zowel startups als overheden, waar ligt de grootste disconnectie tussen hoe AI wordt gebouwd en hoe het wordt gereguleerd?
De disconnectie tussen hoe AI wordt gebouwd en hoe het wordt gereguleerd komt neer op fundamenteel verschillende missies. Overheden reguleren in het publieke belang, terwijl AI-bedrijven (vaak door venture capital gesteund) primair worden gedreven door groei, omzet en winst. Die prioriteiten conflicteren niet altijd, maar trekken vaak in verschillende richtingen, met regulering gezien als een beperking in plaats van ondersteuning.
Dit creëert een structurele spanning: regulators en innovators opereren met verschillende incentives, waarden en zelfs talen. Dat maakt afstemming moeilijk in de praktijk, zelfs als het niet onmogelijk is. We beginnen een nieuwe golf van techbedrijven te zien die meer in overeenstemming zijn met publieke doelstellingen, maar ze zijn nog steeds de uitzondering in plaats van de regel – vooral onder diegenen die met succes schalen.
OpenOrigins richt zich op het verifiëren van content bij het moment van creatie met behulp van cryptografische provenance. Hoe kritiek is deze aanpak van oorsprong-eerst in vergelijking met veiligheidsmaatregelen na distributie?
Dit sluit aan bij mijn antwoord hierboven. Het authentiseren van content bij creatie, ‘upstream’, is veel effectiever dan het proberen te verifiëren bij het moment van distributie of consumptie, d.w.z. ‘downstream’. Het authentiseren van content bij creatie is als het traceren van voedsel vanaf het moment dat het op de boerderij wordt geteeld, in plaats van proberen het uit te zoeken vanaf wat er op uw bord ligt. Als u weet waar de kip is gefokt, hoe het is behandeld en hoe het door de toeleveringsketen is gegaan, kunt u vertrouwen op wat u eet. Als u daarentegen probeert al die informatie af te leiden uit het afgewerkte gerecht, vertrouwt u op giswerk. Het is hetzelfde met het onderscheiden tussen door mensen gegenereerde en AI-gegenereerde content online: provenance bij de bron biedt verifieerbare zekerheid, terwijl downstream-detectie inherent onzekerder en reactiever is.
Wat is de rol van standaarden zoals C2PA in de toekomst van media, en zijn ze op zichzelf voldoende om vertrouwen online te herstellen?
C2PA is een welkome initiatief en ondersteunt in veel opzichten dezelfde beweging voor content-authenticiteit als OpenOrigins. Ze zijn een belangrijk onderdeel van het ecosysteem voor contentveiligheid en -authenticiteit. Zoals bij elke cybersecurity-tool is er geen zilveren kogel.
Wat zijn de praktische stappen die creators en talent in branches zoals film, muziek en gaming vandaag moeten nemen om zich te beschermen tegen ongeautoriseerde digitale replicatie?
Kunstenaars vandaag lopen twee verschillende risico’s: de replicatie van hun werk (zoals muziek, afbeeldingen of schrijven) en de replicatie van hun gelijkenis, inclusief hun gezicht, stem en lichaam. Met minimale invoer kunnen AI-systemen nu beide reproduceren met een hoge mate van geloofwaardigheid. In praktische zin begint bescherming met het bewust zijn van wat u online deelt, het erkennen dat elke geplaatste content kan worden gescraped en gebruikt in trainingsdatasets, vaak zonder duidelijke toestemming of zichtbaarheid.
Dat risico is nu een basisrealiteit van online opereren. Maar het meest directe en beheersbare risico ligt vaak in contracten. Overeenkomsten die artiesten sluiten met hun samenwerkingspartners, distributeurs of platforms kunnen clausules bevatten die AI-gebruik, hergebruik of doorverkoop van content voor trainingsdoeleinden toestaan – vaak zonder significante deelname aan downstream-omzet.
Voor artiesten maakt dit contractuele controle kritiek. Het begrijpen van hoe uw werk en gelijkenis kunnen worden gebruikt, gelicenceerd of hergebruikt, is nu net zo belangrijk als het creatieve proces zelf. Veel van het huidige debat (over unions, industrie-organisaties en platforms) draait om het corrigeren van deze onevenwichtigheid en het waarborgen dat creators zowel controle als eerlijke compensatie behouden.
Dus twee belangrijke adviezen: wees voorzichtig met wat u online deelt, en lees uw contracten en zoek naar AI-clausules voordat u ondertekent.
Kijkend naar de toekomst, drie tot vijf jaar, gelooft u dat we een punt zullen bereiken waarop elke stuk digitale content verifieerbare provenance moet dragen, of zal vertrouwen gefragmenteerd blijven over platforms en rechtsgebieden?
Ik zou willen zeggen ja, maar realistisch gezien, nee – niet binnen vijf jaar. In tech voelt vijf jaar lang; in termen van het veranderen van gebruikersgedrag en -gewoonten is het heel kort. De meeste consumenten zullen waarschijnlijk hun beslissingen niet baseren op of content verifieerbare provenance bevat. Platforms volgen meestal gebruikersvraag, optimaliserend voor engagement in plaats van provenance.
Dat kan veranderen als regulering ingrijpt. We zien al vroege bewegingen in plaatsen zoals Californië, waar etiketterings- en moderatievereisten naar voren komen, maar het opschalen hiervan wereldwijd zal tijd kosten – waarschijnlijk dichter bij een decennium dan vijf jaar.
Een ander gebied van verandering is sector-specifiek: industrieën zoals journalistiek, financiën, verzekeringen en gezondheidszorg kunnen beginnen met het vereisen van provenance en authenticatie, omdat vertrouwen fundamenteel is voor hun operaties.
Tot slot zullen consumenten zich misschien niet druk maken over provenance-informatie op korte termijn, maar ze zullen waarschijnlijk waarde hechten aan de kwaliteit van de content en de kwaliteit van de informatie. Als AI-gegenereerde content te homogeen of “saai” wordt, kunnen audiences beginnen om menselijk gegenereerde content expliciet te waarderen. Dat kan een segmentatie van de markt aandrijven, waarbij sommige platforms prioriteit geven aan schaal en AI-gegenereerde content, en anderen cureren voor authenticiteit, provenance en hoogwaardige, menselijk geleide materialen – maar die verschuiving blijft onbekend.
Bedankt voor uw geweldige antwoorden, lezers die meer willen leren, moeten OpenOrigins bezoeken.


