
Interviews
Dr. Jaime Bland, mede-oprichter en CEO van Aquila Health – Interview Series

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
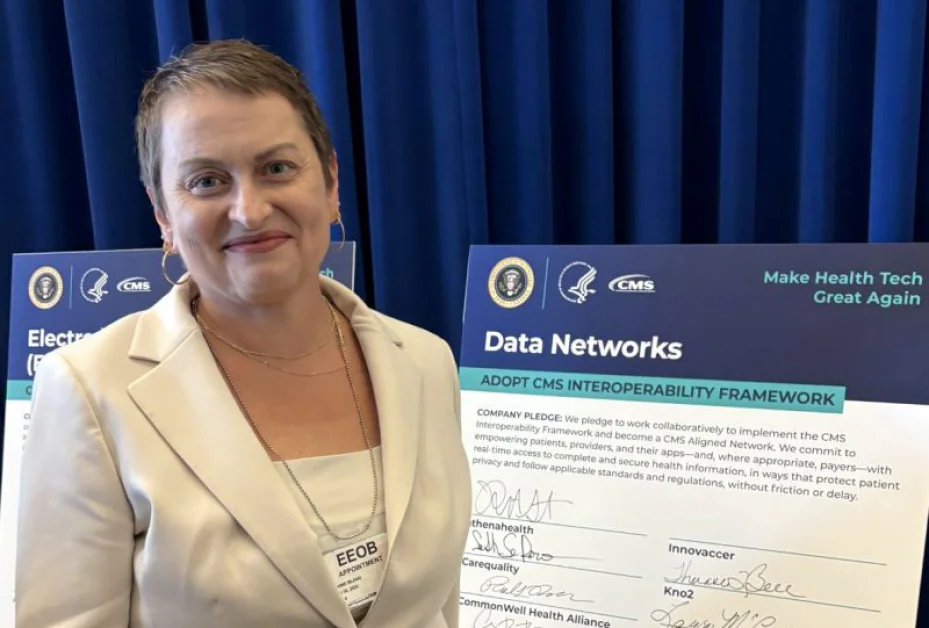
Dr. Jaime Bland, mede-oprichter en CEO van Aquila Health, is een leider in de gezondheidszorgtechnologie die zich richt op het aanpakken van een van de meest hardnekkige uitdagingen in de industrie: gefragmenteerde en ontoegankelijke gegevens. Ze richtte Aquila Health op om een uniforme gegevensinfrastructuur te bouwen die gezondheidsorganisaties in staat stelt om verder te gaan dan gesloten systemen, door machine learning en gestructureerde analyse te gebruiken om actiegerichte inzichten te genereren, terwijl klinische toezicht wordt gehandhaafd. Haar werk is gericht op het verbeteren van de interoperabiliteit, het mogelijk maken van populatiegezondheidsinformatie en het ondersteunen van een eerder detectie van opkomende gezondheidsbedreigingen door geïntegreerde klinische, claims- en genomicsystemen.
Aquila Health is een AI-gedreven gezondheidsgegevensplatform dat is ontworpen om uiteenlopende gegevensbronnen te verenigen in een enkel, interoperabel systeem dat zowel operationele efficiëntie als geavanceerde analyse ondersteunt. Het platform verwerkt grote hoeveelheden gezondheidsgegevensformaten, zoals HL7 en FHIR, waardoor naadloze integratie mogelijk is tussen ziekenhuizen, openbare gezondheidsstelsels en andere belanghebbenden. Door gestructureerde machine learning-benaderingen te combineren met een human-in-the-loop validatiemodel, richt Aquila zich op het leveren van betrouwbare inzichten voor populatiegezondheidsbeheer, anomaliedetectie en real-time besluitvorming, in plaats van alleen te vertrouwen op ondoorzichtige AI-systemen. Dit positioneert het bedrijf op het snijvlak van gegevensinfrastructuur en toegepaste AI, waar het verbeteren van de gegevenskwaliteit en -toegankelijkheid essentieel is om het volledige potentieel van gezondheidsinformatie te ontsluiten.
U heeft CyncHealth door een enorme groei geleid, waarbij u de interoperabiliteit over miljoenen patiëntrecords en meerdere staten hebt uitgebreid, voordat u Aquila Health oprichtte. Wat waren de belangrijkste beperkingen of systemische fouten die u tijdens die reis tegenkwam en die u uiteindelijk ertoe brachten om Aquila van de grond af aan te bouwen?
Bij CyncHealth hebben we jarenlang gewerkt aan het bouwen van de infrastructuur om gezondheidsorganisaties in Nebraska en Iowa te verbinden. We hebben meer dan 1.100 zorglocaties en miljoenen patiëntrecords verbonden, waarmee we een populatie van meer dan vijf miljoen levens bereikten.
Wat we echter steeds weer tegenkwamen, was dat het verbinden van systemen en het daadwerkelijk maken van de gegevens bruikbaar twee heel verschillende problemen zijn. Zo werkten we bijvoorbeeld aan een dashboard voor een overdosis aan opioiden dat gegevens coördineerde die we van meerdere bronnen ontvingen. Het duurde maanden met honderden FTE-uren en coördinatie over veel belanghebbenden om deze enkele gegevenspunten begrijpelijk te maken in een publieke gezondheids- en gezondheidszorgcontext. En na al die moeite was het beeld nog steeds onvolledig.
Die ervaring was de kiem voor Aquila. De traditionele manier van het verbinden van interfaces zonder te begrijpen of de gegevens compleet en van hoge kwaliteit zijn, zal de behoefte niet vervullen met de vooruitgang in AI die we de afgelopen jaren hebben gezien. Wanneer AI in enkele uren kan bereiken wat eerder maanden duurde en het met een hogere kwaliteit en tegen een fractie van de kosten kan doen, moet u die kennis gebruiken om opnieuw te bouwen vanuit een nieuwe basis. Dat is wat we met Aquila hebben gedaan; we richten ons op moderne instrumenten die de kosten van het verbinden verlagen, zodat we ons kunnen concentreren op het voltooien van het hele beeld van de gezondheid – niet alleen gegevens die afkomstig zijn van traditionele EHI-bronnen, maar het hele beeld.
Aquila is onlangs uit de stealth-mode gekomen met een platform dat zich richt op het verenigen van gefragmenteerde gezondheidsgegevens in een enkele, AI-klare laag. Wat waren de kerntechnische doorbraken die dit mogelijk maakten, in tegenstelling tot een paar jaar geleden?
AI-mogelijkheden hebben deze verschuiving bijna geheel aangedreven.
Ik heb jarenlang naar ervaren ingenieurs gekeken die handmatig gegevensnormen verzoenden, één bron tegelijk. Het werkte, maar dat model kan nooit schalen. U kunt niet snel genoeg inhuren om bij te blijven met het volume en de variëteit van gegevens die de gezondheidszorg genereert.
Wat nu anders is, is dat AI het normalisatiewerk continu kan doen op het gegevensniveau, terwijl informatie door het systeem stroomt. Het is geen batchproces dat ‘s nachts wordt uitgevoerd. Het gebeurt in bijna realtime. Dat verandert wat mogelijk is voor clinici en openbare gezondheidsteams, omdat de gegevens die ze nodig hebben, gestructureerd en gevalideerd zijn (bruikbaar gemaakt) voordat ze bij hen aankomen.
Clinici zijn gewend om beslissingen te nemen zonder het volledige beeld van de patiënt. Openbare gezondheid is gewend om programma’s te stimuleren zonder recente gegevens om het te ondersteunen. Aquila verandert het landschap en biedt de snelheid die effectieve, op gegevens gebaseerde besluitvorming mogelijk maakt in de hele gezondheidszorg.
We hebben TREUE™ gebouwd als het kader dat EHR-gegevens, laboratoriumgegevens, openbare gezondheidsgegevens, claimsgegevens, farmaceutische gegevens en sociale gegevens in een uniforme structuur organiseert. De AI vervangt geen goede gegevensbeheer; het maakt goede gegevensbeheer voor het eerst schaalbaar.
U heeft benadrukt dat de echte uitdaging in de gezondheidszorg-AI niet de modellen zijn, maar de gegevens zelf. Wat zijn de meest kritieke lacunes in de huidige gezondheidsgegevensinfrastructuur die voorkomen dat AI betekenisvolle resultaten oplevert?
De industrie praat over het AI-model, maar het model is niet het moeilijke deel.
Het moeilijke deel is dat een patiënt op één dag drie verschillende faciliteiten kan bezoeken en als drie verschillende personen in drie verschillende systemen kan verschijnen. De labresultaten komen niet overeen met de klinische notities. De verzekeraar heeft een andere identificatie dan het ziekenhuisrecord en de openbare gezondheid gebruikt een geheel andere identificatie. Als u al die informatie handmatig sorteert, is het klinische venster al gesloten.
Sterke technische verbindingen kunnen onvolledige of ongeordende records niet repareren. AI kan geen patroon detecteren dat niet in de gegevens zit, en het kan geen betrouwbare aanbeveling doen vanuit een record dat ontbreekt aan de helft van de historische of huidige informatie die het zou moeten bevatten.
De lacune is niet de verwerkingskracht, maar het vertrouwen in de onderliggende gegevens. Dat is wat eerst moet worden opgelost, en oplossingen op schaal zijn waar AI zijn plaats kan verdienen.
Aquila positioneert zich als de “gegevensvoorbereidingslaag” vóór AI-inname. Kunt u ons doorlopen wat die laag eigenlijk doet in de praktijk, vooral bij het omgaan met zeer heterogene ingangen zoals klinische records, claimsgegevens en real-time feeds?
Laten we het voorbeeld uit het vorige antwoord gebruiken. Wanneer een patiënt een ontmoeting heeft, worden gegevens gegenereerd. U krijgt een HL7-bericht van het ziekenhuis, een claimsrecord van de verzekeraar, een labresultaat van een referentielaboratorium met een andere identificatie en een openbaar gezondheidsrapport dat op een geheel andere tijdschaal is ingediend. Niets hiervan was ontworpen om met elkaar te worden verzoend.
Onze voorbereidingslaag, TREUE™, is wat tussen die ingangen en elke downstream-analyse of AI-toepassing zit. De taak is om elke record te evalueren zodra deze aankomt, identiteiten over bronnen heen te matchen, formaten te normaliseren en aan te geven wat ontbreekt of inconsistent is voordat de gegevens verder gaan.
In de praktijk betekent dit dat een clinici die naar een patiënt kijken, werken met een record dat is gevalideerd en uitgelijnd over bronnen heen, in plaats van handmatig vier verschillende systeemweergaven te verzoenen tijdens een zorgverlening. Voor openbare gezondheidsteams betekent dit dat uitbraaksignalen niet worden vertraagd door gegevens die in verschillende formaten vanuit verschillende rechtsgebieden zijn aangekomen.
Het is infrastructuurwerk. Het is niet glamoureus, maar niets downstream werkt zonder het.
Interoperabiliteitsnormen zoals Fast Healthcare Interoperability Resources (FHIR) en United States Core Data for Interoperability (USCDI) bestaan al jaren, maar fragmentatie blijft bestaan. Wat ontbreekt er nog aan vanuit een normenperspectief, en hoe adresseert Aquila deze lacunes op een andere manier?
FHIR en USCDI gaven de industrie een gedeelde taal voor het uitwisselen van gegevens. Dat was belangrijke vooruitgang.
Hier is de lacune: gezondheidsgegevens komen niet uit één domein. Klinische systemen, openbare gezondheidsregisters, laboratoriumgegevens en sociale gegevensbronnen hebben allemaal hun eigen governance-eisen, tijdslijnen en definities van wat een veld betekent. FHIR vertelt u niet hoe u een sociale determinanten-dataset met een klinisch record van een andere rechtsgebied verzoent.
Wat TREUE™ toevoegt, is een uniform kader voor hoe gegevens uit al die domeinen kunnen worden georganiseerd en gevalideerd, terwijl nog steeds de governance-regels worden gerespecteerd die van toepassing zijn op elke bron. Het resultaat is gegevens die daadwerkelijk kunnen worden geanalyseerd over domeinen heen, niet alleen gegevens die met succes zijn overgedragen.
Aquila werkt in omgevingen met hoge gevolgen waar falen geen optie is. Hoe ontwerpt u AI-systemen die real-time prestaties in evenwicht brengen met strikte eisen rond governance, controleerbaarheid en vertrouwen?
U moet governance in de architectuur opnemen voordat u de eerste regel toepassingscode schrijft. Het moet geen laag zijn die u later toevoegt.
In gezondheids- en overheidsomgevingen hebben de beslissingen die door deze gegevens worden geïnformeerd, invloed op de zorgverlening, de respons op uitbraken en hoe overheidsmiddelen worden toegewezen. Elke actie op de gegevens moet traceerbaar zijn, en toegang moet strikt worden gecontroleerd. Het systeem moet voldoen aan de nalevingsvereisten van de omgevingen waarin het werkt.
Voor Aquila betekent dit dat we werken binnen een overheidsklasse-cloudinfrastructuur, zero-trust-toegangscontroles en beveiligingspraktijken die zijn uitgelijnd met HIPAA en federale normen. We hebben actieve contracten met staatsregeringen, federale agentschappen en gezondheidsorganisaties, en die omgevingen hebben heel verschillende nalevingsvereisten die het platform gelijktijdig moet nakomen.
Het human-in-the-loop-component is net zo belangrijk. AI kan signalen naar voren brengen, maar klinische experts valideren anomalieën voordat ze operationele beslissingen informeren. De technologie maakt het vinden van die signalen sneller. Het vervangt niet de oordeel van de mensen die op basis daarvan moeten handelen.
Uw platform ondersteunt beveiligde, on-device AI-implementatie en gegevenssoevereiniteit. Hoe belangrijk wordt decentralisatie in de gezondheidszorg-AI, gezien de groeiende zorgen rond gegevensprivacy en regelgevingsconformiteit?
Het wordt essentieel, en ik denk dat de industrie nog maar net begint te beseffen waarom.
Gezondheidsorganisaties opereren onder strikte privacyverplichtingen. Gevoelige patiëntgegevens kunnen niet eenvoudig worden gecentraliseerd en verwerkt in een gedeelde omgeving. Verschillende staten hebben verschillende regels. Federale agentschappen hebben andere regels. Internationale gezondheidsgegevens hebben nog een andere set beperkingen. Elke architectuur die het verplaatsen van gevoelige gegevens naar een centrale locatie vereist, zal tegen die muren aanlopen.
De richting die werkt, is inzichten genereren dichter bij waar de gegevens al wonen. Organisaties kunnen bijdragen aan gedeelde analyse zonder de controle over hun onderliggende gegevens te verliezen. Dat is wat gefedereerde modellen toelaten.
Ons platform is ontworpen om te werken in een dergelijke gereguleerde, gedecentraliseerde omgeving – governance die met de gegevens reist in plaats van op één punt te worden toegepast. Het is een moeilijker architectuur om te bouwen, maar het is de enige die compatibel is met hoe gezondheidsgegevensgovernance in de praktijk werkt.
Veel AI-startups leunen zwaar op black-box-modellen, maar Aquila incorporeert human-in-the-loop validatie. Waar ligt de grens tussen automatisering en human-toezicht in klinische AI-systemen?
Ik begon mijn carrière als verpleegster. Die ervaring vormt hoe ik denk over waar AI in een klinische setting thuishoort en waar het niet thuishoort.
AI is zeer goed in het vinden van patronen in grote datasets. Het is niet goed in het weten wat een patroon betekent voor een specifieke patiënt met een specifieke geschiedenis in een specifieke gemeenschapscontext. Dat is nog steeds een menselijke oordeelsvorming.
De juiste rol voor AI in klinische systemen is om signalen naar voren te brengen die een mens zou kunnen missen in volume, niet om de klinische redenering te vervangen die volgt. Bij Aquila gaan anomalieën en inzichten die door het systeem worden gesignaleerd naar clinici en domeinexperts voor beoordeling voordat ze operationele beslissingen informeren. De technologie vertelt u waar u moet kijken, en de professional vertelt u wat het betekent.
Waar ik denk dat de grens hoort: automatiseer de detectie, houd de interpretatie bij de mensen die verantwoordelijk zijn voor het resultaat.
Aquila werkt op het gebied van openbare gezondheid, overheidsstelsels en gereguleerde industrieën. Hoe verschillen de eisen voor AI-infrastructuur tussen deze omgevingen en traditionele ondernemings-AI-implementaties?
In een typische ondernemings-AI-implementatie werkt u meestal binnen één organisatorische gegevensomgeving, één set governance-regels, één compliance-kader.
Openbare gezondheid en overheidsomgevingen zijn structureel anders. U coördineert over meerdere rechtsgebieden, meerdere agentschappen, meerdere klinische omgevingen, elk opererend op verschillende rapportagetijdslijnen en onder verschillende wettelijke kaders. Een ziekenhuis in één staat, een openbaar gezondheidsagentschap in een andere staat, een federaal programma met zijn eigen gegevensvereisten. Al deze moeten gegevens uitwisselen en inzichten genereren zonder dat één entiteit ongecontroleerde toegang tot de records van een andere heeft.
De infrastructuur moet hoge volumes verwerken terwijl strikte controleerbaarheid over al die grenzen heen wordt gehandhaafd. Het moet integreren met legacy-gezondheidsberichtgevingsformaten, omdat die systemen niet zullen verdwijnen. En het moet betrouwbaar werken in omgevingen waar downtime niet alleen een bedrijfsprobleem is, maar een patiëntveiligheidsprobleem.
Die complexiteit is waarom we Aquila zijn begonnen met die omgevingen in plaats van de traditionele ondernemingsmarkt. Als u infrastructuur kunt bouwen die hier werkt, werkt het overal.
AI-mogelijkheden blijven sneller vooruitgaan dan governance-kaders. Wat zijn de verantwoordelijkheden van oprichters en platformbouwers om ervoor te zorgen dat deze systemen vanaf de eerste dag ethisch en veilig worden ingezet?
Ik denk dat de verantwoordelijkheid eenvoudig is, zelfs als het nakomen ervan niet eenvoudig is. Als u AI bouwt die klinische beslissingen of openbare gezondheidsresultaten beïnvloedt, kunt u governance niet behandelen als een productroadmap-item dat u uiteindelijk zal bereiken. Het moet vanaf het begin worden ontworpen.
Wat dit in de praktijk betekent, is dat elke actie op de gegevens controleerbaar moet zijn. De modellen moeten interpreteerbaar genoeg zijn zodat een clinici kan begrijpen waarom een signaal werd gesignaleerd. Clinici moeten deel uitmaken van het beoordelingsproces, niet een naderhand. En de organisatie moet eerlijk zijn over wat het systeem wel en niet betrouwbaar kan doen.
Ik heb mijn carrière doorgebracht in omgevingen waar gegevensfouten echte gevolgen hebben voor echte mensen. Dat vormt hoe ik hierover denk. De mogelijkheden ontwikkelen zich snel, en de verantwoordelijkheid voor hoe ze worden ingezet, kan niet worden toegestaan om achter te blijven. Oprichters die deze systemen bouwen, moeten die standaard voor zichzelf hanteren, in plaats van te wachten tot regelgeving het oplegt.
Bedankt voor het inzichtelijke gesprek. Lezers die geïnteresseerd zijn in het onderzoeken van het platform en de aanpak van gezondheidsgegevensinfrastructuur, kunnen meer te weten komen door Aquila Health te bezoeken.




