
Beste
10 beste AI-webscrapingtools (november 2026)

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
Unite.AI kan een vergoeding ontvangen wanneer u links naar beoordeelde producten gebruikt. Dit beïnvloedt onze redactionele beoordelingen niet. Lees onze affiliateverklaring.
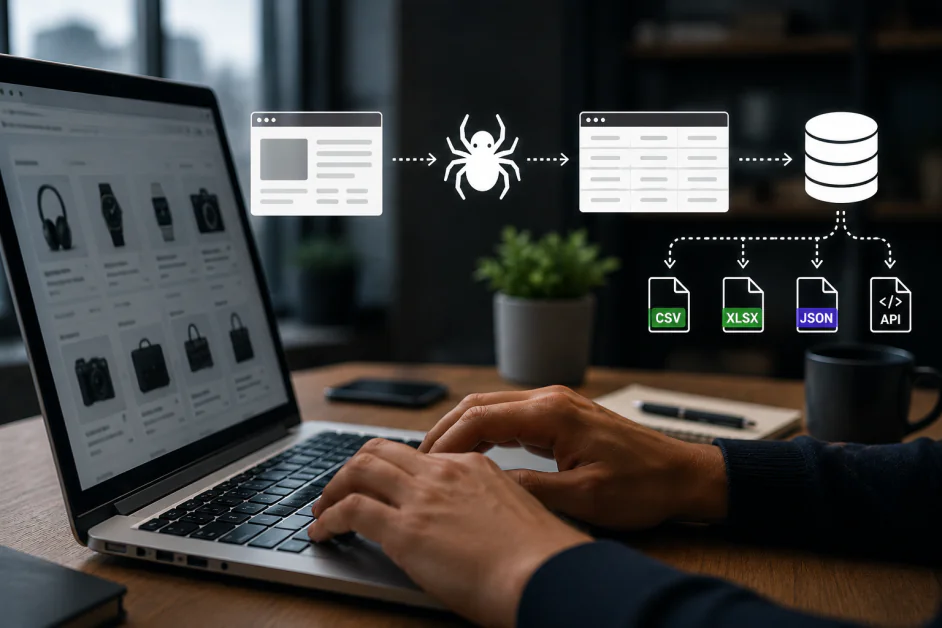
Welke AI-webscrapingtool het beste is, hangt af van wat je wilt doen nadat een pagina is geladen. Een onderzoeksassistent heeft leesbare inhoud en links naar bronnen nodig. Een marktonventiesysteem heeft consistente gegevens op grote schaal nodig. Een interactieve agent heeft mogelijk een browser nodig die meerdere stappen kan doorlopen en de sessie actief kan houden.
Deze gids behandelt tien tools voor die verschillende toepassingen, waaronder platforms voor gegevensverzameling voor bedrijven, content-API’s, scrapers zonder code, zoekgegevensdiensten en beheerde browsers. We beoordelen hoe elk product informatie verzamelt, wie de workflow kan onderhouden en welke afwegingen van belang zijn wanneer een prototype uitgroeit tot een terugkerend proces.
Ons team heeft elke oplossing in deze gids onafhankelijk beoordeeld. Daarbij keken we naar de mogelijkheden, praktische pluspunten, beperkingen en geschiktheid voor de toepassingen waarop onze rangschikking is gebaseerd.
De beste AI-webscrapingtools vergeleken
| AI-tool | Geschikt voor | Belangrijkste pluspunten |
|---|---|---|
| Bright Data | Gegevensverzameling voor bedrijven en uiteenlopende datapijplijnen | Scraper-API’s, Browser API, Scraper Studio, datasets, proxy’s |
| Firecrawl | Webinhoud voor AI-toepassingen | Zoeken, scrapen, in kaart brengen, crawlen, Markdown, JSON, interactie, MCP |
| Apify | Herbruikbare scrapingopdrachten en orkestratie in de cloud | Actors, Crawlee, planningen, opslag, proxy’s, API’s, MCP |
| Browse AI | Gegevensverzameling zonder code en wijzigingen volgen | AI-ondersteunde configuratie, robots, meldingen, planningen, integraties |
| SearchAPI | Gestructureerde zoekresultaten en gelokaliseerd onderzoek | Google, Maps, winkelen, video, AI-zoekomgevingen, JSON |
| Octoparse | Visueel scrapen met herhaalbare uitvoering in de cloud | Sjablonen, AI Assistant, automatische detectie, cloudruns, exports |
| Browserless | Beheerde browsers voor Puppeteer en Playwright | Gehoste browsers, permanente sessies, REST-API’s, MCP |
| ScrapingBee | Beheerde extractie via een API voor applicaties | AI-extractie, CSS/XPath, Markdown, JS-scenario’s, MCP |
| Oxylabs | Beheerde gegevensverzameling van veeleisende openbare websites | Web API /Scrape, rendering, gestructureerde uitvoer, MCP |
| Diffbot | Automatische extractie en informatie over entiteiten | Extract, standaardschema’s, Crawl, Knowledge Graph |
Een AI-webscrapingtool kiezen
Stem de tool af op de taak
Geef voor een AI-kennisbank prioriteit aan leesbare tekst, gestructureerde uitvoer en het behouden van URL’s naar de bronnen. Bij herhaalbaar bedrijfsonderzoek kunnen een visuele robot en meldingen over wijzigingen belangrijker zijn dan een programmeerinterface. Let bij een interactieve agent op sessiecontinuïteit en browserbesturing. API’s voor zoekresultaten lossen een ander probleem op: ze leveren zoekgegevens, terwijl het verzamelen van de gekoppelde pagina’s een aparte stap is.
Bepaal wie verantwoordelijk is voor de workflow
Met een platform zonder code kan een analist de extractiestappen rechtstreeks aanpassen. Een API biedt ontwikkelaars een overzichtelijke interface om gegevensverzameling in een applicatie te integreren. Een cloudplatform voor opdrachten voegt planning en opslag toe, terwijl bij een beheerde browser meer van de automatiseringslogica bij je team blijft. De juiste keuze legt het onderhoud in handen van de mensen die zowel de bronwebsites als de gewenste uitvoer begrijpen.
Begroot op basis van bruikbare gegevens, niet van indrukwekkende aantallen verzoeken
Vergelijk de kosten van een voltooide opdracht met de velden die je nodig hebt. Rendering, premiumproxy’s, de gebruiksduur van de browser, AI-extractie, opslag en herhaalde pogingen kunnen de totale kosten veranderen. Een gratis tegoed, een browsereenheid en een zoekopdracht zijn verschillende meeteenheden. Houd bij terugkerend werk naast succesvolle reacties ook de volledigheid, dubbele gegevens, actualiteit en kosten per bruikbaar gegeven bij.
10 beste AI-webscrapingtools
1. Bright Data
Bright Data is onze algemene aanbeveling voor organisaties die binnen één platform op meerdere manieren webgegevens willen verzamelen. Het aanbod omvat kant-en-klare Scraper-API’s, vooraf verzamelde datasets, Scraper Studio, Web Unlocker en proxydiensten. Een team dat bijvoorbeeld marktinformatie over e-commerce verzamelt, kan gestructureerde feeds gebruiken voor bekende retailers en tegelijkertijd aangepaste gegevensverzameling opzetten voor een gespecialiseerde marktplaats. Dankzij die brede mogelijkheden is het platform bijzonder nuttig wanneer het gegevensprogramma zich uitstrekt tot meer dan één website of afdeling.
Voor interactieve pagina’s biedt Browser API gehoste browsers die ontwikkelaars kunnen aansturen met Puppeteer, Playwright of Selenium. De API combineert browseruitvoering met proxybeheer en CAPTCHA-afhandeling. Dankzij ondersteuning voor Chrome DevTools kunnen technici bovendien een problematische sessie inspecteren. Dit is waardevol wanneer een workflow eerst navigatie of interactie met een pagina vereist voordat de gewenste informatie beschikbaar komt, in plaats van simpelweg een bestaande dataset te downloaden.
De belangrijkste afweging betreft de keuze van producten en het beheer van de kosten. Browserverkeer, scrapingresultaten en de aankoop van datasets vertegenwoordigen verschillende soorten gebruik, waardoor één algemene prijs niet het hele platform kan beschrijven. Bright Data is geschikt voor teams die iemand verantwoordelijk kunnen maken voor de kwaliteit van de verzameling, de dekking van doelbronnen en de uitgaven. Een project met een beperkte scope kan met een eenvoudigere extractie-API sneller in productie gaan.
Voor- en nadelen
- Uitgebreide mogelijkheden voor gegevensverzameling binnen één platform
- Gehoste browsers ondersteunen gangbare automatiseringsbibliotheken
- Kant-en-klare API’s en datasets verkorten de implementatietijd
- Voor verschillende producten is afzonderlijke kostenplanning nodig
- Voor aangepaste pipelines blijft technisch beheer nodig
2. Firecrawl
Firecrawl is onze keuze voor ontwikkelaars die webcontent willen omzetten in bruikbare context voor een AI-toepassing. De zoek-, scrape-, map- en crawltools ondersteunen het hele traject, van het vinden van een pagina tot het verzamelen van gegevens van een website. Markdown en gestructureerde JSON beperken de opschoning die na het ophalen nodig is. Zo kan een onderzoeksassistent of kennisbankproduct meer tijd besteden aan het beantwoorden van vragen en minder aan het verwijderen van navigatiemenu’s uit ruwe HTML.
De huidige Interact-functionaliteit breidt het platform uit met live browserwerk. Agents kunnen acties in natuurlijke taal beschrijven of browsercode uitvoeren, de status tussen aanroepen behouden en geverifieerde profielen opnieuw gebruiken. Dat is een waardevolle aanvulling voor pagina’s waarvoor klikken, filters of een login nodig zijn voordat gegevens kunnen worden opgehaald. Toegang via MCP en de opdrachtregel maakt Firecrawl bovendien geschikt voor ontwikkelworkflows met agents, en niet alleen als traditionele API voor toepassingen.
Firecrawl komt het best tot zijn recht wanneer het verzamelen van content het directe probleem is en de toepassing opslag en ophalen al zelf regelt. Teams moeten nog steeds de grenzen van crawls bepalen, bron-URL’s bewaren en onderscheid maken tussen een ontbrekend veld en een leeg veld. De opensourcecode biedt een extra implementatiemogelijkheid, maar teams moeten de specifieke functies en operationele vereisten van de gekozen implementatie beoordelen in plaats van ervan uit te gaan dat gehoste en zelf beheerde versies identiek zijn.
Voor- en nadelen
- Markdown en JSON zijn geschikt voor AI-pipelines
- Interact ondersteunt browseropdrachten waarbij de status behouden blijft
- Toegang via API, MCP en CLI
- Opgehaalde content moet nog steeds worden gecontroleerd
- Zelfbeheer van implementaties brengt operationeel werk met zich mee
3. Apify
Apify is hier de beste keuze voor teams die herbruikbare scrapingtools en een platform om die te beheren zoeken. Via de marktplaats worden Actors aangeboden: kant-en-klare programma’s die invoer verwerken, in de cloud draaien en resultaten teruggeven. Bestaande Actors kunnen veelvoorkomende verzameltaken versnellen, terwijl ontwikkelaars met aangepaste Actors hun eigen extractielogica kunnen behouden. Daardoor vormt Apify een handige brug tussen een experiment en een herhaalbare productietaak.
Het platform biedt ook belangrijke operationele functies, zoals planning, opslag van resultaten, toegang tot proxy’s, monitoring en integraties. Ontwikkelaars kunnen ook bouwen met Crawlee, de opensourcebibliotheek voor crawlen en browserautomatisering. De MCP-server van Apify maakt Actors beschikbaar voor AI-agents. Zo kan hetzelfde kant-en-klare hulpmiddel worden gebruikt voor een toepassing, een geplande pipeline of een assistent, zonder voor elke interface een aparte scraper te hoeven ontwikkelen.
De keuze van een Actor verdient evenveel aandacht als de keuze van een platform. Verschillende aanbieders kunnen uiteenlopende prijzen, onderhoudsvereisten, invoermogelijkheden en uitvoerkwaliteit hanteren. Een geslaagde uitvoering betekent bovendien niet dat alle verwachte records zijn verzameld. Apify is vooral aantrekkelijk wanneer iemand verantwoordelijk is voor het schema van de taak, wijzigingen in de gaten houdt en budget reserveert voor de gekozen Actor en het infrastructuurgebruik. Voor een handmatige extractie van één pagina is zo’n uitgebreide orkestratie zelden nodig.
Voor- en nadelen
- Kant-en-klare en aangepaste Actors delen hetzelfde platform
- Planning, opslag en monitoring ondersteunen herhaalbare taken
- MCP maakt Actors beschikbaar in workflows met agents
- Onderhoud en kwaliteit van Actors lopen uiteen
- Voor gebruik en Actors zijn budgetten nodig
4. Browse AI
Browse AI is onze aanbeveling voor zakelijke gebruikers die regelmatig webgegevens nodig hebben zonder een softwareproject op te zetten. De huidige configuratie kan een aangeleverde pagina uitlezen, een gegevensstructuur voorstellen en de gebruiker de velden laten controleren of aanpassen. Het trainen van robots blijft essentieel voor herhaalbare extractie. Dit is een praktische aanpak voor operationele en marketingteams die productvermeldingen, adresboekvermeldingen of informatie over concurrenten verzamelen in vertrouwde tabellen.
Monitoring is een bijzonder sterk punt. Robots kunnen pagina’s volgens een schema controleren, toevoegingen of wijzigingen herkennen en meldingen versturen waarin staat wat er is veranderd. Workflows kunnen het verzamelen van gegevens op meerdere pagina’s met elkaar verbinden, terwijl integraties met API’s, webhooks en spreadsheets ervoor zorgen dat de resultaten terechtkomen in de tools die een team al gebruikt. Zo kan een workflow voor prijsmonitoring uitgroeien tot een doorlopend bedrijfsproces in plaats van een reeks handmatige browsercontroles.
De laagdrempeligheid neemt niet weg dat een duidelijke definitie van de gegevens nodig is. Gebruikers moeten bepalen welke wijzigingen een melding verdienen en controleren of paginering, inlogstappen en lege resultaten correct worden afgehandeld. Bij ingrijpende herontwerpen kan nog steeds handmatig ingrijpen nodig zijn. Browse AI is het meest geschikt wanneer een bedrijfsteam de geëxtraheerde rijen kan controleren en de robot kan onderhouden; ontwikkelaars die browserlogica strikt versiebeheerbaar willen houden, geven mogelijk de voorkeur aan een dienst op basis van code.
Voordelen en nadelen
- AI-ondersteunde veldconfiguratie verlaagt de instapdrempel
- Geplande monitoring brengt betekenisvolle wijzigingen aan het licht
- Koppelingen met spreadsheets, API’s en webhooks
- Bij grote wijzigingen aan websites kan hertraining nodig zijn
- Voor complexe logica is een zorgvuldig ontworpen workflow nodig
5. SearchAPI
SearchAPI is onze specialistische aanbeveling voor het verzamelen van zoekresultaten als gestructureerde gegevens. De Google API kan links naar resultaten en zoekfuncties als JSON retourneren, zodat het niet nodig is een parser te onderhouden voor een veranderende resultatenpagina. De bredere catalogus omvat bronnen zoals Maps, winkelen, nieuws, video en ondersteunde AI-zoekervaringen. De tool is vooral nuttig wanneer ontdekking en zichtbaarheid in zoekmachines het gegevensproduct vormen, en niet slechts een opstap zijn naar het crawlen van een andere website.
Lokalisatie is een belangrijk onderdeel van die geschiktheid. Met parameters voor locatie, land, taal en apparaat kunnen teams een markt onderzoeken vanuit een afgebakende zoekcontext. Een SEO-toepassing kan een zoekopdracht in één stad volgen, terwijl een onderzoeksassistent relevante bronnen kan vinden en de geretourneerde links kan bewaren om ze later op te halen. Documentatie per zoekmachine is belangrijk, omdat de beschikbare parameters en resultaatvelden per zoekproduct verschillen.
Kies SearchAPI op basis van de zoekmachines en velden die een workflow daadwerkelijk nodig heeft. Een zoekresultaat bevat niet de volledige inhoud van de gelinkte pagina, en rijkere resultaatweergaven volgen niet allemaal hetzelfde schema. Teams moeten rekening houden met het aantal verzoeken, nagaan of de verwerkingscapaciteit aan de vereisten voldoet en ontbrekende resultaatonderdelen op een goede manier afhandelen. Voor het extraheren van gegevens van willekeurige websites of een interactieve browsersessie is een andere tool in deze gids een beter uitgangspunt.
Voordelen en nadelen
- Gestructureerde resultaten maken onderhoud van SERP-parsers overbodig
- Brede catalogus van zoekmachines en aanverwante engines
- Uitgebreide instellingen voor lokalisatie
- Zoekresultaten vervangen niet het extraheren van gegevens van de bestemmingspagina
- Velden en parameters verschillen per zoekmachine
6. Octoparse
Octoparse laat zijn AI Copilot en mens-in-de-lus-automatisering zien. Video: Octoparse.
Octoparse is een goede keuze voor analisten die visueel een scraper willen ontwerpen en deze vervolgens herhaaldelijk willen uitvoeren. Het huidige platform biedt kant-en-klare sjablonen, configuratie met AI Assistant en automatische paginadetectie in de desktopapplicatie. Gebruikers kunnen de resulterende taak verfijnen in plaats van met browsercode te beginnen. Die flexibiliteit is handig voor het verzamelen van productcatalogi, adresboeken of vermeldingen, waarbij de volgorde van de pagina’s net zo belangrijk is als de velden op elke pagina.
Uitvoering in de cloud maakt van een voorbereide taak een terugkerend verzamelproces, zonder dat een eigen computer ingeschakeld hoeft te blijven. Planning, parallelle verwerking, IP-rotatie en exportkoppelingen helpen grotere opdrachten verder te brengen dan een desktopprototype. De visuele aanpak is vooral aantrekkelijk voor teams die hun bronwebsites en gegevensvereisten kennen, maar geen eigen browserautomatiseringsdienst willen onderhouden.
Bij Octoparse loont het nog steeds om taken zorgvuldig te ontwerpen. Paginering, oneindig scrollen, formulierstappen en dubbele records kunnen de betekenis veranderen van een uitvoering die op het eerste gezicht geslaagd lijkt. De cloudlimieten en functies van het abonnement moeten aansluiten op het beoogde schema en volume. We bevelen Octoparse aan wanneer een team meer controle wil over de extractiestappen dan een snelle tool met één klik biedt, en iemand expliciet verantwoordelijk is voor het aanpassen van de taak wanneer bronpagina’s veranderen.
Voordelen en nadelen
- Sjablonen en AI-ondersteuning vereenvoudigen de configuratie
- Visuele bewerking biedt ondersteuning voor gedetailleerde extractietaken
- Uitvoeringen in de cloud ondersteunen geplande gegevensverzameling
- Complexe websites vereisen verfijning van de taken
- Cloudfuncties zijn afhankelijk van het gekozen abonnement
7. Browserless
Browserless is onze aanrader voor ontwikkelaars die een browser willen aansturen en de hosting en schaalbaarheid ervan willen overlaten aan een beheerde dienst. Bestaande Puppeteer- of Playwright-scripts kunnen verbinding maken met browsers op afstand, waardoor de dienst aantrekkelijk is voor projecten met werkende automatiseringscode. Dit is vooral nuttig wanneer het verzamelen meerdere interacties omvat, de interface veel JavaScript gebruikt of een sessie langer moet blijven bestaan dan één eenvoudige aanvraag.
De dienst biedt ook REST API’s voor scraping, schermafbeeldingen, pdf’s en aangepaste browserfuncties. De gehoste MCP-server maakt browsertools beschikbaar voor AI-agenten, terwijl sessiefuncties en geauthenticeerde profielen ondersteuning bieden voor workflows die continuïteit vereisen. Browserless is daardoor geschikt voor zowel ontwikkelaars die een eigen gegevensverzamelaar bouwen als agenten die via een echte browser moeten navigeren en informatie verzamelen.
De belangrijkste afweging bij de aanschaf is hoe het browsergebruik wordt afgerekend. Het gratis abonnement omvat momenteel 1.000 eenheden per maand en twee gelijktijdige browsers, niet 1.000 gegarandeerde scrape-opdrachten. Browsergebruik verbruikt eenheden; voor proxyverkeer en het succesvol oplossen van CAPTCHA’s worden extra kosten in rekening gebracht. Sessielimieten verschillen per abonnement. Teams blijven zelf verantwoordelijk voor de extractielogica en controles van de uitvoer. Browserless is dus vooral aantrekkelijk wanneer controle over de browser belangrijker is dan een visuele builder voor robots.
Voor- en nadelen
- Behoudt vertrouwde workflows met Puppeteer en Playwright
- REST API’s bieden mogelijkheden voor scraping en het exporteren van pagina’s
- Sessiefuncties en MCP zijn geschikt voor interactieve agenten
- Browsergebruik en uitbreidingen beïnvloeden het verbruik van eenheden
- Voor aangepaste gegevensextractie is nog steeds applicatielogica nodig
8. ScrapingBee
ScrapingBee is een goede keuze voor ontwikkelaars die een beheerde scrape-aanvraag willen in plaats van directe controle over een browser die langdurig actief blijft. De API combineert het ophalen van pagina’s en het weergeven van JavaScript met proxybeheer. Voor de extractie kunnen CSS- of XPath-regels of AI-instructies worden gebruikt. Die combinatie is nuttig wanneer een project gestructureerde gegevens uit meerdere websites nodig heeft, maar geen eigen browserinfrastructuur wil beheren.
JavaScript-scenario’s kunnen klikken, scrollen, tekst invoeren of wachten voordat de gegevens worden verzameld. De uitvoer in Markdown ondersteunt workflows voor AI-content en schermafbeeldingen helpen de weergegeven pagina vast te leggen. Het huidige product biedt ook afzonderlijke API’s voor geselecteerde doelwebsites, naast toegang via CLI en MCP. Een ontwikkelaar kan expliciete extractieregels gebruiken voor stabiele velden en extractie in natuurlijke taal wanneer de paginastructuur of de vraag minder voorspelbaar is.
Het praktische verschil met een gehost browserplatform is dat ScrapingBee de nadruk legt op de aanvraag en het resultaat dat deze oplevert, terwijl een aangepaste applicatie verantwoordelijk is voor de rest van de taak. De coördinatie van meerdere pagina’s, het verwijderen van dubbele gegevens, verversingsschema’s en de validatie van gegevens vereisen nog steeds een eigen oplossing. Ook varieert het kredietverbruik afhankelijk van de gebruikte functies, waaronder rendering en proxyopties. We raden ScrapingBee aan voor applicatieteams die een eenvoudige HTTP-interface op prijs stellen en de orkestratie van hun datapijplijn in eigen code willen beheren.
Voor- en nadelen
- Selectorregels en AI-extractie bieden flexibiliteit
- Rendering en scenario’s kunnen overweg met interactieve pagina’s
- Markdown, CLI en MCP ondersteunen AI-workflows
- Geavanceerde aanvraagopties verhogen het kredietverbruik
- Voor taken met meerdere pagina’s is nog steeds orkestratie nodig
9. Oxylabs
Oxylabs is een goede keuze voor teams die beheerde toegang willen tot moeilijk bereikbare openbare websites en willen kunnen opschalen naar grotere verzamelvolumes. De huidige Web API omvat een /Scrape-aanbod voor het ophalen en structureren van webgegevens, met JavaScript-rendering en toegangsbeheer geïntegreerd in de dienst. Het productaanbod omvat ook /Search en browserinfrastructuur, zodat teams verschillende methoden kunnen kiezen, afhankelijk van de vraag of een taak begint met het vinden van informatie, het extraheren van gegevens of interactie.
Met opties voor specifieke doelwebsites kunnen veelgebruikte zoek- en handelswebsites bruikbare velden opleveren, terwijl verbindingen met agenten via MCP en Agent Skills het verzamelen van gegevens integreren in AI-workflows. Oxylabs blijft de Classic Web Scraper API ook afzonderlijk documenteren. Dat onderscheid is belangrijk voor bestaande integraties: teams die de Classic API onderhouden, moeten de bijbehorende documentatie gebruiken en er niet van uitgaan dat een voorbeeld voor de nieuwere Web API zonder meer uitwisselbaar is.
Oxylabs is vooral geschikt wanneer de moeilijkheidsgraad van de doelwebsites, de verwerkingscapaciteit of de kosten voor het onderhouden van toegangsbeheer een beheerd platform rechtvaardigen. De applicatie moet nog steeds het gewenste schema, de actualiteitsperiode en de afhandeling van onvolledige gegevens bepalen. Stem vóór de ingebruikname de gekozen API-generatie, opties voor de doelwebsites en het gebruiksmodel af op de daadwerkelijke taak. Voor een kleine handmatige extractie kan een visuele scraper geschikter zijn.
Voor- en nadelen
- Beheerde rendering- en toegangsvoorzieningen
- Doelspecifieke opties voor gestructureerde extractie
- De huidige Web-API ondersteunt integraties met agents
- Voor de klassieke en huidige API’s is een afzonderlijke configuratie nodig
- De kwaliteit van de uitvoer moet nog steeds binnen de applicatie worden gecontroleerd
10. Diffbot
Diffbot is onze keuze wanneer inzicht in de informatie op een pagina belangrijker is dan het nabootsen van de lay-out. Extract gebruikt computervisie en natuurlijke taalverwerking om pagina’s te classificeren en via standaardschema’s gestructureerde JSON te genereren. Voor een team dat artikelen of producten van veel verschillende bronnen verzamelt, kan dat de hoeveelheid sitespecifieke parsercode beperken die nodig is om pagina’s om te zetten in vergelijkbare records.
De Knowledge Graph voorziet in een verwante, maar afzonderlijke behoefte: werken met entiteiten zoals organisaties, personen en artikelen die al op basis van het openbare web zijn samengesteld. Records kunnen informatie uit meerdere bronnen combineren en entiteiten met betekenisvolle relaties aan elkaar koppelen. Daardoor is Diffbot nuttig voor verrijking, bedrijfsonderzoek en toepassingen voor informatievergaring die context nodig hebben naast de velden die op één pagina zichtbaar zijn.
De afweging draait om de aansluiting op het gegevensmodel van Diffbot. Gestandaardiseerde extractie is waardevol wanneer de paginatypen en velden ervan bij de taak passen, maar voor een ongebruikelijk veld of een gespecialiseerde interactie kan een andere aanpak nodig zijn. Teams moeten onderscheid maken tussen het extraheren van zelfgekozen URL’s en het doorzoeken van een bestaande kennisgrafiek, en vervolgens de dekking en actualiteit van de bronnen beoordelen. Diffbot is geschikter voor technische teams die genormaliseerde informatieproducten bouwen dan voor gebruikers die slechts enkele rijen naar een spreadsheet willen kopiëren.
Voor- en nadelen
- Automatische classificatie vermindert het werk aan parsers
- Standaardschema’s helpen vergelijkbare pagina’s te normaliseren
- De Knowledge Graph voegt context over entiteiten toe
- Standaardvelden voldoen mogelijk niet aan specialistische vereisten
- Extractie en toegang tot de kennisgrafiek zijn geschikt voor verschillende werkprocessen
Veelgestelde vragen
Wat maakt een webscrapingtool AI-aangedreven?
AI kan helpen bij het herkennen van velden, het interpreteren van pagina-inhoud, het genereren van extractiestappen of het aansturen van browseracties. Sommige tools gebruiken AI tijdens de configuratie; andere doen dat bij elke extractie. Een dienst kan AI-toepassingen ook ondersteunen door schone inhoud aan te leveren, zonder voor elk verzoek een taalmodel te gebruiken. Kies de functionaliteit die uw verzamelprobleem oplost, in plaats van af te gaan op het label.
Wat is het verschil tussen scraping en browserautomatisering?
Scraping verzamelt informatie. Browserautomatisering voert acties op een pagina uit, zoals menu’s openen, een zoekopdracht invoeren of een meerstapsproces doorlopen. Vaak worden ze samen gebruikt: een geautomatiseerde browser brengt de pagina in de gewenste staat, waarna een extractiestap de velden verzamelt. Een rechtstreeks API-verzoek is doorgaans eenvoudiger wanneer zulke interacties niet nodig zijn.
Welke tools zijn het meest geschikt voor een niet-technisch team?
Browse AI is onze eerste aanbeveling voor eenvoudige, terugkerende gegevensverzameling en het monitoren van wijzigingen. Octoparse is een sterk alternatief wanneer het team meer visuele controle wil over de taakstappen. Beide werken het best wanneer iemand de resulterende records controleert en begrijpt wanneer de bronwebsite is veranderd.
Welke gegevens moet een AI- of RAG-pijplijn uit een scrape bewaren?
Bewaar de bron-URL, het verzamelmoment, de paginatitel en de tekst of gestructureerde velden die de applicatie nodig heeft. Markdown kan de leesbare documentstructuur behouden, terwijl JSON geschikt is voor vastomlijnde records. Verwijder dubbele inhoud en voorkom dat navigatietekst wordt vermengd met de hoofdinhoud. Door de herkomst te bewaren, zijn latere antwoorden gemakkelijker te traceren en bij te werken.
Wanneer is een beheerde browser de moeite waard?
Een beheerde browser is nuttig wanneer gegevensverzameling JavaScript-uitvoering, meerdere interacties of sessiecontinuïteit vereist en uw team geen browserprocessen wil hosten. Browserless is een gespecialiseerde optie voor bestaande Puppeteer- of Playwright-code. Voor één statische pagina verbruikt een eenvoudigere ophaal- of extractie-API mogelijk minder middelen.
Zijn 1.000 gratis eenheden hetzelfde als 1.000 scrapes?
Nee. Elke aanbieder hanteert eigen regels voor eenheden en credits. Browserless rekent browserverbindingen af in blokken van maximaal 30 seconden, waarbij proxyverkeer en het oplossen van CAPTCHA’s extra eenheden kosten. Andere diensten brengen kosten in rekening op basis van aanvraagopties, records of rekenkracht. Maak een schatting van het volledige werkproces in plaats van verschillende gratis tegoeden met elkaar gelijk te stellen.
Kun je een AI-extractieresultaat vertrouwen zonder het te controleren?
Een geldig JSON-antwoord kan nog steeds een record weglaten of een veld verkeerd interpreteren. Leg vast welke velden verplicht zijn, controleer typen en bereiken, bekijk steekproefsgewijs de bronpagina’s en houd wijzigingen in het aantal records bij. Bij terugkerende taken zijn expliciete statussen voor fouten en lege resultaten nuttiger dan elk antwoord als een volledige dataset te behandelen.
Tot slot: AI-tools voor webscraping
Bright Data is onze beste keuze voor een breed programma voor webdata, terwijl Firecrawl het beste startpunt is om webpagina’s om te zetten in content die klaar is voor AI. Kies Apify wanneer herbruikbare tools, geplande taken en cloudactiviteiten centraal staan in het project.
Voor zakelijke teams maakt Browse AI terugkerende monitoring toegankelijk, terwijl Octoparse gebruikers een visuele manier biedt om complexere gegevensextractietaken te verfijnen. SearchAPI is de specialistische keuze wanneer de vereiste uitvoer uit gestructureerde zoekgegevens bestaat.
Browserless is een goede keuze voor ontwikkelaars die browseruitvoering willen uitbesteden en daarbij vertrouwde automatiseringsbibliotheken willen gebruiken. ScrapingBee is een sterk alternatief wanneer een beheerde extractieaanvraag beter bij de toepassing past. Oxylabs is geschikt voor veeleisende gegevensverzameling op het openbare web, terwijl Diffbot uitblinkt in gestandaardiseerde extractie en entiteitsinformatie.
De beste keuze voor de lange termijn is de oplossing die de benodigde informatie oplevert met een workflow die je team kan onderhouden. Stem de verzamelmethode af op de taak, behoud de context van de bron en beoordeel de waarde op basis van bruikbare uitvoer, niet op basis van het aantal opgevraagde pagina’s.




