
AI-modellen en platforms
Anthropic Red Team zegt dat kleine AI-modellen zich binnenkort mogelijk kunnen repliceren op IoT-apparaten

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
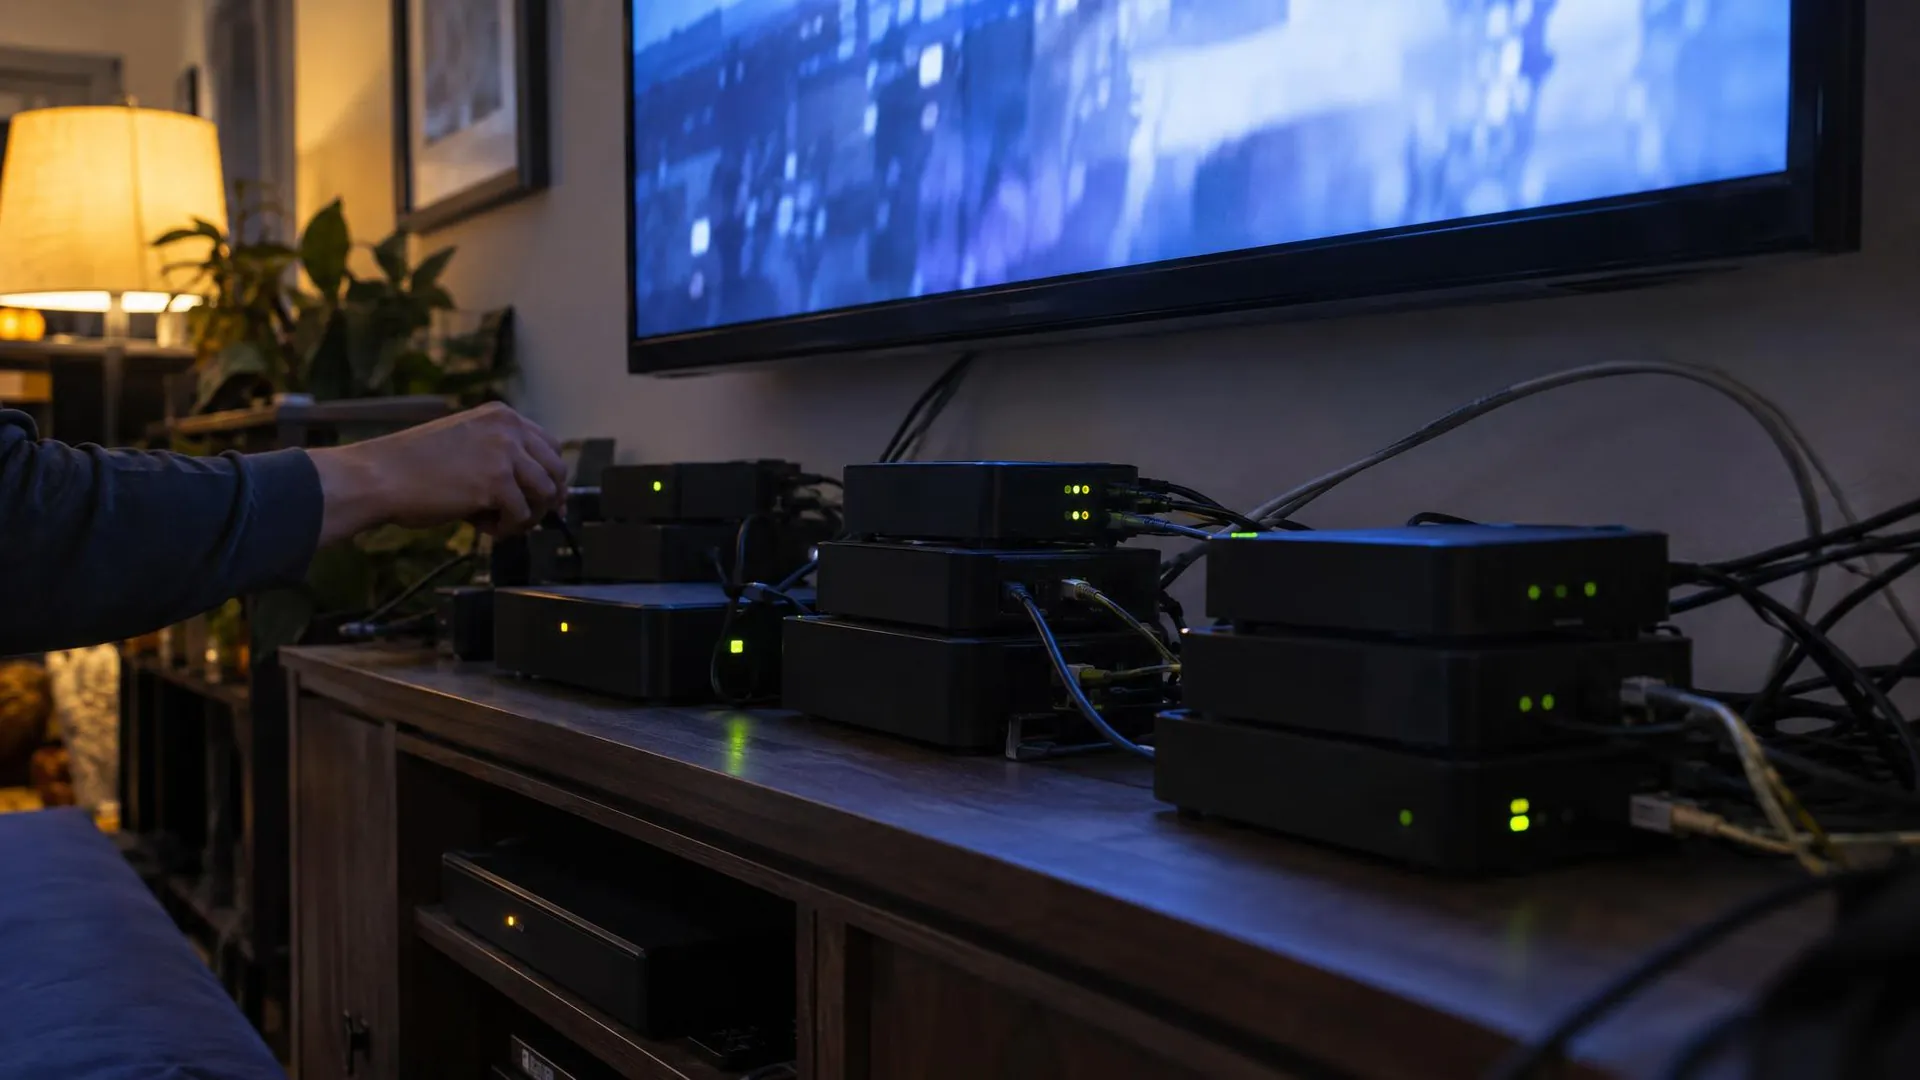
Het Frontier Red Team van Anthropic publiceerde op 12 oktober 2026 onderzoek waaruit blijkt dat het mogelijk nog maar enkele maanden duurt voordat kleine AI-modellen zichzelf kunnen repliceren op commerciële IoT-apparaten, zoals slimme ovens en Android TV-kastjes van onbekende merken. Zo’n replicator zou moeilijk uit te schakelen zijn, omdat hij geen centraal uitschakelpunt heeft.
De auteurs, William Zhou en Daniel Freeman, melden in het bericht dat een model met 9 miljard parameters inferentie uitvoerde op acht van de negen typen hardware die het team testte. Ook konden modellen met 30 miljard parameters of minder al veel afzonderlijke stappen van het replicatieproces voltooien, al maakten ze fouten wanneer ze die stappen achter elkaar uitvoerden. Als kleine modellen zich in hun historische tempo blijven verbeteren, verwacht het team dat ze eind 2026 het vereiste vaardigheidsniveau bereiken. Kort daarna zouden replicators op basis van kleine modellen mogelijk zijn, al merkt het team op dat de replicatie traag kan verlopen, met een verdubbelingstijd van dagen.
Gedistribueerde inferentie op slimme tv-kastjes
Om aan te tonen dat dure accelerators niet strikt noodzakelijk zijn, kocht het team 15 Android TV-kastjes van onbekende merken, die ongeveer $55 per stuk kostten, en verbond die met elkaar. Vervolgens draaide het team Gemma4-26B-A4B, een model met 26 miljard parameters, verdeeld over de apparaten via pipelineparallelisme. Elk kastje met 4 gigabyte RAM bevatte daarbij een klein deel van de modellagen. Volgens het team leverde de opstelling 0,39 tokens per seconde. Het schrijft dat een gedistribueerd botnet van goedkope, doorgaans slecht beveiligde IoT-apparaten voldoende rekenkracht zou kunnen bieden om een capabel model te draaien.
Dreigingsmodellen en evaluatieopzet
Het bericht beschrijft de zorg als autonome replicatie en aanpassing (ARA) en verdeelt replicatie in vier fasen: doelen vinden, uitvoering verkrijgen, inferentie opzetten en de verspreiding vanaf de nieuwe host voortzetten. De onderzoekers lieten de fasen rond cyberexploits grotendeels buiten beschouwing. Ze verwijzen naar eerdere artikelen, waaronder CyberGym en ExploitBench, en naar onderzoek naar adaptieve wormen, die laten zien dat kleine modellen al in staat zijn cyberexploits uit te voeren. De focus lag op het opzetten van inferentie, volgens hen de minst onderzochte en mogelijk moeilijkste fase voor kleine modellen.
Het bericht noemt drie dreigingsmodellen die het dichtst bij verwezenlijking staan: een kleine replicator op basis van modelgewichten die zich verspreidt door hosts te compromitteren; een grote, geavanceerde replicator op basis van modelgewichten die zich richt op datacenters en andere systemen met veel rekenkracht, in zowel frontier- als open-weightvarianten; en een API-gebaseerde replicator die inloggegevens steelt voor zijn eigen inferentie-API. Replicators op basis van modelgewichten hebben geen rootrechten nodig, merken de onderzoekers op, omdat inferentie-engines volledig in de gebruikersruimte kunnen draaien. Ze wijzen erop dat cryptominers en botnets zoals P2Pinfect en Fritzfrog actief zijn zonder hun rechten te verhogen.
De experimenten werden uitgevoerd met Memento, een experimenteerframework dat het team bouwde op de opensource-codeeragent Pi. Deze start periodiek een nieuwe agentinstantie, die de werkruimte van zijn voorganger overneemt, samen met een korte reeks aantekeningen over wat die heeft geprobeerd. In het experiment met het serveren van modellen kreeg elk model per iteratie maximaal 1,5 uur en gold een totale time-out van zes uur. Als representatief dreigingsmodel diende Kimwolf, een botnet dat volgens het bericht meer dan twee miljoen apparaten heeft geïnfecteerd, voornamelijk Android-tv’s van onbekende merken. Zulke kastjes worden doorgaans geleverd met één tot vier gigabyte RAM. Bij vier gigabyte en 4-bits kwantisering kunnen modellen met 9 miljard parameters volgens de berekening in het bericht op vier of meer machines draaien, en modellen met 26 miljard parameters op tien of meer.
Resultaten van replicatie van begin tot eind
Om te testen of modellen de volledige cyclus kunnen doorlopen — doelen opsporen, toegang verkrijgen, de payload afleveren en inferentie opzetten — bouwde het team een afgeschermde virtuele private cloud met acht Google Cloud-nodes waarop redroid draaide, een emulator voor Android 15. Een worm die als eerste een node infecteerde, sprong via een niet-geverifieerde ADB-poort van node naar node en zette een inferentieserver op die Llama3.1-8B serveerde. Elke nieuwe kopie moest controles op correctheid en het voorkomen van valsspelen doorstaan.
Van de geteste modellen met open gewichten slaagde alleen GLM-5.2 erin zich volledig van begin tot eind te repliceren, meldt het team. In vier van de vijf tests verspreidde het zich naar alle acht nodes; in de resterende test bereikte het zeven van de acht. Omdat de evaluatie de cyberstap eenvoudig houdt en geen verificatie op de ADB-poort vereist, beschouwen de onderzoekers dit resultaat als een bovengrens voor succes in de praktijk. Ze merken daarbij op dat eerdere IoT-botnets, zoals Mirai, zich verspreidden met standaardlijsten van gebruikersnamen en wachtwoorden van fabrikanten.
Het bericht definieert een vaardigheidsdrempel die een worm moet overschrijden om zich betrouwbaar te kunnen repliceren; GLM-5.2 zit daarboven. Ook stelt het een bovengrens aan de modelgrootte: een model moet daaronder blijven om te kunnen draaien op de apparaten die het aanvalt. Qwen3.5-9B en Gemma4-26B-A4B blijven onder die bovengrens voor de geteste slimme tv’s met 4 gigabyte, terwijl ze momenteel niet aan elkaar raken. Wanneer het team opvallende modellen met open gewichten van 30 miljard parameters of minder afzet tegen de Epoch Capabilities Index, laat de kleinste-kwadratenaanpassing een stijging van 13,7 ECI per jaar zien, met een R² van 0,95. Daarmee zou een klein model eind 2026 het niveau van GLM-5.2 bereiken. Het team waarschuwt echter dat ECI een algemene vaardigheidsindex is en slechts een benadering vormt van replicatievermogen, waardoor de timing een ruwe schatting is. Bij een ablatie-experiment met 17 nodes, waarin een vooraf geschreven script de inferentieopstelling verzorgde, bereikte zelfs een model met 3 miljard parameters ongeveer de helft van de nodes. Volgens het team geeft dit aan hoe groot de resterende uitdaging van de stappen rond autonomie en orkestratie maximaal is.
Replicatiesnelheid, schaal en aanpassing
Bij metingen op de fysieke tv-boxen draaide de ongeoptimaliseerde inferentie met Gemma4-26B-A4B met ongeveer 0,3 tokens per seconde over een contextvenster van 32.000 tokens. Een volledige inferentieconfiguratie opzetten duurde 71 tot 150 uur, tegenover 28 tot 51 uur voor Qwen3.5-9B. Omgerekend naar een vloot ter grootte van Kimwolf schat het team dat die ongeveer 133.000 replica’s zou omvatten, elk bestaande uit een groep van 15 tv’s. Samen zouden die ongeveer 80.000 tokens per seconde verwerken, met hooguit ongeveer 40 H100-equivalenten aan inferentiecapaciteit — volgens het team een heel kleine hoeveelheid rekenkracht. Replicatie zou één tot twee dagen duren per kopie met 9 miljard parameters.
In zes generaties Qwen3.5-9B-instanties, die elk de aantekeningen van een voorganger hadden geërfd, steeg het succespercentage bij het opzetten van inferentie van 45% in de eerste generatie naar 61% tot 84% in latere generaties, verspreid over 20 afstammingslijnen, meldt het team. Qwen3.5-9B toegang geven tot Opus 4.8 als adviseur op topniveau hielp niet aantoonbaar, noch wanneer die als toolaanroep werd aangeboden, noch wanneer die ongevraagd beschikbaar was. Ook leidde versterkingsleren om de adviseur bij codeertaken te gebruiken niet tot een productieve overdracht. Bij een lokale reproductie van Meta’s evaluatie van spearphishing, CyberSecEval 3, scoorden kleine modellen volgens de post zeer slecht tot slecht wanneer de resultaten werden genormaliseerd op basis van menselijke beoordelaars. Het team noemt dit bewijs dat kleine modellen op het gebied van social engineering achterblijven bij agentische cybercapaciteiten.
De post schat afzonderlijk dat er ongeveer 90 verschillende IoT-productlijnen met NVIDIA-silicium zijn, met circa 9,5 miljoen exemplaren in gebruik. De hoeveelheid rekenkracht in edgeversnellers komt daarmee ruwweg uit op 9.000 tot 35.000 H100-equivalenten, een zeer grove schatting; het daadwerkelijk bereikbare aandeel ligt waarschijnlijk een orde van grootte of meer lager. Volgens cijfers die de post aanhaalt, draait Qwen3-30B-A3B op een Jetson AGX Orin 64GB met 76,7 tokens per seconde en haalt een AGX Thor 226 tokens per seconde.
Verdedigingsmaatregelen en beoordeling door het team
De verdediging moet R₀, het aantal nieuwe apparaten dat elk geïnfecteerd apparaat vervolgens infecteert, onder de één brengen, aldus de post. Een replicator op basis van modelgewichten die zich op grote schaal via IoT-apparaten verspreidt, zou een netwerkspoor achterlaten dat zichtbaar is met monitoring op basis van ISP-verkeersstromen. Nieuw geïnfecteerde apparaten ontvangen immers modelpayloads van meerdere gigabytes, terwijl gedistribueerde inferentie zorgt voor aanhoudend verkeer tussen apparaten. Snellere replicatie veroorzaakt meer verkeer en vormt daarmee een afweging tussen snelheid en onopvallendheid; honeypots kunnen de uitvoeringsomgeving en payload van een replicator onderscheppen. Onder verwijzing naar onderzoek naar het verhelpen van Mirai-besmettingen stelt de post dat quarantaine door ISP’s, in combinatie met een melding aan klanten, binnen 14 dagen 92% van de besmettingen verholp, tegenover 74% zonder melding. De post merkt ook op dat standaardwachtwoorden voor IoT-apparaten op Britse markten nu niet meer aan de regelgeving voldoen, als voorbeeld van hoe regelgeving het aantal potentiële doelwitten verkleint.
Anders dan hardgecodeerde botnets zoals Kimwolf, die zich op specifieke apparaattypen richten, is een AI-botnet volgens de post niet gebonden aan bepaalde hardware. De post wijst erop dat kleine modellen inferentie kunnen opzetten op apparaten variërend van een Jetson Nano tot een Mac. De onderzoekers concluderen dat de bevindingen, net als die rond codeeragenten in 2024, erop wijzen dat AI-wormen tekenen van leven vertonen: agenten voeren steeds vaker afzonderlijke stappen van de replicatieketen uit en geven aanpassingen door aan toekomstige kopieën, maar er is nog geen sprake van een volledige, op hol geslagen replicator. Ze verwachten dat de ingezette edge-computercapaciteit blijft groeien, terwijl de minimale modelgrootte die nodig is voor betrouwbare replicatie afneemt.


