Andersons hoek
AI-beeldmatting die scènes begrijpt

 Voeg Unite.AI toe aan je voorkeursbronnen op Google
Belangrijkste puntenAI-matting maakt nu gebruik van scènebegrip om groene schermen te vervangen.
Meer weergeven
- AI-matting maakt nu gebruik van scènebegrip om groene schermen te vervangen.
- De nieuwe SPG-IM-pipeline presteert met een grote marge beter dan trimap-vrije methoden.
- Tekstuele labels bieden een goedkoop alternatief voor dure pixelannotatie.
In de extra documentaire bij de dvd-uitgave uit 2003 van Alien3 (1992) haalde visualeffectsveteraan Richard Edlund met afgrijzen het ‘sumoworstelen’ van de fotochemische matte-extractie aan, die van het eind van de jaren dertig tot het eind van de jaren tachtig het visuele-effectenwerk domineerde. Edlund omschreef het onvoorspelbare karakter van het proces als ‘sumoworstelen’, in vergelijking met de digitale technieken met een blauw of groen scherm die begin jaren negentig de overhand kregen (en hij is later teruggekomen op die metafoor).
Een voorgrondelement (zoals een persoon of een ruimteschipmodel) losmaken van de achtergrond, zodat de uitgesneden afbeelding in een achtergrondplaat kan worden samengevoegd, gebeurde oorspronkelijk door het voorgrondobject te filmen tegen een egale blauwe of groene achtergrond.
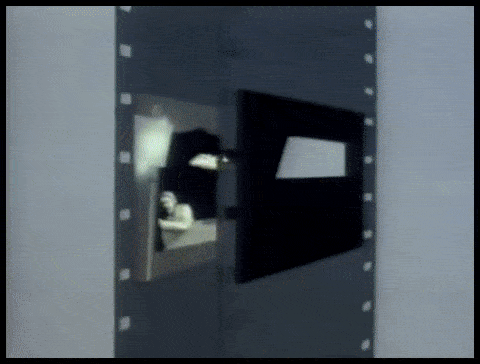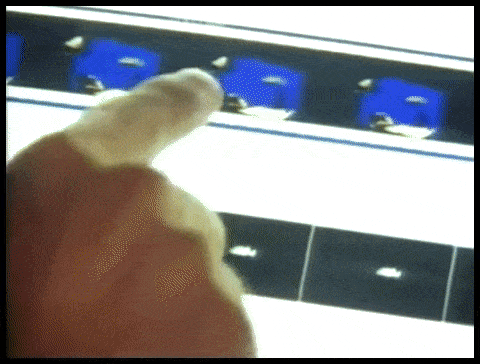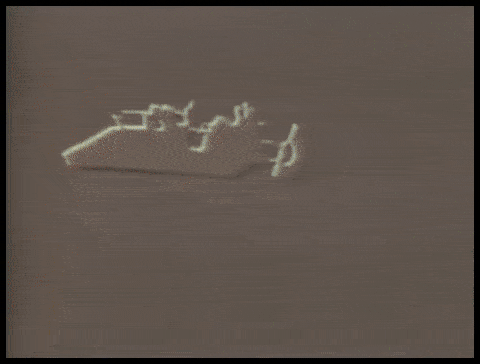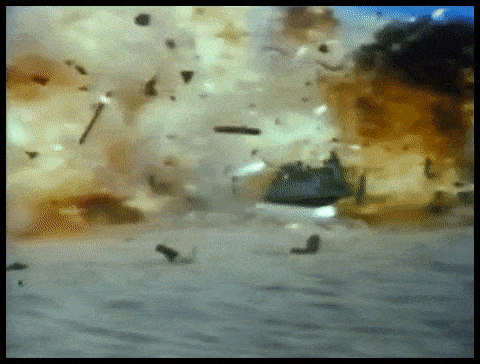
Arbeidsintensieve fotochemische extractieprocessen voor een VFX-opname van ILM voor ‘Return of the Jedi’ (1983).
In de resulterende filmbeelden werd de achtergrondkleur vervolgens chemisch geïsoleerd en gebruikt als sjabloon om het voorgrondobject (of de persoon) met een optische printer opnieuw af te drukken als een ‘zwevend’ object op een verder transparant filmbeeld.
Het proces stond bekend als color separation overlay (CSO), maar die term werd uiteindelijk sterker geassocieerd met de grove video-effecten met ‘Chromakey’ in de televisieproducties met een lager budget uit de jaren zeventig en tachtig, die met analoge in plaats van chemische of digitale middelen werden gemaakt.

Een demonstratie van Color Separation Overlay uit 1970 voor het Britse kinderprogramma ‘Blue Peter’. Bron: https://www.bbc.co.uk/archive/blue_peter_noakes_CSO/zwb9vwx
Hoe dan ook konden de geëxtraheerde filmbeelden daarna, of het nu om film- of video-elementen ging, in andere beelden worden ingevoegd.
Hoewel Disney’s aanzienlijk duurdere, bedrijfseigen natriumdampproces (dat specifiek geel als sleutel gebruikte en ook werd gebruikt voor Alfred Hitchcocks horrorfilm The Birds uit 1963) een betere definitie en scherpere mattes opleverde, bleef fotochemische extractie arbeidsintensief en onbetrouwbaar.

Voor Disney’s bedrijfseigen extractieproces met natriumdamp waren achtergronden nodig met kleuren aan de gele kant van het spectrum. Hier hangt Angela Lansbury aan draden tijdens de opnamen van een scène vol visuele effecten voor ‘Bedknobs and Broomsticks’ (1971). Bron
Verder dan digitale matting
In de jaren negentig maakte de digitale revolutie een einde aan het gebruik van chemicaliën, maar niet aan de behoefte aan groene schermen. Het werd nu mogelijk om de groene achtergrond (of een achtergrond in een andere kleur) te verwijderen door in beeldbewerkingssoftware zoals Photoshop te zoeken naar pixels binnen een bepaalde tolerantie voor die kleur. Ook kwam er een nieuwe generatie videocompositiesoftware die gekleurde achtergronden automatisch kon verwijderen. Vrijwel van de ene op de andere dag werd zestig jaar optische printtechniek naar de geschiedenis verwezen.
De afgelopen tien jaar aan GPU-versneld computer vision-onderzoek luidt een derde tijdperk van matte-extractie in. Onderzoekers werken daarbij aan systemen die mattes van hoge kwaliteit kunnen extraheren zonder groene schermen. Alleen al op Arxiv verschijnen wekelijks artikelen over innovaties op het gebied van machinelearninggebaseerde voorgrondextractie.
Wij in beeld brengen
Deze academische en industriële belangstelling voor AI-extractie heeft de consumentenmarkt al bereikt: we kennen allemaal de eenvoudige maar bruikbare filters van Zoom en Skype, waarmee je tijdens videogesprekken de achtergrond van je woonkamer kunt vervangen door bijvoorbeeld tropische eilanden.
Voor de beste mattes is echter nog steeds een groen scherm nodig, zoals Zoom afgelopen woensdag opmerkte.

Links staat een man voor een groen scherm; zijn haar wordt met de functie Virtual Background van Zoom nauwkeurig geëxtraheerd. Rechts staat een vrouw voor een gewone huiselijke achtergrond; haar haar wordt algoritmisch, minder nauwkeurig en met hogere rekenvereisten geëxtraheerd. Bron: https://support.zoom.us/hc/en-us/articles/210707503-Changing-your-Virtual-Background-image
In een ander bericht waarschuwt het Zoom Support-platform dat extractie zonder groen scherm ook meer rekenkracht vereist van het opnameapparaat.
De noodzaak om het uit te knippen
Verbeteringen in de kwaliteit, draagbaarheid en efficiëntie van het middelengebruik van systemen die in de praktijk matte-extractie uitvoeren (oftewel mensen isoleren zonder green screens) zijn relevant voor veel meer sectoren en toepassingen dan alleen filters voor videoconferenties.
Voor de ontwikkeling van datasets biedt betere herkenning van gezichten, volledige hoofden en lichamen de mogelijkheid om te voorkomen dat ongewenste achtergrondelementen worden meegenomen in de training van computervisiemodellen van mensen. Een nauwkeurigere isolatie zou de technieken voor semantische segmentatie, die zijn ontworpen om domeinen (oftewel ‘kat’, ‘persoon’, ‘boot’) te onderscheiden en te assimileren, aanzienlijk verbeteren. Ook zou die de op VAE en transformers gebaseerde beeldsynthesesystemen verbeteren, zoals OpenAI’s nieuwe DALL-E 2. Betere extractiealgoritmen zouden bovendien de behoefte aan kostbare handmatige rotoscoping in dure VFX-workflows verminderen.
De opkomst van multimodale (doorgaans tekst- en beeldgebaseerde) methoden, waarbij een domein zoals ‘kat’ zowel als afbeelding als met bijbehorende tekstuele verwijzingen wordt gecodeerd, vindt inmiddels ook zijn weg naar de beeldverwerking. Een recent voorbeeld is de architectuur Text2Live, die multimodale (tekst- en beeldgebaseerde) training gebruikt om video’s te maken van onder meer kristallen zwanen en giraffen van glas.
Scènebewuste AI-matting
Veel onderzoek naar automatische AI-matting was gericht op het herkennen van grenzen en het evalueren van pixelgroepen binnen een afbeelding of videoframe. Nieuw onderzoek uit China introduceert echter een extractieworkflow die de afbakening en kwaliteit van de matte verbetert door gebruik te maken van tekstuele beschrijvingen van een scène. Deze multimodale benadering heeft de afgelopen 3-4 jaar aan populariteit gewonnen in de computer vision-sector. De onderzoekers stellen dat hun methode op verschillende punten beter presteert dan eerdere methoden.

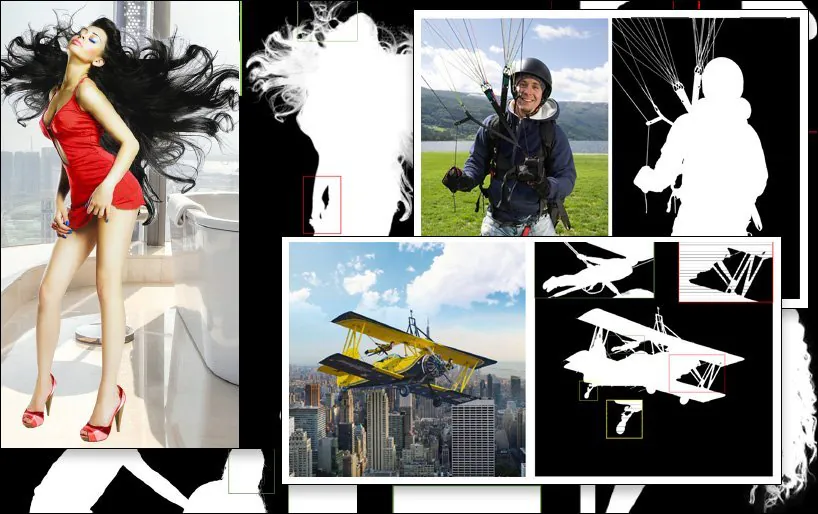
Een voorbeeld van een SPG-IM-extractie (laatste afbeelding, rechtsonder), vergeleken met eerdere concurrerende methoden. Bron: https://arxiv.org/pdf/2204.09276.pdf
De uitdaging voor de onderzoekssector op het gebied van extractie is om workflows te ontwikkelen waarvoor zo min mogelijk handmatige annotatie en menselijke tussenkomst nodig zijn, idealiter helemaal geen. Naast de kosten wijzen de onderzoekers van het nieuwe artikel erop dat annotaties en handmatige segmentaties door uitbestede crowdsourcers uit verschillende culturen ertoe kunnen leiden dat afbeeldingen op uiteenlopende manieren worden gelabeld of zelfs gesegmenteerd. Dat kan leiden tot inconsistente en onbevredigende algoritmen.
Een voorbeeld hiervan is de subjectieve interpretatie van wat als een ‘voorgrondobject’ geldt:

Uit het nieuwe artikel: de eerdere methoden LFM en MODNet (‘GT’ staat voor Ground Truth, een ‘ideaal’ resultaat dat vaak handmatig of met niet-algoritmische methoden wordt bereikt) hanteren uiteenlopende definities van voorgrondinhoud, die in verschillende mate effectief zijn. De nieuwe methode SPG-IM bakent ‘inhoud op de voorgrond’ effectiever af aan de hand van de scènecontext.
Om dit probleem aan te pakken, hebben de onderzoekers een tweetrapsworkflow ontwikkeld met de titel Situational Perception Guided Image Matting (SPG-IM). De encoder-decoderarchitectuur met twee fasen bestaat uit Situational Perception Distillation (SPD) en Situational Perception Guided Matting (SPGM).

De SPG-IM-architectuur.
Eerst traint SPD transformaties van visuele naar tekstuele kenmerken voor, waarbij bijbehorende afbeeldingen passende bijschriften krijgen. Vervolgens wordt voorspelling van het voorgrondmasker mogelijk gemaakt door de workflow te koppelen aan een nieuwe techniek voor salientievoorspelling.
Vervolgens produceert SPGM een geschatte alphamatte op basis van de onbewerkte RGB-afbeelding als invoer en het gegenereerde masker uit de eerste module.
Het doel is begeleiding op basis van situationeel begrip: het systeem begrijpt de context van wat er op de afbeelding staat en kan zo bijvoorbeeld de uitdaging van het isoleren van ingewikkeld haar tegen een achtergrond benaderen op basis van de bekende kenmerken van die specifieke taak.

In het onderstaande voorbeeld begrijpt SPG-IM dat de koorden bij een ‘parachute’ horen, terwijl MODNet deze details niet weet te behouden en af te bakenen. Ook gaat hierboven bij MODNet de volledige structuur van de speeltoestellen willekeurig verloren.
Het nieuwe artikel heet Beeldmatting op basis van situationeel inzicht en is afkomstig van onderzoekers van OPPO Research Institute, PicUp.ai en Xmotors.
Intelligente geautomatiseerde mattes
SPG-IM biedt ook een Adaptive Focal Transformation (AFT)-verfijningsnetwerk dat lokale details en globale context afzonderlijk kan verwerken, waardoor ‘intelligente mattes’ mogelijk worden.

Inzicht in de scènecontext — in dit geval ‘meisje met paard’ — kan het extraheren van de voorgrond mogelijk eenvoudiger maken dan met eerdere methoden.
In het artikel staat:
‘We denken dat visuele representaties uit taken waarbij beeld naar tekst wordt omgezet, zoals het beschrijven van afbeeldingen, zich richten op semantisch uitgebreidere signalen tussen a) objecten onderling en b) objecten en hun omgeving. Zo kunnen beschrijvingen worden gegenereerd die zowel de globale informatie als de lokale details omvatten. Bovendien kunnen tekstuele labels, vergeleken met de kostbare annotatie van afzonderlijke pixels bij beeldmatting, tegen zeer lage kosten op grote schaal worden verzameld.’
De SPD-tak van de architectuur wordt gezamenlijk vooraf getraind met de op transformers gebaseerde tekstdecoder VirTex van de University of Michigan, die visuele representaties leert aan de hand van semantisch rijke bijschriften.

VirTex traint een ConvNet en Transformers gezamenlijk aan de hand van combinaties van afbeeldingen en bijschriften, en zet de opgedane inzichten in voor downstream-visietaken zoals objectdetectie. Bron: https://arxiv.org/pdf/2006.06666.pdf
Naast andere tests en ablatiestudies testten de onderzoekers SPG-IM aan de hand van de modernste methoden op basis van een trimap: Deep Image Matting (DIM), IndexNet, Context-Aware Image Matting (CAM), Guided Contextual Attention (GCA), FBA en Semantic Image Matting (SIM).
Ook werden eerdere raamwerken getest, waaronder trimapvrije benaderingen zoals LFM, HAttMatting en MODNet. Voor een eerlijke vergelijking werden de testmethoden aangepast aan de verschillende methodologieën; als de code niet beschikbaar was, werden de technieken uit het artikel nagebouwd op basis van de beschreven architectuur.
In het nieuwe artikel staat:
‘Onze SPG-IM presteert met ruime voorsprong beter dan alle concurrerende trimapvrije methoden ([LFM], [HAttMatting] en [MODNet]). Bovendien presteert ons model opmerkelijk veel beter dan de modernste (SOTA) methoden op basis van een trimap en methoden die op maskers zijn gebaseerd, gemeten aan de hand van alle vier de maatstaven op de openbare datasets (namelijk Composition-1K, Distinction-646 en Human-2K) en onze benchmark Multi-Object-1K.’
Verder staat er:
‘Het is duidelijk te zien dat onze methode fijne details behoudt (zoals haarpunten, transparante texturen en randen) zonder begeleiding door een trimap. Bovendien behoudt onze SPG-IM, vergeleken met andere concurrerende trimapvrije modellen, de globale semantische volledigheid beter.’


Voor het eerst gepubliceerd op 24 april 2022.