
Andersonの視点
ビデオからのオブジェクトの削除をマシンラーニングでより効率的に行う

 Unite.AI を Google の優先ソースに追加
要点E2FGVIは、3つのビデオインペインティング段階を1つのエンドツーエンドシステムに統合し、大幅な効率向上を実現します。
もっと見る
- E2FGVIは、3つのビデオインペインティング段階を1つのエンドツーエンドシステムに統合し、大幅な効率向上を実現します。
- このシステムは、従来のオプティカルフロー手法よりも15倍高速に動作し、最先端の結果を達成します。
- 新しい時間的焦点トランスフォーマーが注意機構を2Dから3Dに拡張し、フレーム間で一貫性のあるコンテンツの幻覚生成を可能にします。
中国からの新しい研究は、ビデオからオブジェクトを削除するための新しいビデオインペインティングシステムのための最先端の結果と、効率性の驚くべき改善を報告しています。
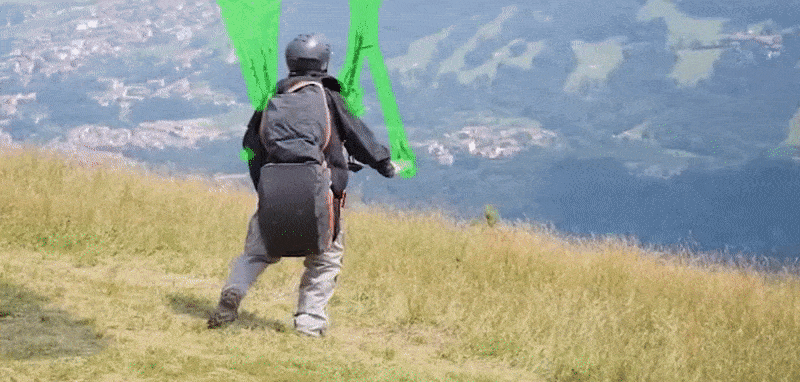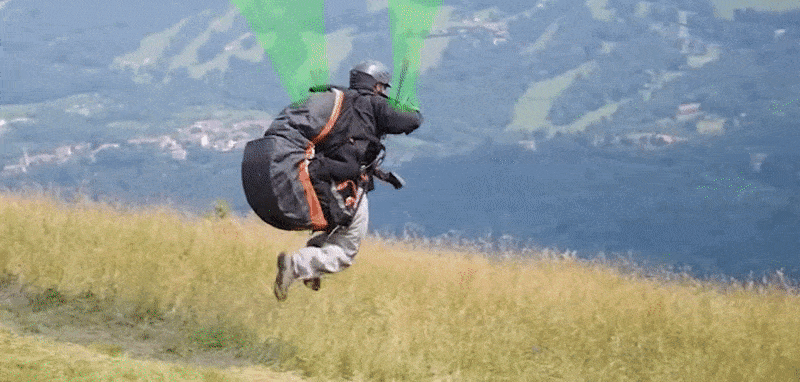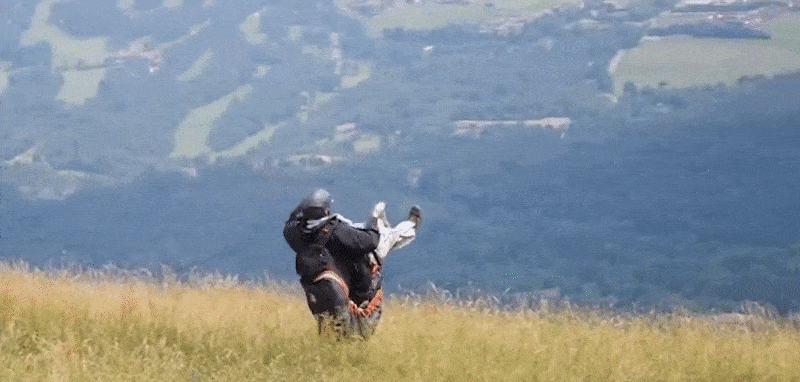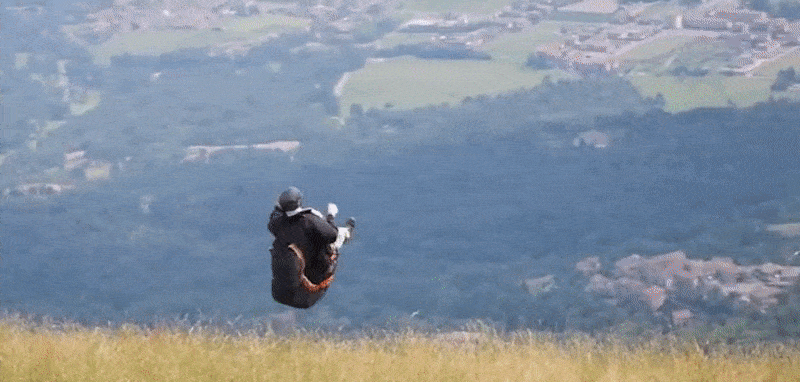
ハンググライダーの操縦者のハーネスが、新しい手法で映像から消去されました。より高解像度とより多くの例を確認するために、この記事の下部に埋め込まれたソースビデオを参照してください。 ソース:https://www.youtube.com/watch?v=N–qC3T2wc4
このテクニックは、End-to-End フレームワーク for Flow-Guided ビデオインペインティング (E2FGVI) と呼ばれています。また、ウォーターマークやその他の種類のオクルージョンをビデオコンテンツから削除することもできます。
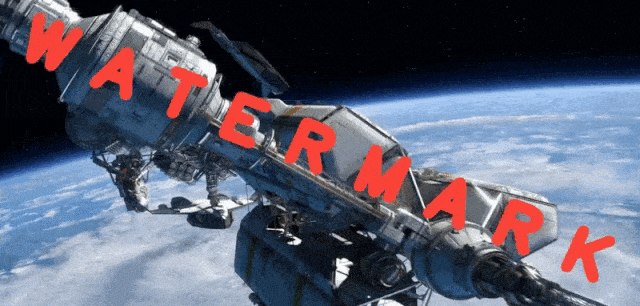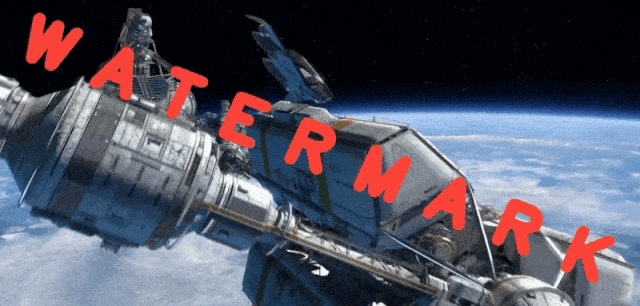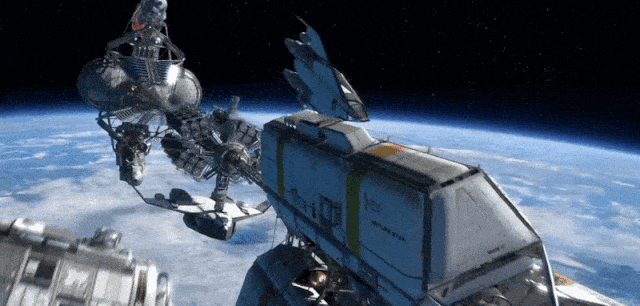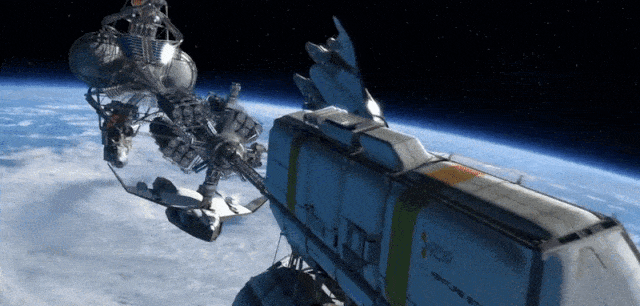
E2FGVI はオクルージョンの後ろにあるコンテンツの予測を計算し、目立っていて除去の難しいウォーターマークを含むウォーターマークの削除を可能にします。 ソース:https://github.com/MCG-NKU/E2FGVI
(より高解像度の例を確認するには、ビデオを参照してください)
研究で紹介されたモデルは、432px x 240px のビデオ(一般的には低入力サイズで、GPU のスペースと最適なバッチ サイズなどの要因によって制限される)でトレーニングされましたが、著者は後に E2FGVI-HQ をリリースしました。これは、任意の解像度のビデオを処理できます。
現在のバージョンのコードは GitHub で利用可能です。一方、HQ バージョンは先週日曜日にリリースされ、Google ドライブ と Baidu Disk からダウンロードできます。

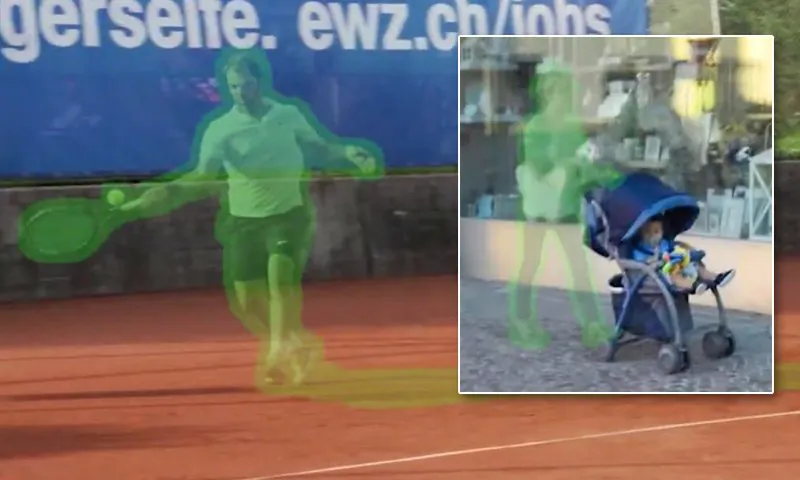
子供は写真に残っています。
E2FGVI は、432×240 のビデオを、Titan XP GPU(VRAM 12GB)上で1フレームあたり0.12秒で処理できます。著者は、このシステムがオプティカルフローに基づく従来の最先端手法と比べて 15 倍速いと報告しています。
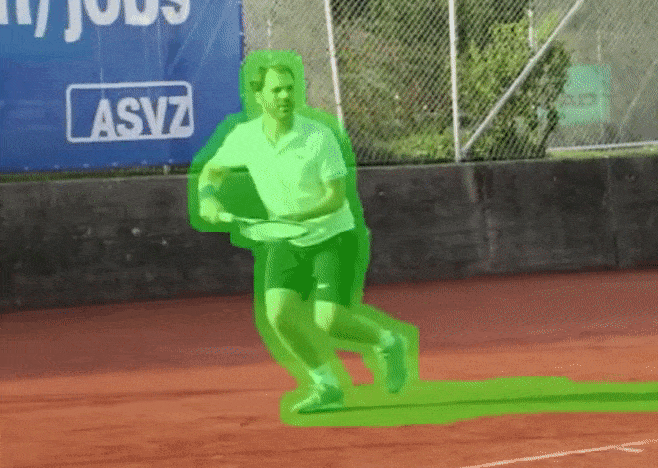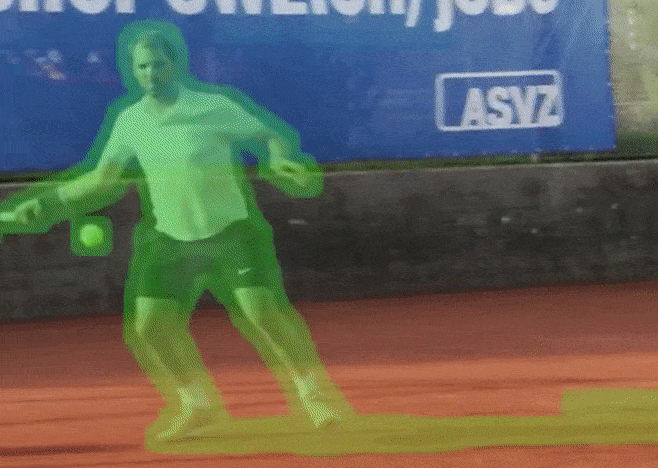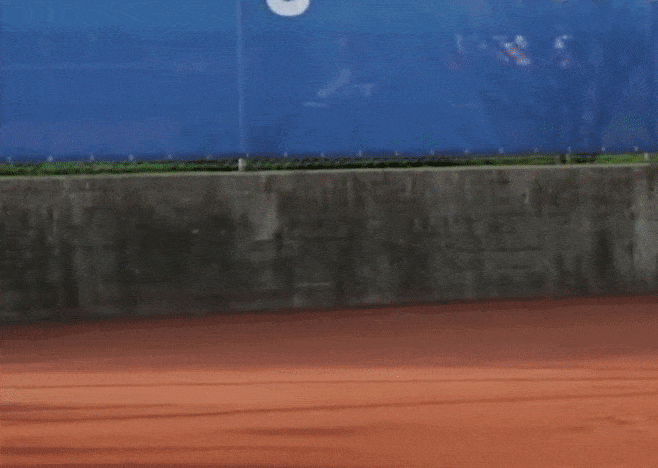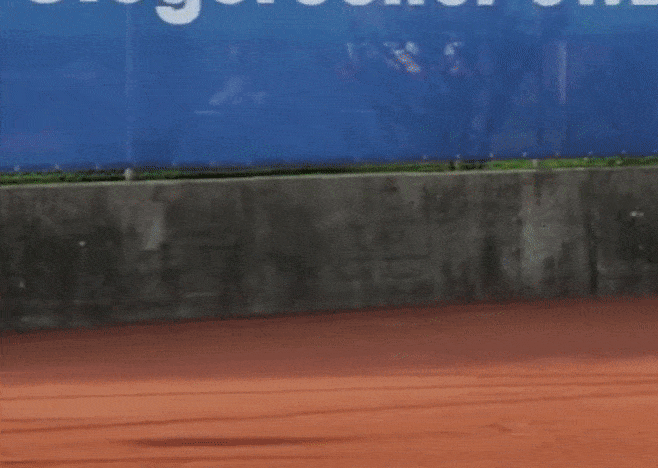
テニス プレーヤーが予期せず退場します。
この新しい方法は、画像合成研究のこのサブセクターの標準データセットでテストされ、ライバルに比べて質的および量的評価の両方で優れています。

以前のアプローチとのテスト。 ソース:https://arxiv.org/pdf/2204.02663.pdf
論文の題名はTowards An End-to-End Framework for Flow-Guided Video Inpaintingで、南開大学の研究者4人とHisilicon Technologiesの研究者1人による共同研究です。
この絵に欠けているもの
この技術の明らかな応用例として、視覚効果や、高品質のビデオインペインティングが新しい AI ベースの画像合成および画像変更技術の重要な特徴になることが予想されます。
これは特に、ボディ アルタリング ファッション アプリケーションや、体形を「スリム化」したり、画像やビデオのシーンを別の方法で変更したりするフレームワークなどの場合に当てはまります。このような場合、合成によって露出される背景を信頼性高く「埋める」ことが必要です。

最近の論文から、ボディ「リシェイピング」アルゴリズムが、サブジェクトをリサイズしたときに新しく露出された背景をインペイントするように設計されています。ここでは、その不足は、実際の(画像左参照)より体の丸い人によって占められていた赤いアウトラインによって表されます。 ソース資料:https://arxiv.org/pdf/2203.10496.pdf
一貫したオプティカル フロー
オプティカル フロー (OF) は、ビデオ オブジェクト除去の開発において重要な技術になりました。地図帳のように、OFは時系列全体のマップを一度に提供します。コンピュータービジョンで速度を測る用途によく使われるOFは、時間的に一貫したインペインティングも可能にします。タスク全体を一度の処理で扱えるため、必然的に時間的な不連続を生むディズニー式のフレームごとの処理とは異なります。
これまでのビデオインペインティング方法は、3 つのステージで構成されています。1. フロー完了、ビデオを離散的で探索可能な対象にマッピングする。2. ピクセル伝播、破損したビデオの穴を、ピクセルを双方向に伝播させて埋める。3. コンテンツのホールシネーション、推定された欠落コンテンツを作り出して映像に挿入する。これは、ディープフェイクやDALL-Eシリーズなどのテキストから画像を生成する仕組みでおなじみの、ピクセルの「発明」にあたる。
E2FGVI の中心的な革新は、これらの 3 つのステージをエンドツーエンドのシステムに統合し、コンテンツやプロセスに対する手動操作の必要性を排除したことです。

論文では、手動介入の必要性により、古いプロセスが GPU を活用できないため、非常に時間がかかることを観察しています。論文から*:
‘DFVIを例に取ると、DAVISの約70フレームからなる432 × 240のビデオ1本を補完するには約4分かかります。これは、ほとんどの実際のアプリケーションでは受け入れられません。さらに、上記の欠点以外に、コンテンツ ホールシネーション段階では、事前トレーニングされた画像インペインティング ネットワークのみを使用し、時間的な隣接フレーム間のコンテンツの関係を無視するため、生成されたコンテンツが一貫性がないことになります。’
E2FGVI は、ビデオインペインティングの 3 つのステージを統合することで、2 番目のステージであるピクセル伝播を、フィーチャー伝播に置き換えることができます。従来の分割された処理では各段階が比較的閉じており、ワークフローも半自動であるため、特徴量をそれほど広く利用できません。
さらに、研究者は、コンテンツ ホールシネーション段階のために、テンポラル フォーカル トランスフォーマー を設計しました。これは、現在のフレームのピクセルの直接的な時間上の近傍(前後の画像で対応する部分に何が起きているか)だけでなく、多くのフレーム離れた遠隔隣接ピクセルも考慮し、ビデオ全体の凝集効果に影響を与える操作を可能にします。

E2FGVI のアーキテクチャ。
ワークフローの新しい特徴量ベースの中心部分は、特徴量レベルの処理と学習可能なサンプリングオフセットをさらに活用します。また、著者によると、新しいフォーカルTransformerは焦点ウィンドウを「2Dから3Dへ」拡張します。
テストとデータ
E2FGVI をテストするために、研究者は、2 つの人気のビデオ オブジェクト セグメンテーション データセット、YouTube-VOS と DAVIS に対して評価しました。YouTube-VOSには学習用3,741本、検証用474本、テスト用508本のクリップがあり、DAVISには学習用60本とテスト用90本のクリップがあります。
E2FGVI は YouTube-VOS でトレーニングされ、両方のデータセットで評価されました。トレーニング中、オブジェクト マスク(上の画像の緑の領域と、付随する YouTube ビデオ)がビデオ完了をシミュレートするために生成されました。
メトリックとして、研究者はピーク信号対雑音比 (PSNR)、構造類似度 (SSIM)、ビデオベースの Fréchet Inception Distance (VFID)、およびフロー ワーピング エラー(テンポラル安定性を測定する)を採用しました。
テストされた以前のアーキテクチャには、VINet、DFVI、LGTSM、CAP、FGVC、STTN、および FuseFormer が含まれました。

論文の量的結果セクションから。上向きと下向きの矢印は、それぞれ高いまたは低い数字が良いことを示します。E2FGVI は全てのスコアで最高の成績を収めています。手法はFuseFormerに従って評価されていますが、DFVI、VINet、FGVCはエンドツーエンドシステムではないため、そのFLOPsを推定できません。
さらに、研究者は、5 つの代表的な方法で変換されたビデオを 20 人のボランティアに個別に提示し、視覚的な品質に基づいて評価を求める質的ユーザー研究を実施しました。

垂直軸は、視覚的な品質に基づいて E2FGVI 出力が好まれた参加者の割合を表します。
著者は、E2FGVI が一貫して好まれたものの、1 つの結果 (FGVC) が量的結果と一致しないことを指摘し、E2FGVI が誤解を招く形で「視覚的により快い結果」を生成している可能性があることを示唆しています。
効率性について、著者は、E2FGVI がDAVISデータセットにおける毎秒の浮動小数点演算(FLOPs)と単一のTitan GPU上での推論時間を大幅に削減することを観察し、結果は E2FGVI がフロー ベースの方法よりも 15 倍速いことを示していることを述べています。
彼らは次のように述べています:
‘[E2FGVI] は他のすべての方法と比較して最も低い FLOPs を持っています。これは、提案された方法がビデオインペインティングに非常に効率的であることを示しています。’
*著者のインライン引用をハイパーリンクに変換しました。
最初に公開された 2022 年 5 月 19 日。
2025 年 10 月 28 日に修正され、不正なビデオ埋め込みを削除し、記事本文への埋め込みビデオへの参照を修正しました。


