
AIの基礎
生成モデルと識別モデルの機械学習

 Unite.AI を Google の優先ソースに追加
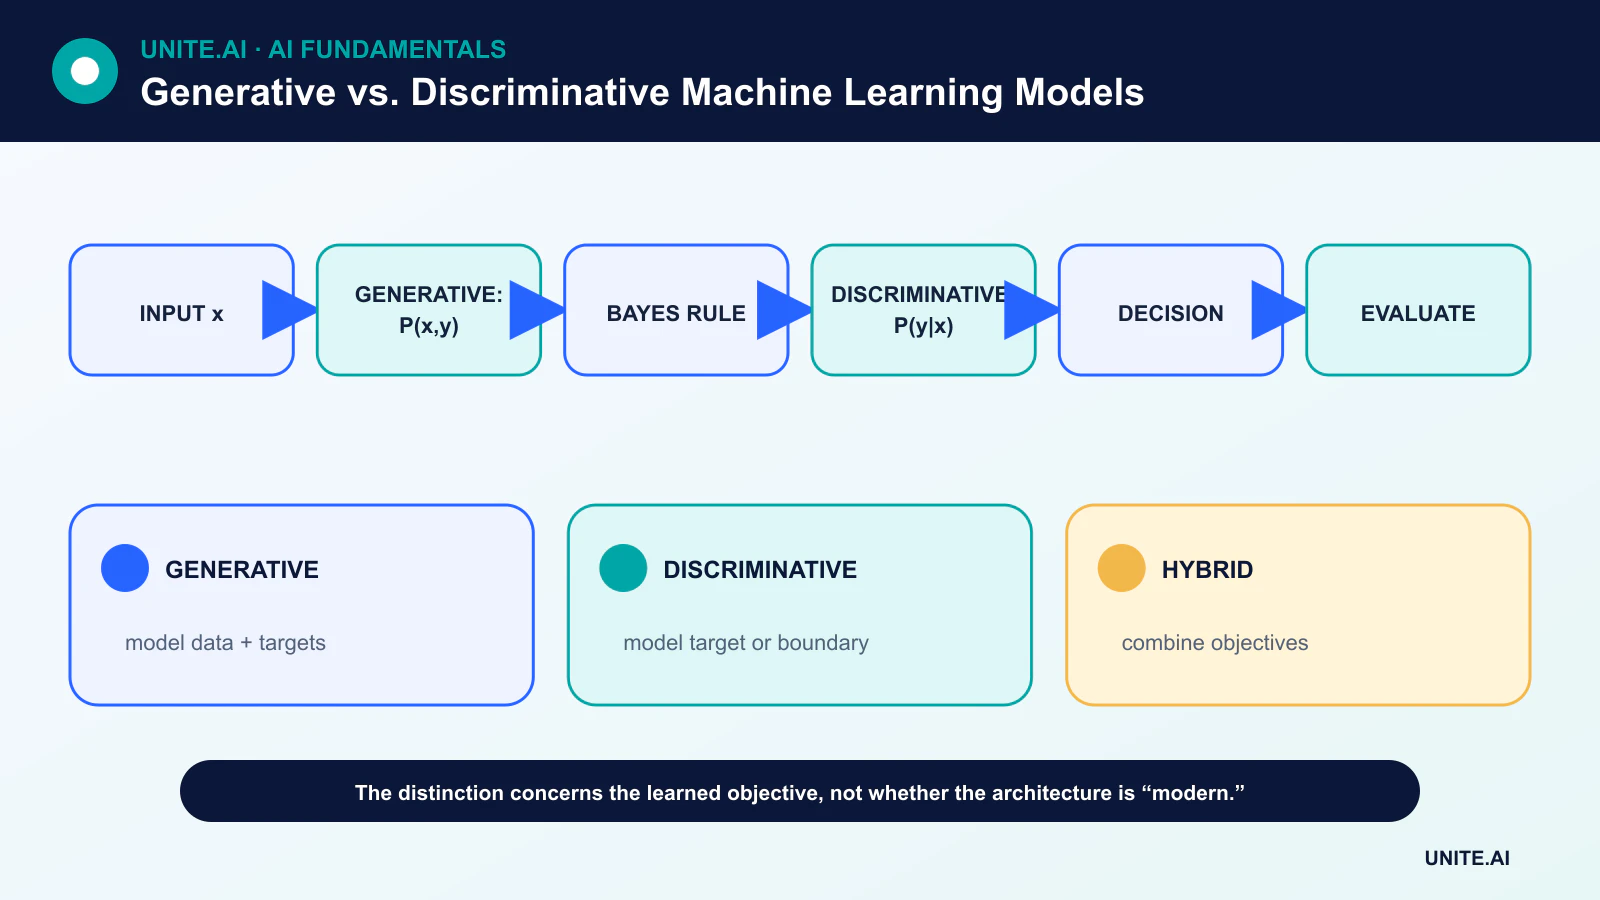
生成的 と 識別的 は、モデルがデータとターゲットについて何を学習するかを表します。古典的な教師あり分類では、生成モデルは P(x, y) やクラス条件付き P(x|y) といった結合分布を学習し、識別モデルは P(y|x) または直接的な決定境界を学習します。
この区別は有用ですが、現代のシステムでは目的を組み合わせることが一般的です。モデルは生成的表現を学習した後に識別的予測のためにファインチューニングされたり、生成と分類の両方で同一のバックボーンを共有したりします。
主なポイント
- 生成的分類器は入力とラベルがどのように生成されるかをモデル化し、識別的分類器は入力が与えられたときのラベルまたは境界をモデル化します。
- 生成的仮定はラベル付きデータが限られている場合に有利になることがありますが、誤っている可能性もあります。
- 識別的手法はしばしば予測タスクに容量を集中させ、漸近的な分類誤差を低減できることがあります。
- GAN、VAE、言語モデルは生成システムですが、「生成的」というだけで全てのコンポーネントが生成的分類器であるわけではありません。
確率の因子分解
生成的分類器は P(x|y) と P(y) を推定し、ベイズの定理を用いて P(y|x) を導出できます。ナイーブベイズは代表的な例です。ロジスティック回帰などの識別的分類器は P(y|x) を直接推定し、SVM は分離境界を学習します。
P(x,y) をモデル化することは、x から y を予測するよりも広範なタスクです。この余分な構造はサンプリングや欠損データの推論を支援しますが、入力分布に関する仮定も必要となります。
データ効率と漸近的挙動
Ng と Jordan が行ったナイーブベイズとロジスティック回帰の比較では、有用なトレードオフが示されました。彼らの仮定の下では、生成的モデルは少ないサンプルで極限性能に近づき、識別的モデルはより低い漸近誤差に到達できます。
これは普遍的な順位付けではありません。結果はモデルファミリーがデータに適合しているか、次元、正則化、最適化、ラベルの品質に依存します。代表的な検証設計での実証的比較は依然として不可欠です。
代表的なモデルファミリー
生成的モデルにはクラス条件付き分布、隠れマルコフモデル、混合モデル、変分オートエンコーダ、自己回帰型言語モデル、拡散モデル、そして GAN が含まれます。
識別的モデルにはロジスティック回帰、決定木、条件付き確率場、サポートベクターマシン、ニューラル分類器が含まれます。同一のニューラルバックボーンでも、学習目的と出力に応じてどちらのカテゴリにも属し得ます。
ハイブリッドおよび自己教師ありシステム
事前学習済みの言語モデルやビジョンモデルは、生成的または自己教師あり目的でラベルなしデータから学習し、その後ターゲットタスク用の識別ヘッドを付加できます。半教師あり手法は、ラベル付き分類とラベルなしデータ目的を同時に最適化することがあります。
ハイブリッド化により、アーキテクチャだけのラベルは完全な学習パイプラインほど情報量がありません。ドキュメントには目的、データ、出力、意図した推論を明記すべきであり、単にモデルを生成的と呼ぶだけでは不十分です。
アプローチ選択の指針
タスクに応じて選択してください。豊富なラベルがあり、校正された境界が目的であれば、識別的モデルが自然なベースラインとなります。サンプリング、密度推定、欠損データ構造、またはラベルなしデータが中心であれば、生成的コンポーネントが有用です。
適切にロバスト性、サンプル効率、計算コスト、尤度または校正性を比較してください。優れた生成サンプルが良い分類器を証明するわけでも、精度の高い分類器が入力分布の現実的なモデルを示すわけでもありません。
確率の方向性とモデリング目的
識別的モデルは境界または条件付き分布 P(y|x) を学習します。すなわち特徴 x が与えられたときラベル y を予測します。ロジスティック回帰、サポートベクターマシン、条件付き確率場、その他多くの分類器は識別的です。生成的モデルは結合分布 P(x,y)、クラス条件付き分布 P(x|y)、あるいは無条件のデータ分布を学習し、サンプリングや尤度関連タスクを可能にします。ナイーブベイズや線形判別分析は生成的分類器です。GAN、変分オートエンコーダ、拡散モデル、自己回帰モデルはそれぞれ異なる目的でデータを生成します。
この区別は、どの分布や決定規則をモデル化するかに関するものであり、ニューラルネットワークを使用するかどうかとは無関係です。生成的言語モデルはプロンプトで分類に利用でき、識別的リランカーは生成を導くことができます。生成的仮定はデータ効率を高めたり欠損変数に対処したりしますが、モデルのミススペックリスクも生じます。識別的手法はラベル付きデータが豊富な場合に直接予測境界に焦点を当てるため優れています。機能、データ、チューニング、計算リソースを同等にした上でファミリーを比較し、一方のカテゴリを普遍的に優位と見なさないようにしてください。
ユースケース別のトレーニングと評価
分類の評価指標は適合率、再現率、校正、ロバスト性、エラーコストです。生成系の評価では忠実度、多様性、カバレッジ、尤度またはタスク有用性、記憶性、安全性に対処する必要があります。モデルは魅力的なサンプルを生成しながらモードを落としたり、良好な尤度を示しつつ知覚的に劣る出力を出すことがあります。合成データの有用性は、独立した実データ上で下流モデルを学習・評価することでテストすべきです。希少グループも含め、テストデータを生成プロンプトや選択に使用しないようにします。
半教師あり学習では、生成的モデルがラベルなし構造を活用できることがあります。異常検知では、外れ分布データが無関係な理由で高い密度を与えられると尤度が失敗します。検索強化生成では、生成的回答モデルと識別的検索器またはリランカーがハイブリッドを構成します。各段階を個別に診断し、流暢な出力が検索失敗を隠さないようにします。証拠と制御が観測可能になるように分解を選択してください。
導入とガバナンス
生成システムはコンテンツの出所、知的財産、なりすまし、プロンプトインジェクション、出力モデレーションといったリスクを付加します。一方、識別システムは閾値、拒否、エラー不均衡のリスクを伴います。両者ともデータ権利、セキュアなアーティファクト、バージョニング、代表的なテスト、モニタリング、影響に比例した人的権限が必要です。ドキュメントには正確な目的と出力の意味論を記録してください。生成と識別は有用な統計的区別ですが、実際のシステムは両者を組み合わせることが一般的であり、信頼性はデータと意思決定パイプライン全体に依存します。
実例:サポート返信の分類と生成
サポートプラットフォームは、問題タイプと緊急度を識別するために識別的分類器を使用し、承認済みポリシーに基づいて回答を下書きするために生成的モデルを使用します。分類器はクラス別再現率と校正で評価され、検索器は証拠再現率で、生成器は根拠性、正確性、拒否で評価されます。各段階の結果は不確定であり、生成的モデルは説得的なテキストで分類や顧客の権利を変更することはできません。
エージェントは予測されたルート、情報源、下書きを確認し、送信前に承認または修正します。検索前に権限フィルタが適用され、顧客テキスト内のプロンプトインジェクションはツールの許可に使えません。モニタリングはルーティングエラー、検索ギャップ、未サポートの記述、エージェントの編集を分離します。ポリシー変更は情報源を即座に更新し、回帰テストをトリガーします。チューニングは安定した挙動に限定されます。ハイブリッド設計は識別と生成の長所を活かしつつ、証拠と人的権限を保持します。
実装証拠と運用準備
本番導入の判断には、成功したデモだけでは不十分です。想定ユーザー、稼働環境、入力・出力、依存関係、所有者、重要な障害ごとの影響を定義します。チューニング前に再現可能なベースラインとバージョン管理された評価セットを確立します。通常ケース、境界条件、形式不正や欠損入力、分布シフト、依存障害、誤用、そしてサービスが行き届きにくいグループや環境をテストします。タスク品質を校正や不確実性、レイテンシ、スループット、リソースコスト、アクセシビリティ、プライバシー、セキュリティと共に測定します。すべての変換と閾値を記録し、独立したレビューアが結果を再現でき、魅力的なプロトタイプと証拠を区別できるようにします。
リリース前に、リリース、例外、変更、ロールバック、廃止の権限を割り当てます。段階的ロールアウトを採用し、安全なフォールバックを保持し、意図的に失敗を注入してモニタリングを検証します。運用テレメトリは、入力品質、出力挙動、モデルまたはルールのバージョン、依存状態、人的オーバーライド、確認された結果を示すべきで、不要な機密データは収集しません。アラート閾値と対応責任者を定義し、デプロイ後に実世界の証拠をレビューします。オフライン性能が持続すると仮定しないでください。データソース、ユーザー、モデル、ベンダー、ポリシー、ハードウェア、目的が変わるたびに再評価します。維持されたシステムは、復旧手順、インシデント学習、削除・保持手順、そして無効化または置換すべき明確なタイミングを文書化する必要があります。
よくある質問
GAN の判別器は識別モデルですか?
訓練時に判別を行いますが、GAN 全体は生成フレームワークであり、出力はジェネレータが生成します。
識別学習は常に教師ありですか?
いいえ。この用語はモデル化された関係や境界を指し、教師ありは学習シグナルを指します。現代の目的はこれらのカテゴリを曖昧にすることがあります。
主要参考文献












