
Andersonの視点
ディープフェイク動画の忠実性とリアリズム

 Unite.AI を Google の優先ソースに追加

要点ディープフェイクのリアリティは、視聴者を欺くために高い忠実度ではなく、一貫性のある劣化に依存している。
もっと見る
- ディープフェイクのリアリティは、視聴者を欺くために高い忠実度ではなく、一貫性のある劣化に依存している。
- DeepFaceLabとFaceSwapには、文脈上の妥当性のために生成された顔を劣化させる組み込みパラメータが含まれている。
- 現実的な劣化パイプラインを用いた新しい検出トレーニングは、実世界のアーティファクトに対する検出器のロバスト性を向上させる。
ディープフェイクの実践者はすべて同じ目的を共有していない:画像合成研究セクターの推進力は、Adobe (ADBE ) 、NVIDIA (NVDA ) 、Facebookなどの影響力のある支持者によって裏付けられており、機械学習技術が最終的に高解像度かつ最も困難な条件下でも人間の活動を再現または合成できるようにすることを目的としている(忠実性)。
一方、ディープフェイク技術を使用してデマを広めることを目的とする人は、人間の活動を模倣するために、単にディープフェイクされた顔の真実性だけに頼るのではなく、他の方法で人間の活動を模倣することを目指している。このシナリオでは、コンテキストや妥当性などの付随的な要因は、顔の模倣能力とほぼ同等の重要性を持つ(リアリズム)。
この「手品」のアプローチは、ディープフェイク動画の最終的な画像品質の劣化にまで及ぶため、動画全体(ディープフェイクされた顔のみでなく)が一貫した「見た目」を持ち、メディアの期待される品質に適合するようにする。
「一貫した」ということは、「良い」ということではなく、オリジナルと挿入された、改ざんされたコンテンツの品質が一貫していて、期待に応えるだけである。SkypeやZoomなどのVoIPストリーミング出力のプラットフォームでは、品質の基準は非常に低く、途切れたりカクついたりする動画、さまざまな圧縮アーティファクトや、それを軽減するスムージング処理などが見られる。こうした処理自体も新たな不自然な効果を加えるが、私たちはそれをライブ配信の制約や特性の結果として受け入れている。
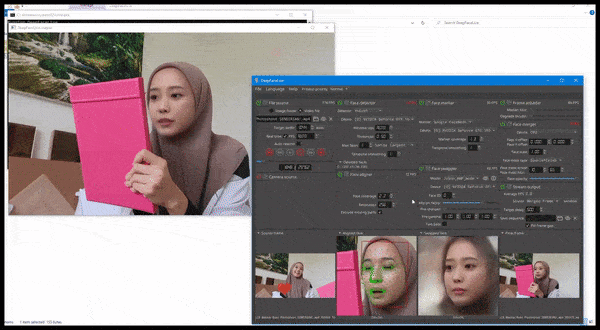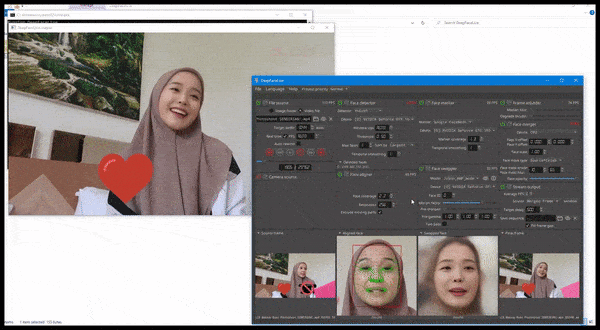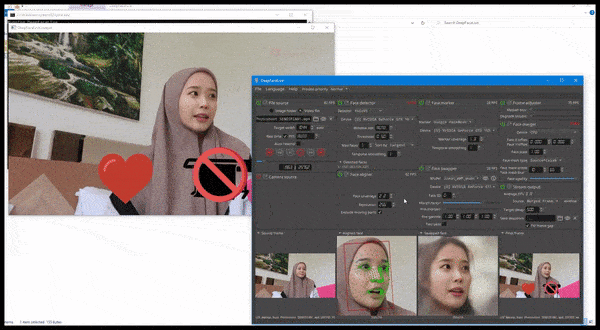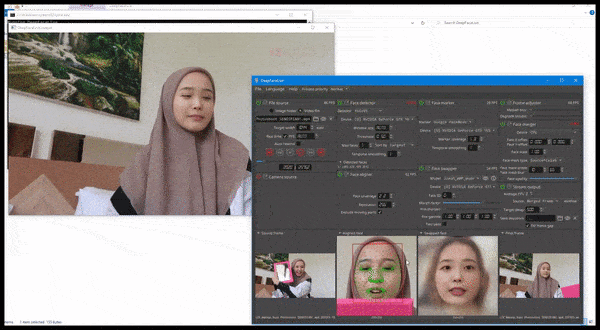
DeepFaceLiveの動作:代表的なディープフェイクソフトウェアDeepFaceLabのストリーミング版で、制限されたビデオ品質、プレイバックの問題、繰り返し発生する接続アーティファクトなどを含むコンテキストでフェイクを提示することで、コンテキストのリアリズムを提供できます。ソース:https://www.youtube.com/watch?v=IL517EgYH8U
組み込みの劣化
実際、2つの最も人気のあるディープフェイクパッケージ(両方とも2017年のソースコードから派生)には、ディープフェイクされた顔が「歴史的」または低品質のビデオのコンテキストに統合されるように、生成された顔の劣化を目的としたコンポーネントが含まれている。DeepFaceLabでは、bicubic_degrade_powerパラメータがこれを実現し、FaceSwapでは、Ffmpegの設定にある「グレイン」設定が、エンコード中にグレインを保持することで、偽の顔を統合するのに役立つ。

FaceSwapのgrain設定は、低画質の動画や、現在は比較的珍しいフィルムグレインを含む古い映像へ、合成顔を自然に組み込むのに役立つ。
ディープフェイカーは、完全に統合されたディープフェイク動画ではなく、アルファチャンネルを含むPNGファイルのシリーズを出力することが多く、各画像は合成された顔のみを示し、画像ストリームをビデオに変換できるプラットフォーム(たとえば、Adobe After Effects)で、より高度な品質劣化効果を適用できるようにする。
これらの意図的な劣化以外に、ディープフェイク作業のコンテンツは頻繁に再圧縮される。たとえば、ソーシャルメディアプラットフォームでは、ユーザーのアップロードを軽量化するためにバンド幅を節約するために、アルゴリズム的に圧縮される(たとえば、YouTubeやFacebook)か、またはアニメーションGIF、詳細セクション、またはその他の多様な動機のあるワークフローに再処理される。
リアルなディープフェイク検出コンテキスト
これを念頭に置いて、スイスの新しい論文は、ディープフェイク検出アプローチの背後にある方法論を刷新することを提案し、検出システムが意図的に劣化したコンテキストでディープフェイクコンテンツの特性を学習するように教える。

新しい論文のデータセットに適用された確率的データ拡張。ガウスノイズ、ガンマ補正、ガウスぼかし、JPEG圧縮アーティファクトを含む。出典:https://arxiv.org/pdf/2203.11807.pdf
新しい論文では、研究者は、ディープフェイク検出のための先駆的なパッケージが、適用する指標のベンチマーク条件に対して非現実的な条件に依存していることを主張し、劣化したディープフェイク出力は検出の最低品質しきい値を下回る可能性があるが、現実的な「汚い」コンテンツは、コンテキストへの適切な注意によって視聴者を欺く可能性がある。
研究者は、現実の環境を模倣する新しいデータ劣化処理を導入した。これにより、元のクリーンなデータでの検出精度をわずかに犠牲にするだけで、主要なディープフェイク検出器の汎化性能が向上する。また、広範なアブレーション研究に裏付けられた新しい評価枠組みにより、現実の条件下で検出器の頑健性を評価できる。
論文のタイトルは、現実的な条件での学習ベースのディープフェイク検出の改善に関する新しいアプローチであり、スイスのマルチメディア信号処理グループ(MMSPG)とローザンヌ連邦工科大学(EPFL)からの研究者によるものである。
有用な混乱
ディープフェイク検出アプローチに劣化した出力を組み込むことを目的とした以前の努力には、Mixupニューラルネットワーク(2018年、MITとFAIRによる)やAugMix(2020年、DeepMindとGoogleによる)などのデータ増強方法が含まれる。これらの方法は、一般化を支援するためにトレーニング資料を「混ぜる」ことを試みる。
新しい研究では、研究者はまた、以前の 研究を引用し、特徴とノイズの関係の境界を確立するために、トレーニングデータにガウシアンノイズと圧縮アーティファクトを適用した。
新しい研究では、研究者は、画像取得プロセスと配布プロセスの妥協した条件をシミュレートするパイプラインを提供し、評価フレームワークに現実のワークフローを組み込むことで、ディープフェイク検出器のトレーニングデータをアーティファクトに対してより耐性を持たせることができる。

新しいアプローチの概念的ロジックとワークフロー。
劣化プロセスは、ディープフェイク検出に使用される2つの人気のあるデータセット、FaceForensics++とCeleb-DFv2に適用された。また、Capsule-ForensicsとXceptionNetなどの先駆的なディープフェイク検出器フレームワークも、2つのデータセットの画質を劣化させたバージョンでトレーニングされた。
検出器は、Adam最適化器を使用して25エポックと10エポックでトレーニングされた。データセットの変換では、各トレーニングビデオから100フレームがランダムにサンプリングされ、32フレームがテストのために抽出された。その後、劣化プロセスが追加された。
ワークフローで考慮された歪みは、ノイズ(6つの異なるレベルでゼロ平均ガウシアンノイズが適用された)、リサイズ(屋外映像に典型的な解像度の低下を模倣する。これは通常、検出器に影響し得る)、圧縮(さまざまなJPEG圧縮レベルがデータに適用された)、スムージング(3つの典型的なスムージングフィルタが評価された)、強調(コントラストと明度が調整された)、組み合わせ(上記の方法の3つが同時に1つの画像に適用された)であった。
テストと結果
テストでは、研究者は3つの指標を採用した:精度(ACC)、ROC曲線下の面積(AUC)、F1スコア。
研究者は、標準的な方法で訓練した2つのディープフェイク検出器を画質の劣化したデータでテストし、その限界を確認した:
「一般的に、ほとんどの現実的な歪みと処理は、通常の学習ベースのディープフェイク検出器にとって非常に有害である。たとえば、Capsule-Forensicsメソッドは、トレーニングデータセットでトレーニングされた後、両方の未圧縮のFFppとCeleb-DFv2テストセットで非常に高いAUCスコアを示すが、修正されたデータセットでテストされたときに、パフォーマンスが大幅に低下する。同様の傾向は、XceptionNet検出器でも観察された。」
一方、2つの検出器のパフォーマンスは、変換されたデータでトレーニングすることで著しく改善され、各検出器は未知の欺瞞的なメディアを検出する能力が向上した。
「データ増強スキームは、2つの検出器のロバスト性を大幅に改善し、同時に元の未変更のデータでの高いパフォーマンスを維持している。」

研究で評価した2つのディープフェイク検出器について、元のデータセットと拡張したデータセットでの性能を比較。
論文は次のように結論付けている:
「現在の検出方法は、特定のベンチマークで最大限の性能を達成するよう設計されている。そのため、より現実的な状況への汎化能力が犠牲になることが多い。本論文では、自然な画像劣化過程に基づく、慎重に設計されたデータ拡張手法を提案する。」
「広範な実験により、この単純ながら効果的な手法は、典型的な画像処理ワークフローにおけるさまざまな現実的な歪みや処理に対して、モデルの頑健性を大きく向上させることが示された。」
* 生成された顔のグレインを合わせる処理は、変換プロセス中にスタイル転送の機能である。
2022年3月29日に初めて公開され、午後8時33分(EST)にFfmpegでのグレインの使用を明確にするために更新された。


