
Modèles et plateformes d’IA
À l’intérieur d’OpenAI o3 et o4-mini : Déverrouiller de nouvelles possibilités grâce à la raisonnement multimodal et aux ensembles d’outils intégrés

 Ajouter Unite.AI à vos sources préférées sur Google
Le 16 avril 2025, OpenAI a publié des versions améliorées de ses modèles de raisonnement avancés. Ces nouveaux modèles, nommés o3 et o4-mini, offrent des améliorations par rapport à leurs prédécesseurs, o1 et o3-mini, respectivement. Les modèles les plus récents offrent des performances améliorées, de nouvelles fonctionnalités et une plus grande accessibilité. Cet article explore les principaux avantages d’o3 et o4-mini, présente leurs principales capacités et discute de la manière dont ils pourraient influencer l’avenir des applications d’IA. Mais avant de plonger dans ce qui rend o3 et o4-mini distincts, il est important de comprendre comment les modèles d’OpenAI ont évolué au fil du temps. Commençons par un bref aperçu du parcours d’OpenAI dans le développement de systèmes de langage et de raisonnement de plus en plus puissants.
L’évolution des modèles de langage de grande échelle d’OpenAI
Le développement de modèles de langage de grande échelle par OpenAI a commencé avec GPT-2 et GPT-3, qui ont rendu ChatGPT populaire en raison de leur capacité à produire du texte fluide et contextuellement précis. Ces modèles ont été largement adoptés pour des tâches telles que la synthèse, la traduction et la réponse aux questions. Cependant, à mesure que les utilisateurs les appliquaient à des scénarios plus complexes, leurs limites sont devenues évidentes. Ces modèles ont souvent eu du mal avec des tâches qui nécessitaient un raisonnement profond, une cohérence logique et une résolution de problèmes mult étapes. Pour relever ces défis, OpenAI a introduit GPT-4, et a recentré son attention sur l’amélioration des capacités de raisonnement de ses modèles. Ce changement a conduit au développement de o1 et o3-mini. Les deux modèles utilisent une méthode appelée chaîne de réflexion, qui leur permet de générer des réponses plus logiques et plus précises en raisonnant étape par étape. Alors que o1 est conçu pour répondre à des besoins de résolution de problèmes avancés, o3-mini est conçu pour offrir des capacités similaires de manière plus efficace et rentable. En s’appuyant sur cette base, OpenAI a maintenant introduit o3 et o4-mini, qui améliorent encore les capacités de raisonnement de leurs modèles de langage. Ces modèles sont conçus pour produire des réponses plus précises et plus réfléchies, en particulier dans des domaines techniques tels que la programmation, les mathématiques et l’analyse scientifique – des domaines où la précision logique est cruciale. Dans la section suivante, nous allons examiner comment o3 et o4-mini améliorent leurs prédécesseurs.
Les avancées clés dans o3 et o4-mini
Capacités de raisonnement améliorées
L’une des améliorations clés dans o3 et o4-mini est leur capacité de raisonnement améliorée pour les tâches complexes. Contrairement aux modèles précédents qui fournissaient des réponses rapides, o3 et o4-mini prennent plus de temps pour traiter chaque invite. Ce traitement supplémentaire leur permet de raisonner plus en profondeur et de produire des réponses plus précises, ce qui améliore les résultats sur les benchmarks. Par exemple, o3 surpasse o1 de 9% sur LiveBench.ai, un benchmark qui évalue les performances sur plusieurs tâches complexes telles que la logique, les mathématiques et le code. Sur le SWE-bench, qui teste le raisonnement dans les tâches d’ingénierie logicielle, o3 a obtenu un score de 69,1%, surpassant même des modèles concurrents comme Gemini 2.5 Pro, qui a obtenu un score de 63,8%. Pendant ce temps, o4-mini a obtenu un score de 68,1% sur le même benchmark, offrant une profondeur de raisonnement presque similaire à un coût nettement inférieur.
Intégration multimodale : réfléchir avec des images
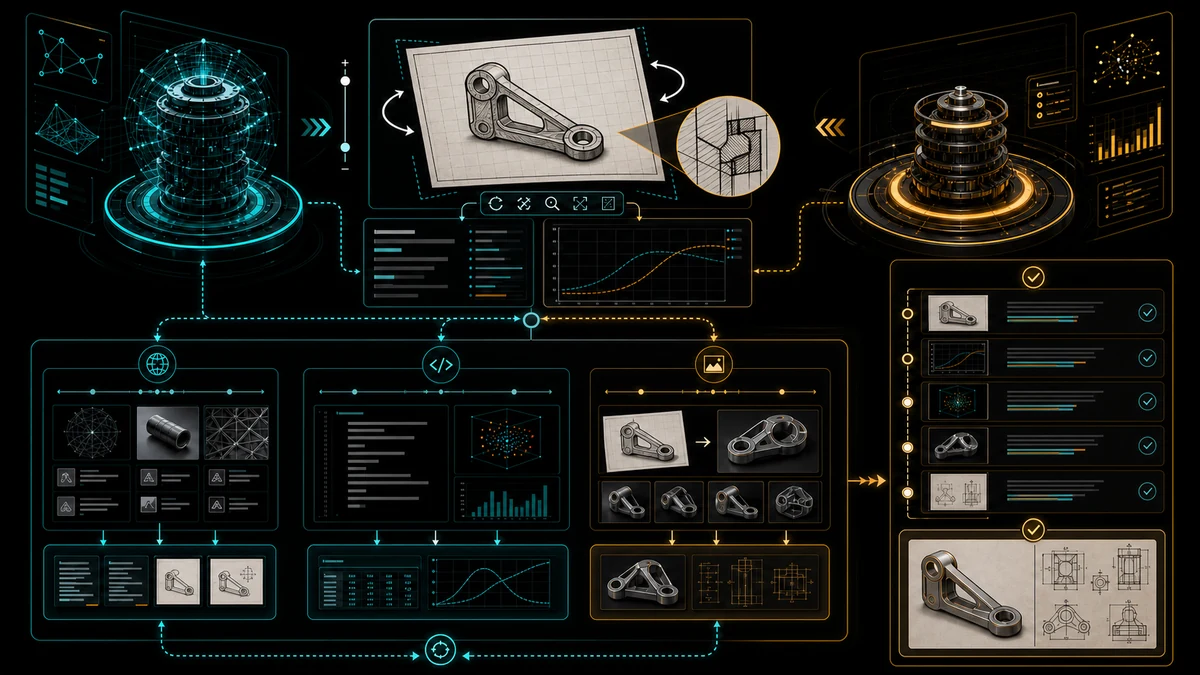
L’une des fonctionnalités les plus innovantes d’o3 et o4-mini est leur capacité à “réfléchir avec des images”. Cela signifie qu’ils peuvent non seulement traiter des informations textuelles mais également intégrer des données visuelles directement dans leur processus de raisonnement. Ils peuvent comprendre et analyser des images, même si elles sont de mauvaise qualité – comme des notes manuscrites, des croquis ou des diagrammes. Par exemple, un utilisateur pourrait télécharger un diagramme d’un système complexe, et le modèle pourrait l’analyser, identifier des problèmes potentiels ou même suggérer des améliorations. Cette capacité comble le fossé entre les données textuelles et visuelles, permettant des interactions plus intuitives et plus complètes avec l’IA. Les deux modèles peuvent effectuer des actions telles que le zoom sur des détails ou la rotation d’images pour mieux les comprendre. Cette raison multimodale est une avancée significative par rapport aux prédécesseurs comme o1, qui étaient principalement basés sur le texte. Elle ouvre de nouvelles possibilités d’applications dans des domaines tels que l’éducation, où les aides visuelles sont cruciales, et la recherche, où les diagrammes et les graphiques sont souvent centraux pour la compréhension.
Utilisation avancée d’outils
o3 et o4-mini sont les premiers modèles d’OpenAI à utiliser tous les outils disponibles dans ChatGPT simultanément. Ces outils incluent :
- La navigation Web : permettant aux modèles d’obtenir les dernières informations pour les requêtes sensibles au temps.
- L’exécution de code Python : leur permettant d’effectuer des calculs complexes ou des analyses de données.
- Le traitement et la génération d’images : améliorant leur capacité à travailler avec des données visuelles.
En utilisant ces outils, o3 et o4-mini peuvent résoudre des problèmes complexes et mult étapes plus efficacement. Par exemple, si un utilisateur pose une question nécessitant des données actuelles, le modèle peut effectuer une recherche Web pour récupérer les dernières informations. De même, pour les tâches impliquant l’analyse de données, il peut exécuter du code Python pour traiter les données. Cette intégration est une étape significative vers des agents d’IA plus autonomes qui peuvent gérer une gamme plus large de tâches sans intervention humaine. L’introduction de Codex CLI, un agent de codage léger et open-source qui fonctionne avec o3 et o4-mini, améliore encore leur utilité pour les développeurs.
Implications et nouvelles possibilités
La sortie d’o3 et o4-mini a des implications généralisées dans diverses industries :
- Éducation : Ces modèles peuvent aider les étudiants et les enseignants en fournissant des explications détaillées et des aides visuelles, rendant l’apprentissage plus interactif et plus efficace. Par exemple, un étudiant pourrait télécharger un croquis d’un problème mathématique, et le modèle pourrait fournir une solution étape par étape.
- Recherche : Ils peuvent accélérer la découverte en analysant des ensembles de données complexes, en générant des hypothèses et en interprétant des données visuelles comme des graphiques et des diagrammes, ce qui est inestimable pour des domaines comme la physique ou la biologie.
- Industrie : Ils peuvent optimiser les processus, améliorer la prise de décision et améliorer les interactions avec les clients en gérant à la fois les requêtes textuelles et visuelles, comme l’analyse de conceptions de produits ou la résolution de problèmes techniques.
- Créativité et médias : Les auteurs peuvent utiliser ces modèles pour transformer des plans de chapitres en storyboards simples. Les musiciens font correspondre des visuels à une mélodie. Les monteurs de films reçoivent des suggestions de rythme. Les architectes convertissent des plans de sol manuscrits en plans détaillés 3D qui incluent des notes structurelles et de durabilité.
- Accessibilité et inclusion : Pour les utilisateurs aveugles, les modèles décrivent les images en détail. Pour les utilisateurs sourds, ils convertissent des diagrammes en séquences visuelles ou en texte sous-titré. Leur traduction des mots et des visuels aide à combler les lacunes linguistiques et culturelles.
- Vers des agents autonomes : Puisque les modèles peuvent parcourir le Web, exécuter du code et traiter des images dans un flux de travail, ils forment la base d’agents autonomes. Les développeurs décrivent une fonctionnalité ; le modèle écrit, teste et déploie le code. Les travailleurs de la connaissance peuvent déléguer la collecte de données, l’analyse, la visualisation et la rédaction de rapports à un seul assistant d’IA.
Limitations et ce qui suit
Malgré ces progrès, o3 et o4-mini ont toujours une limite de connaissance de août 2023, ce qui limite leur capacité à répondre aux événements ou technologies les plus récents, à moins d’être complétés par une navigation Web. Les itérations futures aborderont probablement cette lacune en améliorant l’ingestion de données en temps réel.
On peut également s’attendre à des progrès supplémentaires dans les agents d’IA autonomes – des systèmes qui peuvent planifier, raisonner, agir et apprendre de manière continue avec une supervision minimale. L’intégration d’OpenAI des outils, des modèles de raisonnement et de l’accès aux données en temps réel signale que nous nous rapprochons de tels systèmes.
Le point clé
Les nouveaux modèles d’OpenAI, o3 et o4-mini, offrent des améliorations en termes de raisonnement, de compréhension multimodale et d’intégration d’outils. Ils sont plus précis, plus polyvalents et plus utiles dans une large gamme de tâches – de l’analyse de données complexes à la génération de code et à l’interprétation d’images. Ces progrès ont le potentiel d’améliorer considérablement la productivité et d’accélérer l’innovation dans diverses industries.





