
Angle d’Anderson
Un système d’apprentissage automatique pour réécrire un article pendant que vous le lisez

 Ajouter Unite.AI à vos sources préférées sur Google
De nouvelles recherches menées au Canada proposent une méthode pour réécrire automatiquement un article pendant que vous le lisez, sur la base d’un vote de type Tinder ou d’une observation passive de l’interaction de l’utilisateur avec les différents types de contenu que contient l’article.
Le système, intitulé Hone As You Read (HARE), est présenté dans un document de l’Université de l’Ouest de l’Ontario, au Canada, avec le code Python correspondant sur GitHub.
L’idée centrale du projet est qu’un article peut contenir différents types de contenu, évoluant (comme celui-ci) de l’en-tête jusqu’aux détails supplémentaires. Les parties ultérieures d’un article peuvent contenir différents types de matériel de soutien, des cas d’utilisation ou des hypothèses ou des conjectures sur les ramifications de l’actualité.
Sous HARE, si vous n’aimez pas ce type de matériel, vous pouvez le voter pour le supprimer au niveau du paragraphe pendant que le système apprend vos préférences, de sorte que lorsque vous faites défiler la page, le contenu similaire au matériel que vous avez « downvoté » a déjà été supprimé ou réécrit. Si vous ne voulez pas participer activement à la formation du système, HARE peut déduire vos choix en observant vos interactions passives avec le document.
Vote de type Tinder pour les phrases déplaisantes
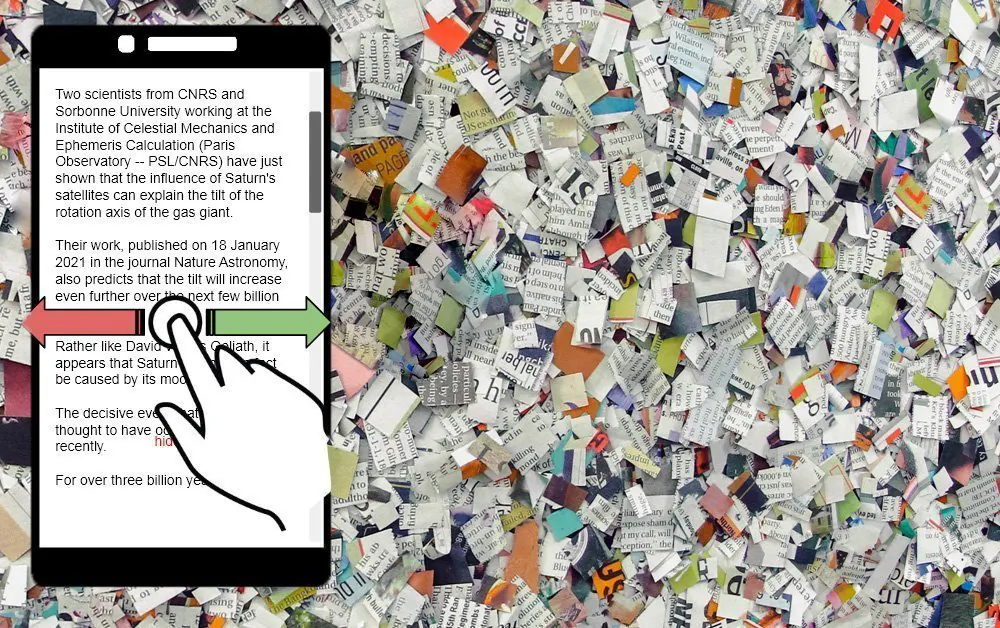
Dans l’image ci-dessous, nous voyons trois types possibles de catégorisation inférée pour HARE, basés sur le comportement explicite ou implicite de l’utilisateur. Dans le premier cas (gauche), l’utilisateur vote activement « à gauche » (ou à droite), dans un geste de vote de type Tinder exprimant son approbation ou son déplaisir pour le contenu du paragraphe ou de la phrase, ou pour son style, sa complexité ou son ton.

Source: https://arxiv.org/pdf/2105.02923.pdf
Dans le deuxième cas (centre), le système utilise le temps de pause comme mesure de l’intérêt de l’utilisateur, basé sur la position et la durée de la pause de défilement.
Dans le troisième cas (droite), HARE utilise la caméra du smartphone pour estimer le chemin et le temps de pause de l’emplacement du regard de l’utilisateur à travers les paragraphes des documents visibles.
Les chercheurs affirment que le temps de pause accru sur n’importe quel paragraphe peut indiquer un intérêt accru de l’utilisateur, même si logiquement ce n’est pas le cas lorsque le lecteur essaie d’assimiler du texte qui peut être compliqué ou simplement mal écrit.

La rétroaction de l’utilisateur édite efficacement, réécrit ou efface entièrement les parties non encore vues de l’article.
Prétraitement du contenu en fonction des préférences de l’utilisateur
Le document traite de l’expérience utilisateur de HARE sur une base par article, mais clairement l’interaction historique de l’utilisateur avec les documents permet la personnalisation des expériences de lecture futures, en reconnaissant systématiquement les types de contenu et en appliquant des préférences utilisateur modélisées à de nouveaux articles, de sorte que le besoin d’interaction diminue à mesure que l’utilisateur voit moins et moins de « contenu indésirable ».
HARE est caractérisé comme un algorithme de résumé, permettant à du contenu non visible plus bas dans la page d’être réécrit en termes de style ou de concision avant que l’utilisateur n’y arrive; mais le document indique clairement qu’il peut également supprimer préventivement du contenu en fonction de la rétroaction de l’utilisateur.
Aux fins de test, le système a utilisé un corpus de 11 222 articles du journal Daily Mail du Royaume-Uni, et a été évalué via un déploiement de test sur l’application de chat Telegram. Les articles avec moins de dix paragraphes ont été écartés pour les essais.

L’application Telegram HARE en phase de test avec les utilisateurs.
La méthodologie des chercheurs utilise le regroupement K-Means sur les empreintes de phrase SBERT dans les articles, avec des poids initiaux aléatoires pour les concepts traités.
Parmi un large groupe d’algorithmes et d’approches, HARE comporte trois modèles de comparaison, le premier desquels (ORACLEGREEDY) a accès aux préférences utilisateur précédentes, indiquant l’intention que l’algorithme pourrait prétraiter les articles lors du chargement, plutôt que de manière interactive.
Les autres modèles, ORACLESORTED et ORACLEUNIFORM, sélectionnent des phrases en fonction du niveau d’intérêt ou de manière aléatoire dans l’article, respectivement.
Suppression et réécriture de contenu
Étonnamment, ORACLEUNIFORM a surpassé l’ensemble de contrôle, même s’il n’a pas accès aux intérêts précédents de l’utilisateur. Les chercheurs affirment que c’est parce qu’il traite de l’ensemble de l’article en une seule fois, « en choisissant uniquement les phrases les plus intéressantes ». Les chercheurs admettent que cela peut restreindre le contenu disponible aux phrases qui traitent uniquement du concept le plus important, en supprimant logiquement d’autres textes qui peuvent traiter des ramifications ou de l’évaluation du concept.
Les résumés extractifs utilisés dans HARE sont LexRank, SumBasic et TextRank.
HARE a été testé sur 13 volontaires au cours de 70 essais et d’approches algorithmiques différentes, et a pu mettre à jour les résumés (texte réécrit/supprimé) en environ 1,3 milliseconde à 100 ms sur un ordinateur portable de consommation, en fonction du modèle testé. Les résultats ont montré que les modèles qui supprimaient le plus de texte ne fonctionnaient pas bien, principalement parce que cela peut affecter la cohérence du texte restant.
Implications éthiques de la réécriture dynamique d’articles
Les chercheurs reconnaissent les préoccupations éthiques entourant les technologies de ce type:
‘La tâche HARE est destinée à la conception d’applications futures à l’attention de l’utilisateur. Par conception, ces applications ont la capacité de contrôler ce qu’un utilisateur lit dans un article donné. Il est possible que, lorsqu’elles sont déployées sans soin suffisant, ces outils puissent exacerber l’effet de « chambre d’écho » déjà produit par les flux d’actualités automatisés, les résultats de recherche et les communautés en ligne.’
Cependant, ils notent également qu’un tel système pourrait être utilisé dans les applications futures pour atténuer l’effet de chambre d’écho en injectant du texte qui propose des points de vue alternatifs qui n’auraient peut-être pas été présents initialement dans l’article. Ils observent: « Le poids de ce facteur pourrait être ajusté pour fournir à la fois une expérience de lecture engageante et une exposition à une diversité d’idées. »
Ceux qui sont susceptibles de bénéficier d’un tel système, selon les chercheurs, sont les lecteurs qui veulent économiser du temps pour prendre connaissance des informations, et les éditeurs de contenu.


