
AI-mallit ja alustat
TensorRT-LLM: Kattava opas suurten kielen mallien inference-optimoimiseen maksimaalisen suorituskyvyn saavuttamiseksi

 Lisää Unite.AI suosikkilähteisiisi Google-palvelussa
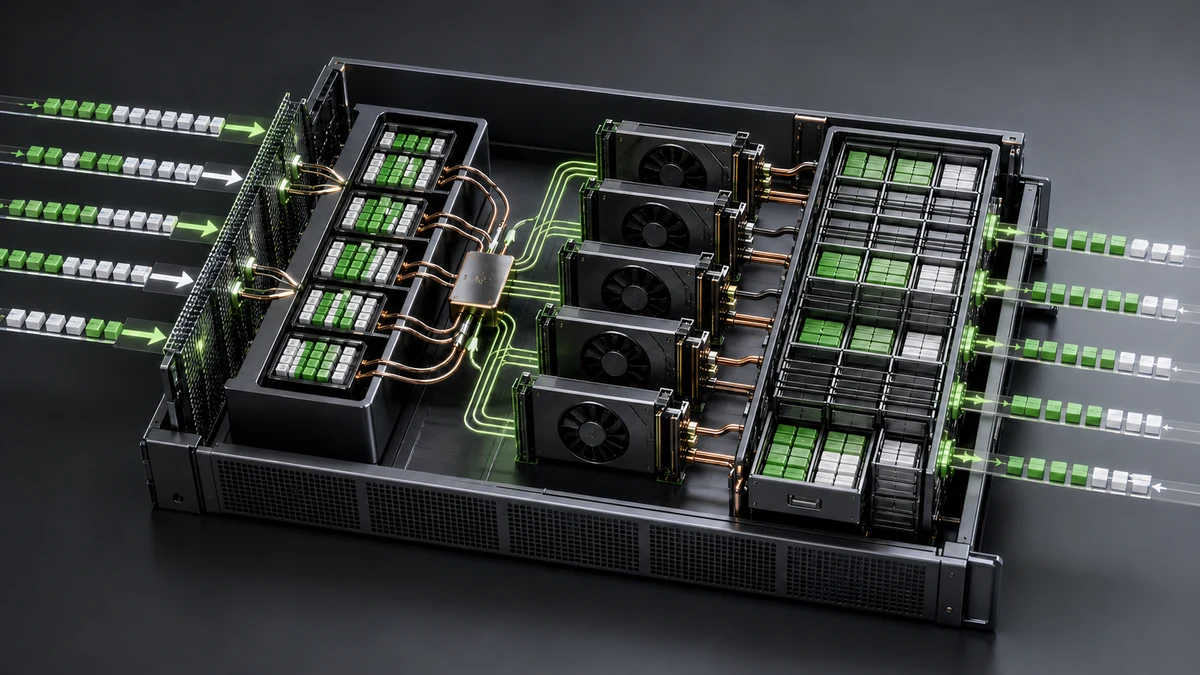
Suurten kielen mallien (LLM) kysynnän jatkuessa kasvaa, varmistamaan nopea, tehokas ja skaalautuva inference on tullut entistä tärkeämmäksi. NVIDIAN TensorRT-LLM vastaa tähän haasteeseen tarjoamalla joukon voimakkaita työkaluja ja optimoimisia, jotka on suunniteltu erityisesti LLM-inferenssiin. TensorRT-LLM tarjoaa vaikuttavan valikoiman suorituskyvyn parannuksia, kuten kvantisaatio, ytimen yhdistäminen, lennossa oleva eräily ja moni-GPU-tuki. Nämä edistysaskeleet mahdollistavat jopa 8 kertaa nopeamman inferenssin verrattuna perinteisiin CPU-pohjaisiin menetelmiin, muuttaen tapaa, jolla otamme LLM-malleja käyttöön tuotannossa.
Tämä kattava opas käy läpi kaikki TensorRT-LLM:n puolet, sen arkkitehtuurista ja avainominaisuuksista käytännön esimerkkeihin mallien käyttöönotosta. Olit sitten AI-insinööri, ohjelmistokehittäjä tai tutkija, tämä opas antaa sinulle tiedon hyödyntääksesi TensorRT-LLM:ää LLM-inferenssin optimoimiseen NVIDIAN GPU:illa.
Nopeuta LLM-inferenssiä TensorRT-LLM:llä
TensorRT-LLM tarjoaa dramaattisia parannuksia LLM-inferenssin suorituskyvyssä. NVIDIAN testien mukaan TensorRT-pohjaiset sovellukset näyttävät jopa 8 kertaa nopeamman inferenssin nopeuden verrattuna pelkästään CPU-pohjaisiin alustoihin. Tämä on ratkaiseva edistysaskel reaaliaikaisissa sovelluksissa, kuten chatboteissa, suositussysteemeissä ja autonomisissa järjestelmissä, joissa nopeat vastaukset ovat kriittisiä.
Toimintaperiaate
TensorRT-LLM nopeuttaa inferenssiä optimoimalla neuroverkkoja käyttöönoton aikana tekniikoilla kuten:
- Kvantisaatio: Vähentää painojen ja aktivaatioiden tarkkuutta, pienentää mallin kokoa ja parantaa inferenssin nopeutta.
- Kerrosten ja tensorien yhdistäminen: Yhdistää toimintoja, kuten aktivaatiofunktioita ja matriisien kertolaskuja, yhteen toimintoon.
- Ytimen säätö: Valitsee optimaaliset CUDA-ytimet GPU-laskentaan, vähentää suoritusaikaa.
Nämä optimoinnit varmistavat, että LLM-mallisi toimivat tehokkaasti laajalla skaalalla käyttöönottoalustoja – hyperskaalautuvista tietokeskuksista upotettuihin järjestelmiin.
Optimoi inferenssin suorituskyky TensorRT:llä
NVIDIAN CUDA-rinnakkaisohjelmointimallin pohjalta TensorRT tarjoaa erittäin erikoistuneita optimoimisia inferenssiin NVIDIAN GPU:illa. Suorittamalla prosesseja kuten kvantisaatiota, ytimen säätöä ja tensorioperaatioiden yhdistämistä, TensorRT varmistaa, että LLM:t voivat suorittaa vähäisellä viiveellä.
Jotkut tehokkaimmista tekniikoista ovat:
- Kvantisaatio: Tämä vähentää numeerisen tarkkuuden malliparametreissa säilyttäen korkean tarkin, tehokkaasti nopeuttaen inferenssiä.
- Tensorien yhdistäminen: Yhdistämällä useita toimintoja yhteen CUDA-ytimeen, TensorRT minimoi muistin ylikuormituksen ja lisää läpi-vientiä.
- Ytimen automaattinen säätö: TensorRT valitsee automaattisesti parhaan ytimen kullekin toiminnolle, optimoiden inferenssin tietyn GPU:n osalta.
Nämä tekniikat mahdollistavat TensorRT-LLM:lle optimoida inferenssin suorituskykyä syvän oppimisen tehtävissä, kuten luonnollisen kielen prosessoinnissa, suositussysteemeissä ja reaaliaikaisessa videon analytiikassa.
Kiihdytä AI-työkuormia TensorRT:llä
TensorRT kiihdyttää syvän oppimisen työkuormia sisällyttämällä tarkkuusoptimoimisia kuten INT8 ja FP16. Nämä vähennetyt tarkkuusmuodot sallivat merkittävästi nopeamman inferenssin säilyttäen tarkin. Tämä on erityisen arvokasta reaaliaikaisissa sovelluksissa, joissa matala viive on kriittinen vaatimus.
INT8 ja FP16 optimoinnit ovat erityisen tehokkaita seuraavissa:
- Videovirran käsittely: AI-pohjaiset videon käsittelytehtävät, kuten esineen havaitseminen, hyötyvät näistä optimoinneista vähentämällä kestoja kehysien prosessoinnissa.
- Suositussysteemit: Kiihdyttämällä inferenssiä malleille, jotka prosessoi suuria määriä käyttäjätietoja, TensorRT mahdollistaa reaaliaikaisen henkilökohtaisen suosittelun suuressa mittakaavassa.
- Luonnollisen kielen prosessointi (NLP): TensorRT parantaa NLP-tehtävien, kuten tekstin luomisen, kääntämisen ja yhteenvetokuvan, nopeutta, tehden niistä soveltuvia reaaliaikaisiin sovelluksiin.
Käyttöönotto, suoritus ja skaalautuminen NVIDIAN Tritonilla
Kun mallisi on optimoitu TensorRT-LLM:llä, voit helposti käyttää, suorittaa ja skaalata sitä NVIDIAN Triton Inferenssipalvelimen avulla. Triton on avoimen lähdekoodin ohjelmisto, joka tukee dynaamista eräilyä, mallien yhdistelyä ja korkeaa läpi-vientiä. Se tarjoaa joustavan ympäristön AI-mallien hallintaan suuressa mittakaavassa. (NVDA )
Jotkut avainominaisuudet ovat:
- Rinnakkainen mallin suoritus: Suorita useita malleja samanaikaisesti, maksimoimalla GPU:n käyttö.
- Dynaaminen eräily: Yhdistä useita inferenssipyynnöksi yhteen erään, vähentäen viivettä ja lisäten läpi-vientiä.
- Striimausääni- ja videolähdöt: Tukee lähtöströimejä reaaliaikaisissa sovelluksissa, kuten live-videon analytiikassa tai puhe-teksti -palveluissa.
Tämä tekee Tritonista arvokkaan työkalun TensorRT-LLM-optimoitujen mallien käyttöönotossa tuotantoympäristöissä, varmistaen korkean skaalautuvuuden ja tehokkuuden.
TensorRT-LLM:n ydinominaisuudet LLM-inferenssiin
Avoimen lähdekoodin Python-rajapinta
TensorRT-LLM tarjoaa erittäin modulaarisen ja avoimen lähdekoodin Python-rajapinnan, yksinkertaistaen LLM-mallien määrittely-, optimointi- ja suorittamisprosessia. Rajapinta mahdollistaa kehittäjille luoda mukautettuja LLM-malleja tai muokata valmiita malleja ilman syvää CUDA- tai syvän oppimisen kehyksen tuntemusta.
Lennossa oleva eräily ja sivutettu huomio
Yksi TensorRT-LLM:n erityisominaisuuksista on Lennossa oleva eräily, joka optimoi tekstin luomista prosessoiden useita pyynnöksiä samanaikaisesti. Tämä ominaisuus minimoi odotteluaikaa ja parantaa GPU:n käyttöä dynaamisesti eräilemällä sekvenssejä.
Lisäksi Sivutettu huomio varmistaa, että muistin käyttö pysyy alhaisena, vaikka käsiteltäisiin pitkiä syöte-sekvenssejä. Sen sijaan, että varataan yhtenäinen muisti kaikille tokenille sekvenssissä, sivutettu huomio jakaa muistin “sivuihin”, jotka voidaan uudelleen käyttää dynaamisesti, estäen muistin fragmentaation ja parantaen tehokkuutta.
Moni-GPU- ja monisolmu-inferenssi
Suuremmille malleille tai monimutkaisemmille työkuormille TensorRT-LLM tukee moni-GPU ja monisolmu-inferenssiä. Tämä mahdollistaa mallilaskelmien jakamisen useiden GPU:iden tai solmujen kesken, parantaen läpi-vientiä ja vähentäen koko inferenssiaikaa.
FP8-tuki
FP8:n (8-bittisen liukuluvun) myötä TensorRT-LLM hyödyntää NVIDIAN H100-grafiikkaprosessoreiden uusimpia innovaatioita. FP8 vähentää LLM-mallien muistijalanjälkeä tallentamalla painot ja aktivaatiot 8-bittisessä liukuluvussa, johtaen nopeampaan laskentaan ilman merkittävää tarkin alentumista. TensorRT-LLM kääntää automaattisesti mallit hyödyntämään optimoituja FP8-ytimiä, kiihdyttäen edelleen inferenssiaikoja.
TensorRT-LLM:n arkkitehtuuri ja komponentit
Ymmärtääksesi TensorRT-LLM:n arkkitehtuuri parhaiten, on tärkeää tutustua sen avainkomponentteihin:
Mallin määrittely
TensorRT-LLM sallii LLM-mallien määrittelyn yksinkertaisella Python-rajapinnalla. Rajapinta rakentaa verkkoesitysmuodon mallista, helpottaen monimutkaisten kerrosten hallintaa LLM-arkkitehtuureissa kuten GPT ja BERT.
Painojen sitominen
Ennen mallin kääntämistä, painot (tai parametri) on sitominen verkkoon. Tämä vaihe varmistaa, että painot upotetaan TensorRT-moottoriin, mahdollistaen nopean ja tehokkaan inferenssin. TensorRT-LLM sallii myös painojen päivittämisen käännöksen jälkeen, lisäten joustavuutta malleille, jotka vaativat usein päivityksiä.
Mallin havaitseminen ja yhdistäminen
Operaatioiden yhdistäminen on toinen voimakas ominaisuus TensorRT-LLM:ssä. Yhdistämällä useita operaatioita (esim. matriisien kertolaskut aktivaatiorunktojen kanssa) yhteen CUDA-ytimeen, TensorRT minimoi useiden ydinten käynnistämiseen liittyvän viiveen. Tämä vähentää muistin siirtoja ja nopeuttaa inferenssiä.
Lisäosat
Laajentaaksesi TensorRT:n ominaisuuksia, kehittäjät voivat kirjoittaa lisäosia – mukautettuja ytimiä, jotka suorittavat tiettyjä tehtäviä, kuten monipäisen huomion parantamista Transformer-pohjaisissa malleissa.
Esimerkiksi Flash-Attention-lisäosa on tunnettu mukautettu ydin, joka optimoi monipäistä huomiota Transformer-mallien huomiokerroksissa. Käyttämällä tätä lisäosaa, kehittäjät voivat saavuttaa merkittäviä nopeuksia huomion laskennassa – yhdessä LLM-mallien resursseja vaativimmista osista.
Suorituskykyvertailu: TensorRT-LLM:n suorituskyvyn parannukset
TensorRT-LLM osoittaa merkittäviä suorituskyvyn parannuksia LLM-inferenssissä eri NVIDIAN GPU:illa. Tässä on vertailu inferenssin nopeudesta (mitattuna tokenien määrässä sekunnissa) käyttäen TensorRT-LLM:ää eri NVIDIAN GPU:illa:
| Malli | Tarkkuus | Syöte/Ulostulo-pituus | H100 (80GB) | A100 (80GB) | L40S FP8 |
|---|---|---|---|---|---|
| GPTJ 6B | FP8 | 128/128 | 34,955 | 11,206 | 6,998 |
| GPTJ 6B | FP8 | 2048/128 | 2,800 | 1,354 | 747 |
| LLaMA v2 7B | FP8 | 128/128 | 16,985 | 10,725 | 6,121 |
| LLaMA v3 8B | FP8 | 128/128 | 16,708 | 12,085 | 8,273 |
Nämä suorituskykyvertailut osoittavat, että TensorRT-LLM tarjoaa merkittäviä suorituskyvyn parannuksia, erityisesti pidemmissä sekvensseissä.
Käytännön esimerkki: Asenna ja rakenna TensorRT-LLM
Vaihe 1: Luo konttialusta
TensorRT-LLM tarjoaa Docker-kuvia, joilla voit luoda hallitun ympäristön mallien rakentamiseen ja suorittamiseen.
[koodi kielenä=”PYTHON”]
docker build –pull \
–target devel \
–file docker/Dockerfile.multi \
–tag tensorrt_llm/devel:latest .
[/koodi]
[koodi kielenä=”PYTHON”]
python3 ./scripts/build_wheel.py –trt_root /usr/local/tensorrt
pip install ./build/tensorrt_llm*.whl
[/koodi]
Vaihe 2: Suorita kontti
Suorita kehityskontti, jossa on pääsy NVIDIAN GPU:ihin:
[koodi kielenä=”PYTHON”]
docker run –rm -it \
–ipc=host –ulimit memlock=-1 –ulimit stack=67108864 –gpus=all \
–volume ${PWD}:/code/tensorrt_llm \
–workdir /code/tensorrt_llm \
tensorrt_llm/devel:latest
[/koodi]
Vaihe 3: Rakenna TensorRT-LLM lähdekoodista
Kontin sisällä, käännä TensorRT-LLM seuraavalla komennolla:
[koodi kielenä=”PYTHON”]
python3 ./scripts/build_wheel.py –trt_root /usr/local/tensorrt
pip install ./build/tensorrt_llm*.whl
[/koodi]
Tämä vaihtoehto on erityisen hyödyllinen, kun haluat välttää yhteensopivuusongelmia liittyen Python-riippuvuuksiin tai keskittyä C++-integrointiin tuotantojärjestelmissä. Kun käännös on valmis, löydät käännetyt kirjastot C++-ajonaikaisesta cpp/build/tensorrt_llm-hakemistosta, valmiina integroimiseen C++-sovelluksiisi.
Vaihe 4: Linkitä TensorRT-LLM C++-ajonaikainen
Integroidessasi TensorRT-LLM:ää C++-projektiisi, varmista, että projektiisi osoittavat polut cpp/include-hakemistoon. Tämä sisältää vakaat, tuetut API-otsikot. TensorRT-LLM-kirjastot linkitetään osana C++-käännösprosessia.
Esimerkiksi projektiisi CMake-konfiguraatio voi sisältää:
[koodi kielenä=”PYTHON”]
include_directories(${TENSORRT_LLM_PATH}/cpp/include)
link_directories(${TENSORRT_LLM_PATH}/cpp/build/tensorrt_llm)
target_link_libraries(your_project tensorrt_llm)
[/koodi]
Tämä integrointi mahdollistaa hyödyntääksesi TensorRT-LLM:n optimoinnit mukautetuissa C++-projekteissasi, varmistaen tehokkaan inferenssin myös alhaisissa tai suorituskykyisissä ympäristöissä.
Edistyneet TensorRT-LLM-ominaisuudet
TensorRT-LLM on enemmän kuin vain optimointikirjasto; se sisältää useita edistyneitä ominaisuuksia, jotka auttavat ottamaan suuret LLM-käyttöönotot haltuun. Tässä käymme läpi joitakin näistä ominaisuuksista tarkemmin:
1. Lennossa oleva eräily
Perinteinen eräily vaatii odottelua, kunnes erä on täysin kerätty ennen prosessointia, mikä voi aiheuttaa viiveitä. Lennossa oleva eräily muuttaa tämän aloittamalla inferenssin valmiista pyynnöistä erässä, samalla kun kerätään muita pyynnöksiä. Tämä parantaa kokonaisuorituskykyä minimoiden odotteluaikaa ja parantaen GPU:n käyttöä.
Tämä ominaisuus on erityisen arvokas reaaliaikaisissa sovelluksissa, kuten chatboteissa tai älykkäissä avustajissa, joissa vastausaika on kriittinen.
2. Sivutettu huomio
Sivutettu huomio on muistin optimointitekniikka pitkien syöte-sekvenssien käsittelyyn. Sen sijaan, että vaadittaisiin yhtenäistä muistia kaikille tokenille sekvenssissä (mikä voi johtaa muistin fragmentaatioon), sivutettu huomio sallii mallin jakaa avain-arvo-keskusdatan “sivuihin” muistia, jotka voidaan dynaamisesti määrittää ja vapauttaa, optimoiden muistin käytön.
Sivutettu huomio on kriittinen pitkien sekvenssien käsittelyssä ja muistin ylikuormituksen vähentämisessä, erityisesti generatiivisissa malleissa kuten GPT ja LLaMA.
3. Mukautettavat lisäosat
TensorRT-LLM sallii laajentaa sen toiminnallisuutta mukautettavilla lisäosilla. Lisäosat ovat käyttäjän määrittämät ytimet, jotka mahdollistavat tiettyjä optimoimisia tai toimintoja, joita standardi TensorRT-kirjasto ei kata.
Esimerkiksi Flash-Attention-lisäosa on tunnettu mukautettu ydin, joka optimoi monipäistä huomiota Transformer-pohjaisissa malleissa. Käyttämällä tätä lisäosaa, kehittäjät voivat saavuttaa merkittäviä nopeuksia huomion laskennassa – yhdessä LLM-mallien resursseja vaativimmista osista.
Voit integroida mukautetun lisäosan TensorRT-LLM-malliisi kirjoittamalla mukautetun CUDA-ytimen ja rekisteröimällä sen TensorRT:lle. Lisäosa kutsutaan mallin suorittamisen aikana, tarjoten räätälöityjä suorituskyvyn parannuksia.
4. FP8-tarkkuus NVIDIAN H100:lla
FP8-tarkkuuden myötä TensorRT-LLM hyödyntää NVIDIAN uusimpia innovaatioita H100 Hopper -arkkitehtuurissa. FP8 vähentää LLM-mallien muistijalanjälkeä tallentamalla painot ja aktivaatiot 8-bittisessä liukuluvussa, johtaen nopeampaan laskentaan ilman merkittävää tarkin alentumista. TensorRT-LLM kääntää automaattisesti mallit hyödyntämään optimoituja FP8-ytimiä, kiihdyttäen edelleen inferenssiaikoja.
Tämä tekee TensorRT-LLM:stä ihanteellisen valinnan suurten käyttöönottojen tarpeisiin, joissa vaaditaan huipputasoinen suorituskyky ja energiatehokkuus.
Esimerkki: Käyttöönotto TensorRT-LLM:llä Triton Inferenssipalvelimella
Tuotantokäyttöönotoissa NVIDIAN Triton Inferenssipalvelin tarjoaa vankkaan alustan mallien hallintaan suuressa mittakaavassa. Tässä esimerkissä osoitamme, kuinka käyttää TensorRT-LLM-optimoitua mallia Tritonilla.
Vaihe 1: Määritä mallin hakemisto
Luo mallin hakemisto Tritonille, joka tallentaa TensorRT-LLM-mallitiedostosi. Esimerkiksi, jos olet kääntänyt GPT2-mallin, hakemistorakenteesi voisi näyttää tältä:
[koodi kielenä=”BASH”]
mkdir -p model_repository/gpt2/1
cp ./trt_engine/gpt2_fp16.engine model_repository/gpt2/1/
[/koodi]
Vaihe 2: Luo Triton-konfiguraatiotiedosto
Samassa model_repository/gpt2/-hakemistossa luo konfiguraatiotiedosto nimeltä config.pbtxt, joka kertoo Tritonille, kuinka ladata ja suorittaa malli. Tässä on peruskonfiguraatio TensorRT-LLM:lle:
[koodi kielenä=”PYTHON”]
name: “gpt2”
platform: “tensorrt_llm”
max_batch_size: 8
syöte [
{
name: “input_ids”
data_type: TYPE_INT32
dims: [-1]
}
]
ulos [
{
name: “logits”
data_type: TYPE_FP32
dims: [-1, -1]
}
]
[/koodi]
Vaihe 3: Käynnistä Triton-palvelin
Käytä seuraavaa Docker-komentoa käynnistääksesi Tritonin mallin hakemistolla:
[koodi kielenä=”PYTHON”]
docker run –rm –gpus all \
-v $(pwd)/model_repository:/models \
nvcr.io/nvidia/tritonserver:23.05-py3 \
tritonserver –model-repository=/models
[/koodi]
Vaihe 4: Lähetä inferenssipyynnöt Tritonille
Kun Triton-palvelin on käynnissä, voit lähettää sille inferenssipyynnöksiä HTTP:llä tai gRPC:llä. Esimerkiksi, käyttäen curl lähettääksesi pyynnön:
[koodi kielenä=”PYTHON”]
curl -X POST http://localhost:8000/v2/models/gpt2/infer -d ‘{
“inputs”: [
{“name”: “input_ids”, “shape”: [1, 128], “datatype”: “INT32”, “data”: [[101, 234, 1243]]}
]
}’
[/koodi]
Triton prosessoi pyynnön käyttäen TensorRT-LLM-moottoria ja palauttaa logiitit ulostulona.
Parhaat käytännöt LLM-inferenssin optimoimiseksi TensorRT-LLM:llä
Hyödyntääksesi täysin TensorRT-LLM:n voimaa, on tärkeää noudattaa parhaita käytäntöjä sekä mallin optimoinnissa että käyttöönotossa. Tässä ovat joitakin avainvinkkejä:
1. Profiili mallisi ennen optimointia
Ennen kuin sovellet optimoimisia, kuten kvantisaatiota tai ytimen yhdistämistä, käytä NVIDIAN profilointityökaluja (kuten Nsight Systems tai TensorRT Profiler) ymmärtääksesi nykyiset pullonkaulat mallin suorituksessa. Tämä mahdollistaa kohdennetun parantamisen, johtaen tehokkaampiin optimoimisiin.
2. Käytä sekoitettua tarkkuutta optimaalisen suorituskyvyn saavuttamiseksi
Optimoidessasi malleja TensorRT-LLM:llä, sekoitettu tarkkuus (yhdistelmä FP16 ja FP32) tarjoaa merkittävän nopeutuksen ilman suurta tarkin alentumista. Saavuttaaksesi parhaimman tasapainon nopeuden ja tarkin välillä, harkitse FP8:n käyttöä, erityisesti H100-grafiikkaprosessoreilla.
3. Hyödynnä sivutettua huomiota pitkien sekvenssien käsittelyssä
Tehtävissä, jotka vaativat pitkiä syöte-sekvenssejä, kuten asiakirjan yhteenveto tai monivaiheinen keskustelu, käytä aina sivutettua huomiota muistin käytön optimoimiseksi. Tämä vähentää muistin ylikuormituksen ja estää muistivirheitä inferenssin aikana.
4. Säädä rinnakkaisuutta moni-GPU-kokoonpanoissa
Käyttäessäsi LLM-malleja useiden GPU:iden tai solmujen yli, on tärkeää säätää tensorin rinnakkaisuutta ja putken rinnakkaisuutta vastaamaan työkuormiasi. Oikean konfiguraation valitseminen voi johtaa merkittäviin suorituskyvyn parannuksiin jakamalla laskentakuorman tasaisesti GPU:iden kesken.
Johtopäätös
TensorRT-LLM edustaa merkittävää askelta eteenpäin LLM-mallien optimoimisessa ja käyttöönotossa. Sen edistyneiden ominaisuuksien, kuten kvantisaation, operaatioiden yhdistämisen, FP8-tarkkuuden ja moni-GPU-tuen, ansiosta TensorRT-LLM mahdollistaa LLM-mallien suorittamisen nopeammin ja tehokkaammin NVIDIAN GPU:illa. Olit sitten työskentelemässä reaaliaikaisissa chat-sovelluksissa, suositussysteemeissä tai suurissa kielen malleissa, TensorRT-LLM tarjoaa työkalut, jotka tarvitaan suorituskyvyn rajojen venyttämiseen.
Tämä opas on opastanut sinua TensorRT-LLM:n asennuksesta, mallien optimoimisesta Python-rajapinnalla, käyttöönotosta Triton Inferenssipalvelimella ja parhaiden käytäntöjen soveltamisesta tehokkaaseen inferenssiin. TensorRT-LLM:llä voit kiihdyttää AI-työkuormiasi, vähentää viivettä ja toimittaa skaalautuvia LLM-ratkaisuja tuotantoympäristöihin.
Lisätietoja varten, tutustu viralliseen TensorRT-LLM-dokumentaatioon ja Triton Inferenssipalvelimen dokumentaatioon.



